
 #01
Відео
AI у коротких відео
Одна ідея в одному відео, простою мовою. Кожне веде до розділу нашого безкоштовного курсу, де все пояснено крок за кроком.
Почніть тут AI 101
- #01
 #02
Machine learning: how a computer draws its own dividing line
 #03
Neural networks: layers of tiny calculators passing signals on
 #04
How AI learns: guess, measure the error, nudge, repeat
 #05
Tokens: how AI chops your words into numbered pieces
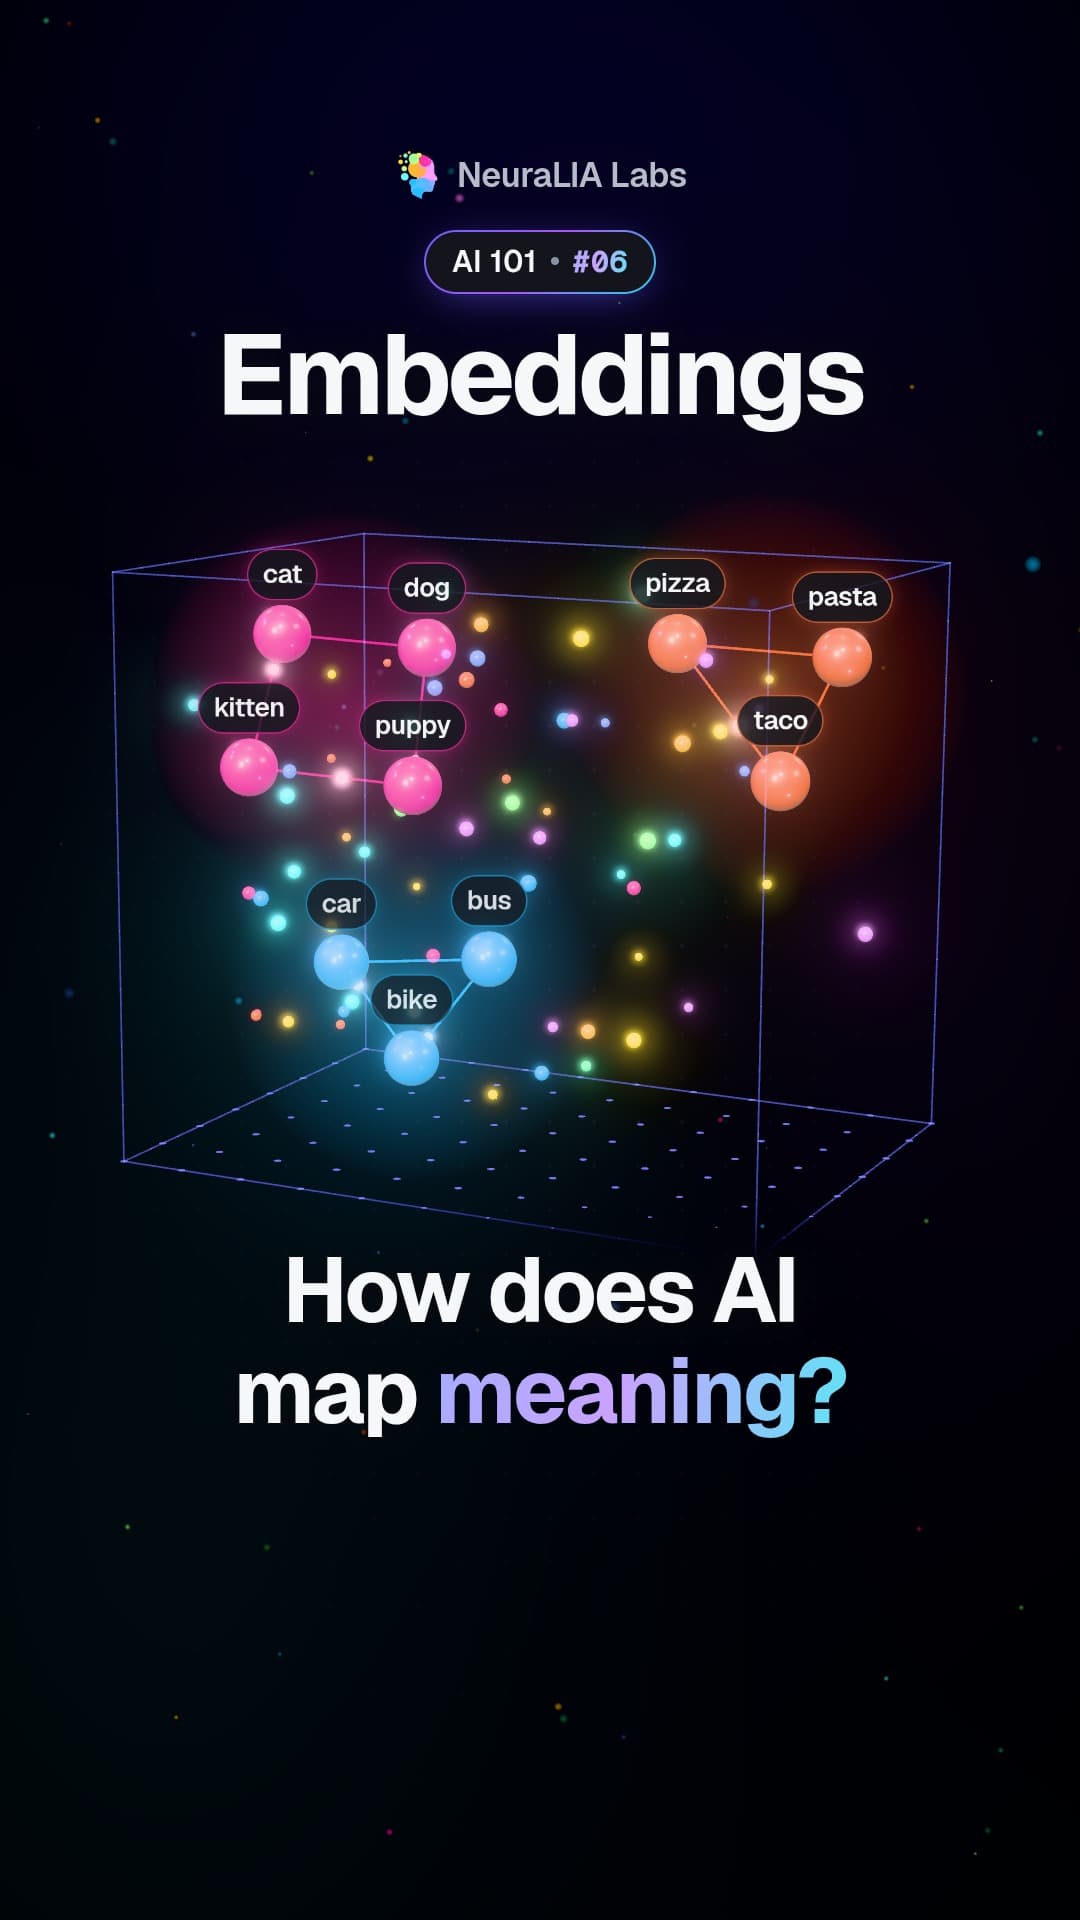 #06
Embeddings: why a puppy lands closer to a dog than to a pizza
Останні
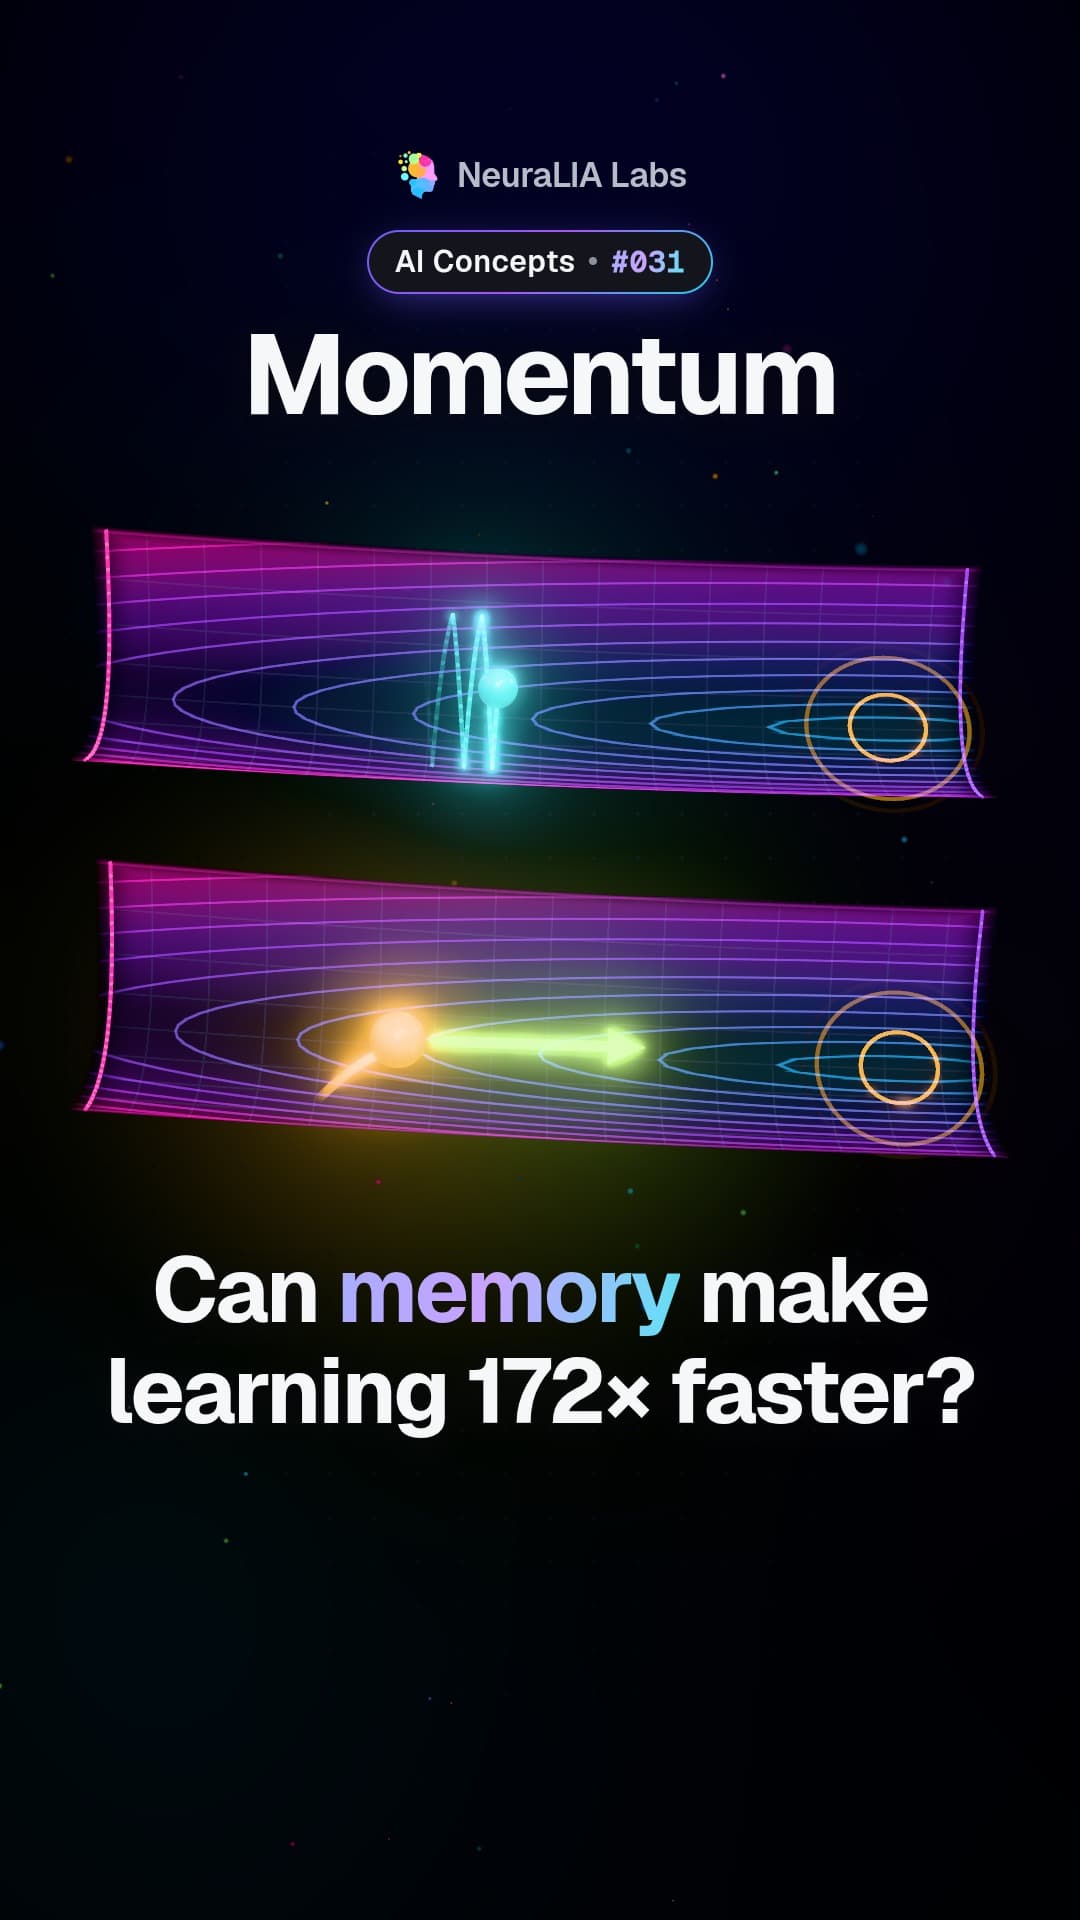 #031
Momentum: how remembering past steps stops AI training zigzagging
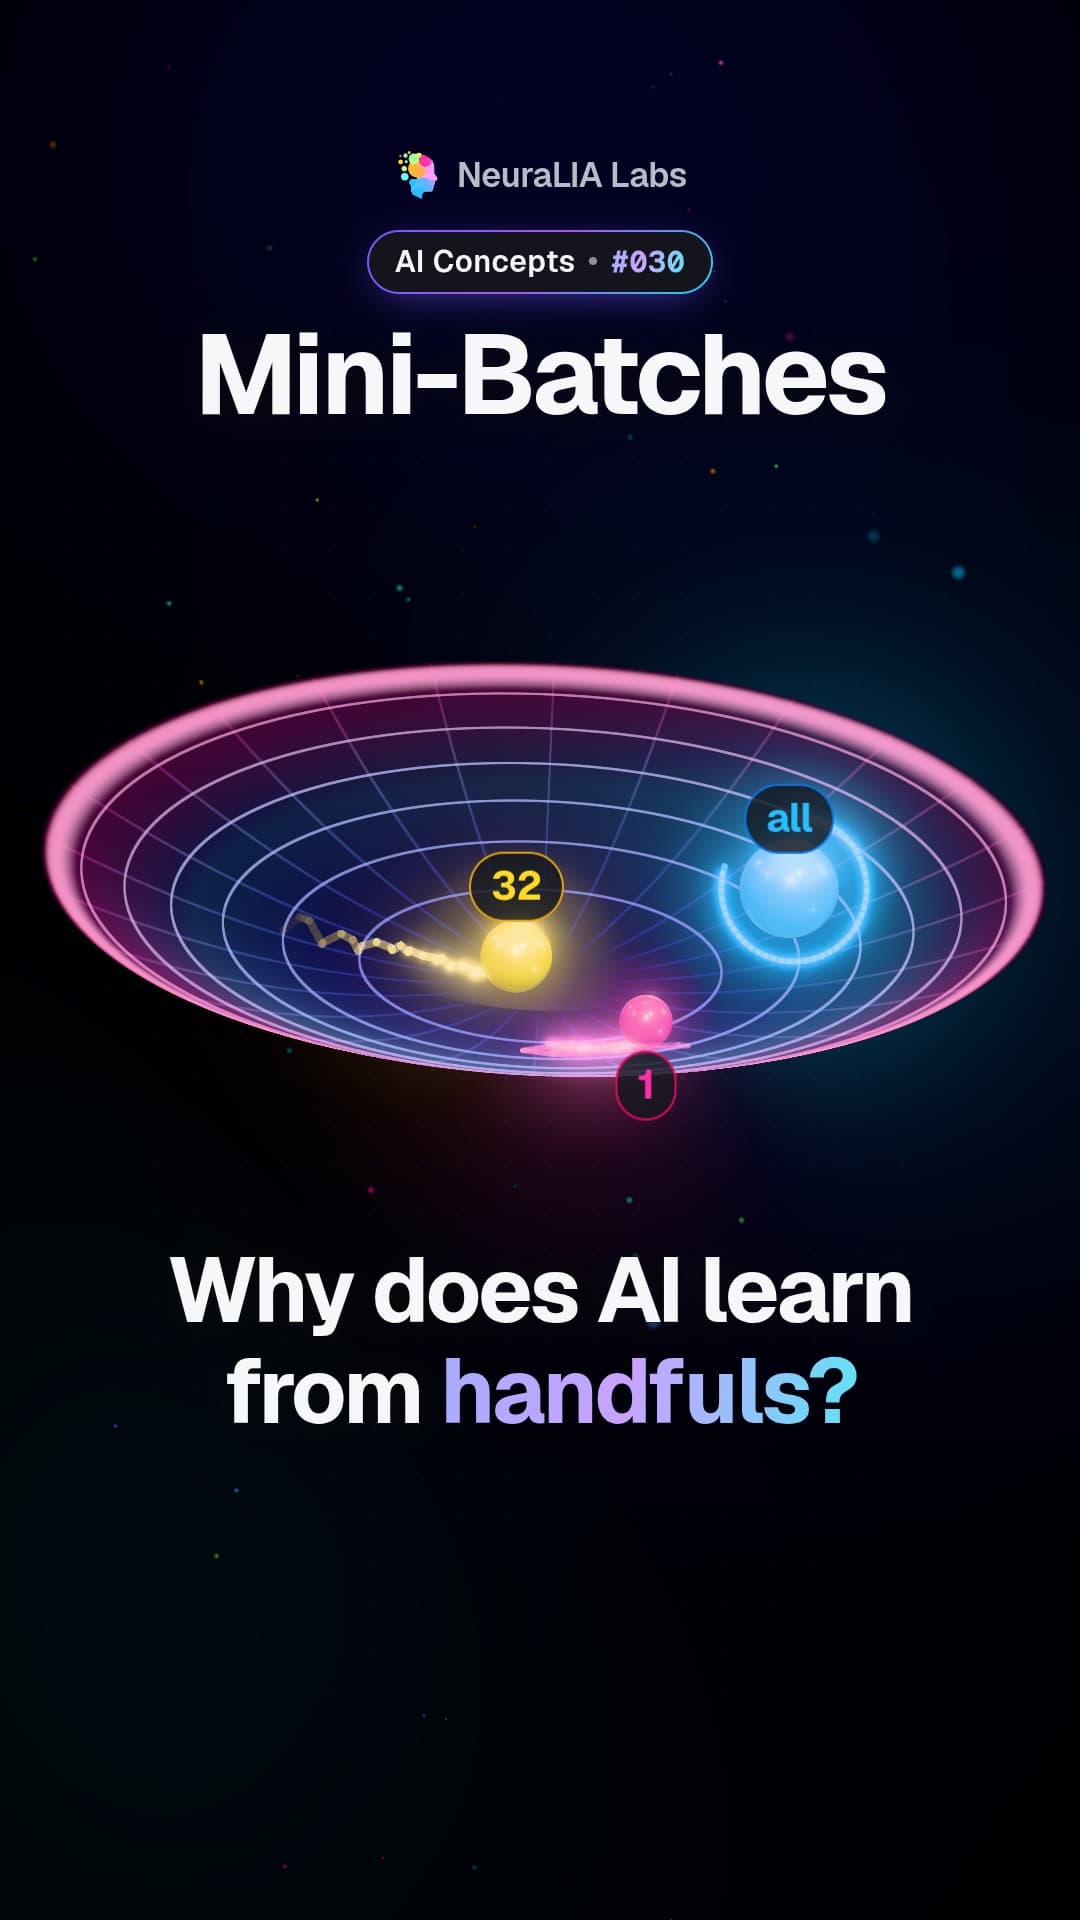 #030
Mini-batches: why AI learns faster from a random handful of data
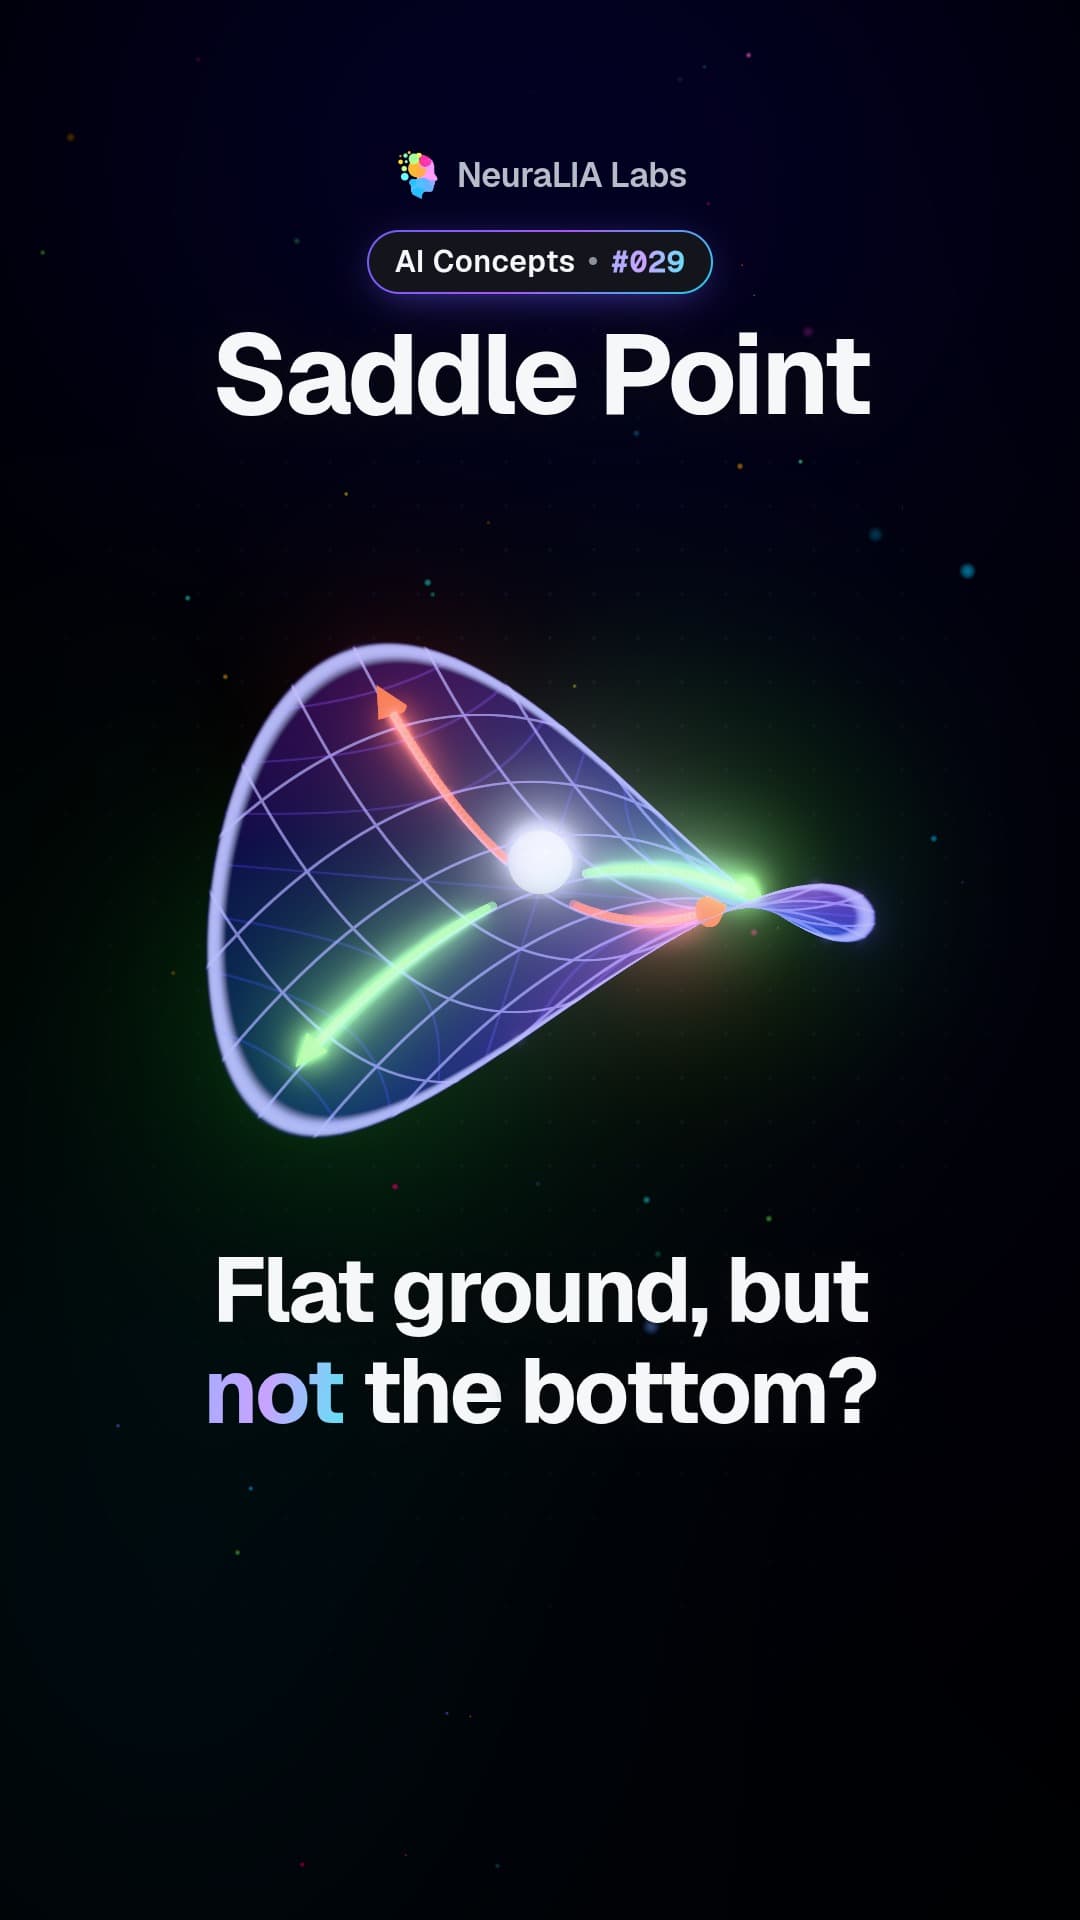 #029
Saddle points: where AI training looks stuck but has a way down
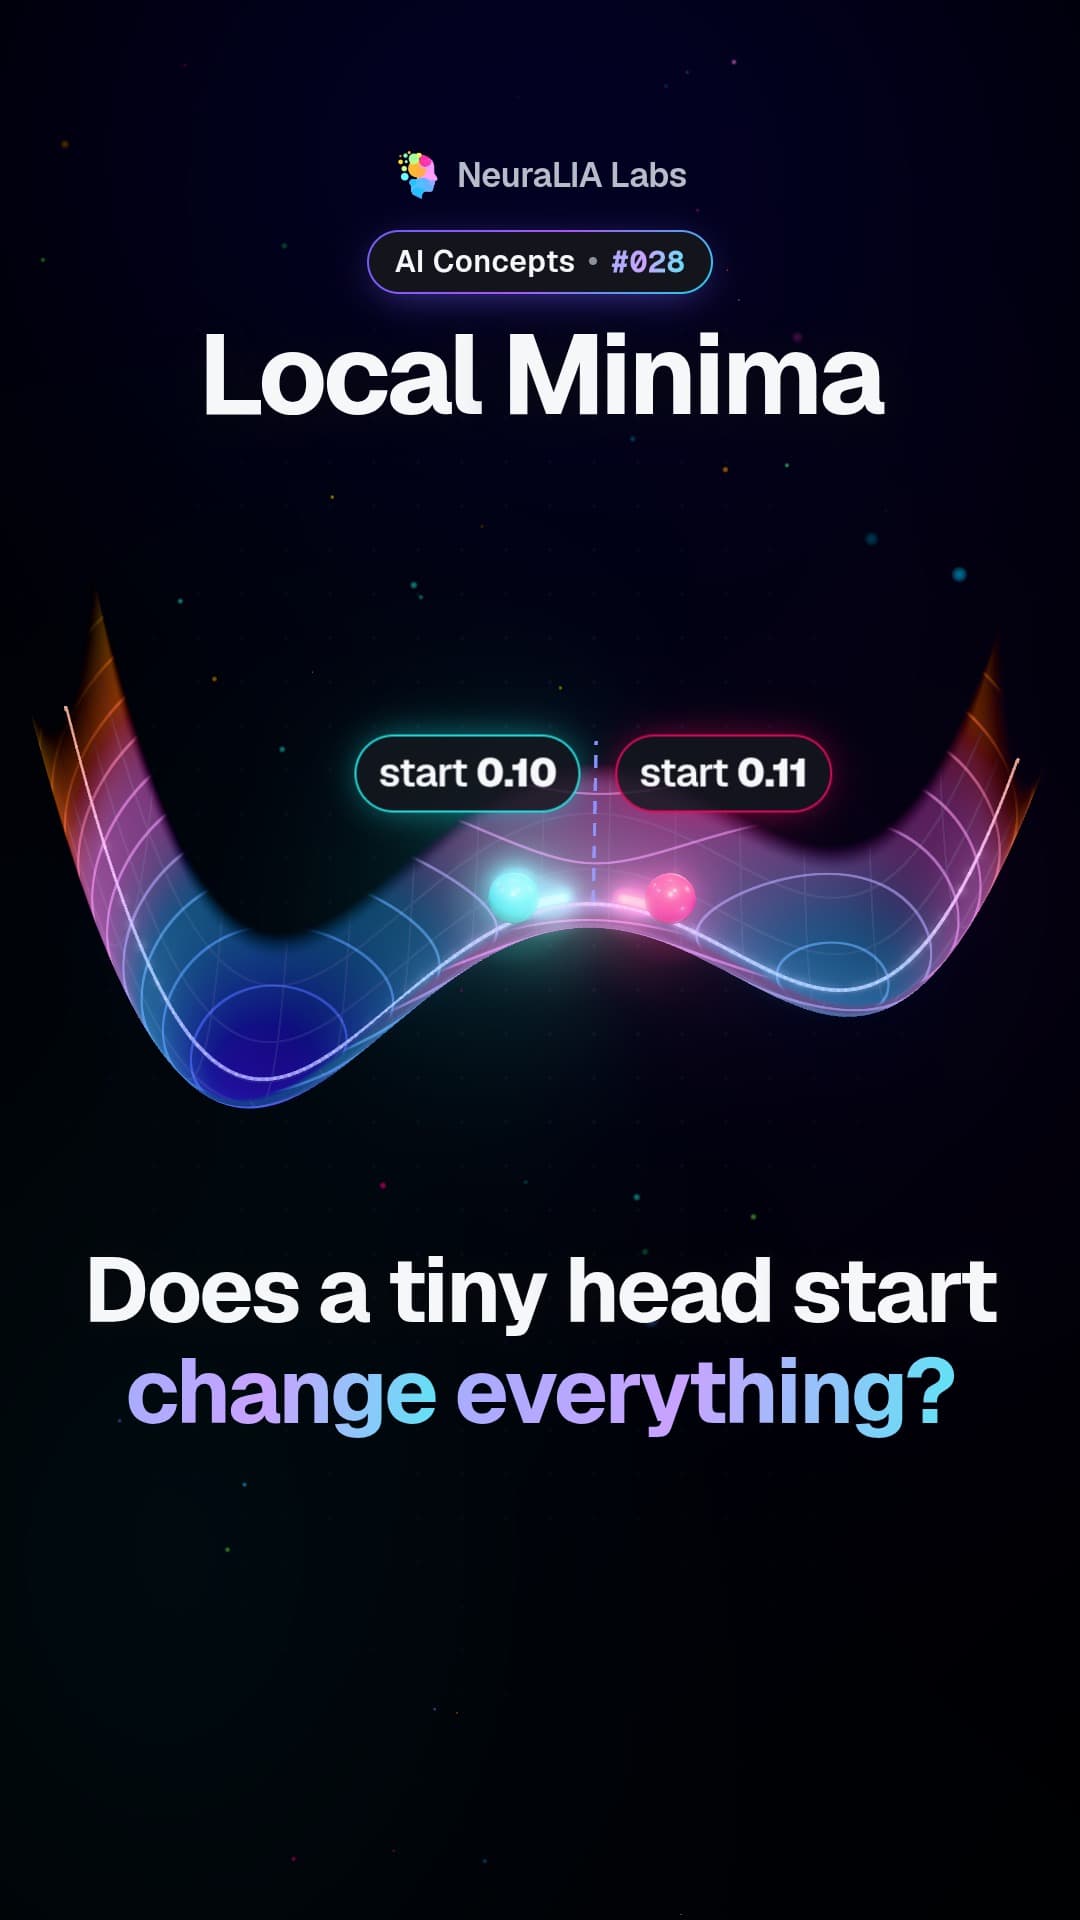 #028
Local minima: why AI training can settle for second best
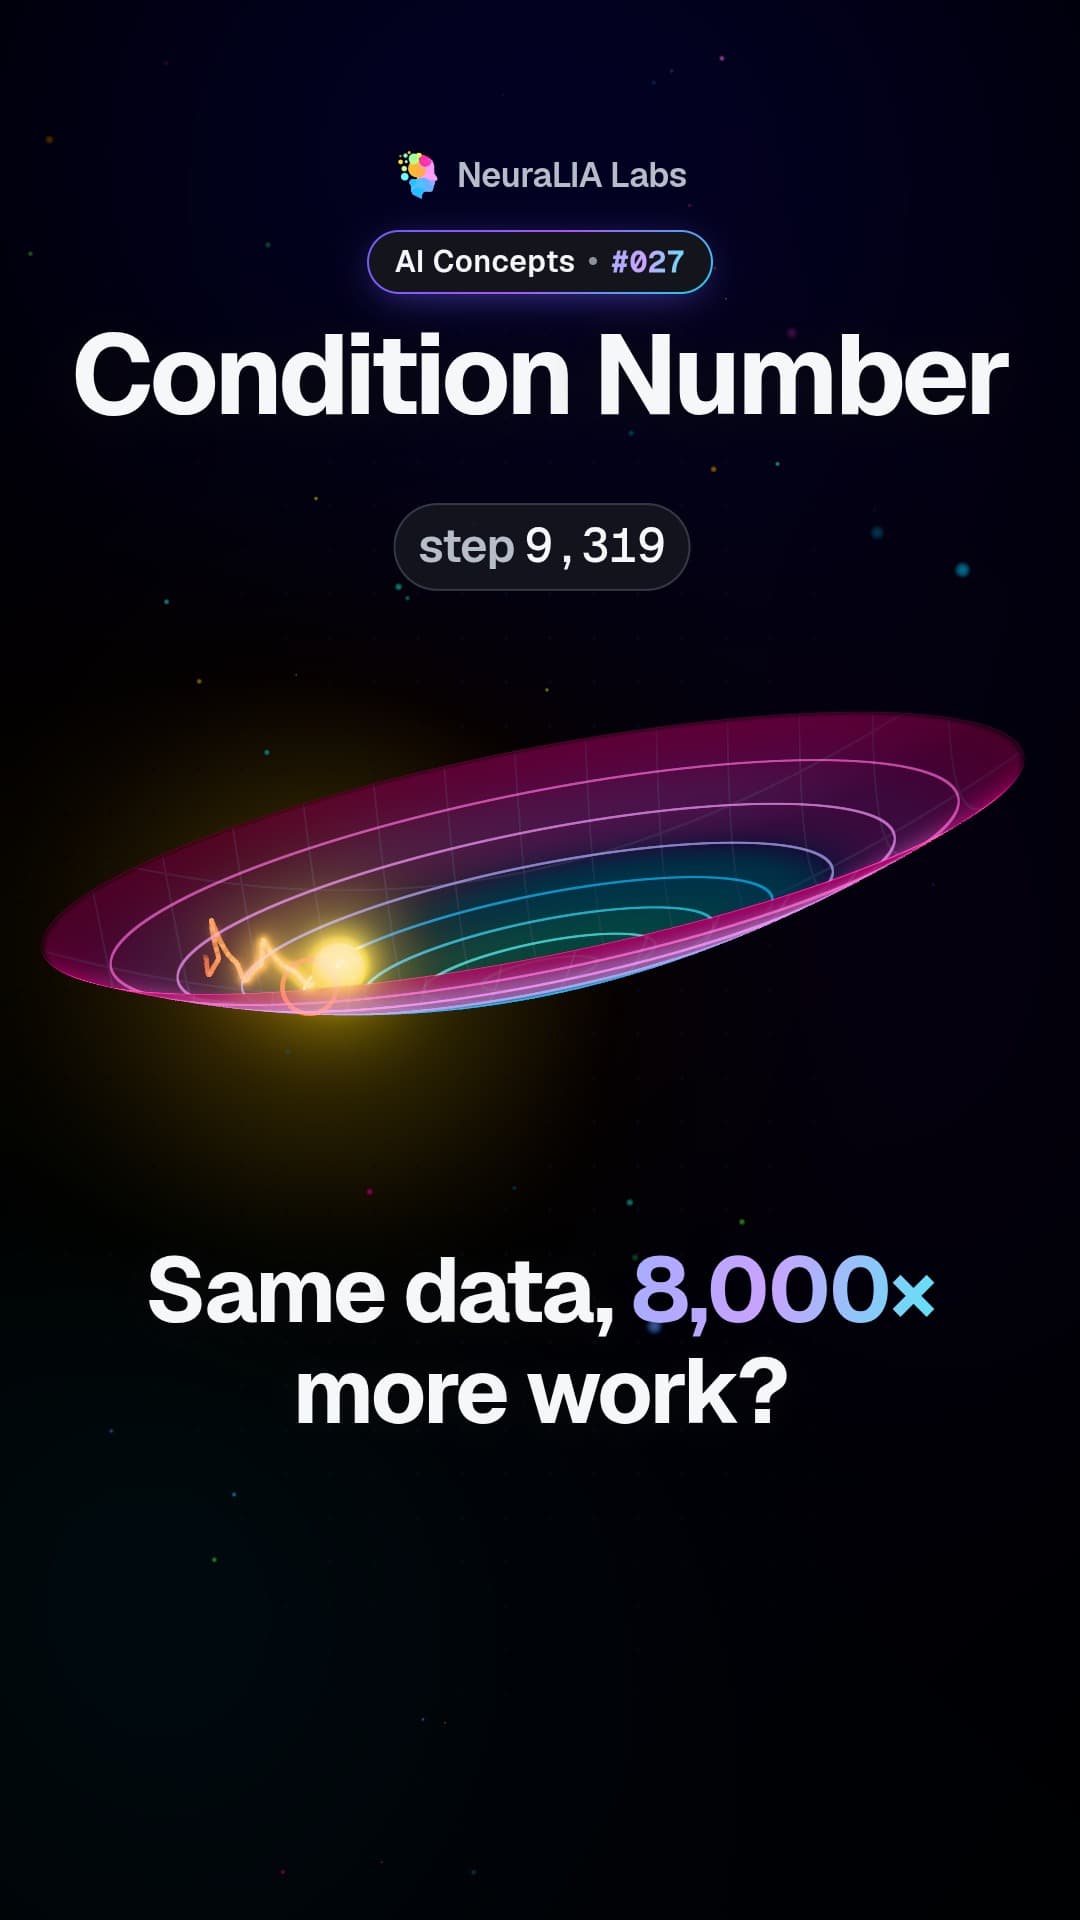 #027
Condition number: why a stretched valley makes AI training crawl
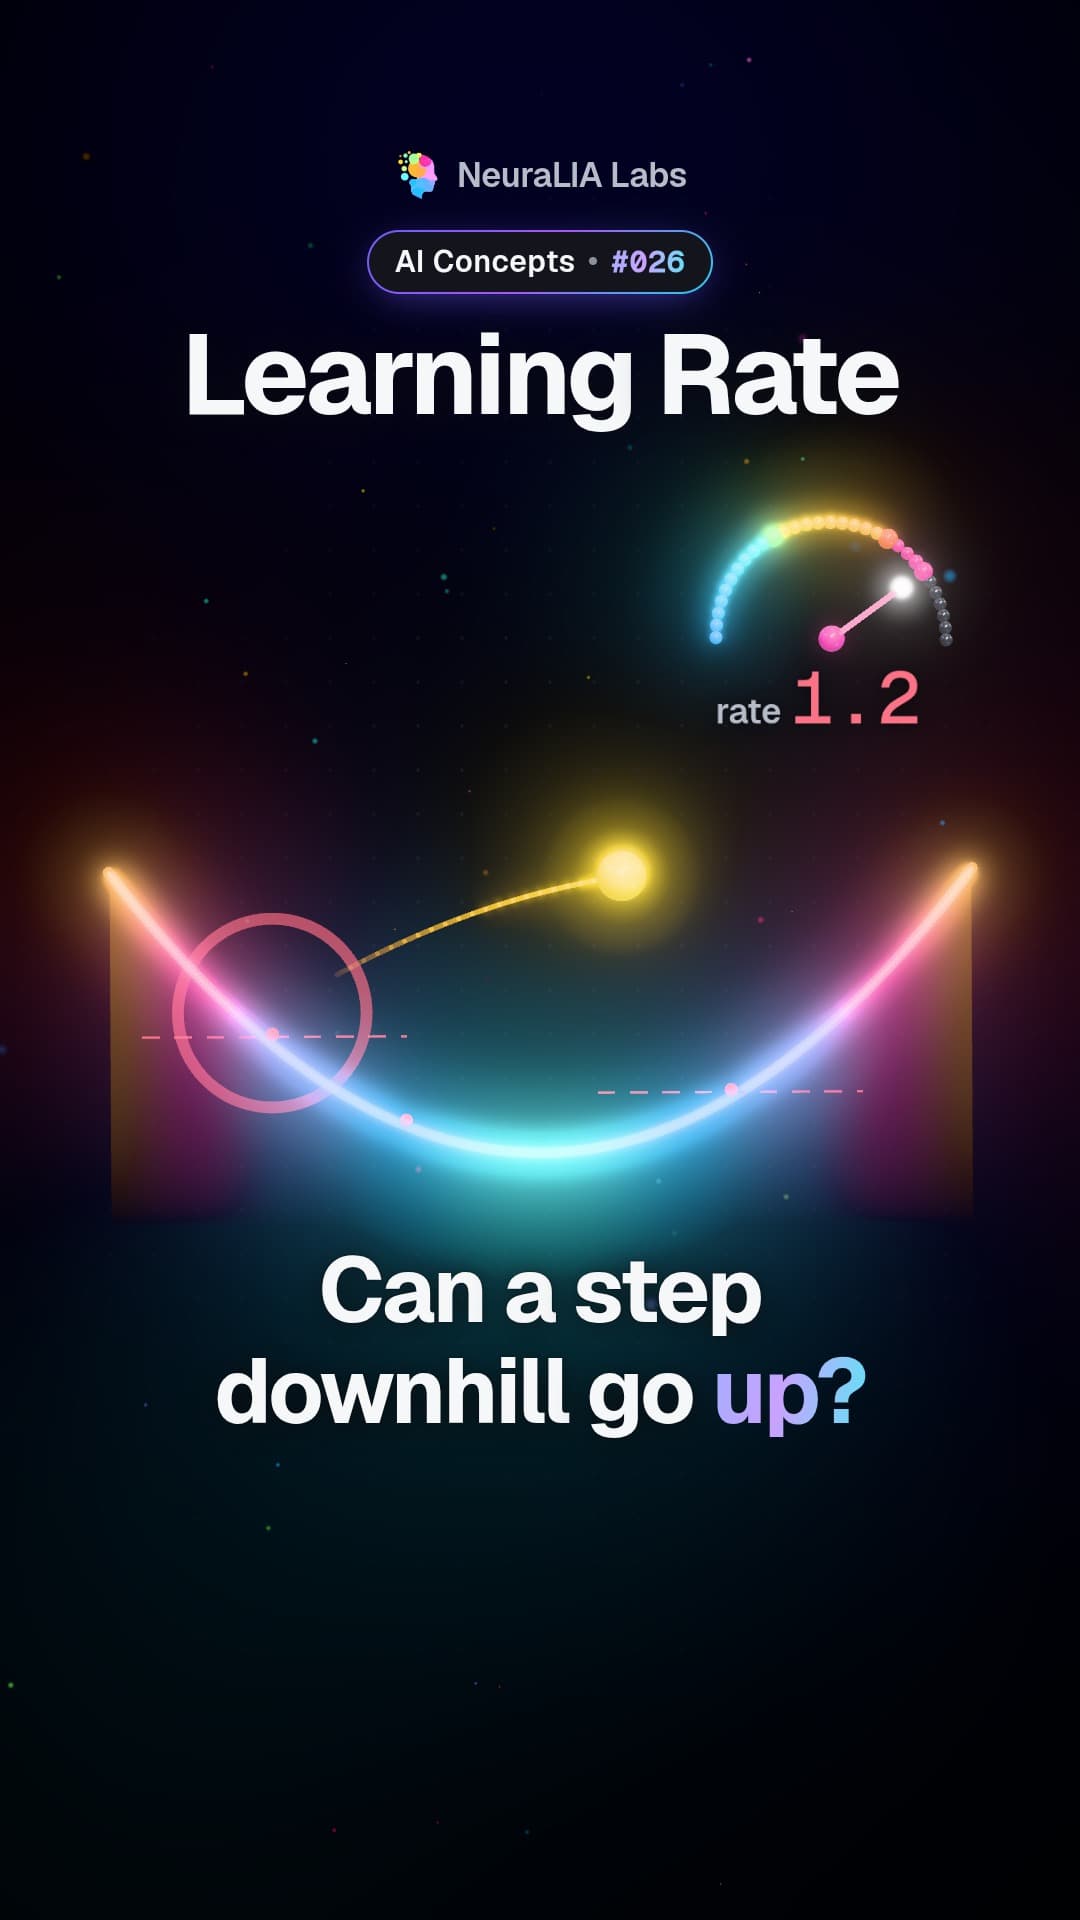 #026
Learning rate: the step size with a ceiling you can calculate
 #025
Gradient descent: how AI finds its way downhill in small steps
 #024
Gradient: the arrow that points uphill, and why AI walks the other way
 #023
Chain rule: how AI traces the effect of every layer
 #022
Derivative: how much the result moves when you nudge one input
 #021
Grid search: why you cannot train an AI by trying every setting
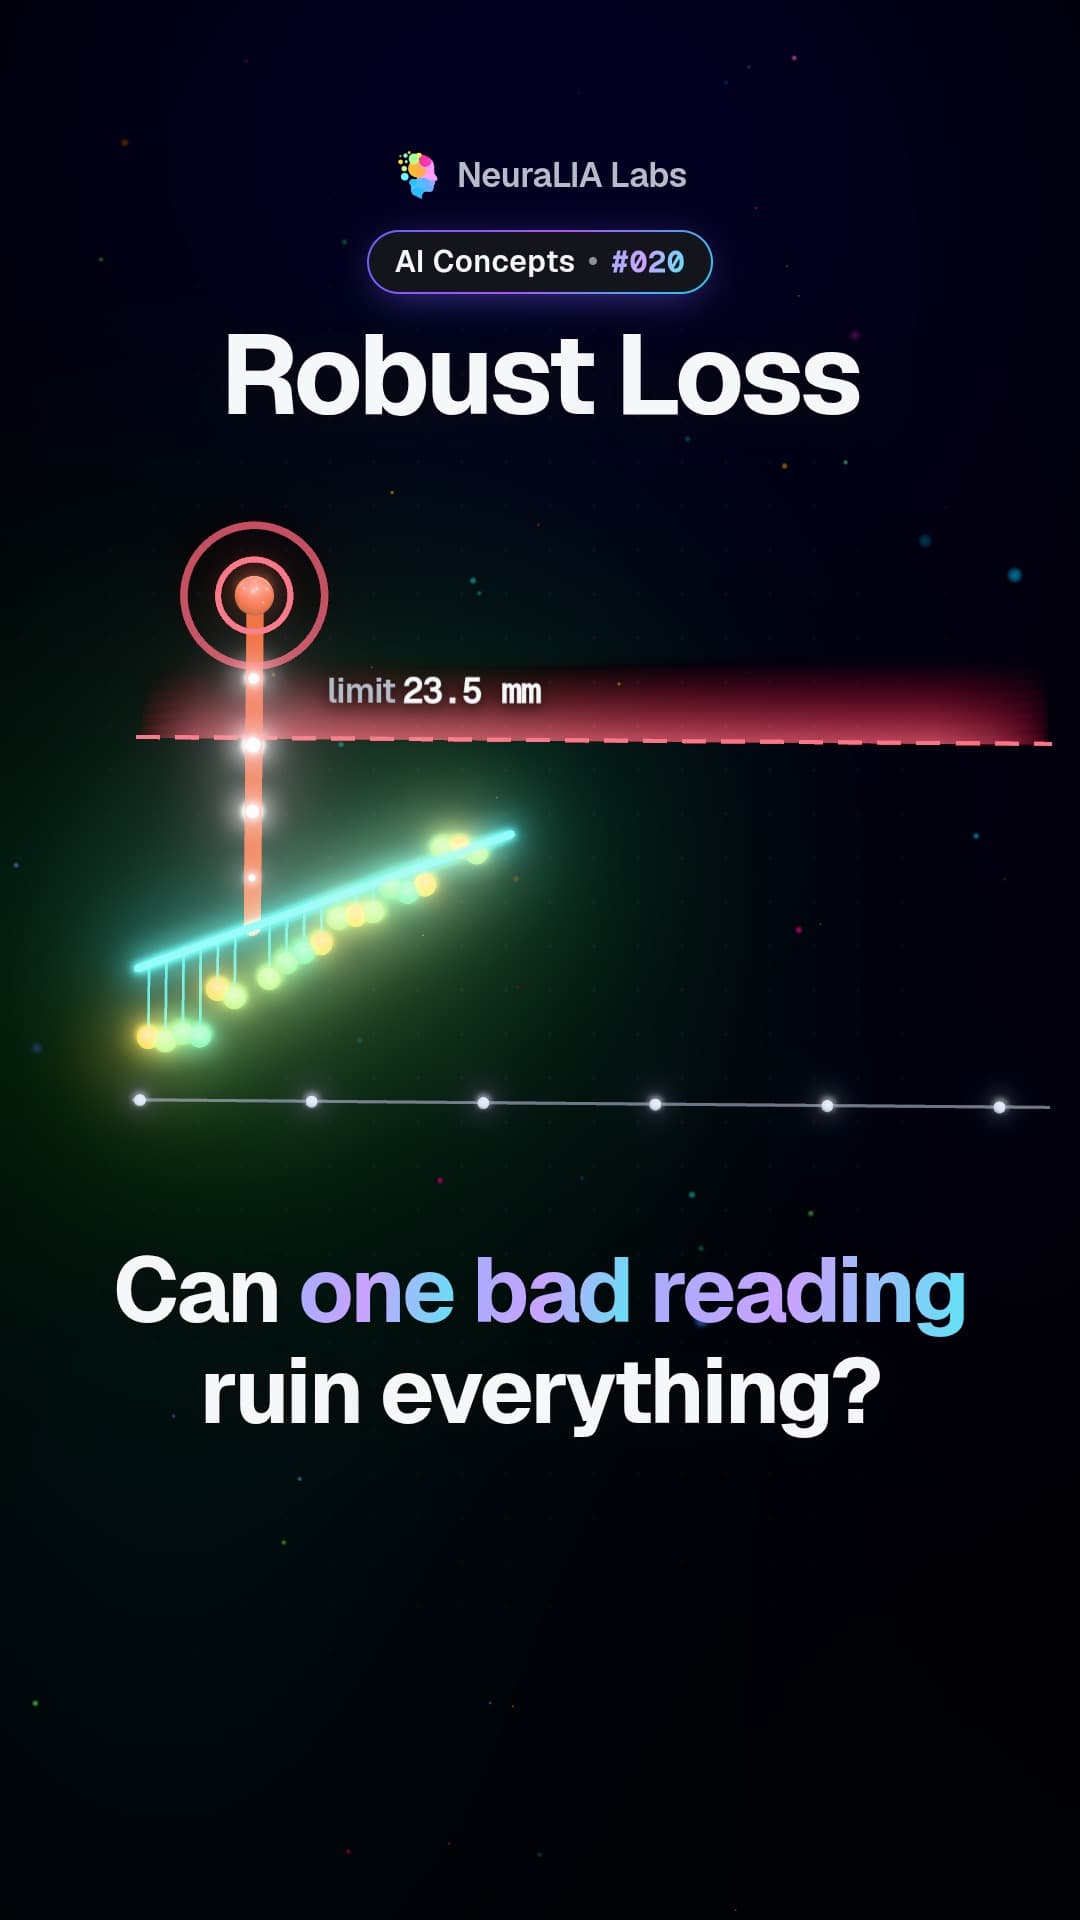 #020
Robust loss: stop one wild reading from wrecking your forecast
 #019
Heavy tails: when rare, huge errors break the usual average
 #018
Mean squared error: the hidden bet behind squaring your mistakes
 #017
The LogSumExp trick: one subtraction that stops AI math overflowing
 #016
Rounding error: why adding the same numbers can give two answers
 #015
Floating-point numbers: why your computer cannot hold every number
 #014
Negative log-likelihood: turning a fragile product into a calm sum
 #013
Maximum likelihood: the answer that makes your data least surprising
 #012
Bayes' rule: reasoning backwards from a clue to its most likely cause
 #011
Chain rule of probability: how AI scores a sentence word by word
 #010
Loss landscape: training an AI means finding the bottom of a valley
 #009
Loss function: the scoring rule that decides which answer wins
 #008
Feature engineering: the human choice that can beat the algorithm
За розділом курсу
- 1Перцептрон з нуля: що обчислює нейрон10 відео
- 2Звідки береться функція втрат: правдоподібність, а не умовність12 відео
- 3Downhill: Gradient Descent і два кроки, які всі пропускають12 відео
- 4Класифікація, перехресна ентропія і як не обдурити себе
- 5Backpropagation з нуля: спершу рушій, потім мережа1 відео
- 6Як змусити мережу навчатися — і узагальнювати
- 7Створюємо BPE Tokenizer: чому ваша модель не може порахувати літери R1 відео
- 8Next-token prediction: embedding і що означає перплексія1 відео
- 9Attention і transformer block, виведені із середнього
- 10Pretraining LLM: дані, обчислення, scaling laws і вартість
- 11Від базової моделі до асистента: SFT, RLHF, DPO і GRPO
- 12Chain of Thought, RLVR і Test-Time Compute: виміряно
- 13Як здешевити inference: KV cache, batching і квантування
- 14Перший production-виклик LLM: стримінг, повтори, тайм-аути
- 15Prompt engineering у цифрах: що змінює output
- 16Context window, tokens і рахунок: виміряно
- 17Температура, top-p і детермінізм, якого у вас немає
- 18Tool Calling і структуровані виходи: контракт, що витримує
- 19RAG у production: chunking, retrieval і чесні цитування
- 20Fine-tune, retrieval чи prompt? Рішення — економічне
- 21Мультимодальне ціноутворення: за що насправді рахують зображення, аудіо та відео
- 22Що таке AI agent: п’ять класичних типів і два конкурентні визначення
- 23Створюємо agent harness: цикл і п’ять способів вийти з нього
- 24Context Engineering: чому ваш agent тупішає на 40-му ході
- 25Multi-agent orchestration: п’ять патернів і коли перемагає один
- 26MCP за специфікацією: що насправді є сервером
- 27Випустити MCP server: TypeScript і Python у вимірах
- 28Agent Skills і SKILL.md: прогресивне розкриття, виміряне
- 29Оцінювання LLM: від публічних benchmark до вашого golden set
- 30Prompt Injection і смертельна тріада: як захистити реального agent