
 #01
Videot
AI selitettynä lyhyillä videoilla
Yksi idea per video, selkeällä kielellä. Jokainen linkittyy ilmaisen kurssimme lukuun, joka selittää aiheen vaihe vaiheelta.
Aloita tästä AI 101
- #01
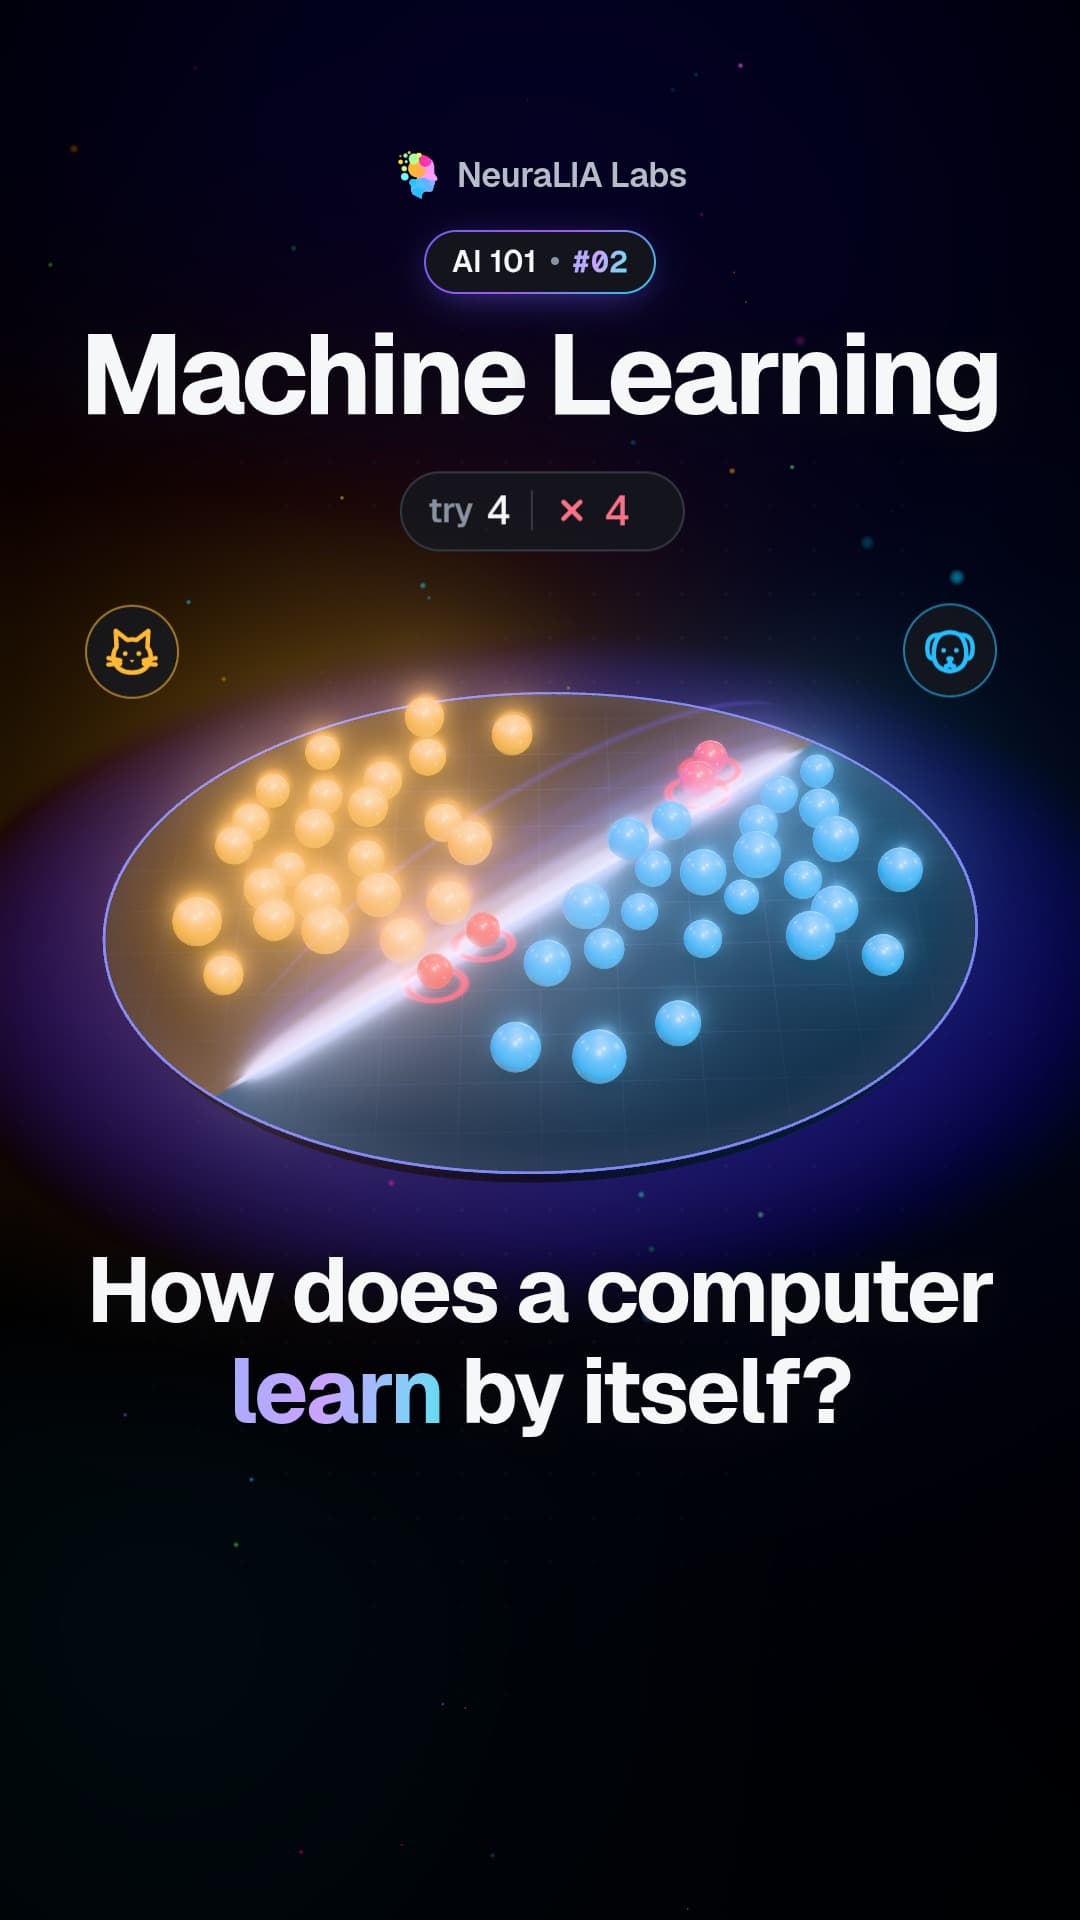 #02
Machine learning: how a computer draws its own dividing line
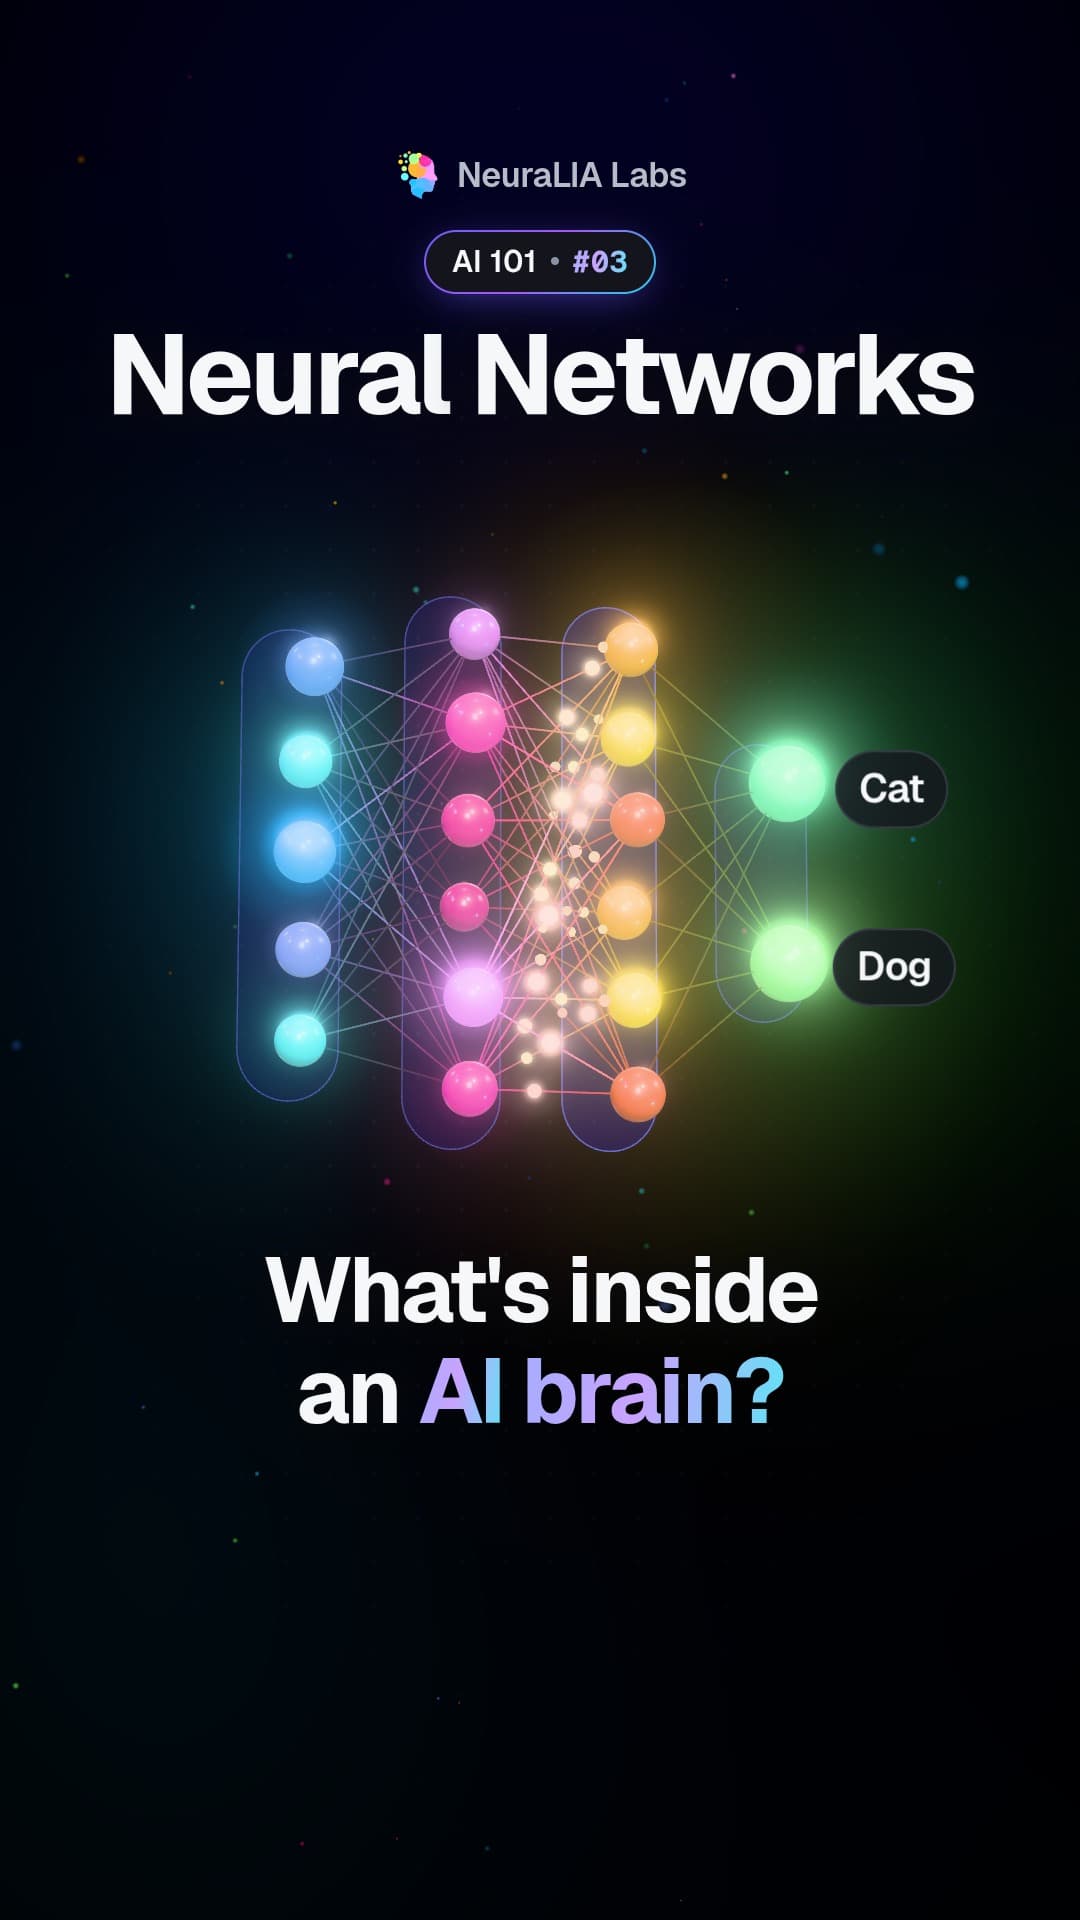 #03
Neural networks: layers of tiny calculators passing signals on
 #04
How AI learns: guess, measure the error, nudge, repeat
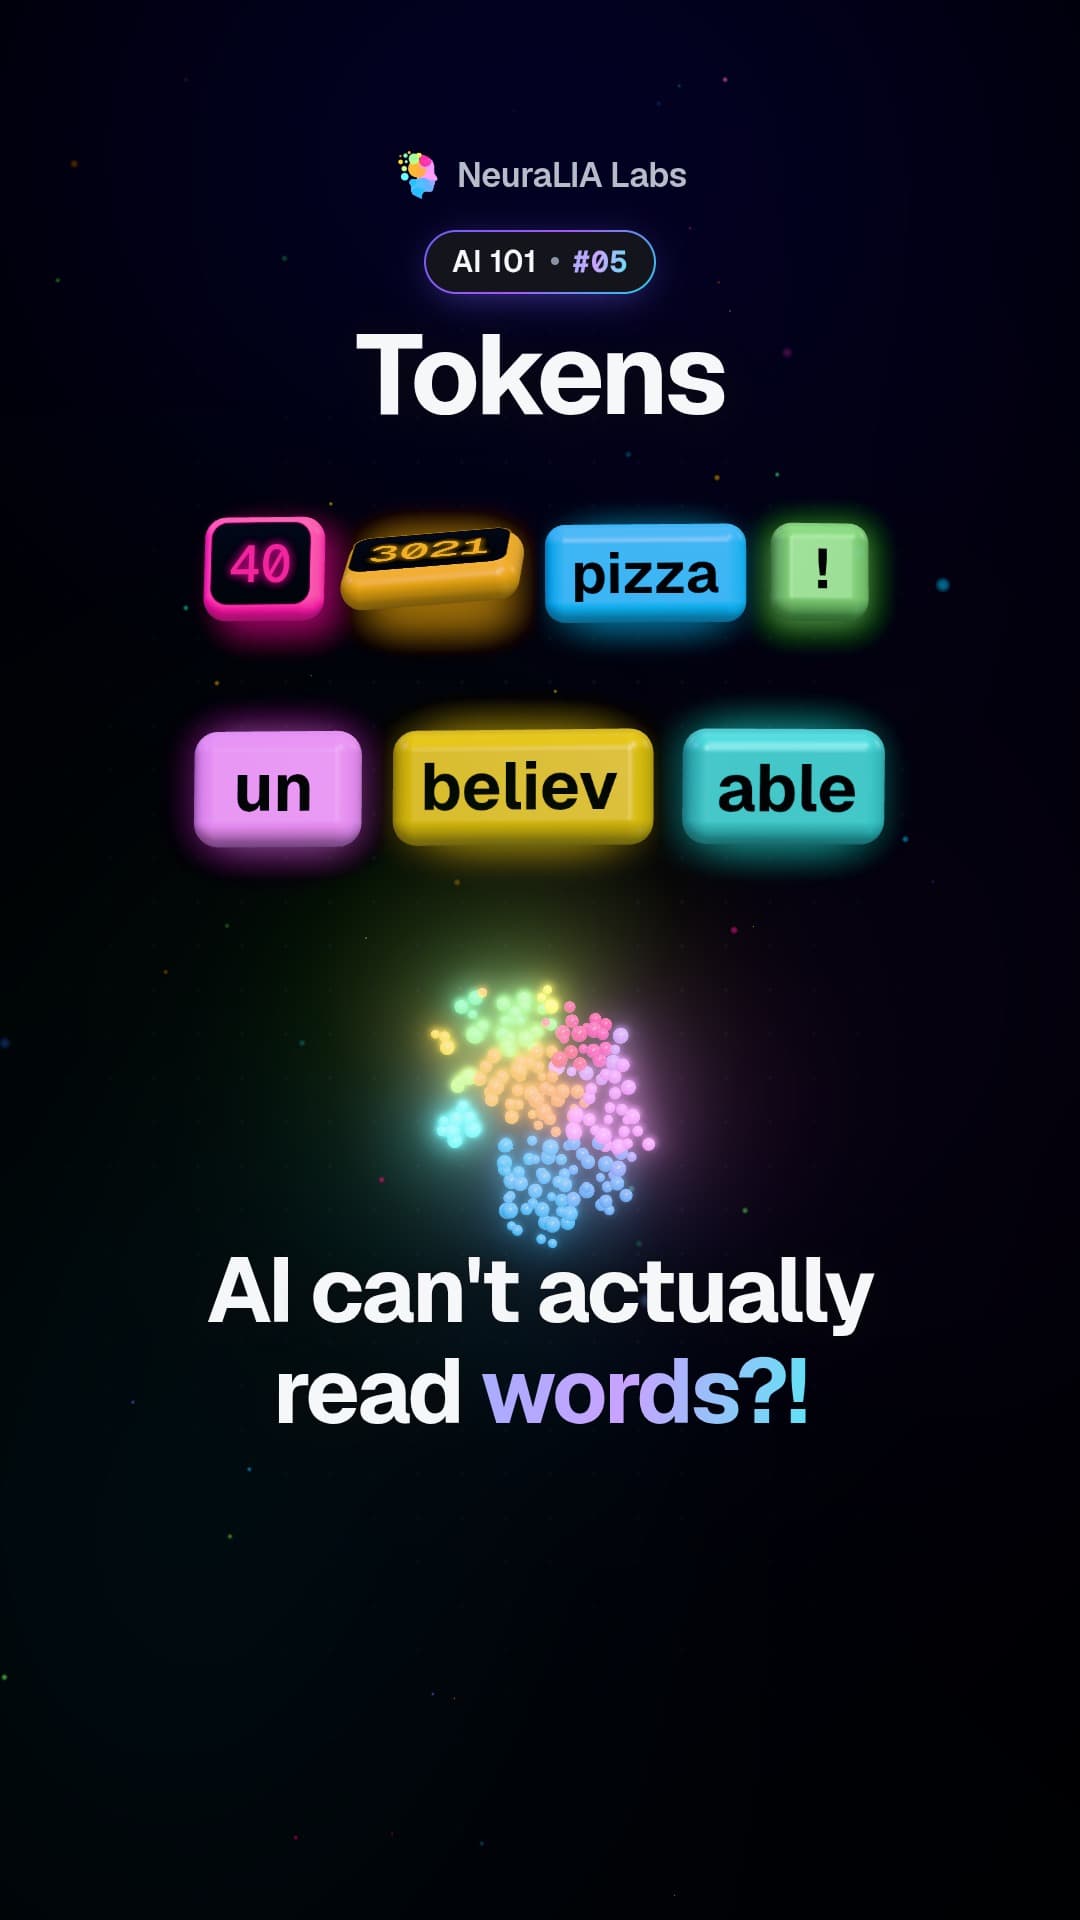 #05
Tokens: how AI chops your words into numbered pieces
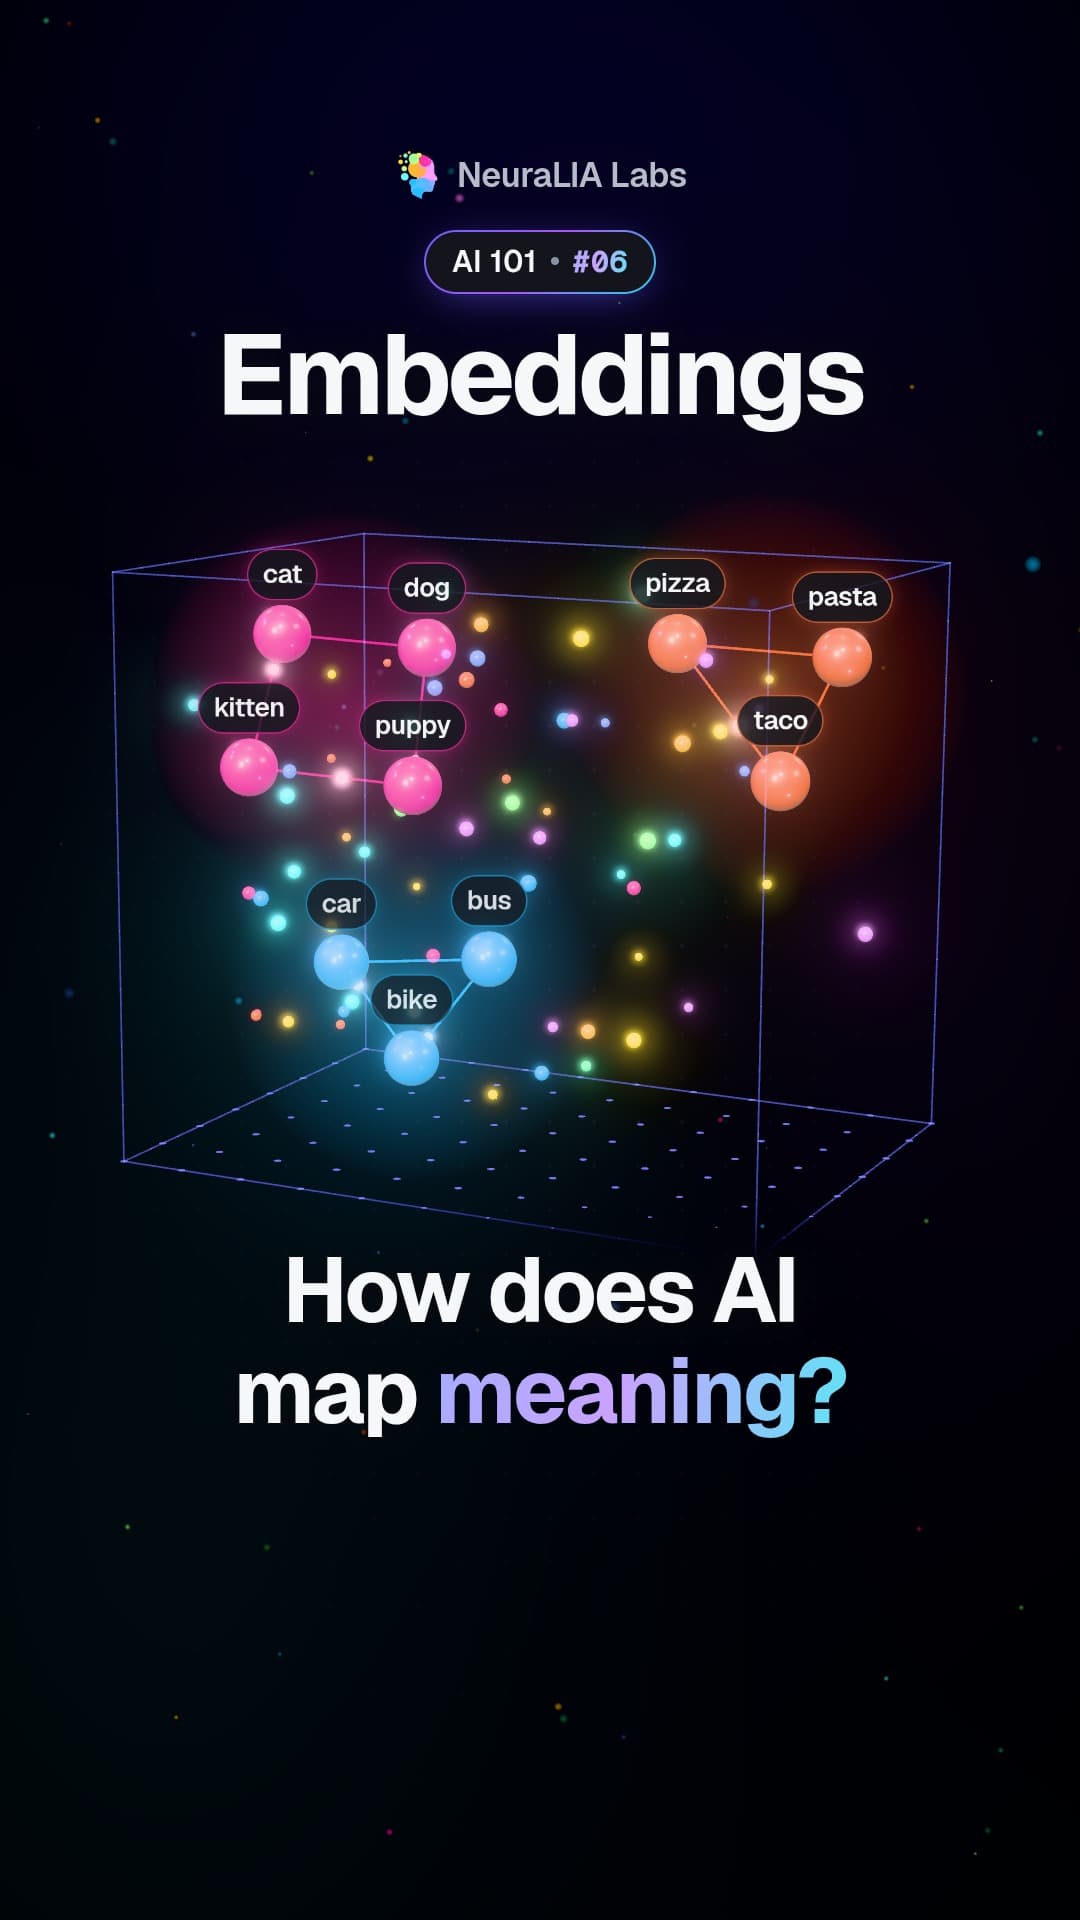 #06
Embeddings: why a puppy lands closer to a dog than to a pizza
Uusimmat
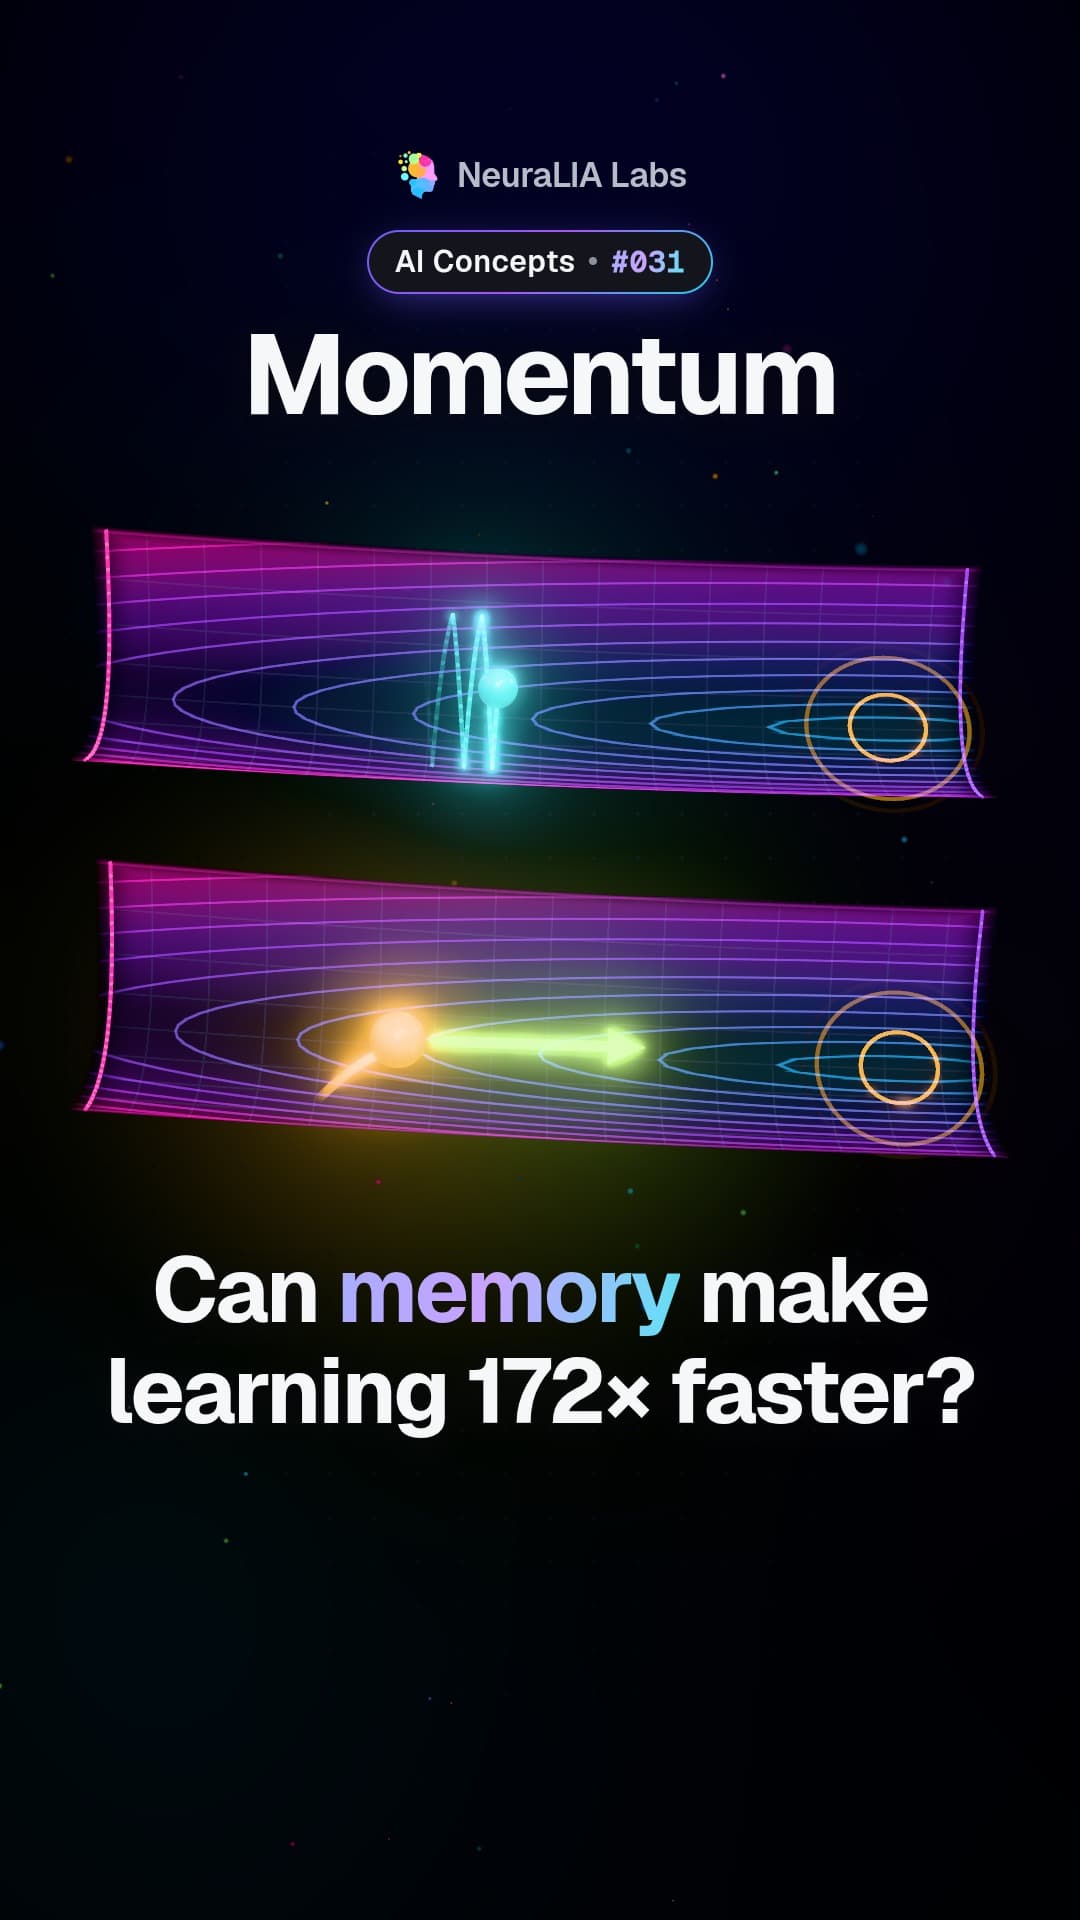 #031
Momentum: how remembering past steps stops AI training zigzagging
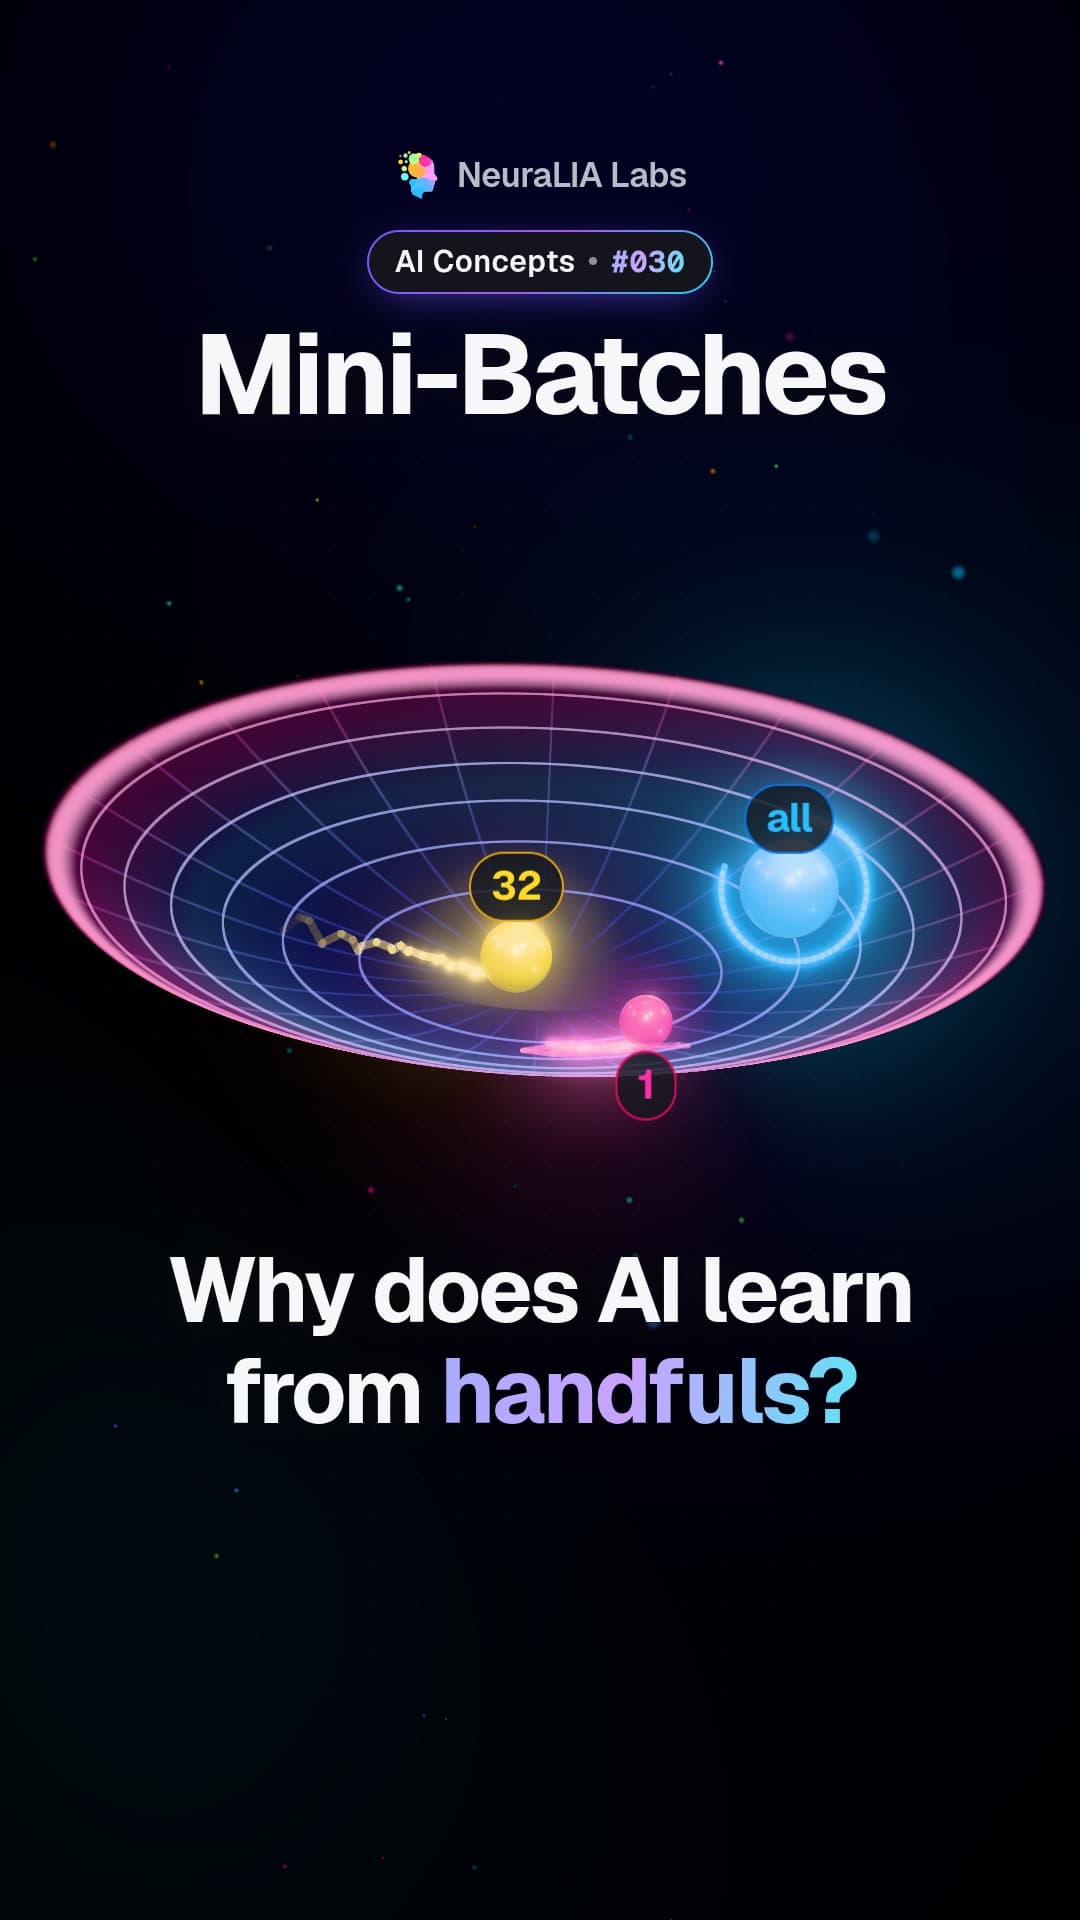 #030
Mini-batches: why AI learns faster from a random handful of data
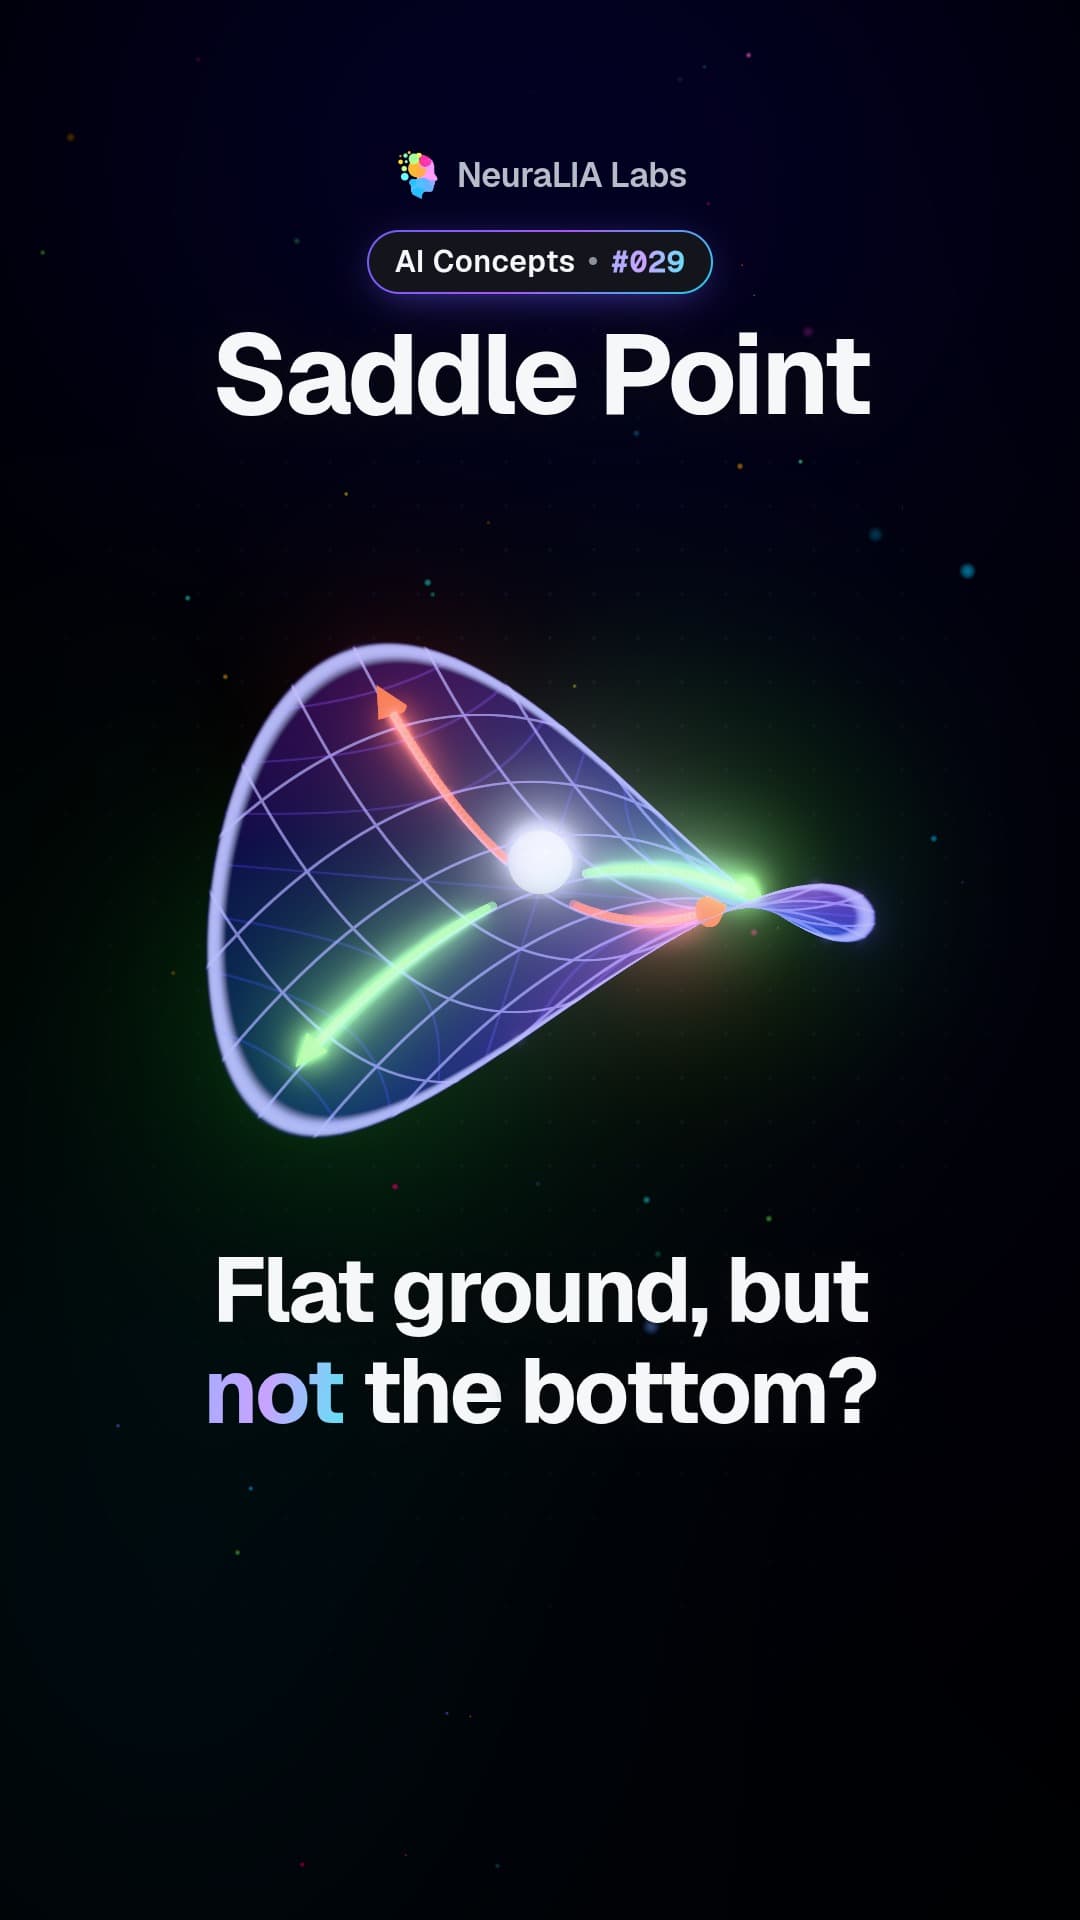 #029
Saddle points: where AI training looks stuck but has a way down
 #028
Local minima: why AI training can settle for second best
 #027
Condition number: why a stretched valley makes AI training crawl
 #026
Learning rate: the step size with a ceiling you can calculate
 #025
Gradient descent: how AI finds its way downhill in small steps
 #024
Gradient: the arrow that points uphill, and why AI walks the other way
 #023
Chain rule: how AI traces the effect of every layer
 #022
Derivative: how much the result moves when you nudge one input
 #021
Grid search: why you cannot train an AI by trying every setting
 #020
Robust loss: stop one wild reading from wrecking your forecast
 #019
Heavy tails: when rare, huge errors break the usual average
 #018
Mean squared error: the hidden bet behind squaring your mistakes
 #017
The LogSumExp trick: one subtraction that stops AI math overflowing
 #016
Rounding error: why adding the same numbers can give two answers
 #015
Floating-point numbers: why your computer cannot hold every number
 #014
Negative log-likelihood: turning a fragile product into a calm sum
 #013
Maximum likelihood: the answer that makes your data least surprising
 #012
Bayes' rule: reasoning backwards from a clue to its most likely cause
 #011
Chain rule of probability: how AI scores a sentence word by word
 #010
Loss landscape: training an AI means finding the bottom of a valley
 #009
Loss function: the scoring rule that decides which answer wins
 #008
Feature engineering: the human choice that can beat the algorithm
Kurssiluvuittain
- 1Perceptron alusta alkaen: mitä neuroni laskee10 videota
- 2Mistä häviöfunktio syntyy: likelihood, ei käytäntö12 videota
- 3Alamäkeen: Gradient Descent ja kaksi askelta, jotka kaikki ohittavat12 videota
- 4Luokittelu, ristientropia ja miten et huijaa itseäsi
- 5Backpropagation alusta asti: ensin moottori, sitten verkko1 video
- 6Miten saada se oppimaan ja yleistämään
- 7Rakenna BPE-tokenizer: miksi mallisi ei osaa laskea R-kirjaimia1 video
- 8Next-token-ennustus: embedding ja mitä perpleksisyys tarkoittaa1 video
- 9Attention ja transformer-lohko keskiarvosta johdettuna
- 10LLM:n esikoulutus: data, laskenta, scaling laws ja kustannus
- 11Perusmallista assistentiksi: SFT, RLHF, DPO ja GRPO
- 12Chain of Thought, RLVR ja test-time compute mitattuna
- 13Halpaa inferenceä: KV cache, batching ja kvantisointi
- 14Ensimmäinen tuotannon LLM-kutsusi: streaming, retries ja timeouts
- 15Prompt engineering mitattuna: mikä muuttaa outputia
- 16Context window, token-kulut ja lasku mitattuina
- 17Temperature, top-p ja determinismi, jota sinulla ei ole
- 18Tool Calling ja rakenteiset tulosteet: sopimus, joka pitää
- 19RAG tuotannossa: chunking, haku ja rehelliset viittaukset
- 20Fine-tuning, retrieval vai prompt? Päätös on taloudellinen
- 21Multimodaalinen hinnoittelu: mitä kuvat, ääni ja video todella laskuttavat
- 22Mikä AI agent on: viisi klassista tyyppiä, kaksi kilpailevaa määritelmää
- 23Rakenna agent harness: loop ja sen viisi poistumistietä
- 24Context engineering: miksi agent muuttuu tyhmemmäksi vuorolla 40
- 25Multi-Agent Orchestration: viisi mallia ja milloin yksi voittaa
- 26MCP selitettynä speksiä vasten: mikä serveri oikeasti on
- 27MCP Server tuotantoon: TypeScript ja Python mitattuina
- 28Agent Skills ja SKILL.md: asteittainen paljastaminen mitattuna
- 29LLM-evaluointi: julkisista benchmarks omaan golden setiin
- 30Prompt Injection ja kuolettava kolmikko: oikean agentin suojaaminen