
Downhill: Gradient Descent і два кроки, які всі пропускають
Обчислюємо точну верхню межу learning rate і дивимось, як brute-force пошук у 3 600 напрямах заново знаходить gradient.
На цій сторінці
Попередній розділ закінчився долиною.
Не метафоричною: справжньою кривою, де loss відкладено відносно одного параметра, вона спускається вниз і знову підіймається. І loss під нею було вибрано не тому, що так охайно, — його вивели з твердження про шум у вимірюваннях, а squared error з’явилася на виході як наслідок, а не як домовленість.
Отже, у нас є ландшафт із дном і причина вважати, що дно — правильне місце. Чого в нас немає, то це способу туди дістатися.
Цей розділ будує такий спосіб, і це алгоритм, який навчає кожну модель у решті цього курсу — кожну без винятку, аж до моделей із сотнями мільярдів параметрів включно. Він уміщується приблизно в двадцять рядків. Дві складні частини не в цих двадцяти рядках, і саме їх майже кожне пояснення пропускає:
- Чому знак мінус. Оновлення віднімає gradient. Кожен tutorial це пише; дуже мало хто пояснює, чому gradient — це напрямок, що веде вгору, а це єдиний факт, який робить знак мінус чимось більшим за акт віри.
- Наскільки великий крок. «Занадто великий — розбігається, занадто малий — повільно» — правда й водночас марно. Є точне число, його можна обчислити з loss, і цей розділ обчислює його двічі — один раз для іграшкової параболи й один раз для реальних даних.
Постановка і чому не можна просто шукати
Посилання на розділ: Постановка і чому не можна просто шукатиПереформулюємо так, щоб цей розділ був самодостатнім: ті самі вісім деталей із конвеєрної стрічки з Розділу 1, але з іншим запитанням. Не прийняти чи відбракувати — це повернеться пізніше, — а передбачити вагу деталі за її шириною.
import numpy as np

WIDTH  = np.array([18.0, 19.5, 20.2, 21.0, 24.0, 25.5, 23.0, 26.0])
WEIGHT = np.array([47.0, 52.0, 49.0, 55.0, 61.0, 66.0, 70.0, 58.0])

x = WIDTH  - WIDTH.mean()      # 22.15 mm
y = WEIGHT - WEIGHT.mean()     # 57.25 g
Вимірювання центровано, точно як у Розділі 1, і з причини, яка ще повернеться з відсотками до кінця цього розділу. Модель — пряма, , а loss — mean squared error, яку попередній розділ вивів:
Два параметри. Чому б просто не перебрати багато значень? Давайте справді це зробимо — сітка від до і від до , з кроком :
grid 501 x 1001 = 501,501 evaluations in 3.67 s
  best found: a = 2.1000, b = -0.0000, L = 24.592450
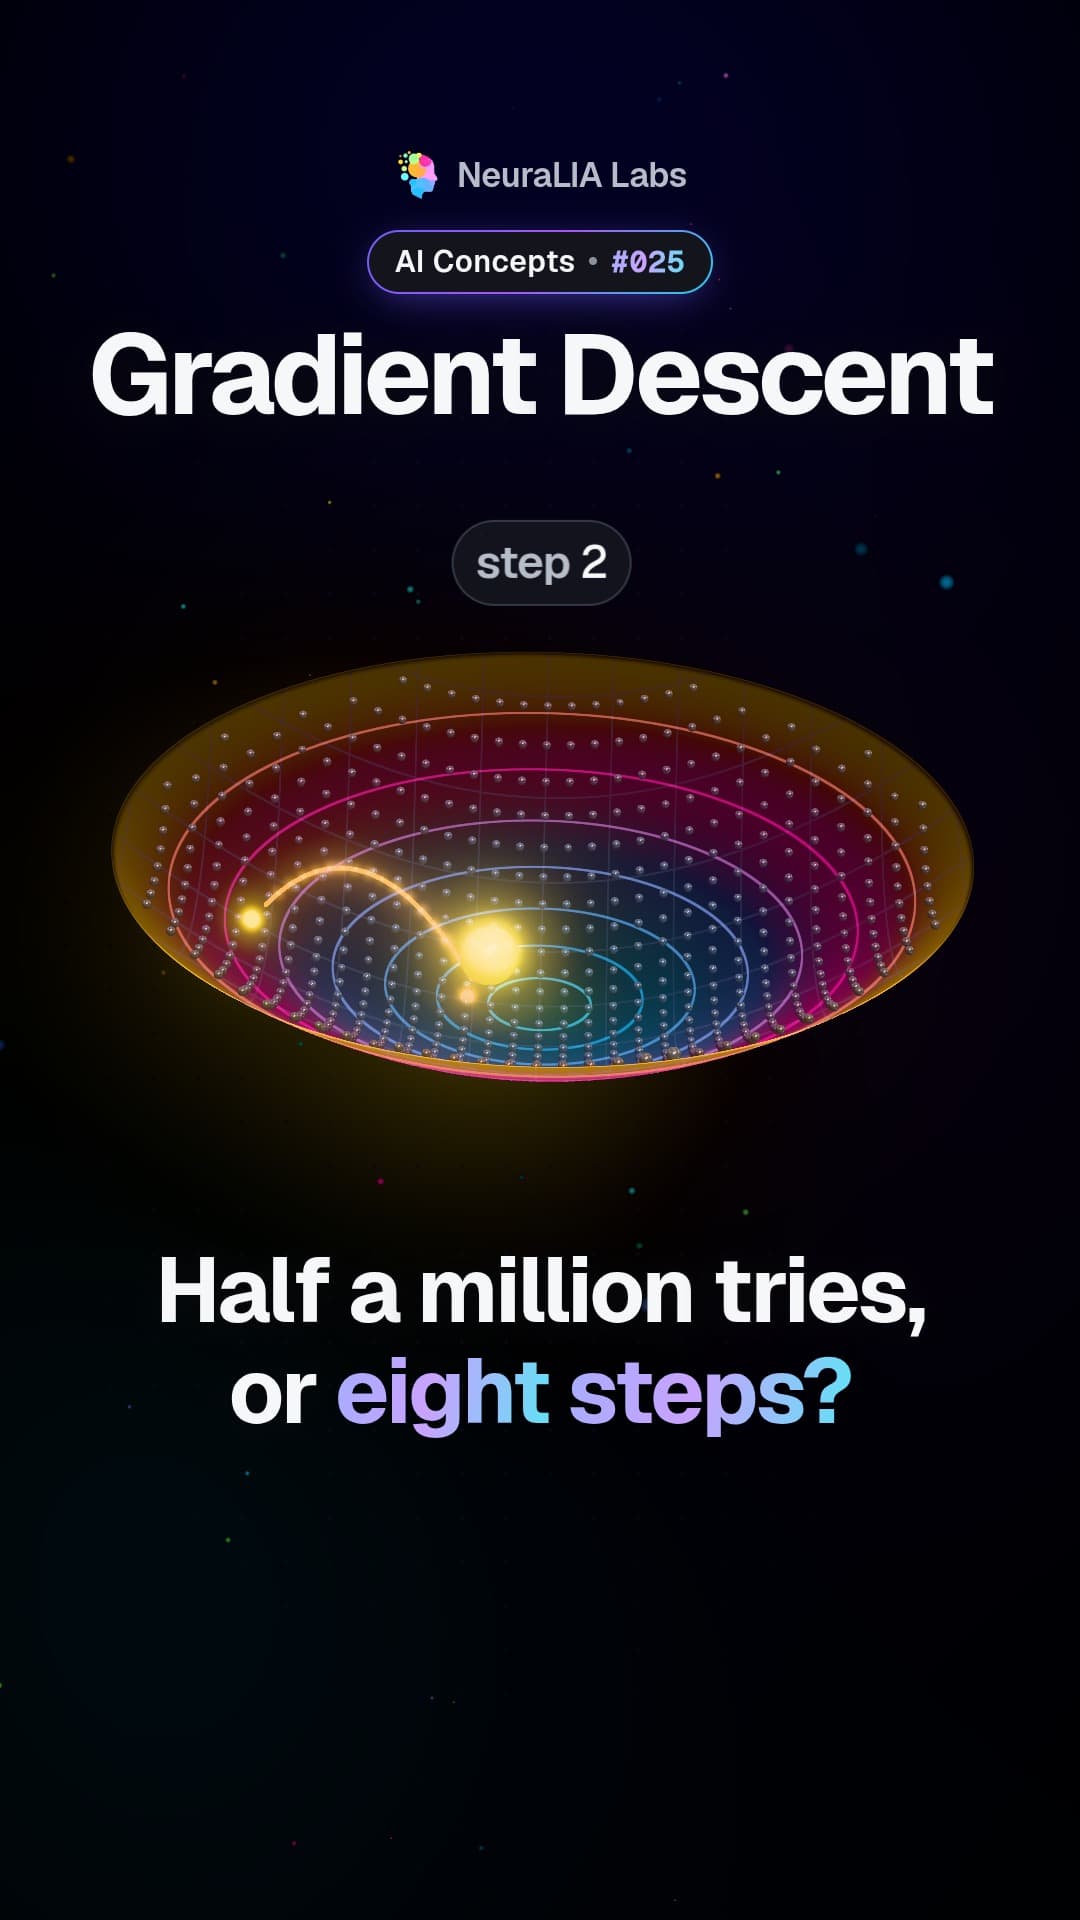
Пів мільйона обчислень, щоб зафіксувати два числа з точністю до двох знаків після коми — і ця секунда є wall clock на одній машині, тож повторний запуск може дати будь-що від трьох до шести; кількість обчислень і мінімум — це частина, що відтворюється. Gradient descent наприкінці цього розділу отримує чотири знаки після коми за вісім кроків і повну float64-відповідь за тридцять шість.
Але швидкість — не головний аргумент, і саме це визначає весь курс. Grid search коштує обчислень для параметрів по значень кожен. Із тисячею значень на вісь:
| модель | параметри | обчислення сітки |
|---|---|---|
| ця пряма | 2 | |
| XOR-мережа з Розділу 5 | 9 | |
| мала багатошарова мережа | 20,000 |
Третій рядок — не велике число, а беззмістовне: в observable universe приблизно атомів. Search не стає повільнішим із ростом моделей; він перестає існувати. Усе, що далі, існує через цю таблицю.
Похідна — це вимірювання, яке можна зробити
Посилання на розділ: Похідна — це вимірювання, яке можна зробитиЗафіксуйте на мить, щоб залишився один параметр і одна крива — саме та картинка, на якій зупинився попередній розділ. Візьміть на ній точку, , і запитайте: якщо я злегка зсуну на малу величину , наскільки зміниться loss на одиницю цього зсуву?
Це відношення — rise over run, нахил прямої, що проходить через дві точки кривої. Коли зменшується, дві точки зсуваються одна до одної, і пряма стає дотичною. Її нахил — це похідна : швидкість, з якою loss змінюється на одиницю зміни . Не наближення чогось і не нескінченно мала величина. Границя звичайних відношень.
Це варто запустити, бо числа говорять те, чого не говорить визначення:
def loss1(a):
    return np.mean((a * x - y) ** 2)

for h in [1.0, 1e-2, 1e-4, 1e-6, 1e-8, 1e-10, 1e-12, 1e-14]:
    q = (loss1(1.0 + h) - loss1(1.0)) / h
print(f"h = {h:<8.0e} slope estimate = {q:.10f} error = {abs(q + 16.385):.3e}")h = 1e+00 slope estimate = -8.9400000000 error = 7.445e+00
h = 1e-02 slope estimate = -16.3105500000 error = 7.445e-02
h = 1e-04 slope estimate = -16.3842555001 error = 7.445e-04
h = 1e-06 slope estimate = -16.3849925556 error = 7.444e-06
h = 1e-08 slope estimate = -16.3850003787 error = 3.787e-07
h = 1e-10 slope estimate = -16.3850444324 error = 4.443e-05
h = 1e-12 slope estimate = -16.3851154866 error = 1.155e-04
h = 1e-14 slope estimate = -17.0530256582 error = 6.680e-01Тут відбуваються дві речі, і обидві несуть вагу конструкції.
Помилка не розмито пропорційна — вона точно дорівнює . Поділіть на сто — помилка ділиться на сто, щоразу до чотирьох значущих цифр. Ця константа — не прикраса: це половина другої похідної loss, і це перша поява ідеї, що повернеться через два розділи: крива біля точки схожа на пряму плюс поправка, пропорційна .
А потім шаблон ламається. Нижче оцінка стає гіршою, а при вона помиляється вже у другій цифрі. Нічого математичного не сталося; спрацювала коробка з floating-point із попереднього розділу. і збігаються в перших десяти цифрах, їх віднімання знищує ці цифри, а ділення уламків на крихітне число підсилює те, що лишилося. Існує найкраще — тут близько , приблизно квадратний корінь із machine epsilon, — і робити менше не означає бути обережнішим, це означає бути менш точним. Запам’ятайте це; від цього залежить функція наприкінці розділу.
Точний нахил із calculus, а не з вимірювання, дорівнює . Отже, можемо припинити вимірювати й почати виводити.
Композиція і chain rule
Посилання на розділ: Композиція і chain ruleОсь ідея, на якій тримається решта курсу, сформульована один раз і прямо.
Компонувати дві функції означає подати одну на вхід іншої: . І нічого більше.
Глибока мережа не схожа на композицію. Вона є композицією. Шар — це функція; складання шарів — це їх композиція; «глибина» — це кількість функцій у ланцюзі. Коли Розділ 5 будує мережу, він будує і нічого іншого. А це означає, що найважливіше правило calculus для наших цілей — те, яке диференціює композицію:
Швидкості множаться. Якщо змінюється втричі швидше за , а — удвічі швидше за , тоді змінюється вшестеро швидше за . У цьому весь зміст, і саме тому сигнал, що проходить назад через десять шарів, множиться на десять чисел — тому Розділ 6 витрачає секцію на те, що відбувається, коли всі ці числа трохи менші за одиницю.
Застосуймо це до нашого loss. Запишемо residual , так що . Кожен залежить від через внутрішню функцію , чия похідна дорівнює . Chain rule, член за членом:
Ці фігурні символи позначають часткову похідну: диференціюйте за однією змінною, а всі інші вважайте сталими. Нічого нового не відбувається — це та сама границя, що й раніше, тільки взята вздовж однієї осі. Зберіть часткові похідні у вектор — і маєте gradient:
У точці цей вектор дорівнює . Два числа. Питання в тому, що вони означають, і це перший крок, який усі пропускають.
Чому gradient вказує вгору
Посилання на розділ: Чому gradient вказує вгоруGradient — це вектор нахилів уздовж осей. Це все, що ми довели. Не очевидно — і не має бути очевидно, — що збирання їх у вектор дає щось, що вказує в якийсь конкретний бік.
Тож визначимо те, що нам справді потрібно. Виберіть одиничний вектор , напрямок. Похідна за напрямком — це швидкість, з якою loss змінюється, коли ви рухаєтеся в цьому напрямку:
Chain rule перетворює це на те, що можна обчислити. Рух уздовж змінює зі швидкістю і зі швидкістю , а внески додаються:
Швидкість зміни в будь-якому напрямку — це dot product gradient із цим напрямком. І тепер кульмінація, один рядок геометрії. Записавши dot product через кут між векторами,
оскільки має довжину 1. Єдине, що ви контролюєте, — це , яке найбільше при і найменше при півоберті, градусів. Отже:
- Найкрутіший підйом — уздовж самого , і нахил там точно дорівнює .
- Найкрутіший спуск — уздовж , і нахил там дорівнює .
- Перпендикулярно до gradient loss узагалі не змінюється. Саме тому лінії на контурній карті перетинають gradient під прямим кутом.
Ось звідки знак мінус. Не домовленість, не flip знака, який хтось вибрав: напрямок найшвидшого зменшення — це від’ємний gradient, бо мінімізується при півоберті, і з жодної іншої причини.
Оскільки це твердження про всі напрямки, перевіримо його на всіх напрямках. Візьмемо 3 600 із них, по одному на кожну десяту частину градуса, і виміряємо кожен легким зсувом:
theta = np.array([1.0, 4.0])
g = grad(theta)
print("gradient      ", g)
print("its length    ", np.linalg.norm(g))
print("its angle     ", np.degrees(np.arctan2(g[1], g[0])) % 360, "degrees")

best = max(
    ((loss(theta + 1e-6 * u) - loss(theta - 1e-6 * u)) / 2e-6, np.degrees(ang))
    for ang, u in (
        (a, np.array([np.cos(a), np.sin(a)])) for a in np.arange(3600) * 2 * np.pi / 3600
    )
)
print("steepest slope", best[0], "at", best[1], "degrees")gradient [-16.385 8. ]
its length 18.23371122399386
its angle 153.97598928042032 degrees
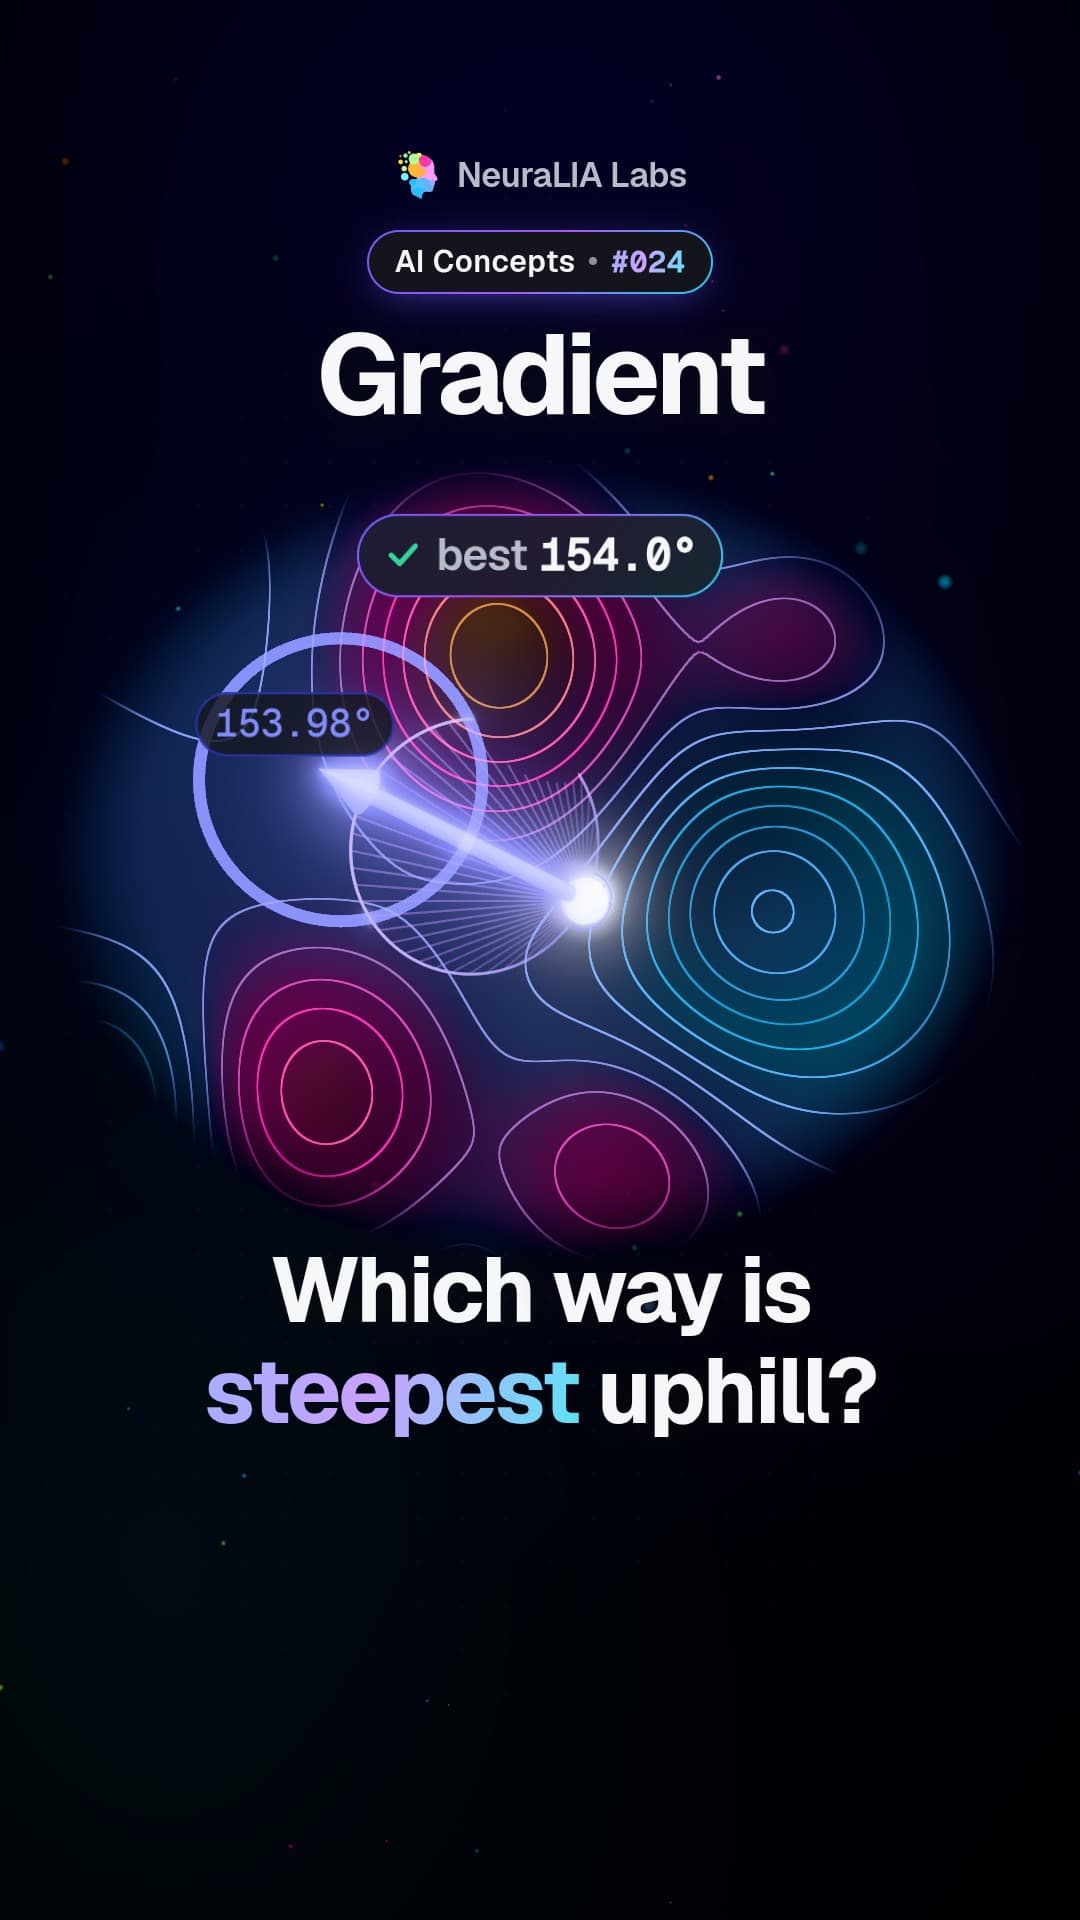
steepest slope 18.233709624837502 at 154.0 degreesSearch, який нічого не знає про gradients, серед 3 600 напрямків знаходить найкрутіший підйом на 154.0 градусах — у власному напрямку gradient, з точністю до 0.1-градусної роздільності search. І нахил, який він там знаходить, 18.2337, — це довжина gradient до шести цифр. Теорема — не історія про те, що означають gradients; це вимірюваний факт, і ось його вимірювання.
Чому малий крок униз справді допомагає
Посилання на розділ: Чому малий крок униз справді допомагаєТепер другий пропущений крок. Ми знаємо, куди вниз. Із цього не випливає, що рух у цей бік зменшить loss, бо «вниз» — це твердження про нескінченно малий зсув, а крок не нескінченно малий.
Місток — це лініаризація. Поблизу точки гладка функція — це її дотична плюс поправка:
Це Taylor expansion першого порядку. Відкинутий — це кривина, той самий член, через який оцінка в таблиці нахилів була хибною рівно на . Підставимо крок, який збираємося зробити, :
Loss падає на . Кожна частина цього виразу невід’ємна, тож обіцянка реальна — для достатньо малого , бо занедбаний член росте як і зрештою з’їдає її. Це вся теорія. Ось обіцянку виконано, а потім зламано:
eta = 0.2       promised    66.49364500   delivered   -16.01619240   ratio -0.240868
eta = 0.1       promised    33.24682250   delivered    12.61936315   ratio  0.379566
eta = 0.01      promised     3.32468225   delivered     3.11840766   ratio  0.937957
eta = 0.001     promised     0.33246822   delivered     0.33040548   ratio  0.993796
eta = 0.0001    promised     0.03324682   delivered     0.03322620   ratio  0.999380
eta = 1e-05     promised     0.00332468   delivered     0.00332448   ratio  0.999938
Читайте знизу. Коли зменшується, отримане падіння збігається з обіцяним — ratio 0.99938, потім 0.99994, — тобто Taylor theorem працює. Читайте згори: при отримане «падіння» дорівнює мінус шістнадцять. Крок ішов вниз, а loss зріс.
Тож правило оновлення таке:
і воно має умову, яку ніхто не озвучує: має бути достатньо малим. Достатньо малим порівняно з чим саме — тема наступного розділу.
Learning rate має верхню межу, і її можна обчислити
Посилання на розділ: Learning rate має верхню межу, і її можна обчислитиПочнімо з найпростішої долини, , де . Один крок gradient descent:
Позиція множиться на на кожному кроці. Це геометрична послідовність, а в геометричних послідовностей є рівно одне правило: вони стискаються, коли множник менший за 1 за абсолютною величиною, і ростуть інакше. Отже , тобто .
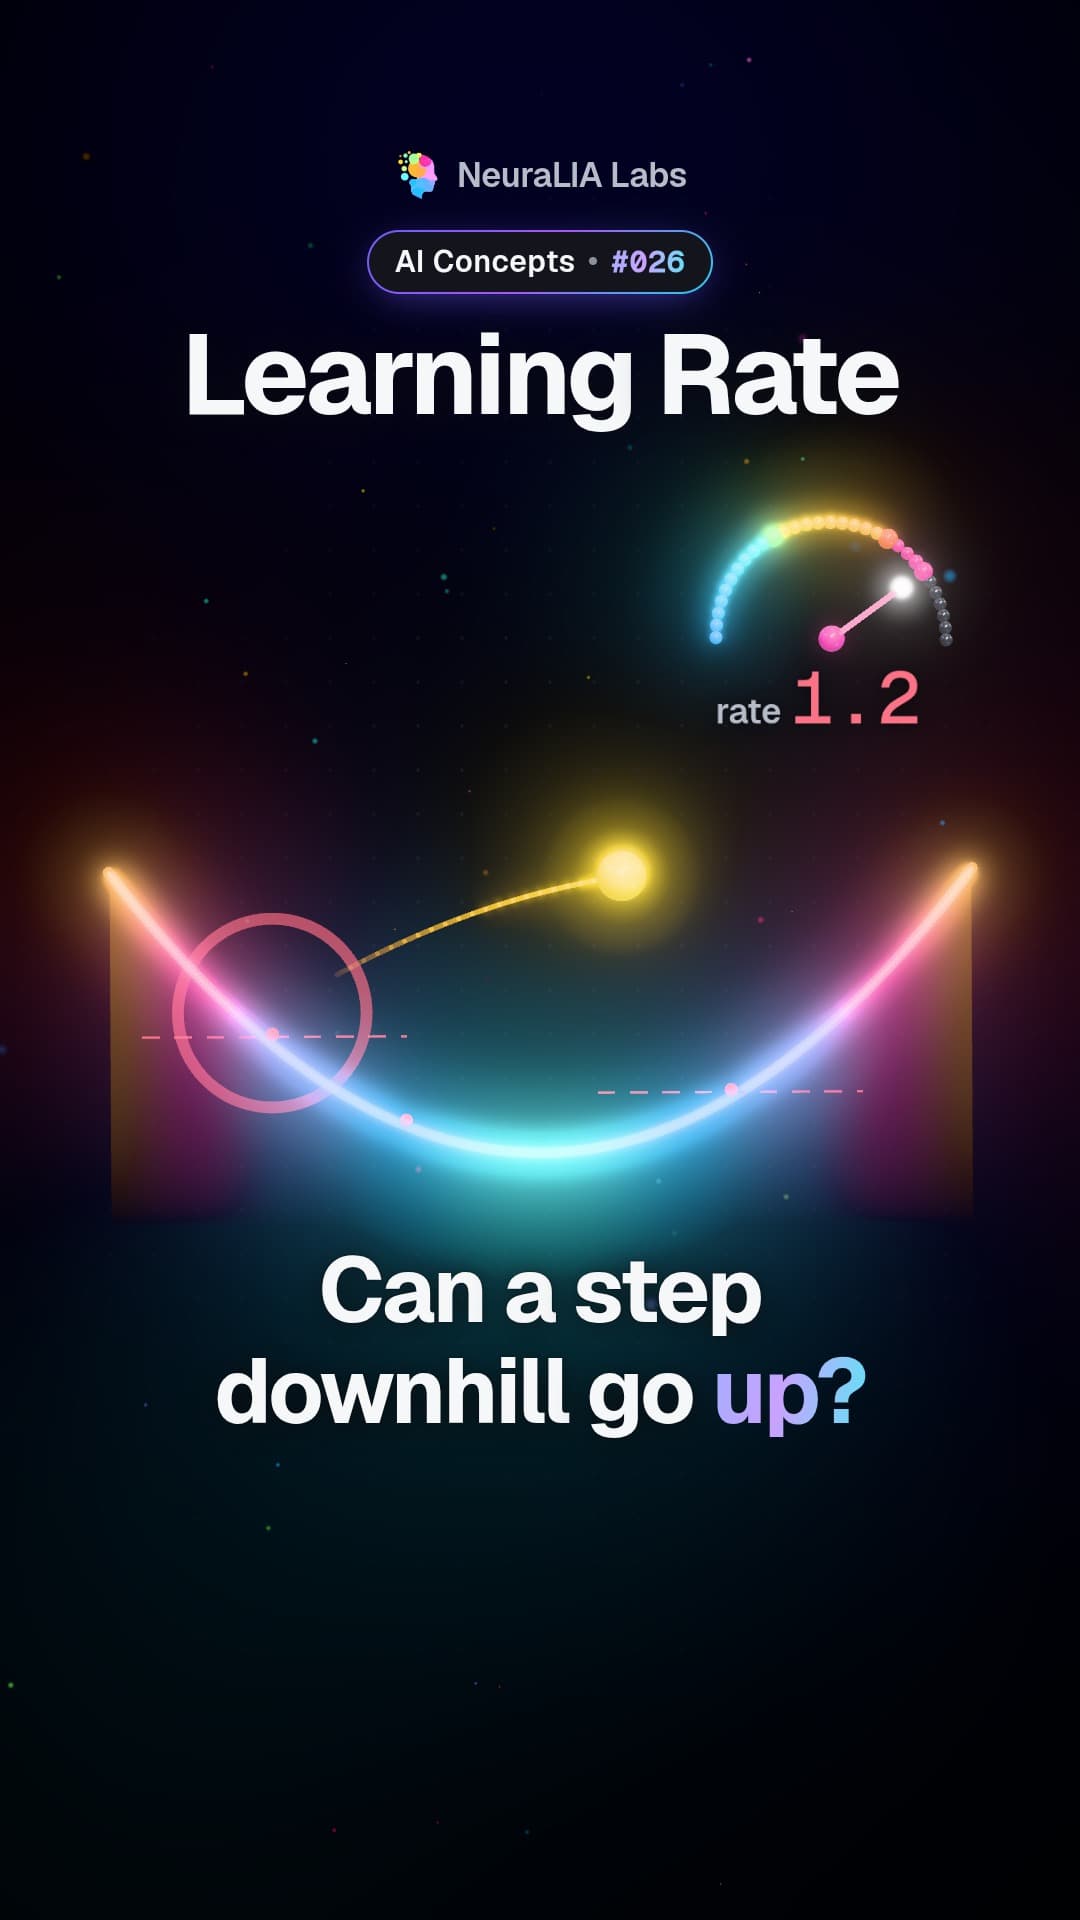
Межа рівно в . Не «приблизно 1», не «1 зазвичай завелике». При множник дорівнює , і точка вічно відскакує між і , не наближаючись і не тікаючи. Нижче — convergence; вище — divergence. Інтервал ділиться ще раз у , де множник змінює знак: нижче підхід монотонний, вище точка перескакує через дно й чергує боки, а рівно при множник дорівнює 0, і один-єдиний крок потрапляє в мінімум.
Чотири режими з чотирьох рядків алгебри. Перетніть межі самі:
А тепер цікавий випадок:
Тепер загальне правило, яке випливає з того самого аргументу. Множник насправді був , а біля мінімуму multi-parameter loss має по одному такому числу для кожного напрямку — eigenvalues матриці других похідних. Кожен напрямок має бути стабільним одночасно, тому межу задає найбільше з них:
Для , , межа 1, саме те, що ми щойно вивели. Для нашої стрічки матриця других похідних — це , де — двостовпцева матриця inputs, а її eigenvalues дорівнюють 2 і 14.89, тож межа — . Це прогноз із п’ятьма значущими цифрами. Перевіримо:
lr=0.1343    -> L =      24.5924
lr=0.13431   -> L =      24.5924
lr=0.13432   -> L =       4707.8       BLEW UP
lr=0.13433   -> L =  4.00452e+16       BLEW UP
lr=0.1344    -> L = 1.18229e+107       BLEW UP
П’ять знаків після коми збігу між одним рядком лінійної алгебри і ста тисячами ітерацій циклу for.
І ось тут повертається Розділ 1. Усе вище використовувало центровані вимірювання. Запустіть ідентичний код на сирих міліметрах і грамах — і eigenvalues будуть 0.0298 та 998.1 замість 2 і 14.89. Межа обвалюється з 0.134 до 0.002004 — так само точно, зі convergence при lr=0.002003 і вибухом при lr=0.002004.
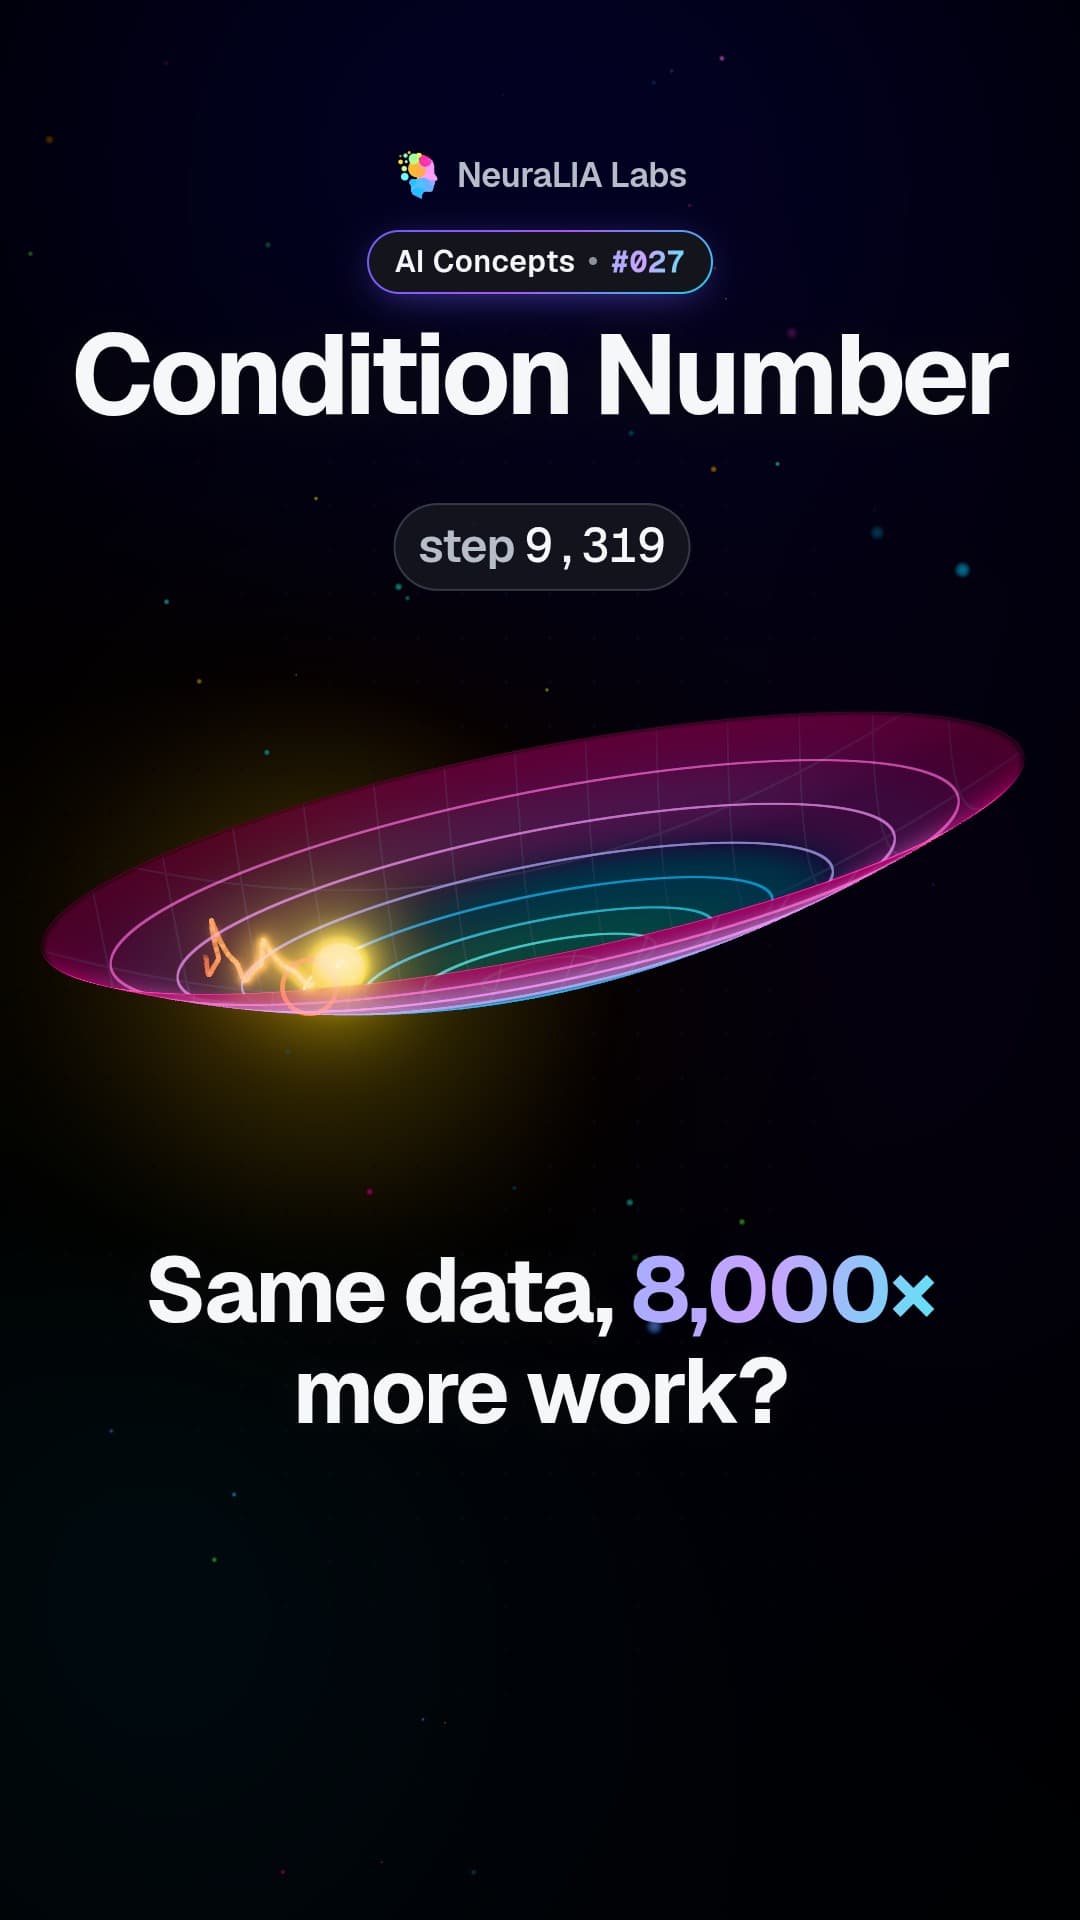
Гірше за межу — ratio між eigenvalues. Condition number вимірює, наскільки долина далека від круглої: довгий тонкий рів змушує взяти rate достатньо малий для крутих стінок, а потім дном рову доводиться повзти з тією самою швидкістю. У нас він змінюється з 7.44 для центрованих даних до 33,452 для сирих. Із найкращим rate, який може взяти кожна версія:
| features | condition number | найкращий rate | кроки до межі 1% від optimum |
|---|---|---|---|
| центровані | 7.44 | 0.1184 | 10 |
| сирі міліметри й грами | 33,452 | 0.0020037 | 79,513 |
Ті самі дані, той самий код, та сама відповідь наприкінці — і у вісім тисяч разів більше роботи, бо ніхто не відняв mean. У Розділі 1 та сама omission коштувала perceptron коефіцієнта шість тисяч в epochs, і діагноз там був геометричним: дані плавали далеко від початку координат. Тут та сама геометрія в костюмі optimisation, і саме тому input normalisation — не порада про гігієну, а арифметика.1
Двадцять рядків
Посилання на розділ: Двадцять рядківУсе вище не потребувало бібліотеки. Ось увесь optimiser.
def loss(theta):
    a, b = theta
    return np.mean((a * x + b - y) ** 2)


def grad(theta):
    a, b = theta
    residual = a * x + b - y
    return np.array([np.mean(2 * residual * x), np.mean(2 * residual)])


def descend(theta, lr, steps):
    theta = np.array(theta, dtype=float)
    for _ in range(steps):
        theta = theta - lr * grad(theta)
    return theta


theta = descend([0.0, 0.0], lr=0.05, steps=60)
print(theta, loss(theta))[ 2.10040296e+00 -2.76445533e-15] 24.592448791134984Closed-form least-squares відповідь для цих восьми точок — , , із loss . Цикл знайшов її до восьми значущих цифр, не знаючи, що closed form узагалі існує, — і це важливо, бо від Розділу 5 її вже не буде.
Траєкторія, бо саме заради цього її варто побачити:
   0 a=0.000000 b=0.000000 L=57.437500
   1 a=1.563750 b=0.000000 L=26.736582
   2 a=1.963288 b=-0.000000 L=24.732418
   5 a=2.098116 b=-0.000000 L=24.592488
  10 a=2.100400 b=-0.000000 L=24.592449
  60 a=2.100403 b=-0.000000 L=24.592449
Більшу частину відстані пройдено за перші два кроки, бо gradient найбільший, коли ви найдалі від дна, і зменшується, коли наближаєтесь. Gradient descent автоматично сповільнюється біля мінімуму. Це перевага, а в Розділі 6 — ще й проблема.
Де ще нахил дорівнює нулю
Посилання на розділ: Де ще нахил дорівнює нулюУ нашому аргументі досі є діра. Крок зупиняється, коли , і ми називали це «мінімумом». Точка з нульовим gradient — це критична точка, і бути мінімумом — лише один зі способів бути нею:
- локальний мінімум: вгору в кожному напрямку, але, можливо, це не найнижча така точка взагалі;
- локальний максимум: вниз у кожному напрямку;
- сідлова точка: вгору в одних напрямках і вниз в інших. Поверхня має , що дорівнює нулю в початку координат, де функція є мінімумом уздовж осі і максимумом уздовж осі одночасно.
Gradient descent не може їх розрізнити, бо він завжди дивиться лише на gradient, а gradient дорівнює нулю в усіх трьох випадках.
Наша пряма має одну критичну точку, і це відповідь — squared-error loss над лінійною моделлю є convex, одна-єдина чаша, і descent на ній не може не знайти global minimum. Ця властивість не переживає зіткнення з цим курсом. Loss neural network не є convex, і від Розділу 5 «мінімум» — не річ, яка існує: мінімумів багато, різної глибини, а який отримаєте ви, залежить від того, звідки стартували. Це одне речення і лишається одним реченням, бо теорія велика, а практичний наслідок малий.
Увесь наслідок видно на одній кривій. Візьміть , яка має дві долини різної глибини:
   x =  -1.046681   f(x) =  -0.352386   minimum
   x =   0.101031   f(x) =   0.005026   maximum
x = 0.945649 f(x) = -0.152639 minimumПотрапляння в мілку долину дає loss на 56.7% гірший, і алгоритм ніяк не може цього знати, бо зсередини долини кожен напрямок веде вгору. У gradient descent немає ремонту для цього, і він не з’явиться. Натомість на практиці є спостереження, що це значно менш важливо, ніж підказує ця картинка: у дуже високих вимірах реальної мережі більшість критичних точок виявляються сідлами, а не пастками,2 і Розділ 5 вимірює, як часто мала мережа справді застрягає.
Дешевші кроки: stochastic, minibatch, momentum
Посилання на розділ: Дешевші кроки: stochastic, minibatch, momentumОдна річ у grad вище має вас непокоїти: він сумує по всьому dataset для кожного кроку. Вісім деталей — ніщо. Мільйон — це мільйон gradient computations, щоб зрушити параметри один раз.
Вихід у тому, що gradient — це середнє, а середнє можна оцінити за sample. Обчисліть його на випадковій жменьці — minibatch — і зробіть крок за ним. Оцінка шумна; вона також unbiased, і сотні дешевих шумних кроків перемагають один дорогий точний. На ста тисячах synthetic parts, рахуючи per-example gradients, а не кроки:
| method | кроки до межі 0.1% від optimum | per-example gradients |
|---|---|---|
| full batch | 7 | 700,000 |
| minibatch з 32 | 100 | 3,200 |
| по одному example за раз | 17,580 | 17,580 |
У двісті дев’ятнадцять разів менше арифметики, щоб дійти до того самого місця. І крайній випадок — по одному example за раз, оригінальна stochastic approximation Роббінса й Монро3 — не перемагає: він уп’ятеро гірший за batches по 32, бо 32 examples майже нічого не коштують понад один на hardware, що множить матриці, тоді як шум спадає з квадратним коренем batch size. Саме через цей компроміс кожен training script, який ви коли-небудь прочитаєте, матиме batch_size.
Momentum — інше дешеве виправлення, і воно спрямоване прямо на рів. У погано conditioned долині кроки зигзагують через вузький напрямок, повільно просуваючись уздовж довгого. Momentum тримає running average минулих gradients, тож oscillating компоненти взаємно гасяться, а consistent компонента накопичується:4
Два додаткові рядки. На сирій нецентрованій стрічці — condition number 33,452, наш найгірший випадок — при найкращому rate, який може взяти plain descent:
momentum beta=0.0   ->    79,513 steps to 1%
momentum beta=0.9   ->     1,609 steps to 1%
momentum beta=0.99  ->       461 steps to 1%
Коефіцієнт 172 за два рядки коду. Розділ 6 перетворює це на Adam; механізм уже тут.
Перевірка, яка знадобиться в Розділі 5
Посилання на розділ: Перевірка, яка знадобиться в Розділі 5Кожен gradient у цьому розділі було виведено вручну, а отже він міг бути неправильним. Виправлення — таблиця нахилів із початку: виміряти похідну чисельно й порівняти. Використовуйте центральну різницю, , яка скасовує провідний член помилки й дає значно більшу точність для того самого .
def numeric_grad(f, theta, h=1e-5):
    theta = np.asarray(theta, dtype=float)
    out = np.zeros_like(theta)
    for i in range(theta.size):
        bump = np.zeros_like(theta)
        bump[i] = h
        out[i] = (f(theta + bump) - f(theta - bump)) / (2 * h)
    return out


def gradcheck(f, df, theta, h=1e-5):
    analytic = np.asarray(df(theta), dtype=float)
    numeric = numeric_grad(f, theta, h)
    return np.max(np.abs(analytic - numeric) / np.maximum(1e-8, np.abs(analytic) + np.abs(numeric)))
Важлива відносна форма порівняння: absolute difference — катастрофа для gradient розміру і не має значення для gradient розміру .
relative error: 1.8929136036763527e-11
with 2 dropped: 0.33333333331650744
Перший рядок — hand-derived gradient вище. Другий — та сама функція, але з пропущеним factor of 2 в одному компоненті, typo з одного символу, — і перевірка ловить її негайно. Усе нижче приблизно — це збіг; усе вище — bug. Збережіть цю функцію: Розділ 5 використовує її для debug automatic differentiation engine, і це єдина причина, чому неправильний gradient узагалі можна знайти.
Куди це веде далі
Посилання на розділ: Куди це веде даліУсе в цьому розділі трималося на одному припущенні, яке жодного разу не було озвучено: що ви можете записати .
Для прямої з двома параметрами це був один рядок алгебри. Майже одразу це перестає бути одним рядком. Попросіть symbolic algebra system знайти похідну loss мережі за однією вагою першого шару, для одного example, і порахуйте арифметику у відповіді:
| network | operations in one partial derivative |
|---|---|
| чотири hidden units, один шар | 40 |
| чотири hidden units, два шари | 301 |
| чотири hidden units, три шари | 1,717 |
Третій рядок — мережа з 57 параметрами, настільки мала, що в Розділі 6 вона була б виноскою, — і записати її gradient вручну означає приблизно 97,869 operations для одного training example. Немає нотації, яка це врятує. Рятує інше спостереження: chain rule, застосований до композиції, має величезну структуру; ті самі проміжні величини з’являються знову й знову; а обчислення їх у правильному порядку дає всі похідні приблизно за ціну одного forward pass. Це Розділ 5.
Але спершу є менша проблема, і вона чекає негайно.
Тепер у нас є машина, яка котитиметься вниз на будь-якому differentiable loss. Спрямуйте її на оригінальне запитання стрічки — прийняти чи відбракувати, target 1 або 0, — поставте sigmoid на output, щоб він передбачав probability, і мінімізуйте squared error. Вона запуститься. Але вона також майже не рухатиметься, коли помиляється найсильніше, і gradient пояснює чому:
| output | prediction | truth | gradient with squared error | gradient with cross-entropy |
|---|---|---|---|---|
| 0.5000 | 1 | |||
| 0.1192 | 1 | |||
| 0.0025 | 1 | |||
| 1 |
Модель, яка впевнено, катастрофічно помиляється — predicting 0.0000454, коли відповідь 1, — породжує squared-error gradient . Вона не має уявлення, що в халепі. Інший стовпчик, із loss, яку ми ще не вивели, повідомляє 1.0: максимальна терміновість рівно там, де вона заслужена.
Це підводить до запитання, з якого відкривається наступний розділ. Попередній розділ сказав, що loss — це припущення про шум, а squared error припускає Gaussian noise. Яка noise model у відповіді «так або ні» — і яка loss виходить, коли провести для неї той самий derivation?
Джерела і метод
Посилання на розділ: Джерела і методСам метод старіший за всі ці роботи: Cauchy описав його в нотатці до Académie des Sciences у 1847 році як спосіб розв’язувати системи рівнянь, спускаючись униз по сумі квадратів їхніх residuals. Також варто читати разом із цим розділом: Sebastian Ruder, An overview of gradient descent optimization algorithms (arXiv:1609.04747), де momentum до Adam розглянуто на чотирнадцяти читабельних сторінках; chapter 3 Nocedal and Wright, Numerical Optimization (2nd ed., Springer, 2006), де theorem 3.3 дає convergence rate steepest descent на quadratic через condition number — це теорія за тим, чому conditioning визначає кількість кроків, хоча там розглянуто line search, а не fixed-step межу , виміряну вище; або §5.8 і §7.1 Deisenroth, Faisal and Ong, Mathematics for Machine Learning, для того самого матеріалу з меншою кількістю machinery; §6.1 Prince, Understanding Deep Learning, і §4.3 Goodfellow, Bengio and Courville, Deep Learning; Dive into Deep Learning §12.1–12.3, де є minibatch analysis із більшою кількістю вимірювань, ніж тут є місця; і chapter 4 Géron, Hands-On Machine Learning (3rd ed.), найпрактичніший розгляд learning rate як речі, яку налаштовують, а не виводять. Нотатки MIT 6.390 ставлять gradient descent перед classification, як і цей курс, і з тієї самої причини.
Примітки
Посилання на розділ: Примітки-
LeCun, Y., Bottou, L., Orr, G. B. and Müller, K.-R. Efficient BackProp, in Neural Networks: Tricks of the Trade (Springer, 1998), pp. 9–50. Section 4.3 дає рекомендацію, а section 5.1 — аргумент, використаний у detail box вище: centring і scaling inputs змінюють eigenvalues матриці других похідних, а отже й кількість кроків, не лише numerical comfort. ↩
-
Dauphin, Y. N., Pascanu, R., Gulcehre, C., Cho, K., Ganguli, S. and Bengio, Y. Identifying and attacking the saddle point problem in high-dimensional non-convex optimization, arXiv:1406.2572 (2014). Аргумент про те, що у високих вимірах критичні точки переважно є сідлами, а не локальними мінімумами, бо мінімум вимагає, щоб кожен із тисяч напрямків одночасно викривлявся вгору. ↩
-
Robbins, H. and Monro, S. A Stochastic Approximation Method. Annals of Mathematical Statistics 22(3), pp. 400–407 (1951). Стаття, яка встановила, що шумної оцінки gradient достатньо, якщо step size зменшується правильним способом. ↩
-
Polyak, B. T. Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics 4(5), pp. 1–17 (1964). Метод heavy-ball, тобто momentum update вище, за двадцять два роки до того, як backpropagation дійшла до цієї галузі. ↩
Цей розділ у відео
Короткі відео, що просто пояснюють ідеї з цього розділу.
 #04
How AI learns: guess, measure the error, nudge, repeat
 #021
Grid search: why you cannot train an AI by trying every setting
 #022
Derivative: how much the result moves when you nudge one input
 #023
Chain rule: how AI traces the effect of every layer
 #024
Gradient: the arrow that points uphill, and why AI walks the other way
 #025
Gradient descent: how AI finds its way downhill in small steps
 #026
Learning rate: the step size with a ceiling you can calculate
 #027
Condition number: why a stretched valley makes AI training crawl
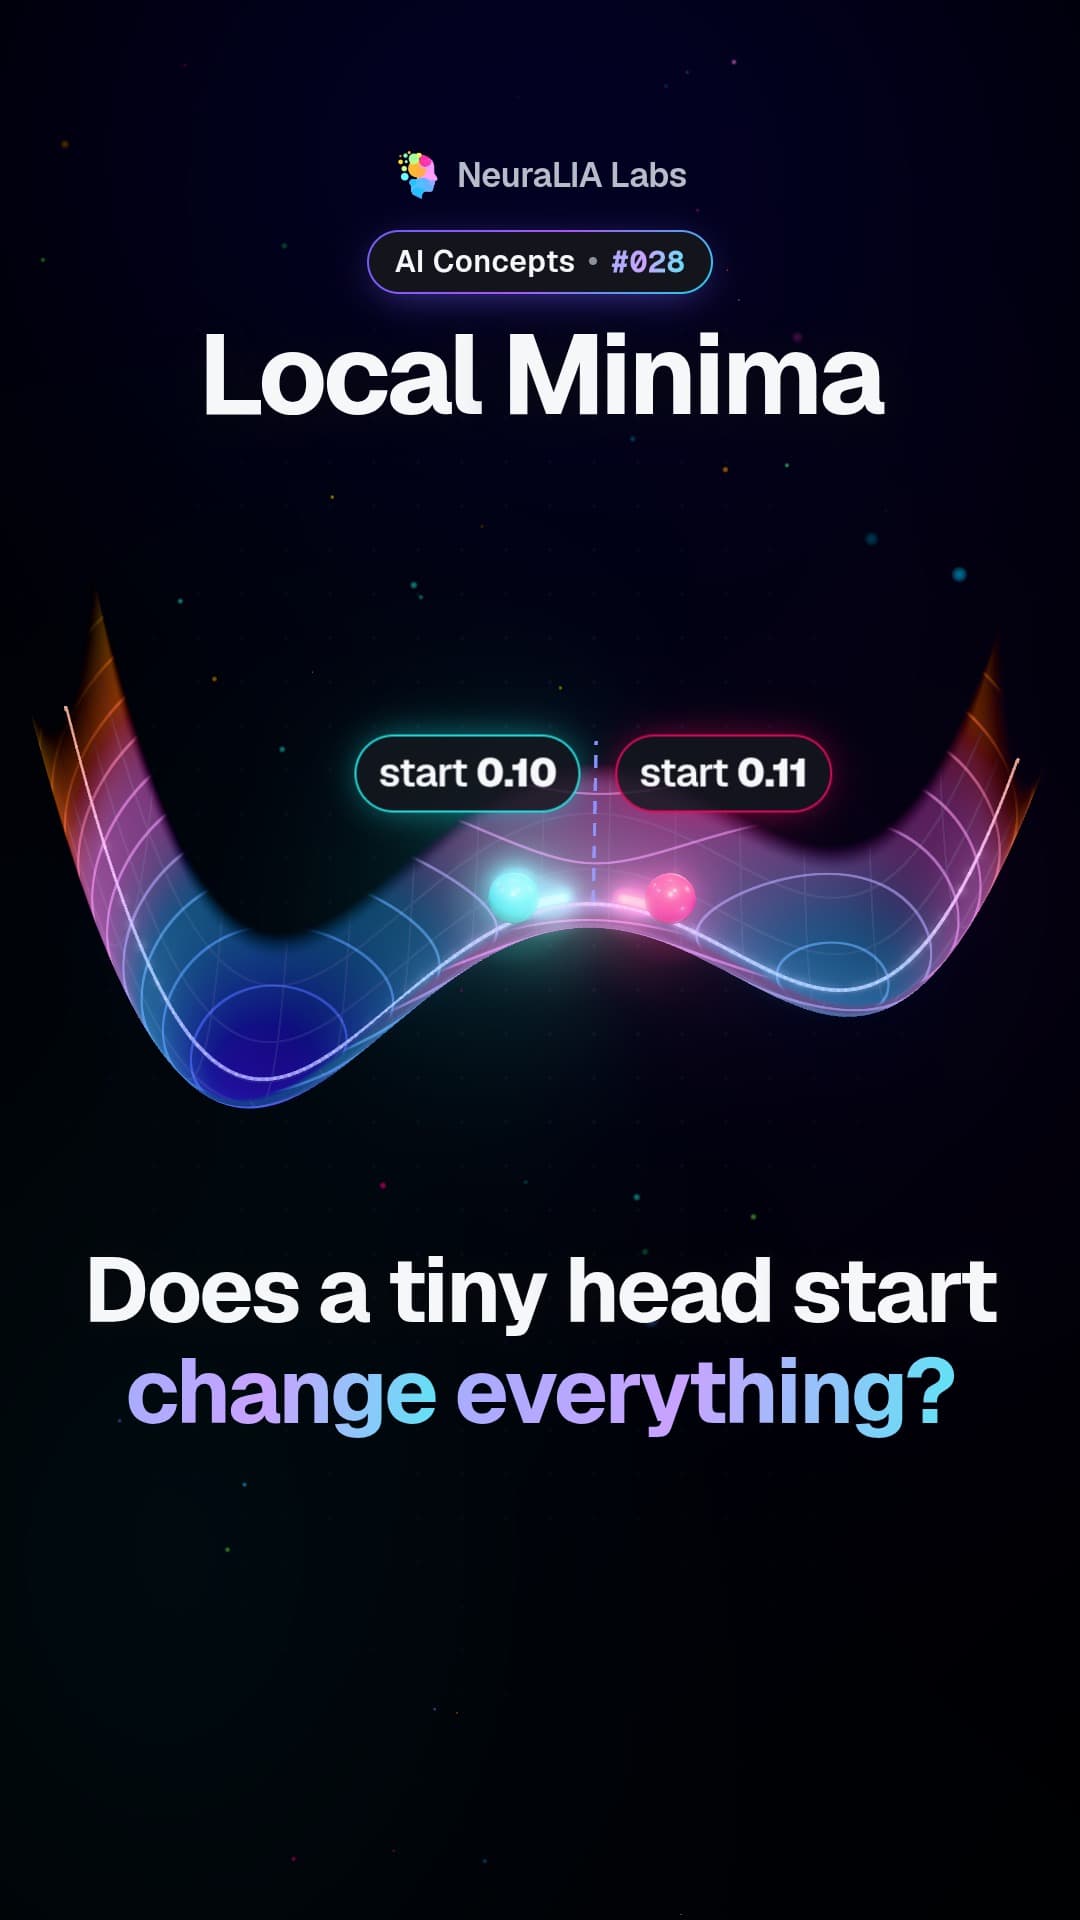 #028
Local minima: why AI training can settle for second best
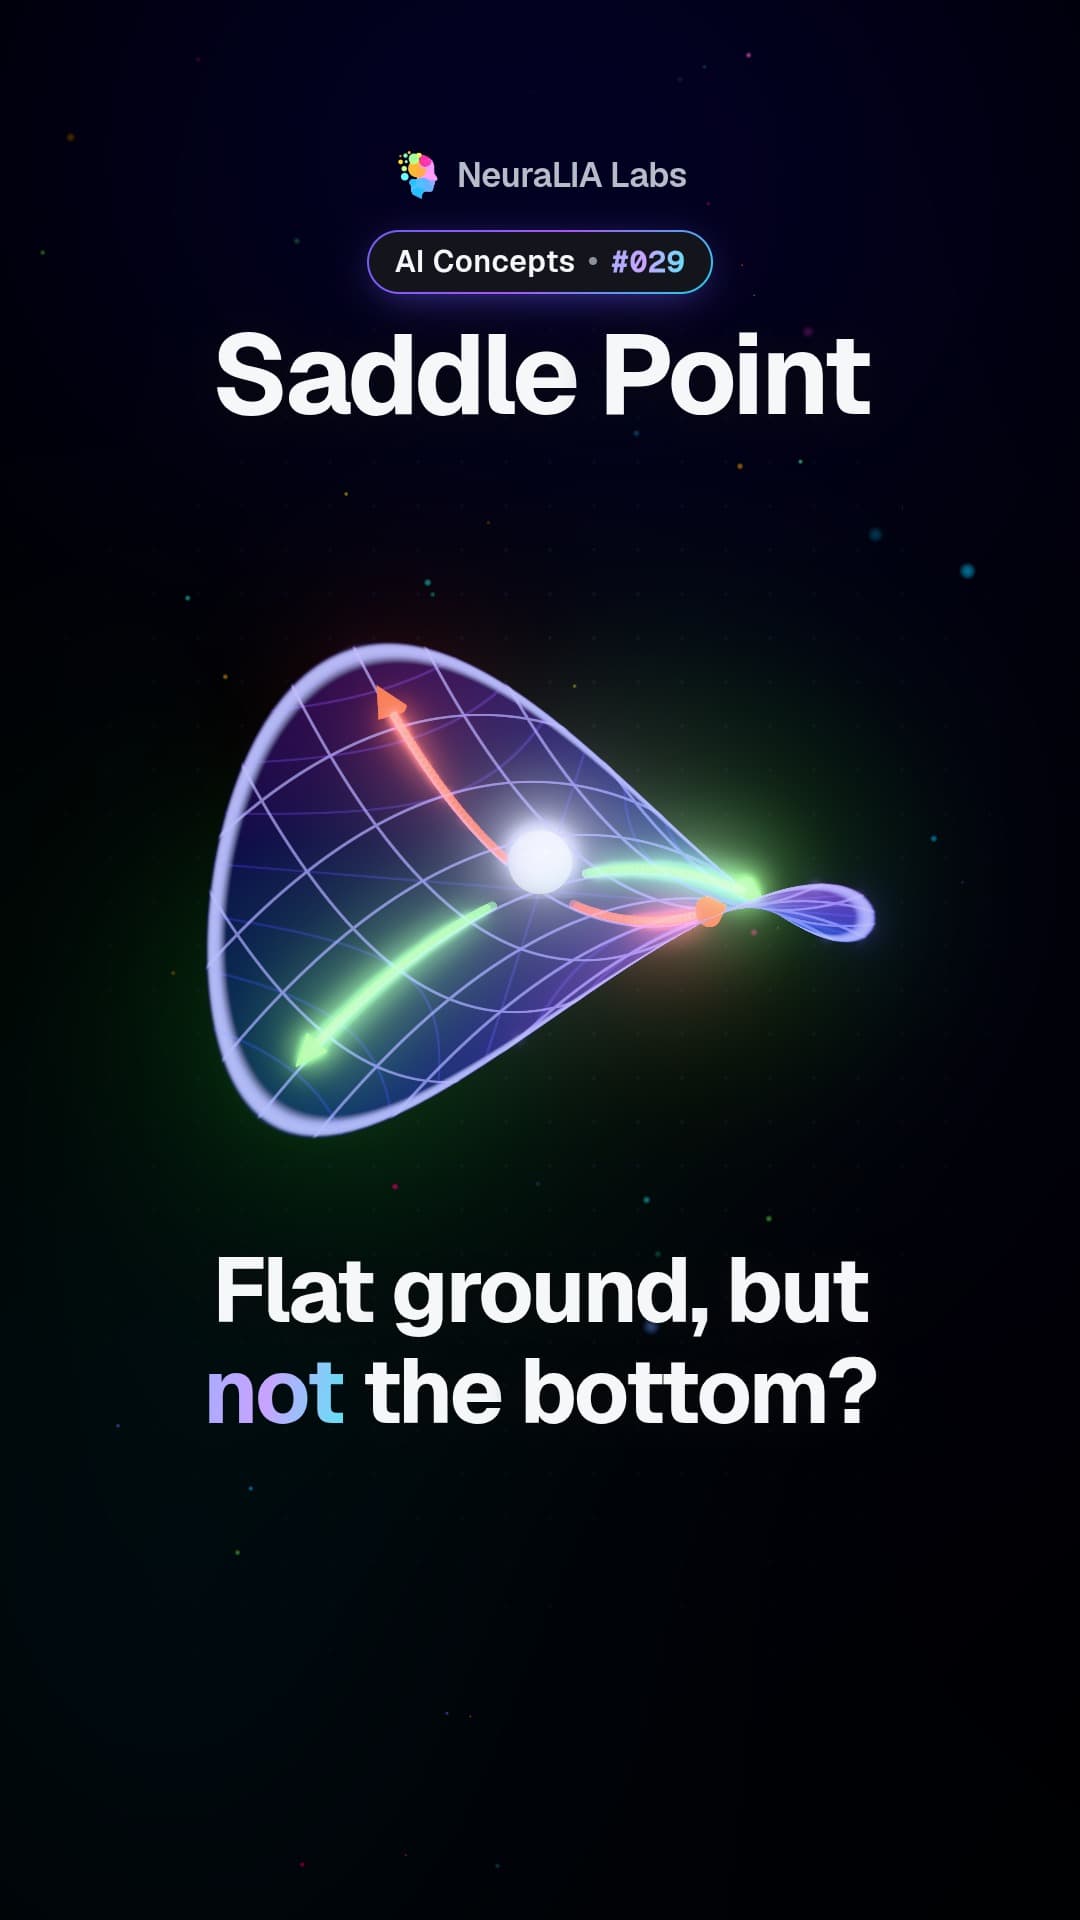 #029
Saddle points: where AI training looks stuck but has a way down
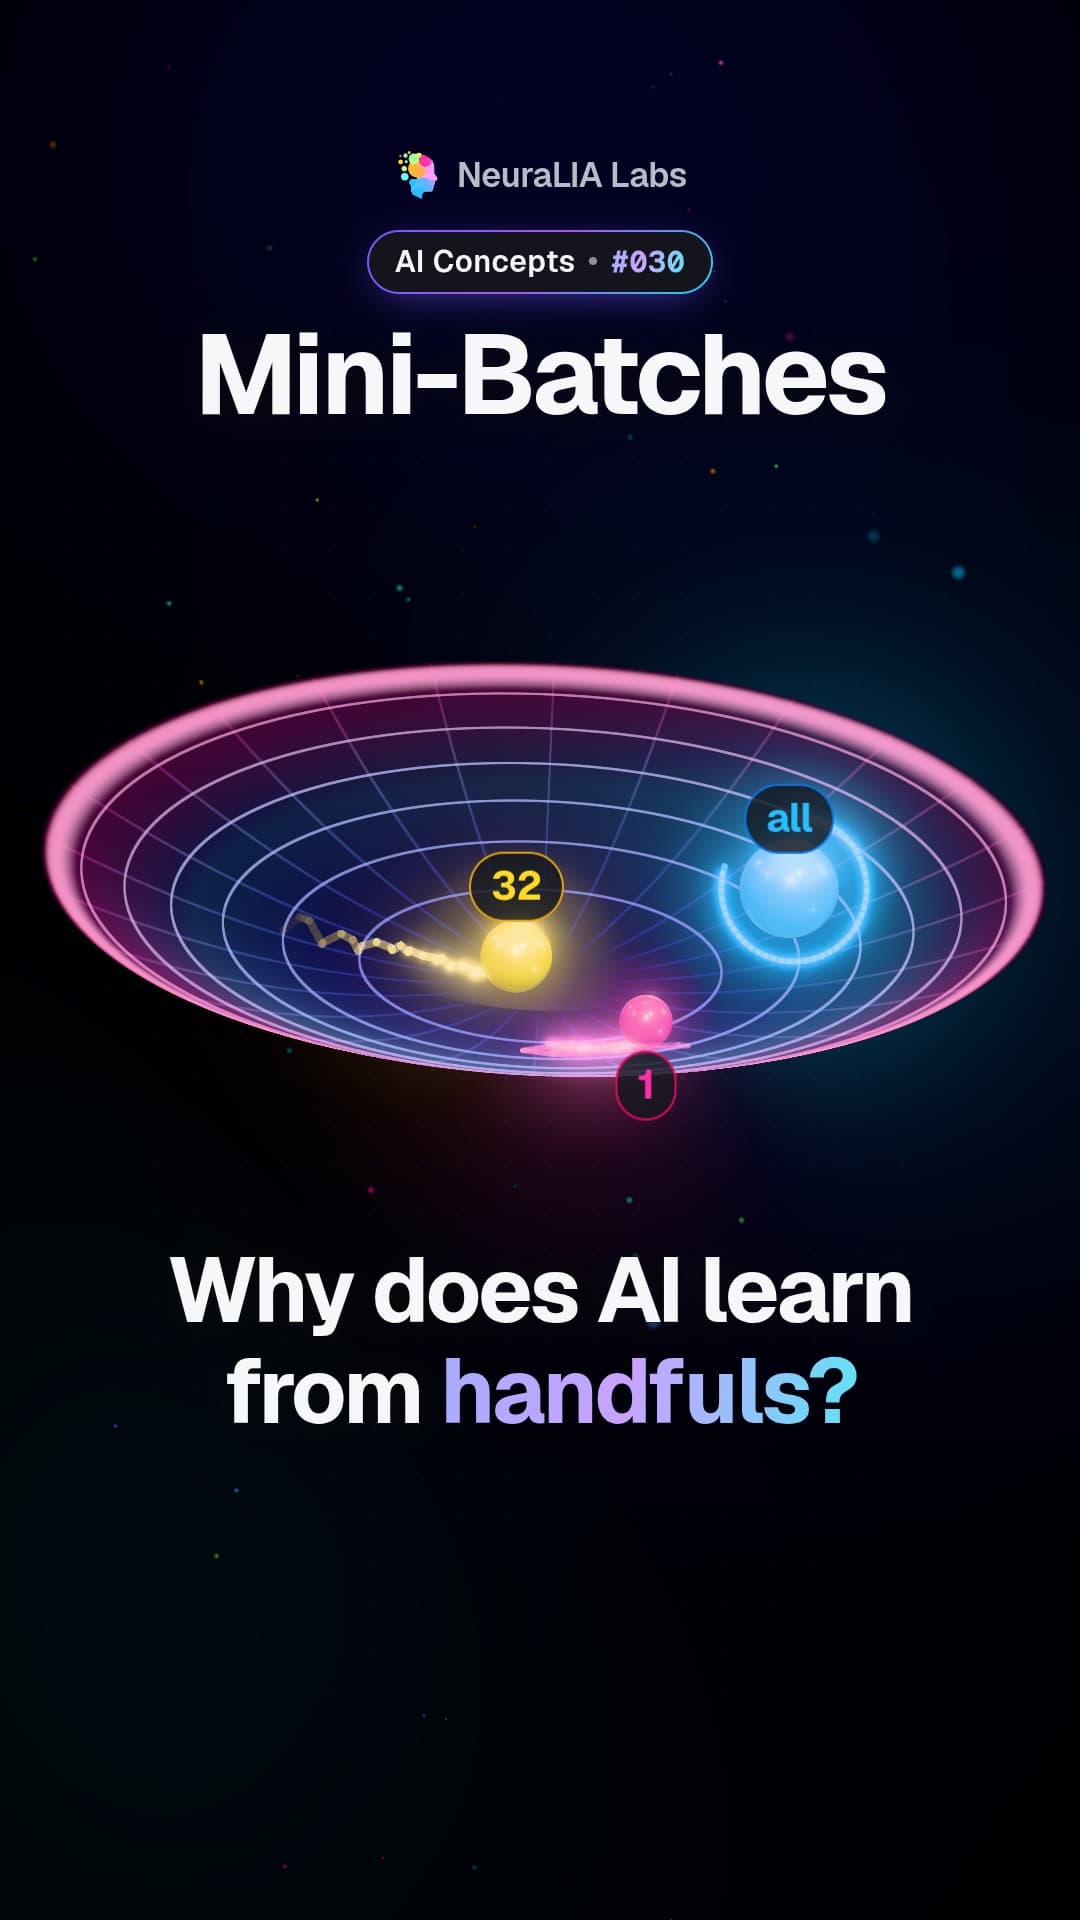 #030
Mini-batches: why AI learns faster from a random handful of data
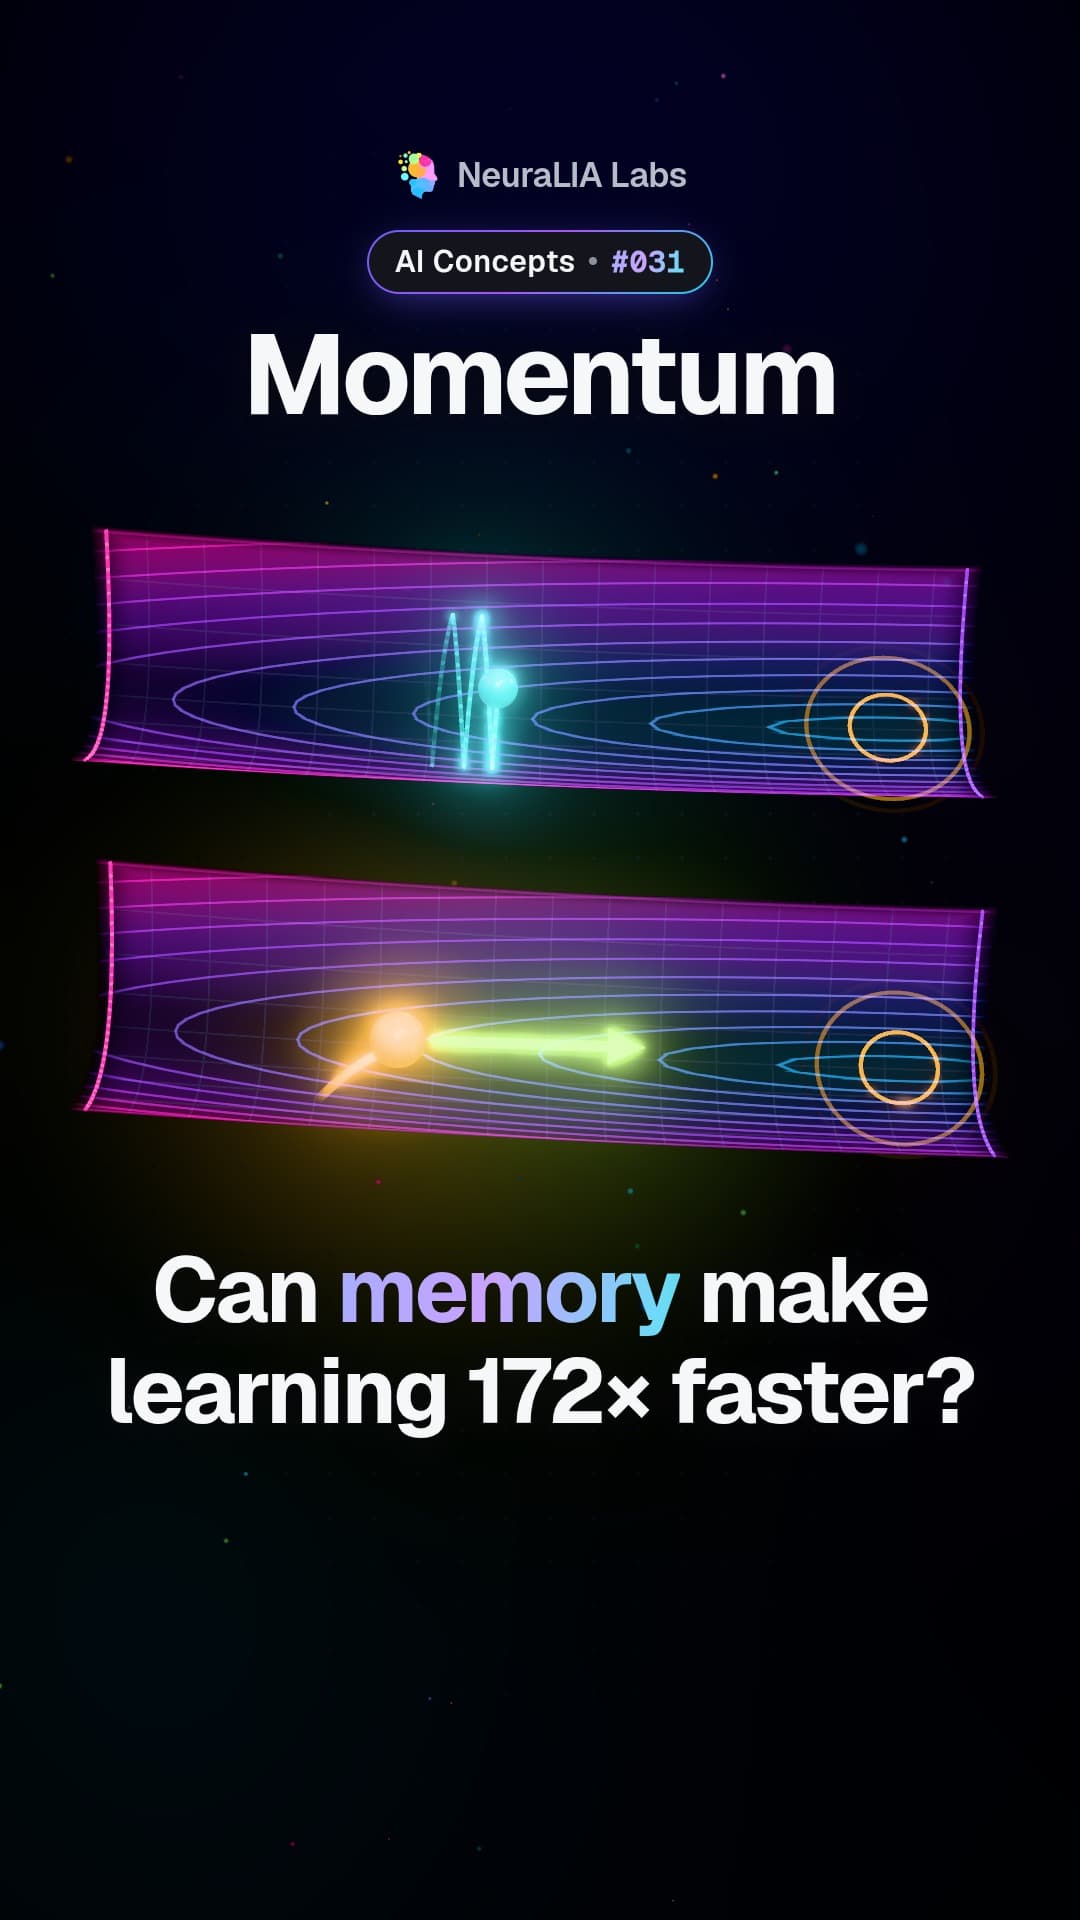 #031
Momentum: how remembering past steps stops AI training zigzagging
 #032
Gradient checking: catching the silent bug in AI training math