
 #01
Vidéos
L’IA expliquée en courtes vidéos
Une idée par vidéo, en langage clair. Chacune renvoie au chapitre de notre cours gratuit qui l’explique étape par étape.
Commencer ici AI 101
- #01
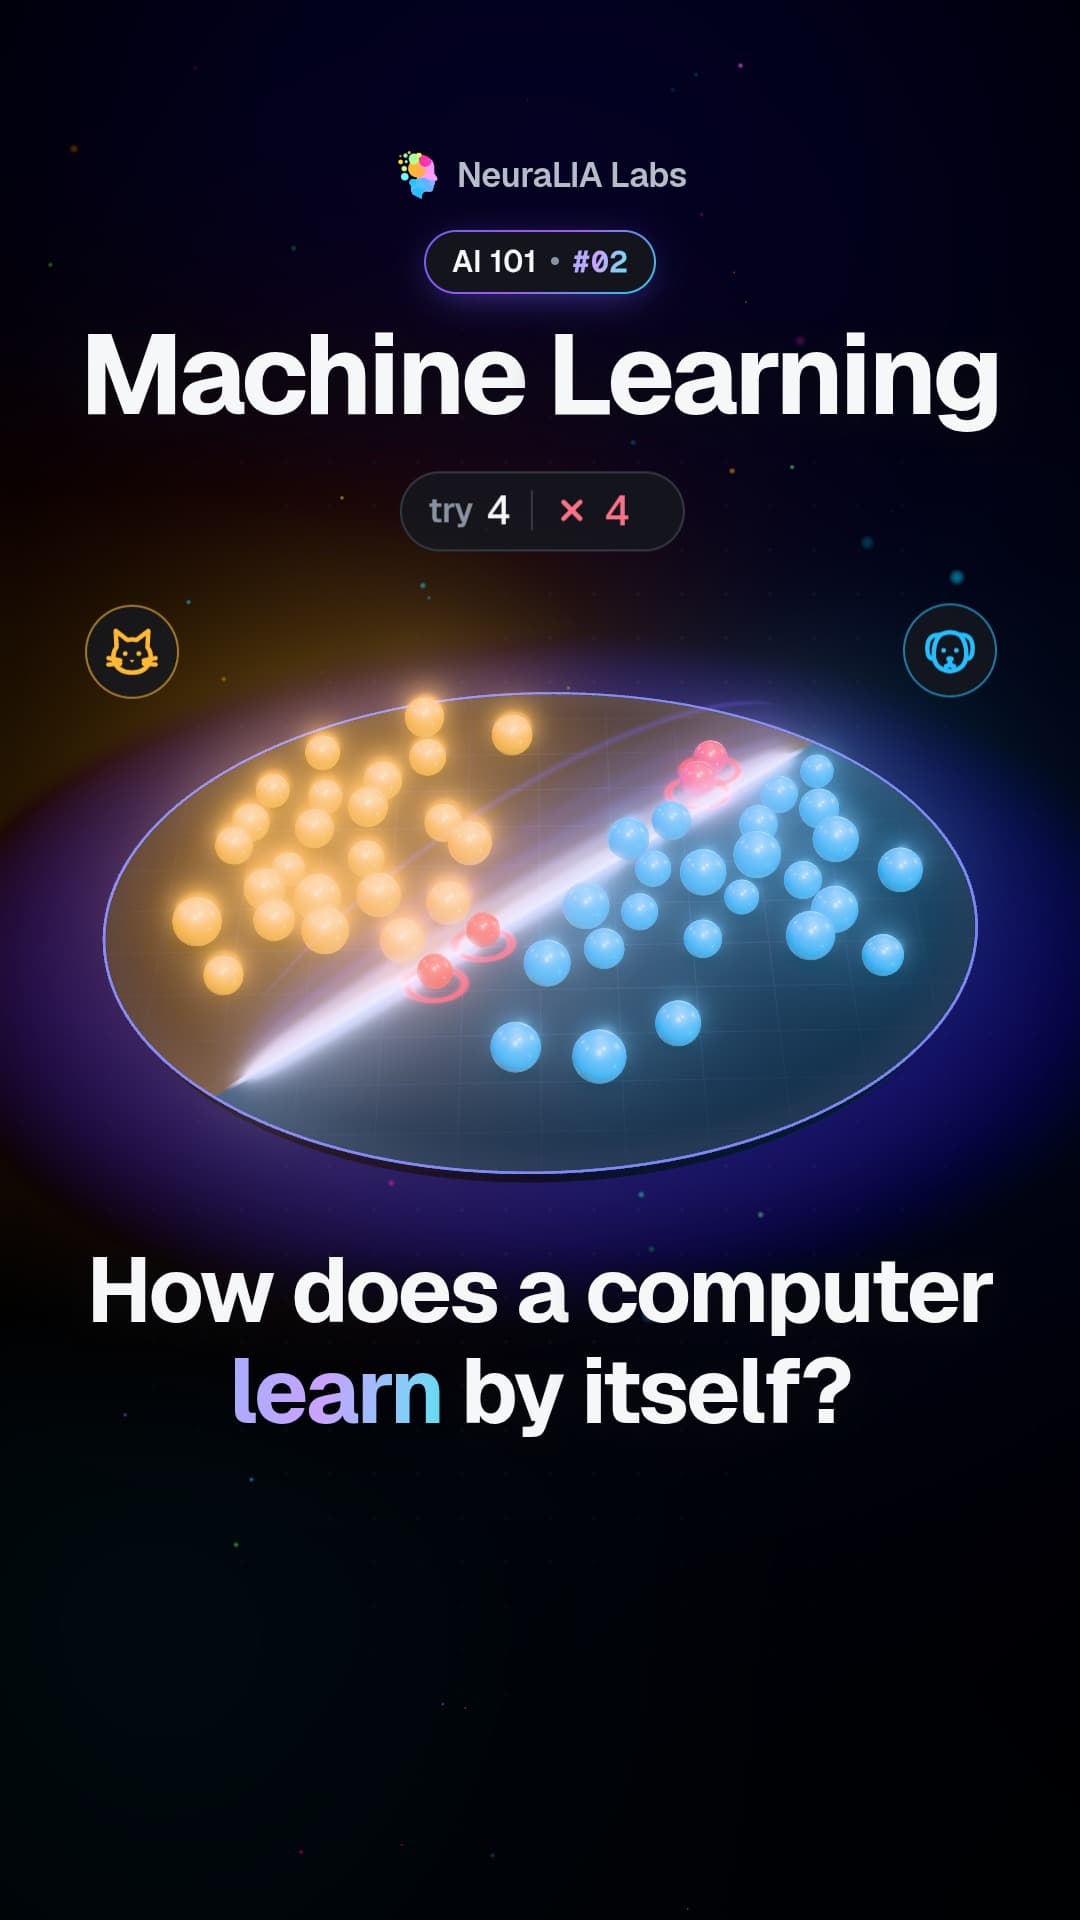 #02
Machine learning: how a computer draws its own dividing line
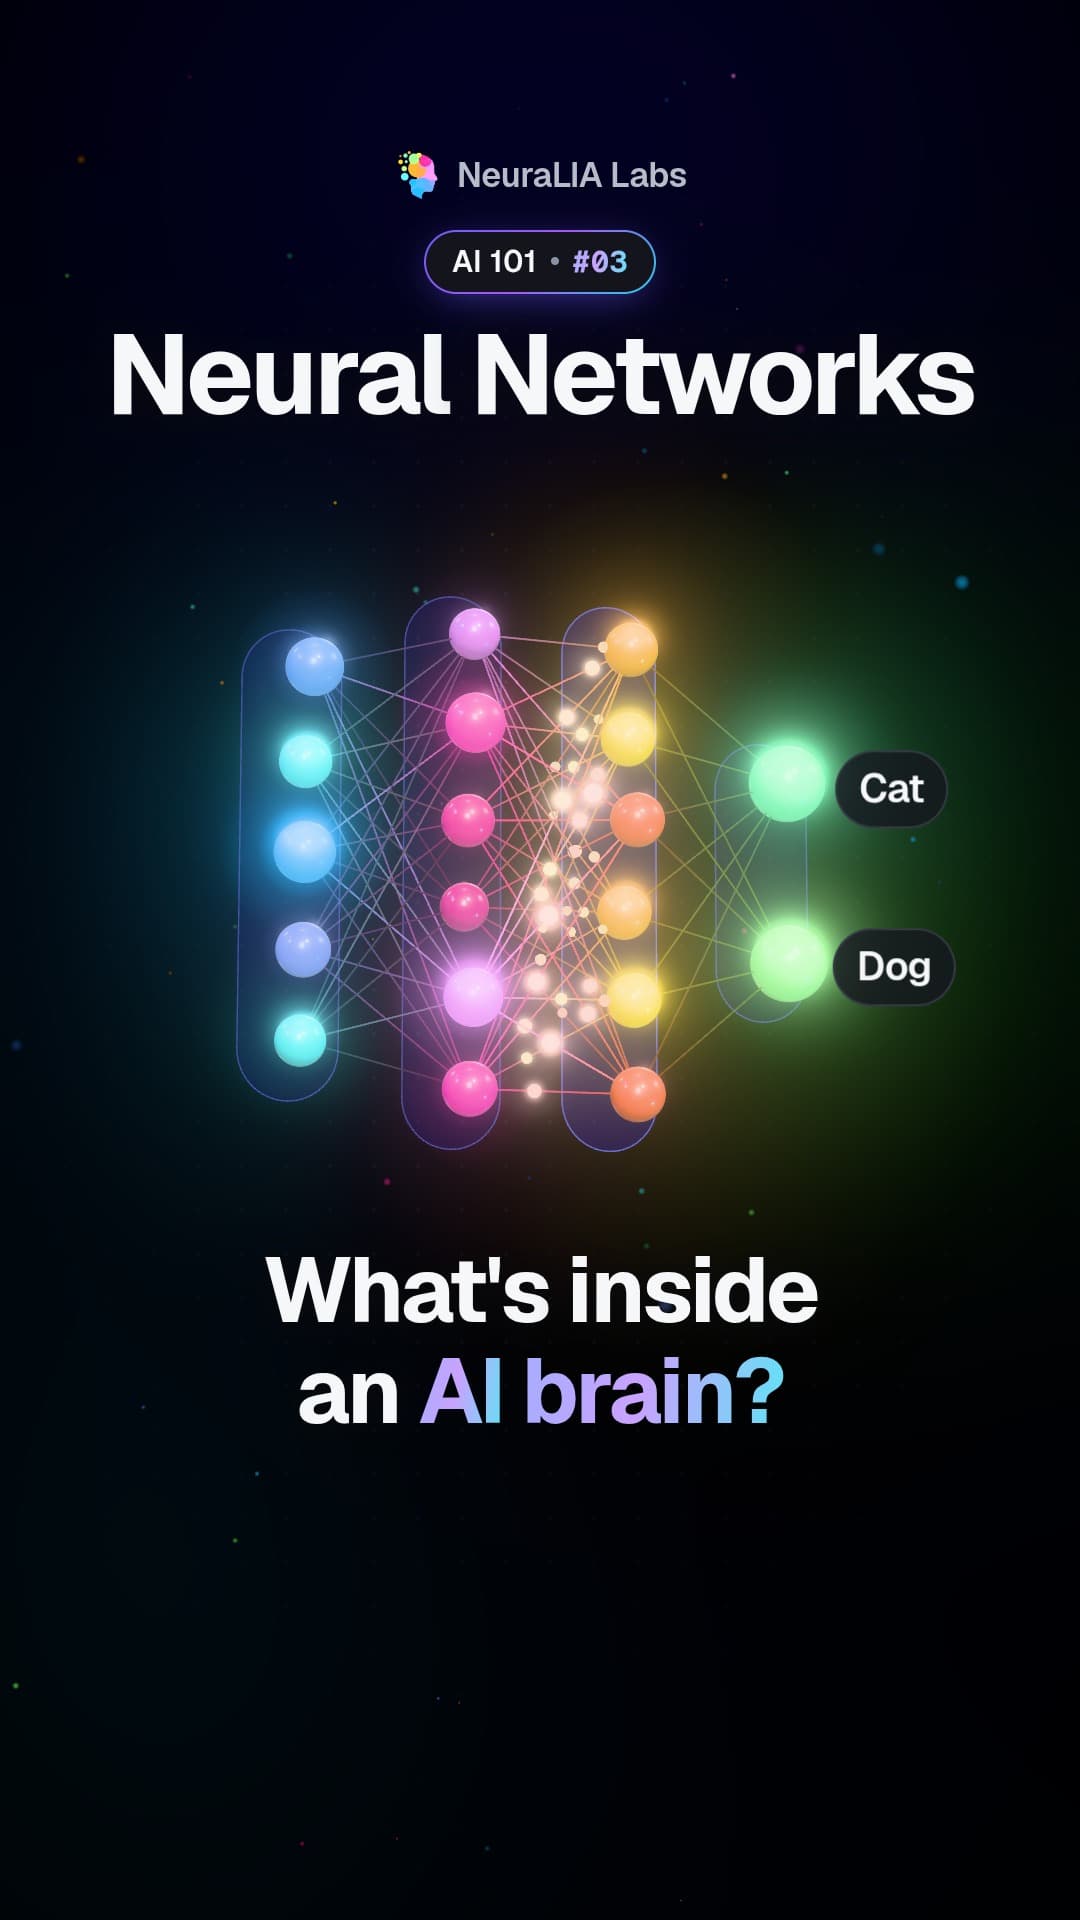 #03
Neural networks: layers of tiny calculators passing signals on
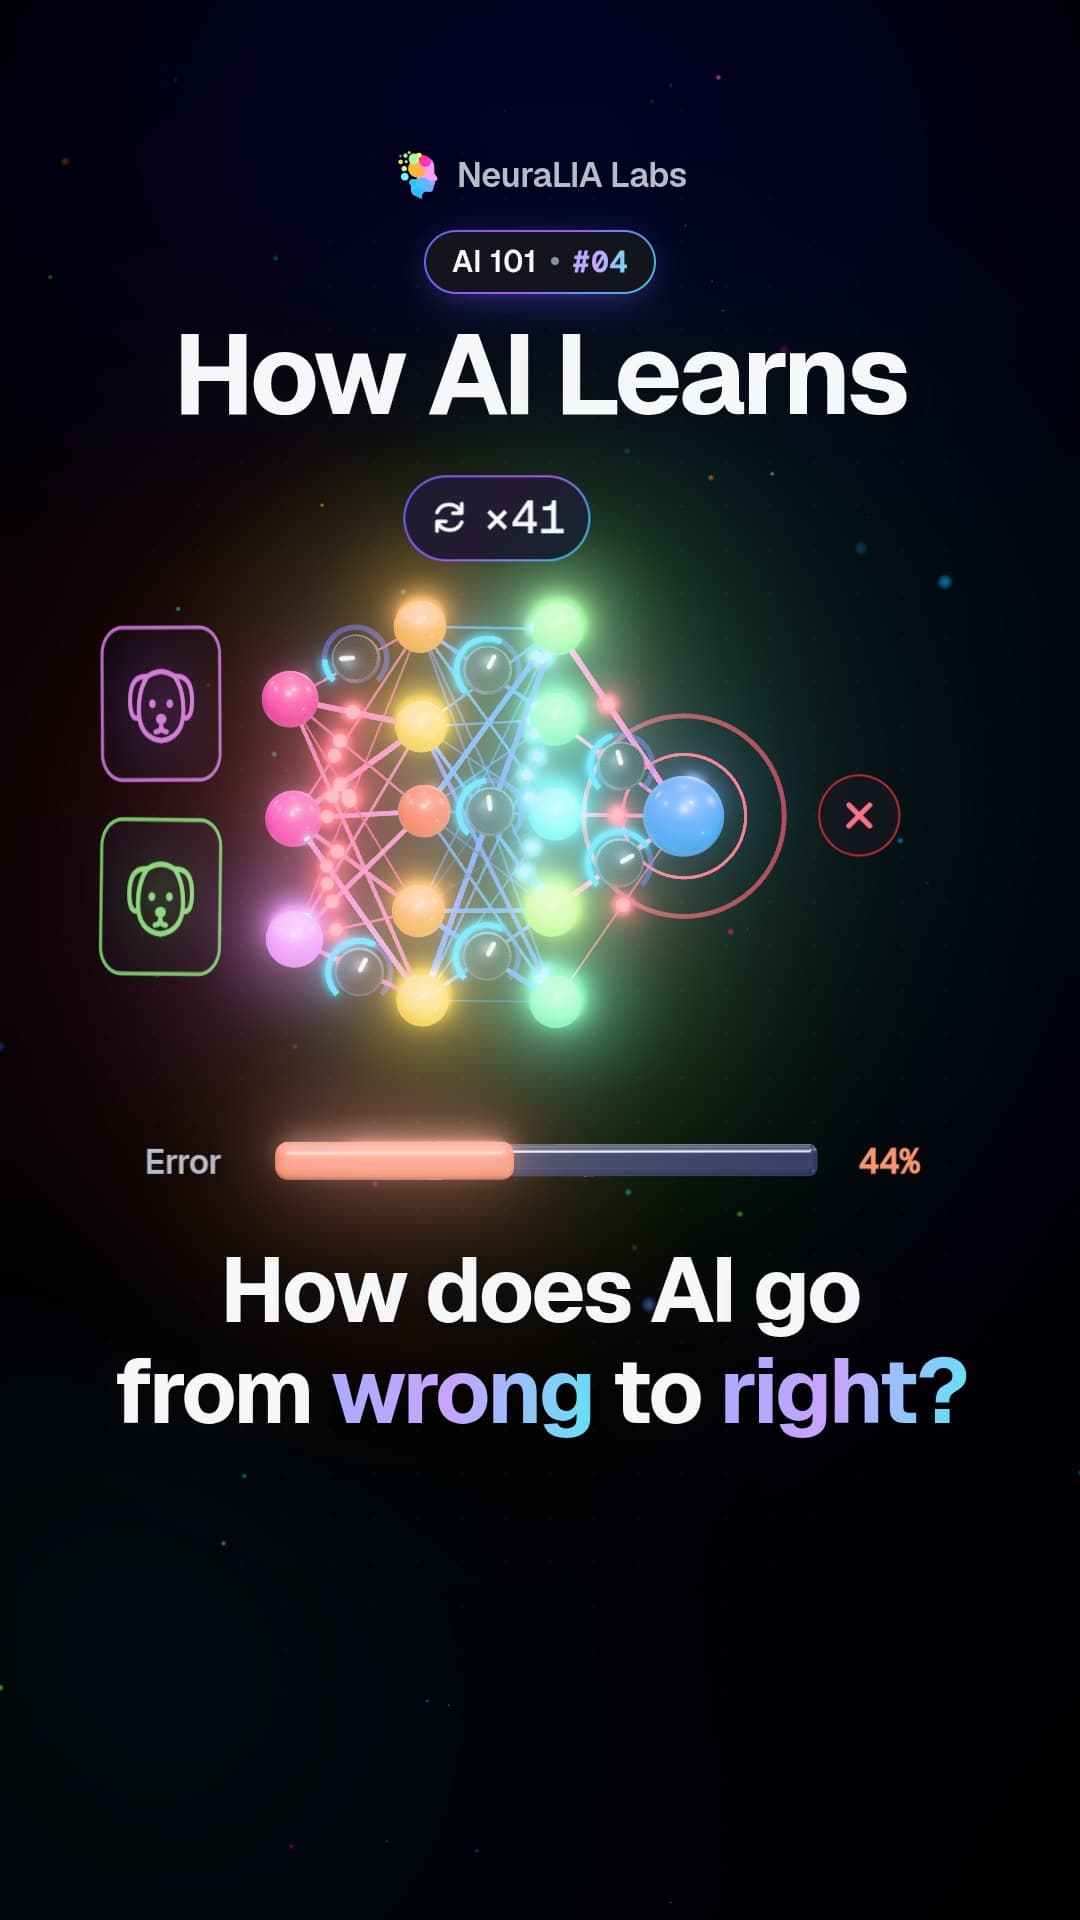 #04
How AI learns: guess, measure the error, nudge, repeat
 #05
Tokens: how AI chops your words into numbered pieces
 #06
Embeddings: why a puppy lands closer to a dog than to a pizza
Dernières
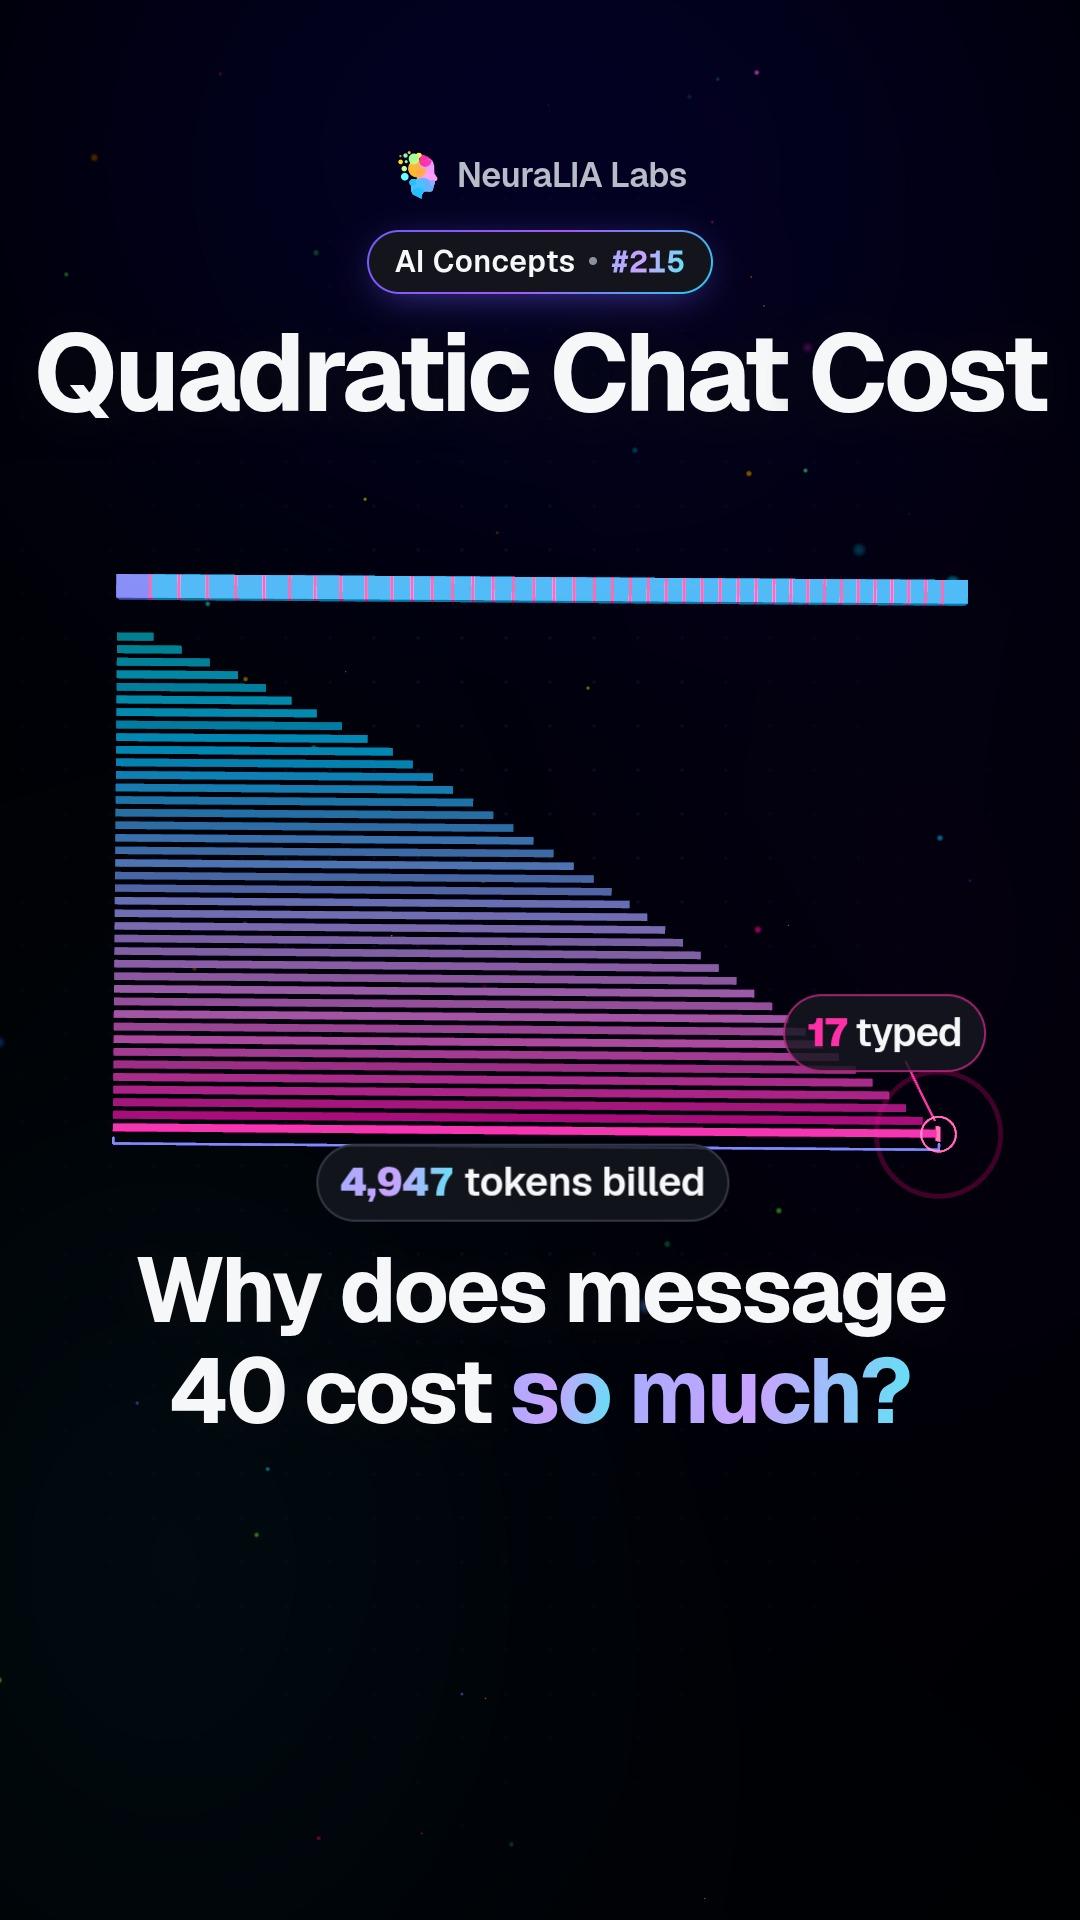 #215
Quadratic chat cost: why each new message costs more than the last
 #214
Stateless models: why your chatbot rereads the whole chat every time
 #213
Prompt versioning: treat your AI instructions like code, not a note
 #212
DSPy: describe the task and let a tool write the prompts
 #211
Auto prompt engineering: letting the AI search for its own wording
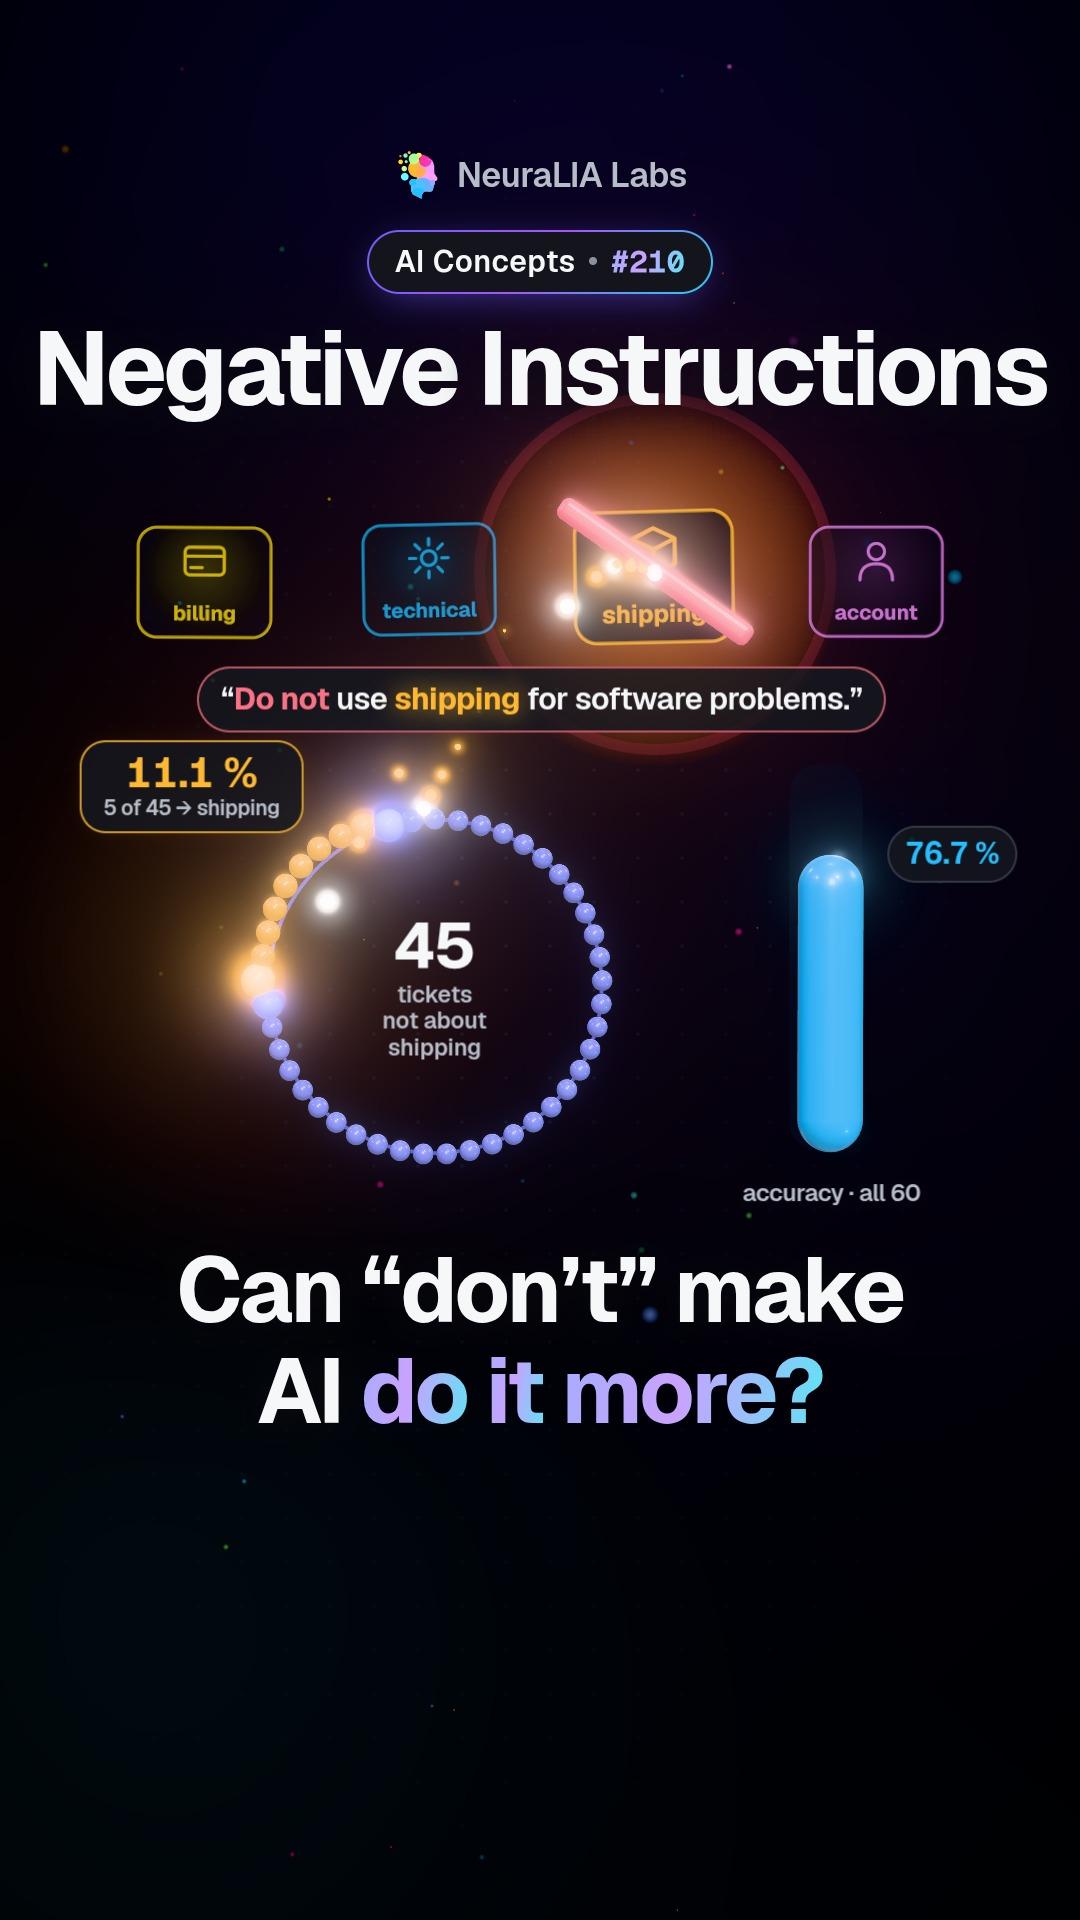 #210
Negative instructions: why telling an AI "don't" can backfire
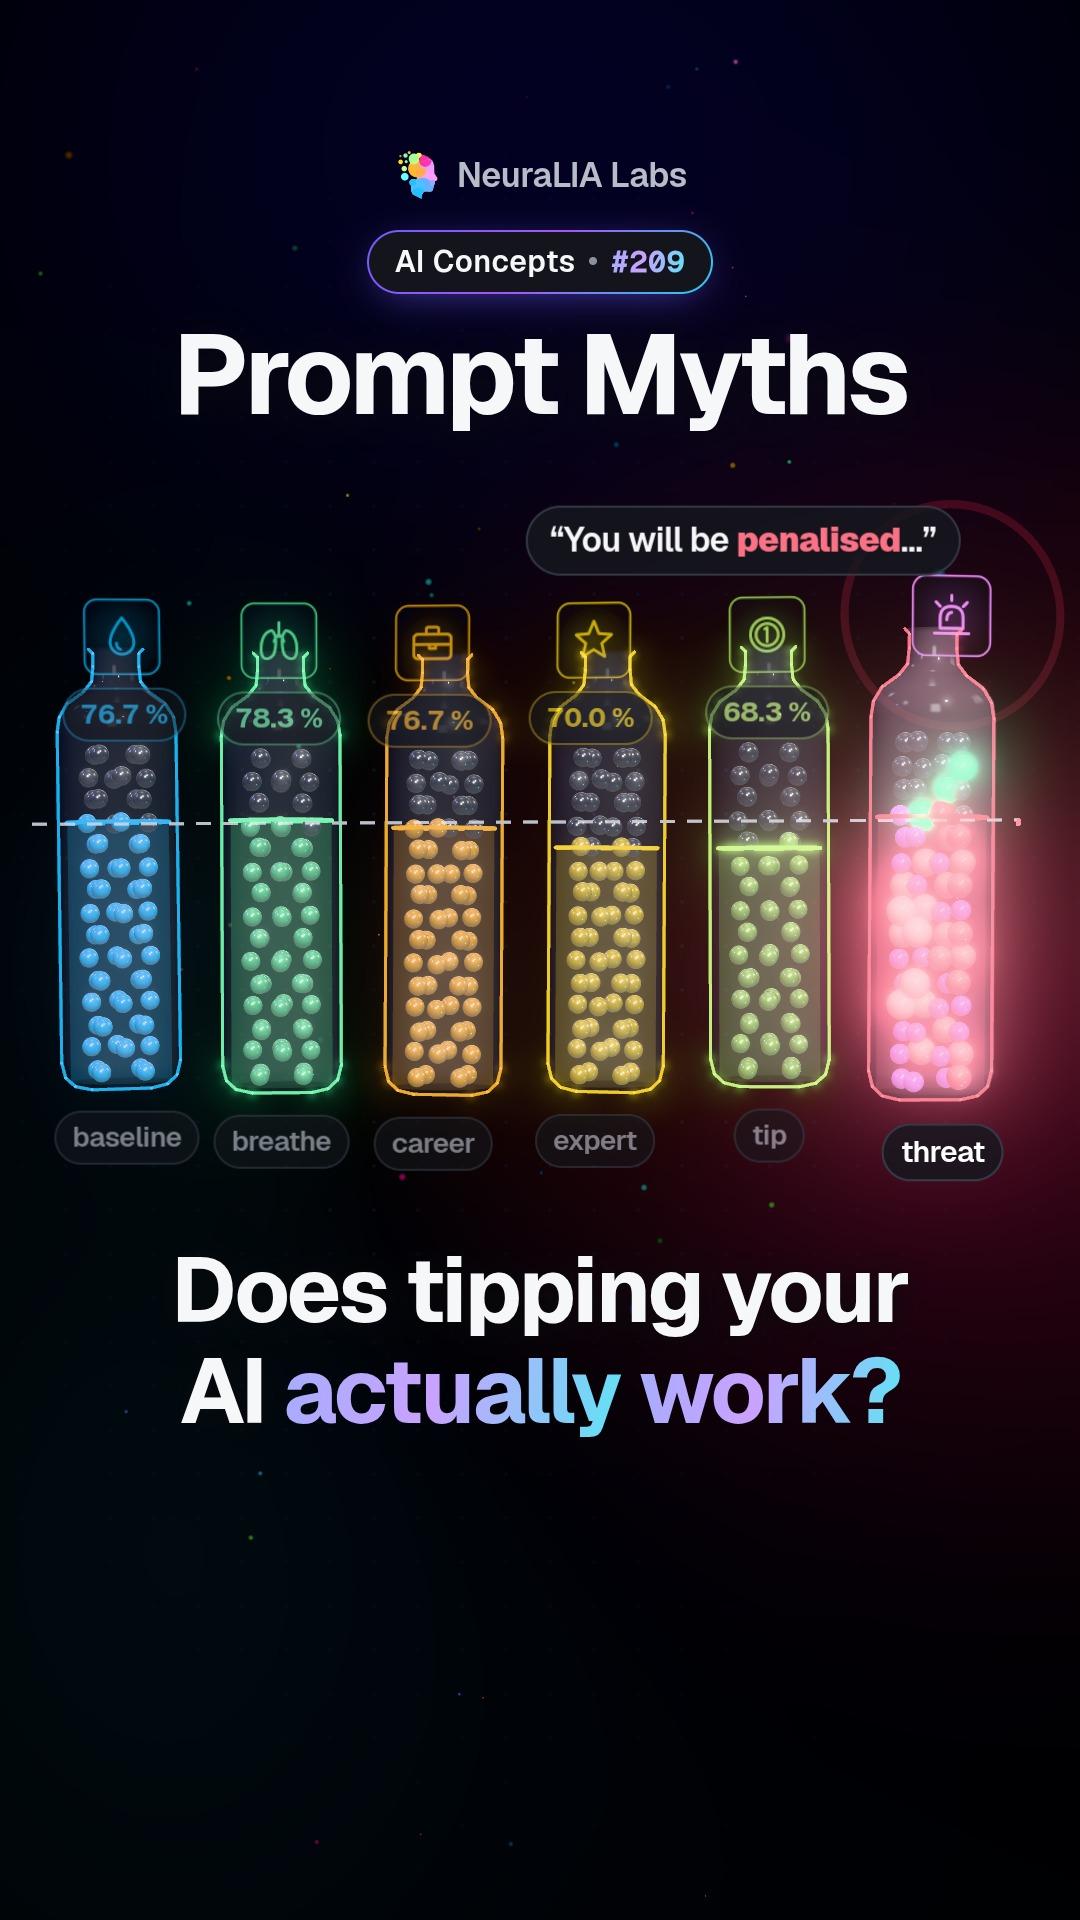 #209
Prompt myths: what tips, pep talks and threats did in a real test
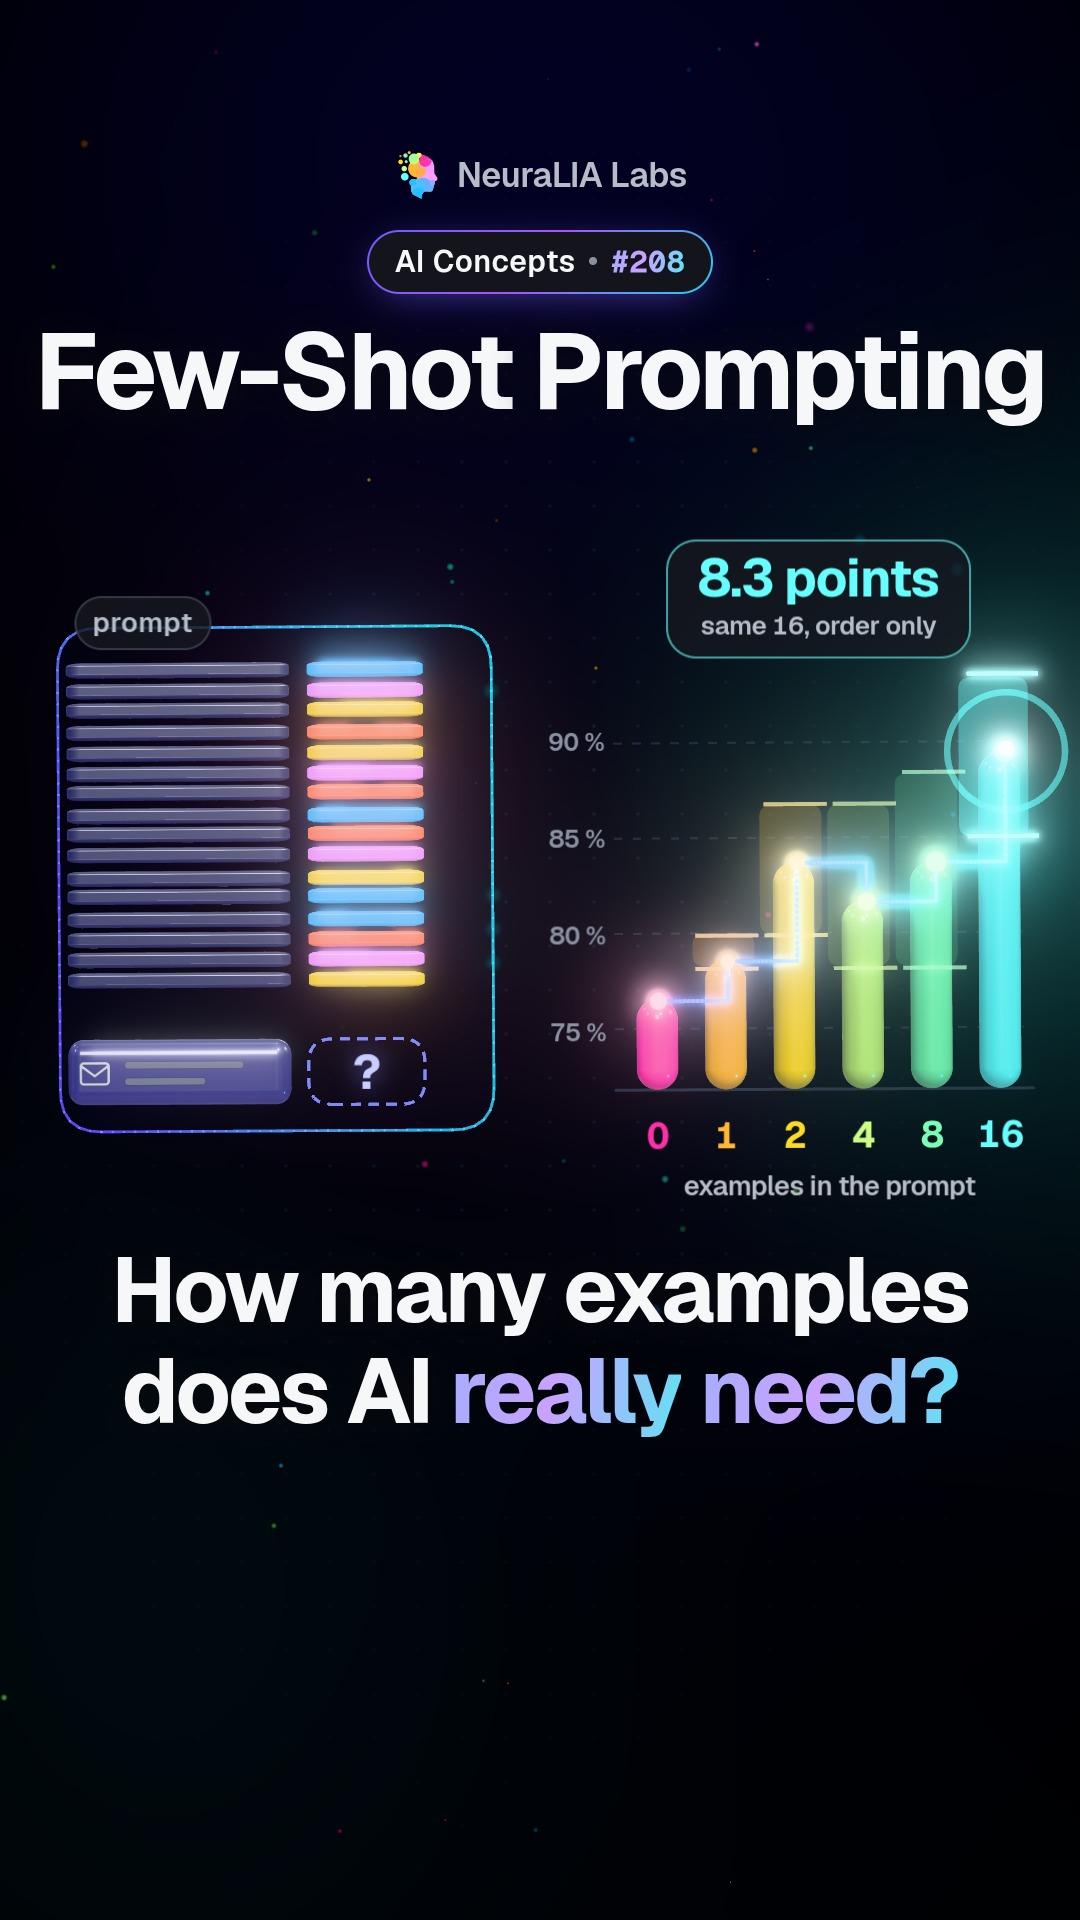 #208
Few-shot prompting: how many examples an AI prompt really needs
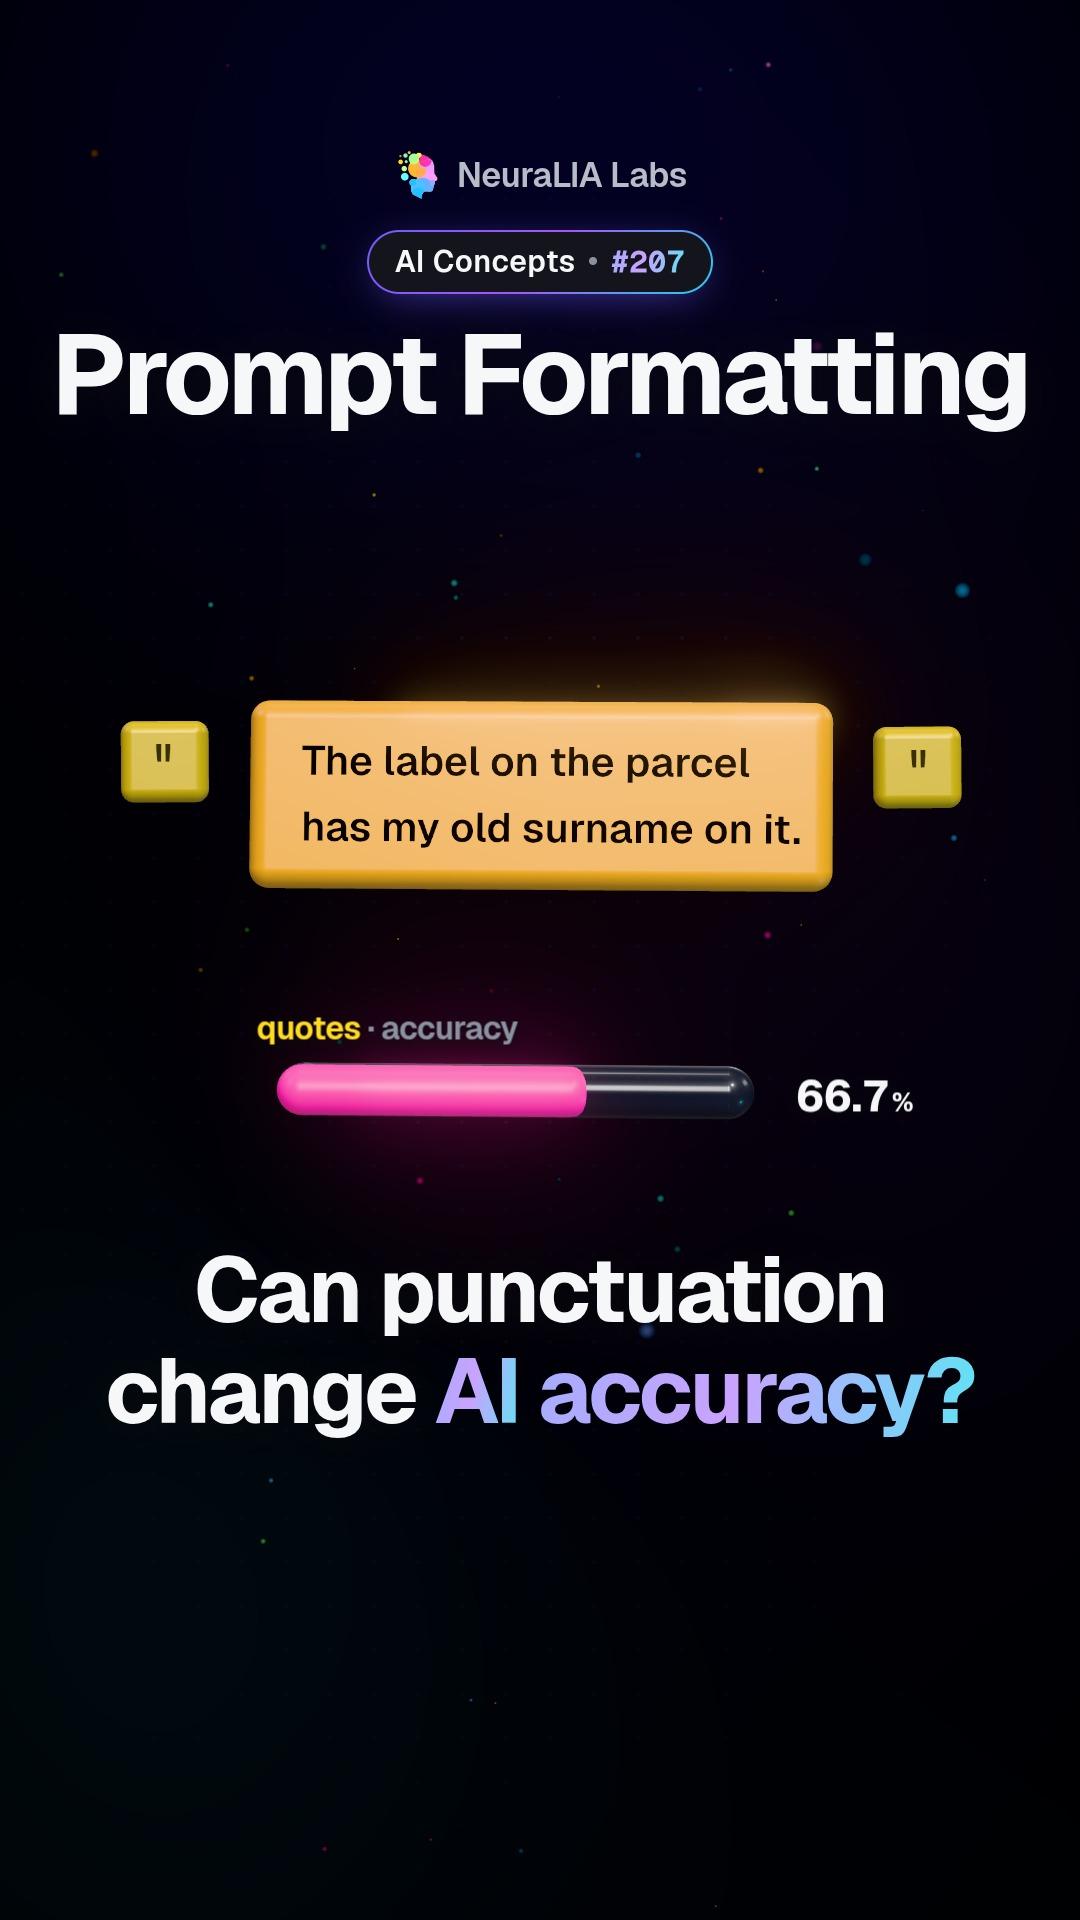 #207
Prompt formatting: how quotes and tags quietly shift AI accuracy
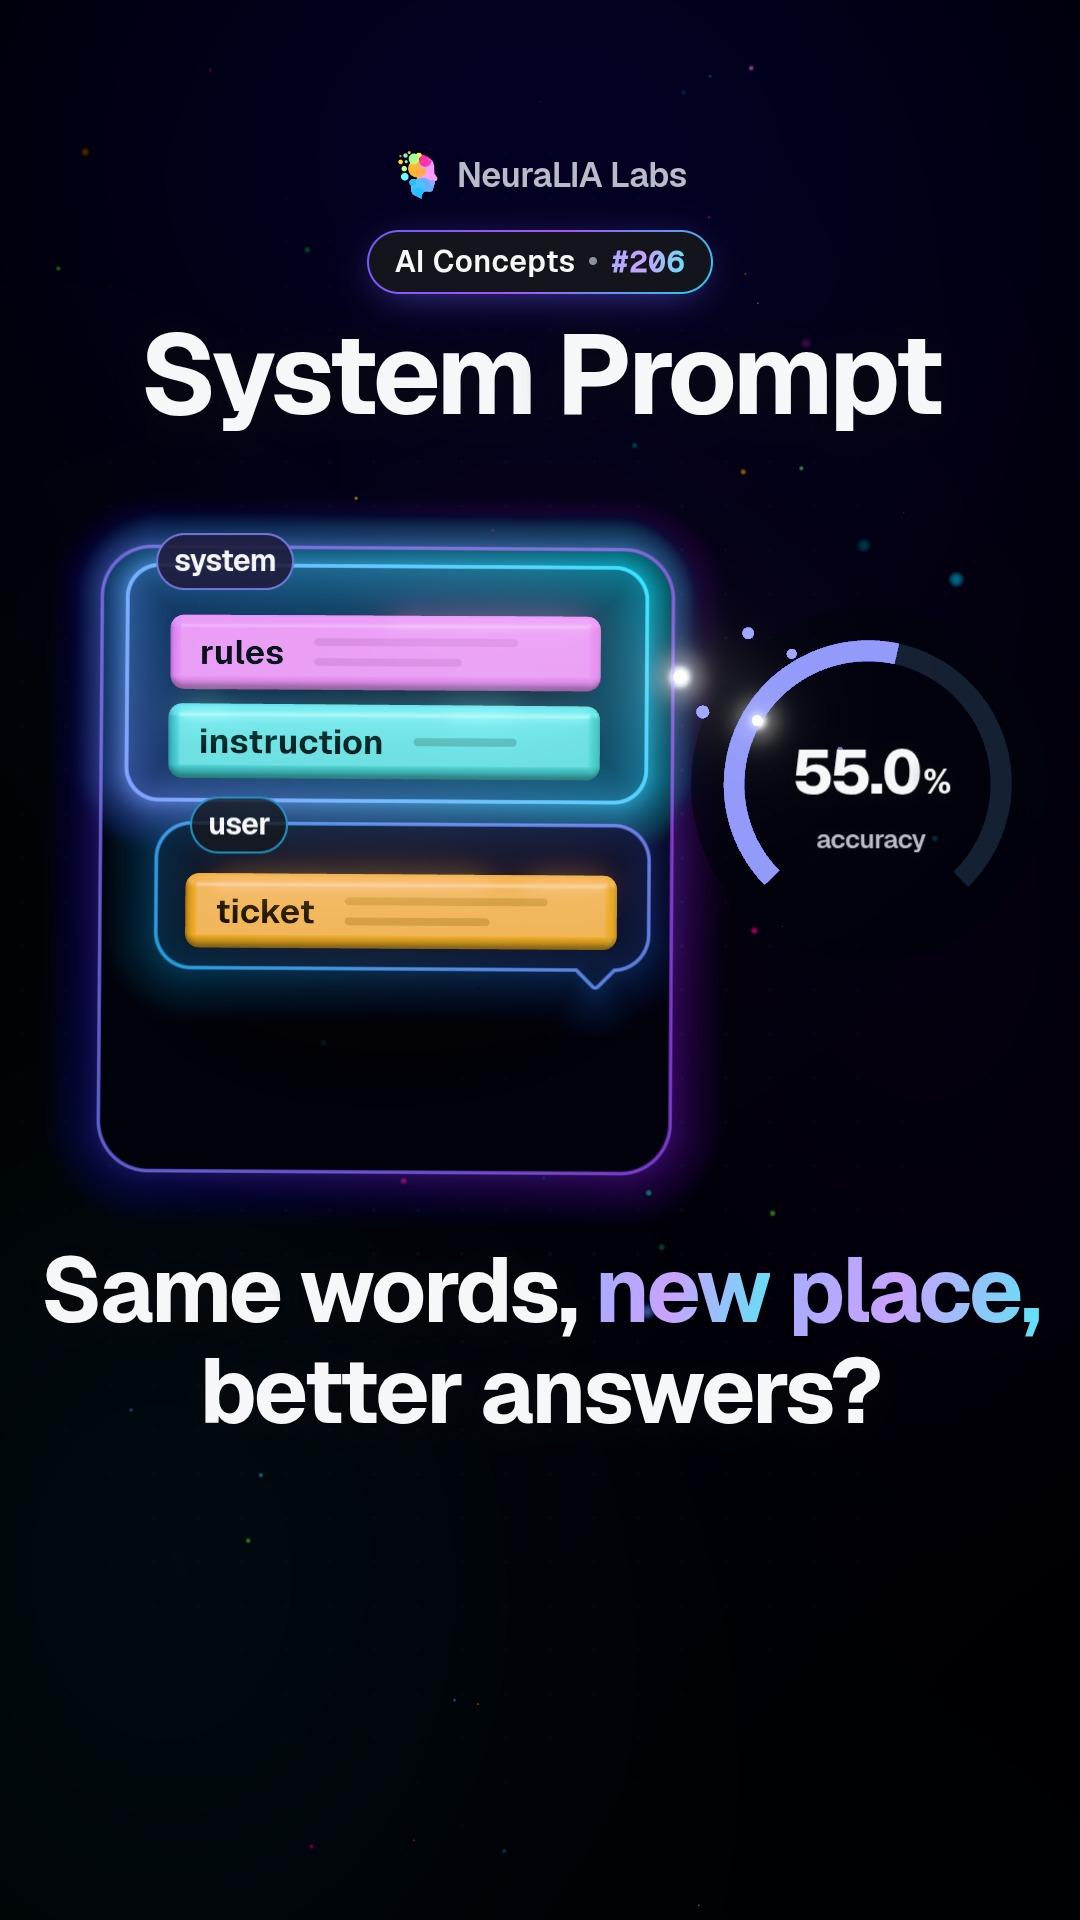 #206
System prompt: why where you put AI instructions changes results
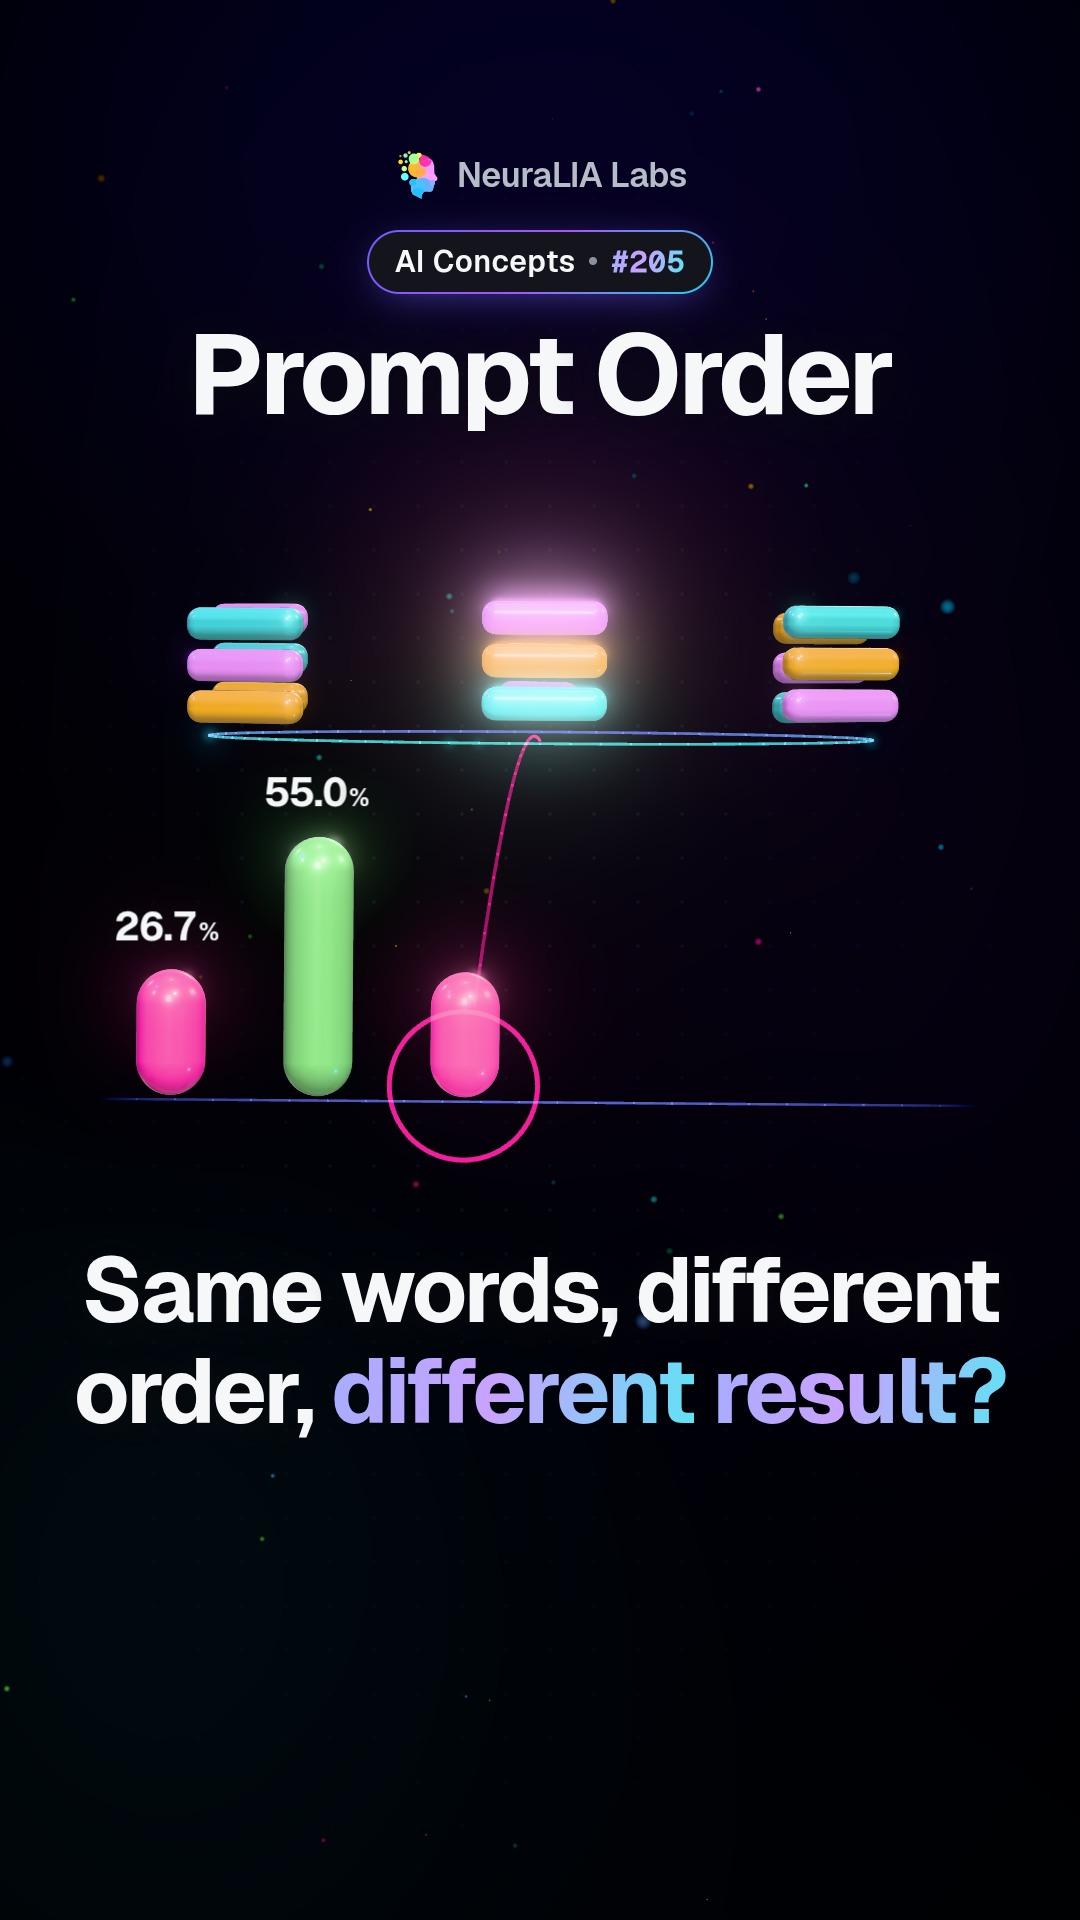 #205
Prompt order: the same words, rearranged, can double AI accuracy
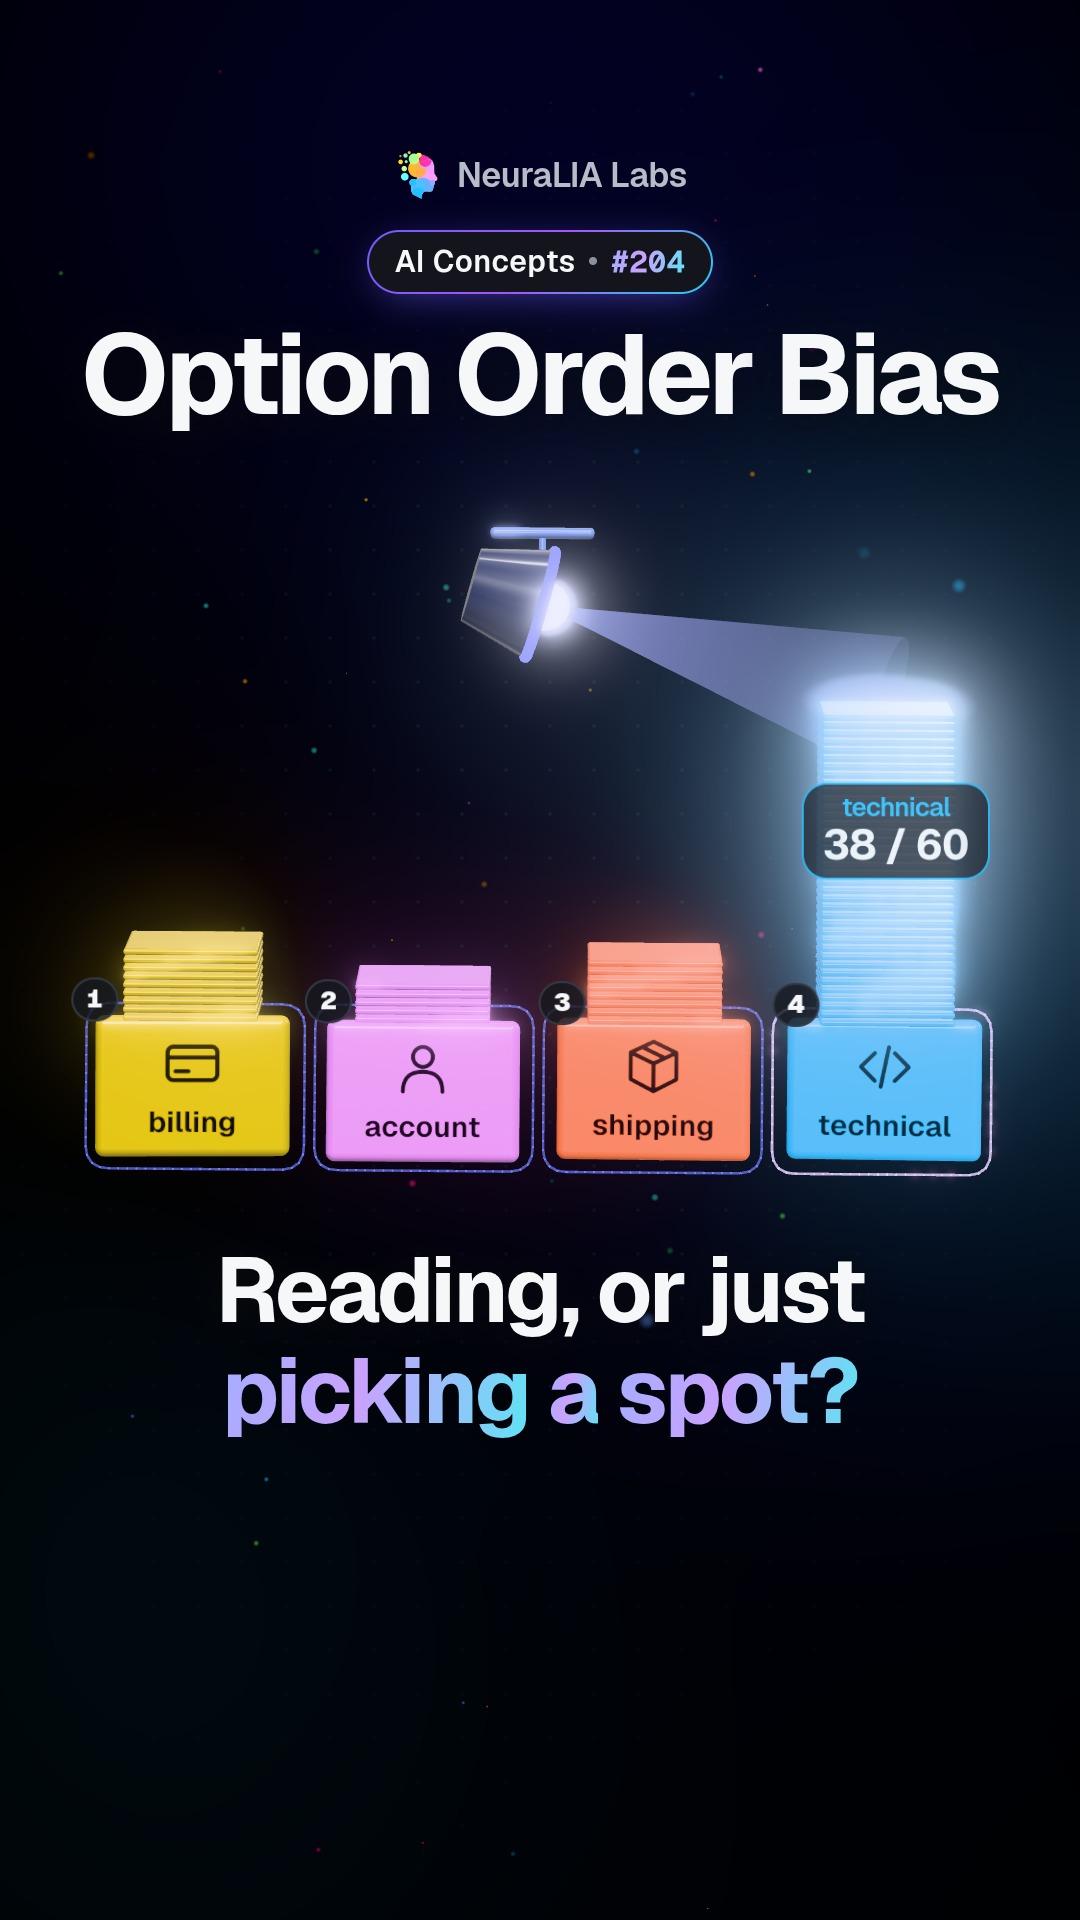 #204
Option order bias: when an AI picks a position, not an answer
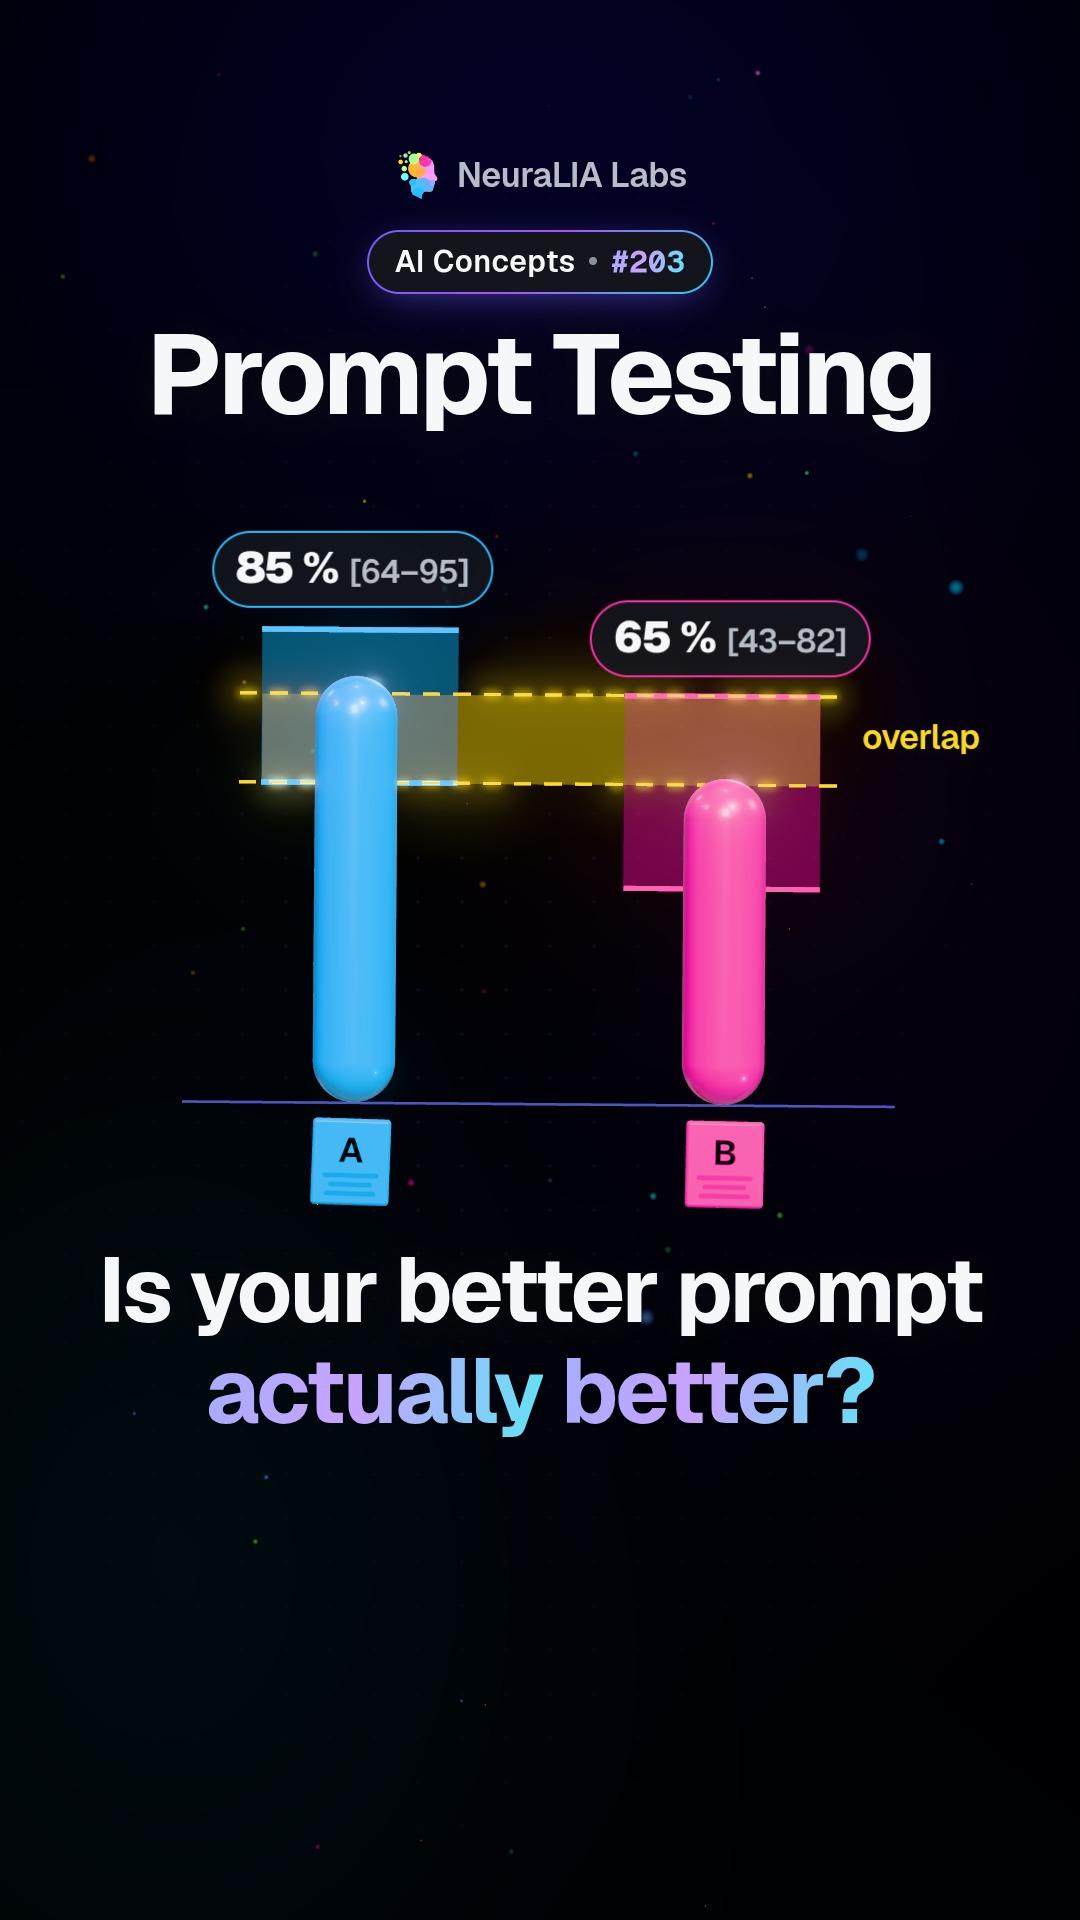 #203
Prompt testing: why twenty examples can't prove a prompt is better
 #202
Idempotency key: how to retry an AI request without paying twice
 #201
Idle timeout: how to tell a long AI answer from a frozen one
 #200
Timeouts: why every AI request needs a deadline you choose
 #199
Rate limits: when an AI service says wait, wait at least that long
 #198
Concurrency gate: letting fewer requests in made everything faster
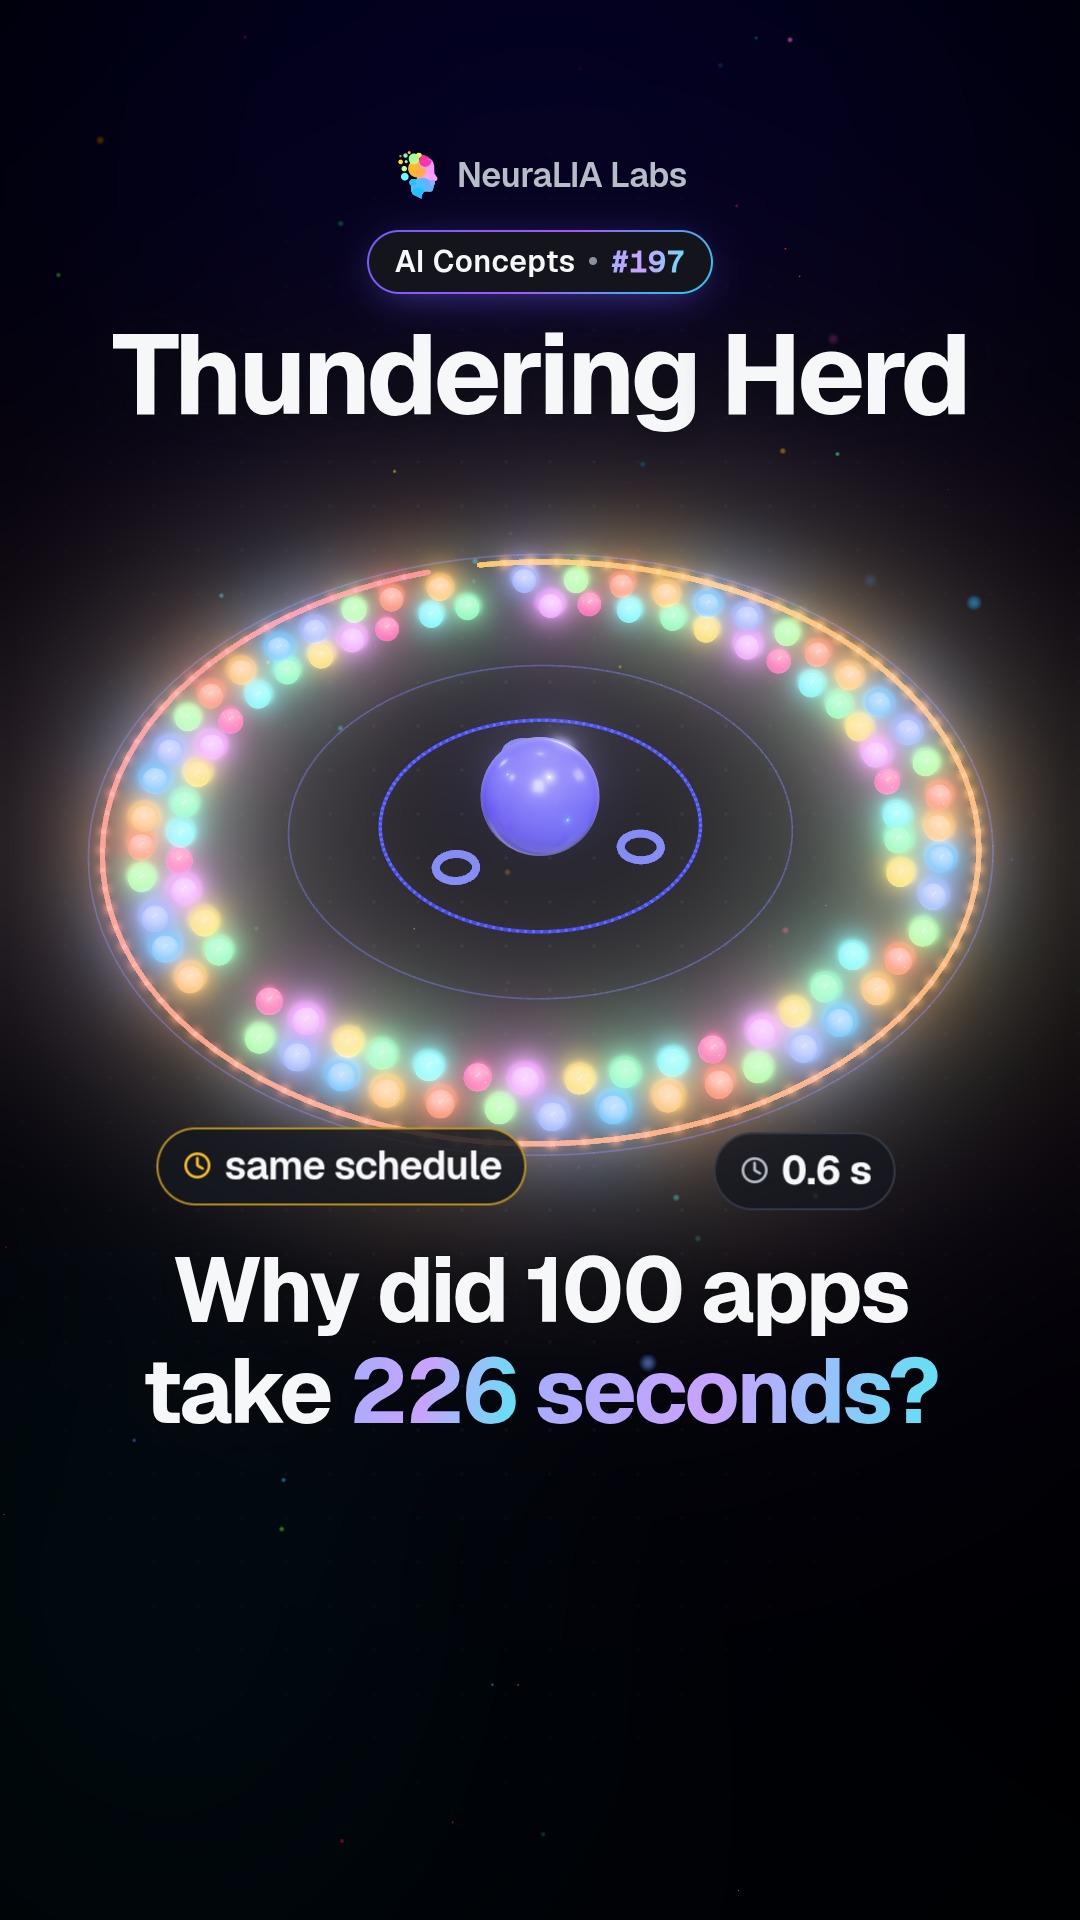 #197
Thundering herd: when retrying apps move in lockstep and jam a server
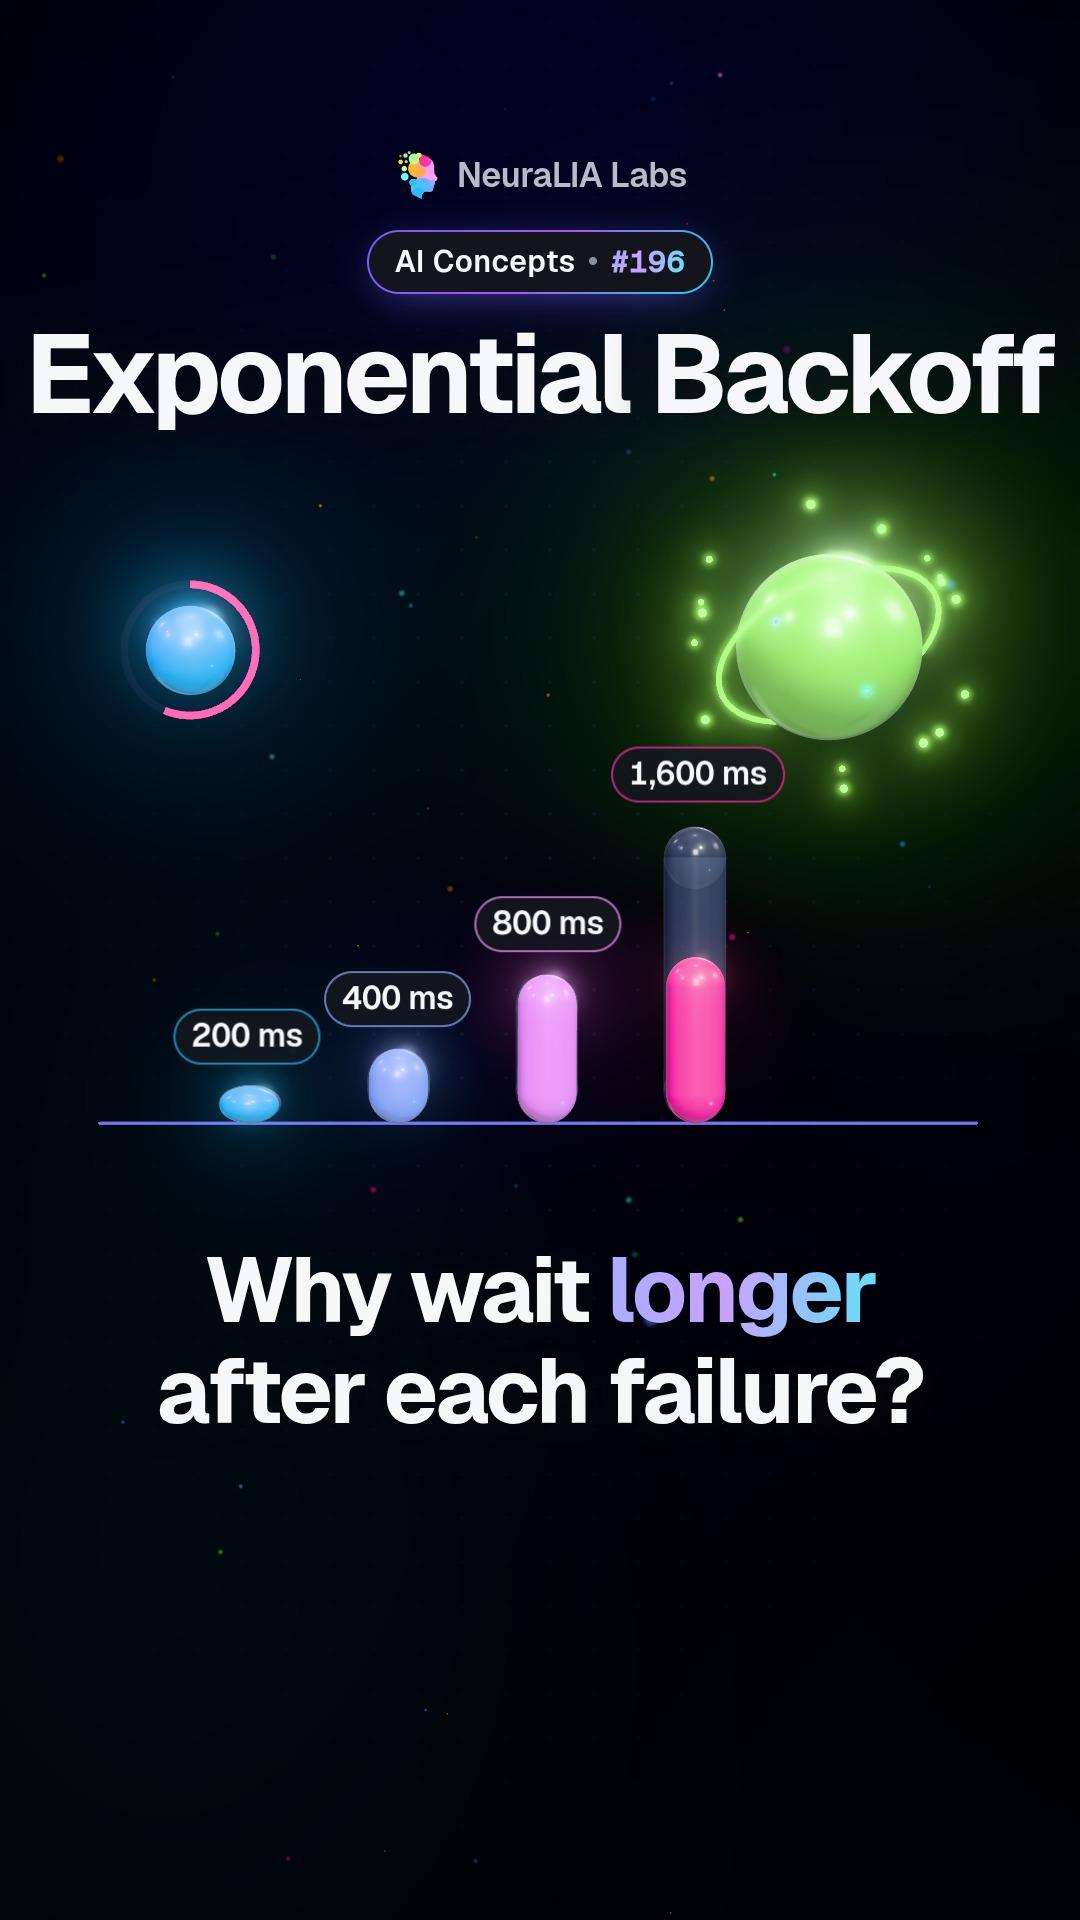 #196
Exponential backoff: why a retry should wait twice as long each time
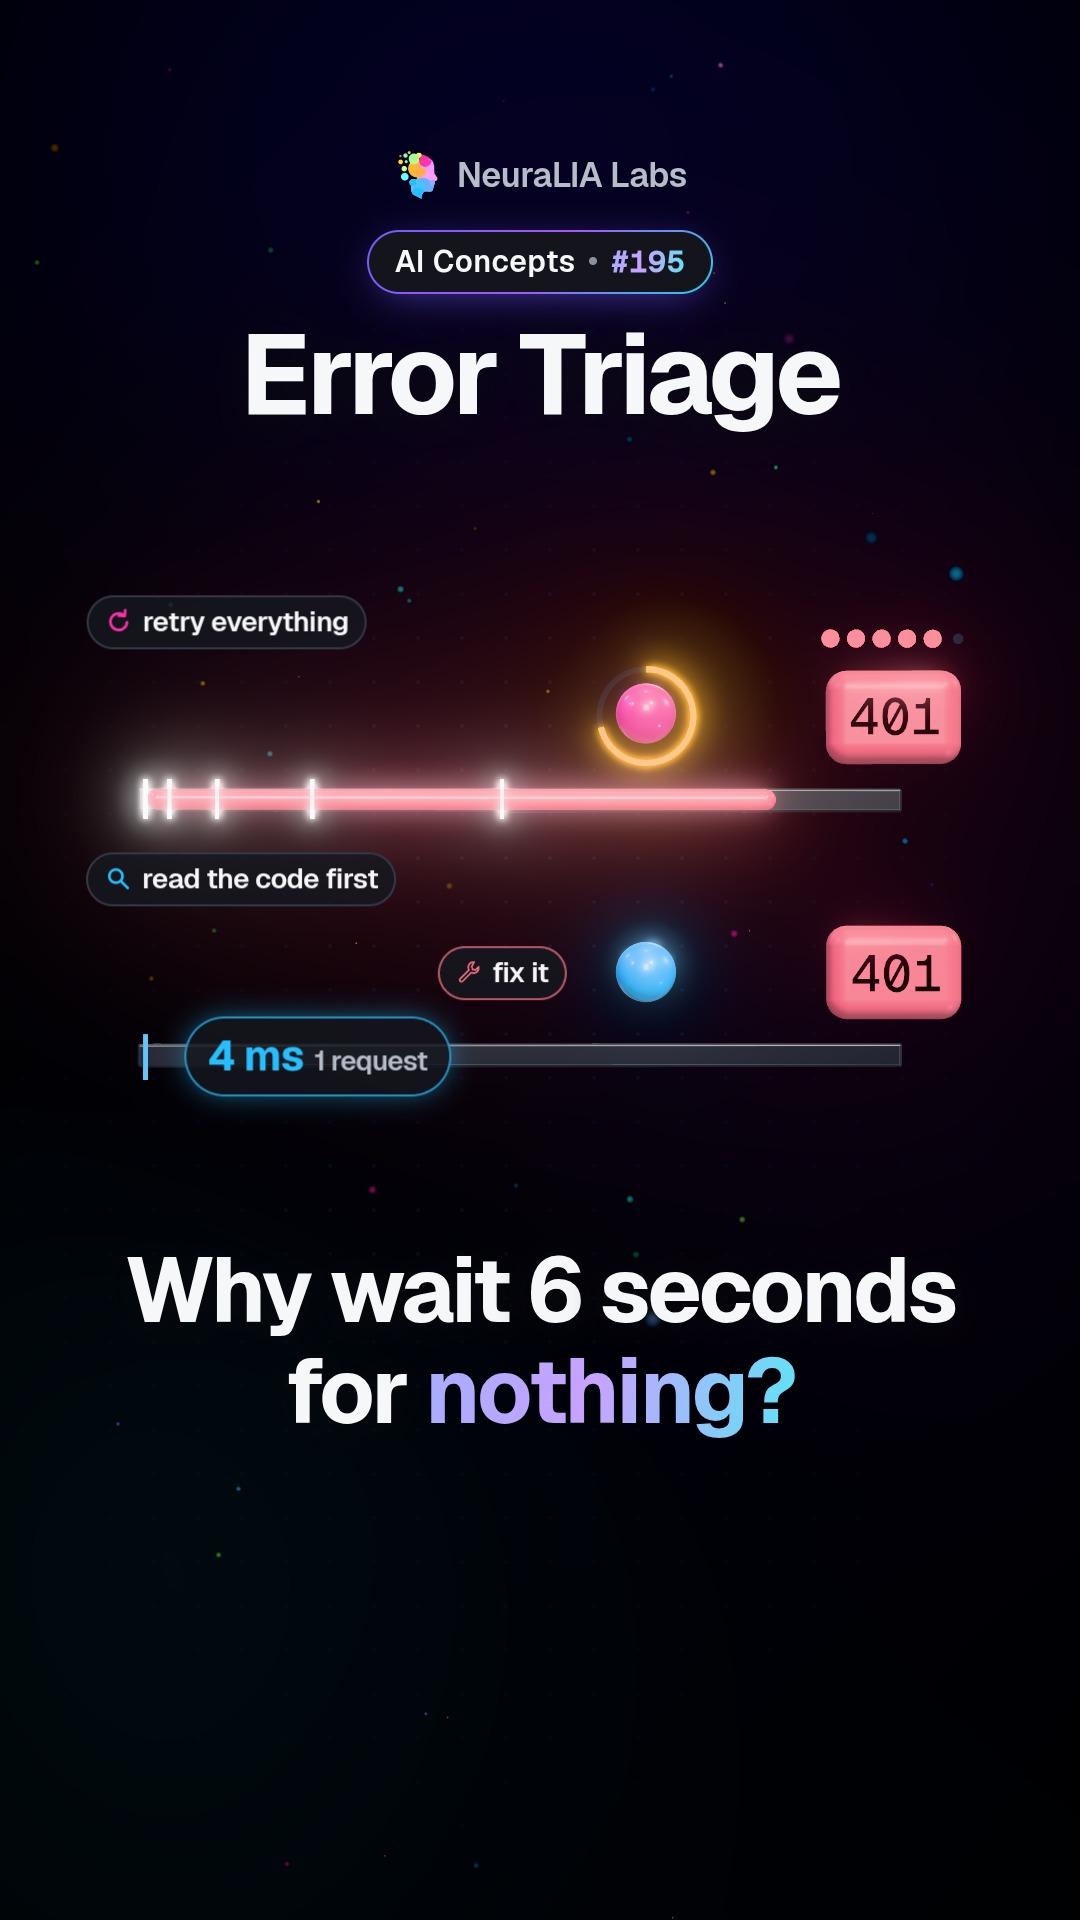 #195
Error triage: which AI errors deserve a retry and which never do
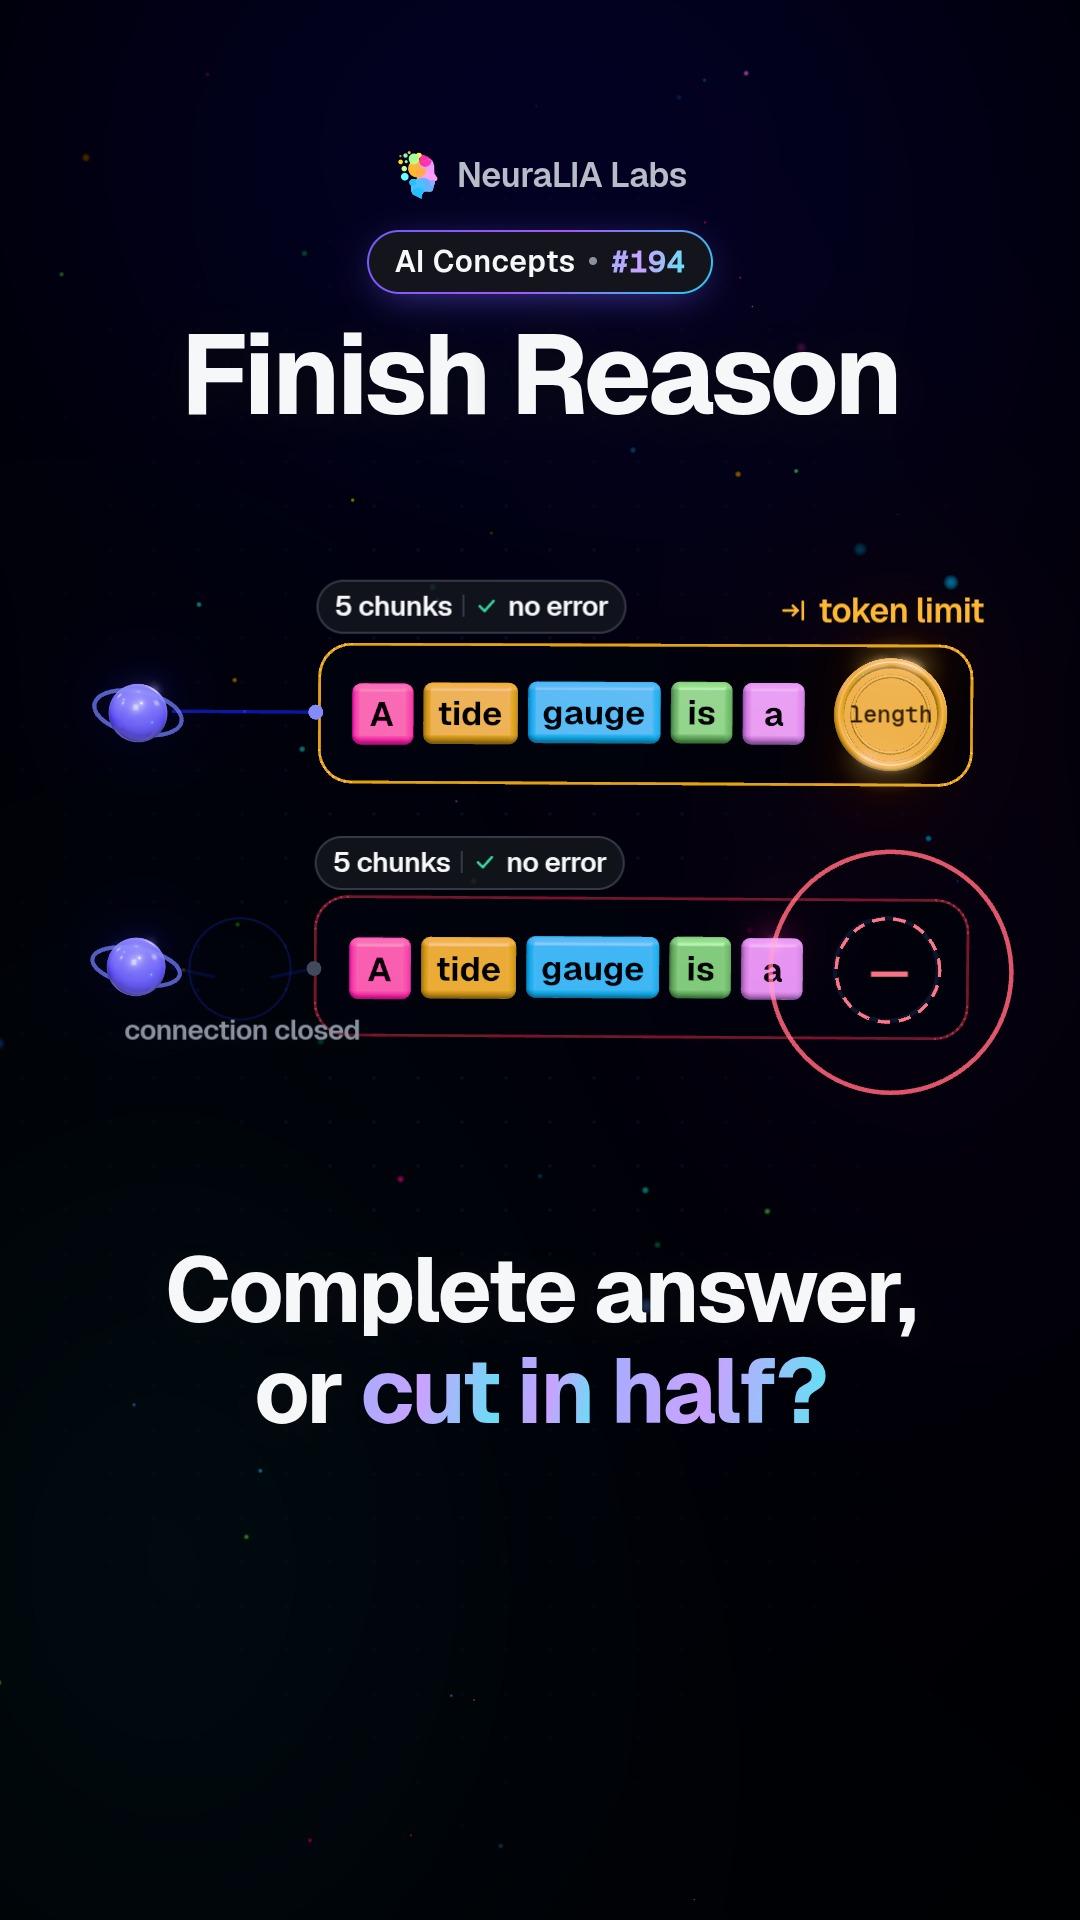 #194
Finish reason: telling a finished AI answer from a cut-off one
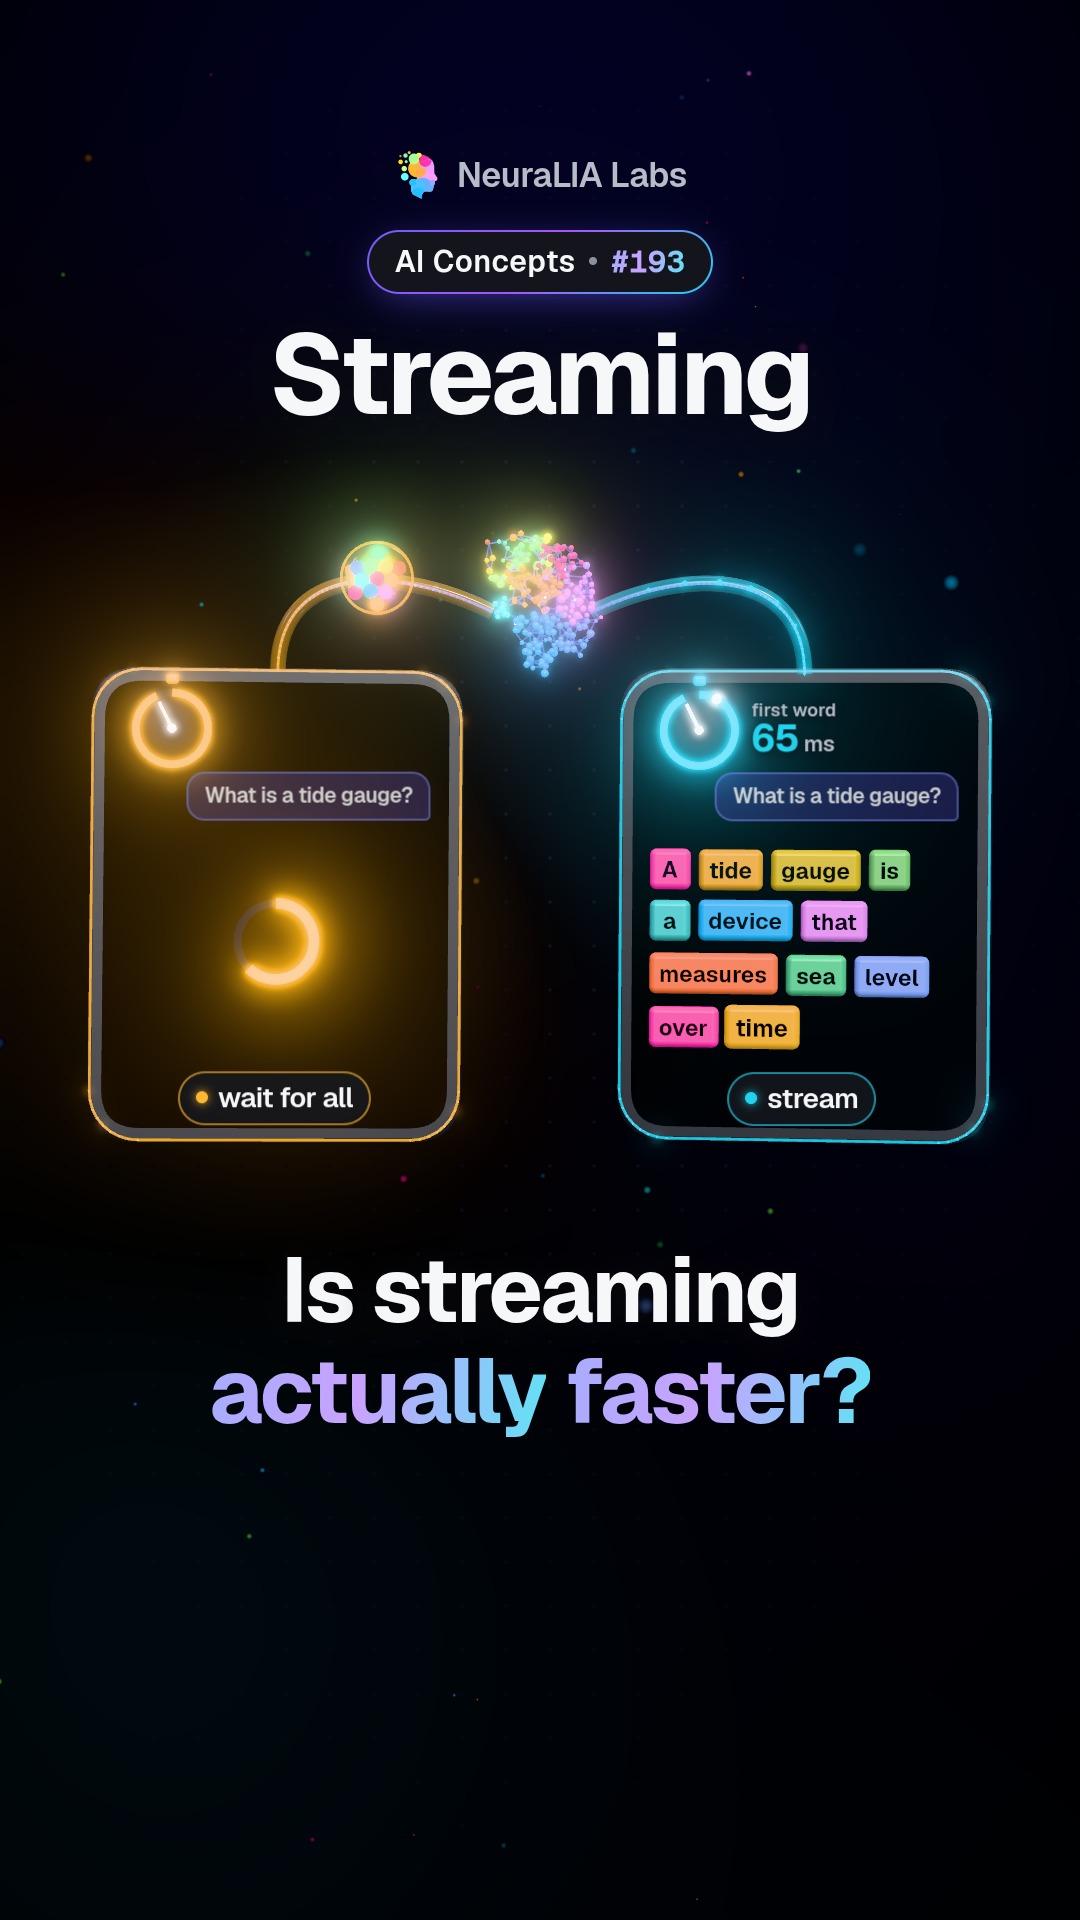 #193
Streaming: why AI answers arrive word by word, and what it really buys
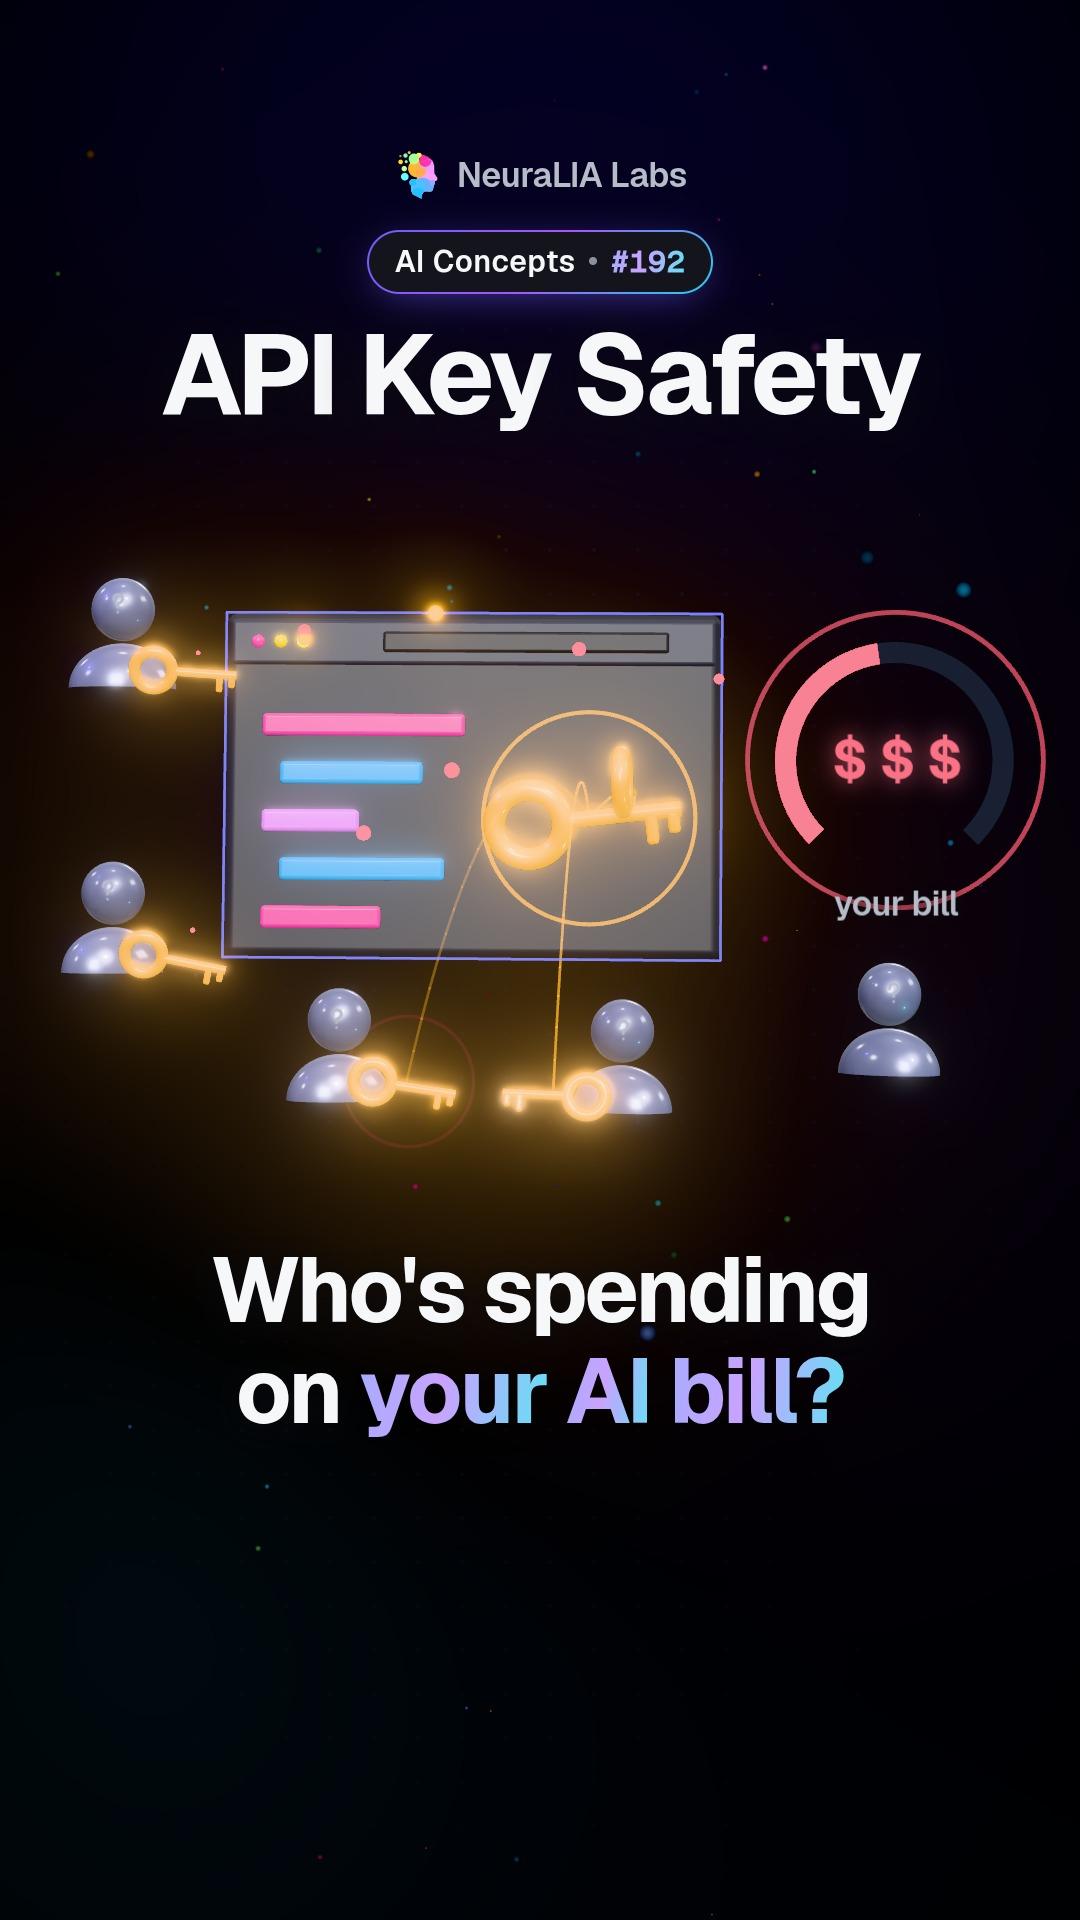 #192
API key safety: why your AI key must never reach the browser
Par chapitre du cours
- 1Le perceptron à partir de zéro : ce que calcule un neurone10 vidéos
- 2D’où vient une fonction de perte : de la vraisemblance, pas d’une convention12 vidéos
- 3En descente : gradient descent et les deux étapes que tout le monde saute13 vidéos
- 4Classification, entropie croisée et l’art de ne pas se raconter d’histoires22 vidéos
- 5Backpropagation de zéro : le moteur, puis le réseau11 vidéos
- 6Le faire apprendre, puis le faire généraliser19 vidéos
- 7Construire un tokenizer BPE : pourquoi votre modèle ne compte pas les « r »12 vidéos
- 8Prédiction du token suivant : embeddings et sens de la perplexité17 vidéos
- 9Attention et bloc transformer, dérivés d’une moyenne17 vidéos
- 10Pré-entraîner un LLM : données, calcul, scaling laws et coût21 vidéos
- 11Du modèle de base à l’assistant : SFT, RLHF, DPO et GRPO16 vidéos
- 12Chain of Thought, RLVR et test-time compute, mesurés9 vidéos
- 13Rendre l’inférence moins chère : KV cache, batching et quantification18 vidéos
- 14Votre premier appel LLM en production : streaming, retries, timeouts11 vidéos
- 15Prompt engineering, mesuré : ce qui change la sortie11 vidéos
- 16Context window, tokens et facture : les chiffres2 vidéos
- 17Température, top-p et le déterminisme que vous n’avez pas
- 18Tool calling et sorties structurées : le contrat qui tient
- 19RAG en production : chunking, retrieval et citations honnêtes
- 20Fine-tuning, retrieval ou prompt ? La décision est économique
- 21Tarification multimodale : ce que facturent vraiment images, audio et vidéo
- 22Qu’est-ce qu’un agent IA : cinq types classiques, deux définitions rivales
- 23Construire un agent harness : la boucle et ses cinq issues
- 24Context Engineering : pourquoi votre agent devient moins fiable au tour 40
- 25Orchestration multi-agent : cinq schémas, et quand l’un l’emporte
- 26MCP expliqué à partir de la spec : ce qu’est vraiment un serveur
- 27Livrer un serveur MCP : TypeScript et Python, mesurés
- 28Agent Skills et SKILL.md : la divulgation progressive, mesurée
- 29Évaluer les LLM : des benchmarks publics à votre golden set
- 30Prompt Injection et trifecta létal : sécuriser un vrai agent