
Створюємо BPE Tokenizer: чому ваша модель не може порахувати літери R
Навчіть byte-pair encoder за 60 рядків, побачте, як він сам відкриває «the», і виміряйте, чому абзац іспанською коштує на 39 % більше.
На цій сторінці
Запитайте модель, яка може скласти адвокатський іспит, скільки літер r у слові strawberry, — і є непоганий шанс, що вона відповість: дві.
Звичне пояснення — мовляв, мовні моделі «погано рахують» або «насправді не розуміють». Обидва твердження неможливо спростувати, і жодне не є причиною. Причина механічна, вона виникає ще до запуску моделі, і її видно в одному рядку:
'strawberry' -> 3 tokens [496, 675, 15717] ['str', 'aw', 'berry']Модель дивиться не на десять літер. Вона дивиться на три числа. Щоб порахувати r, їй треба було б лише з ідентичності token 496 знати, скільки r міститься всередині рядка, якого вона не бачить, — а потім зробити те саме для 675 і 15717 та скласти результати. Її просять відповісти на запитання про подання, до якого вона не має доступу.
У цьому розділі ми побудуємо те, що породжує ці три числа. Це займає близько шістдесяти рядків, це той самий алгоритм, який використовує кожна велика модель, і щойно ви його напишете, десяток на вигляд не пов’язаних дивностей зведуться до однієї причини.
Чому не літери й чому не слова
Посилання на розділ: Чому не літери й чому не словаЄ два очевидні способи подавати текст у мережу, і обидва провалюються з причин, які варто зрозуміти, бо саме цей провал задає форму розв’язку.
Слова. Розбити за пробілами, кожному слову призначити число. В англійській сотні тисяч словоформ, і моделі потрібен рядок embedding для кожної, тож словник — і вихідний шар, який має видавати оцінку для кожного запису, — стає величезним. Ще гірше те, що відбувається під час inference: слово, якого модель ніколи не бачила під час навчання, не має числа. Це проблема out-of-vocabulary, і звичний пластир — відображати все невідоме в один token <UNK>, викидаючи інформацію. До того ж «слово» — не чітко визначене поняття: китайська та японська не ставлять пробіли між словами, а німецька може нескінченно зчіплювати один іменник з іншим.
Символи. Немає проблеми out-of-vocabulary, а словник складається з якихось сотні символів. Але послідовності стають дуже довгими, і розділ 9 покаже, що вартість attention зростає квадратично з довжиною послідовності. Документ на 1000 слів — це приблизно 5000 символів, тобто послідовність у чотири-п’ять разів довша, ніж потрібно, ще й за квадратичною ціною. І кожен символ сам по собі майже не несе значення, тому перші кілька шарів витрачаються на повторне складання слів, які tokenizer міг би передати цілими.
Відповідь посередині: subwords. Часті слова стають одним token, рідкісні слова розбиваються на частини, і нічого ніколи не є невідомим, бо частини внизу зводяться до окремих байтів. Найцікавіше, що ніхто не проєктує цей поділ. Tokenizer навчається на даних того самого типу, що й модель, і вчиться, які послідовності байтів заслуговують на власне число, підраховуючи, як часто вони трапляються разом.
Byte-pair encoding
Посилання на розділ: Byte-pair encodingАлгоритм походить із 1994 року, і це був алгоритм стиснення. Philip Gage опублікував його в C Users Journal як спосіб зменшувати файли, багаторазово замінюючи найчастішу пару сусідніх байтів байтом, якого немає в даних.1 Він пролежав там двадцять два роки, доки Sennrich, Haddow і Birch у 2016 році не переосмислили його для машинного перекладу, щоб розв’язати проблему out-of-vocabulary.2 Тепер саме так читає фактично кожна велика мовна модель.
Цикл навчання — це чотири повторювані кроки:
Почати з байтів
Посилання на розділ: Почати з байтівЗакодуйте навчальний текст як UTF-8. Кожне значення байта 0–255 — це token. Розмір словника: 256.
Порахувати сусідні пари
Посилання на розділ: Порахувати сусідні париПройдіться послідовністю й порахуйте, як часто трапляється кожна пара сусідніх tokens.
Об’єднати найчастішу пару
Посилання на розділ: Об’єднати найчастішу паруВізьміть переможця, створіть для нього новий token id і замініть кожне входження в послідовності. Словник зростає на один; послідовність коротшає.
Записати merge і повторити
Посилання на розділ: Записати merge і повторитиЗбережіть пару та id, яким вона стала, у порядку. Цей упорядкований список і є tokenizer — це все, що потрібно, щоб пізніше кодувати новий текст.
Ось увесь trainer:
def get_stats(ids):
    counts = {}
    for a, b in zip(ids, ids[1:]):
        counts[(a, b)] = counts.get((a, b), 0) + 1
    return counts


def merge(ids, pair, idx):
    out, i = [], 0
    while i < len(ids):
        if i < len(ids) - 1 and ids[i] == pair[0] and ids[i + 1] == pair[1]:
            out.append(idx)
            i += 2
        else:
            out.append(ids[i])
            i += 1
    return out


class BPE:
    def __init__(self):
        self.merges = {}
        self.vocab = {i: bytes([i]) for i in range(256)}

    def train(self, text, vocab_size):
        ids = list(text.encode("utf-8"))
        for i in range(vocab_size - 256):
            stats = get_stats(ids)
            if not stats:
                break
            pair = max(stats, key=stats.get)
            idx = 256 + i
            ids = merge(ids, pair, idx)
            self.merges[pair] = idx
            self.vocab[idx] = self.vocab[pair[0]] + self.vocab[pair[1]]
return idsСпостерігаємо, як народжуються merges
Посилання на розділ: Спостерігаємо, як народжуються mergesЗапустіть його на 151 191 байті англійської прози й виведіть перші дванадцять merges у момент їх появи. Цю частину варто читати повільно, бо ніхто не казав алгоритму нічого про англійську:
merge   1: b'e' + b' '   -> b'e '     (occurred 4433 times)
merge   2: b' ' + b't'   -> b' t'     (occurred 3302 times)
merge   3: b'\xe2' + b'\x80' -> b'\xe2\x80'  (occurred 3247 times)
merge   4: b' ' + b'a'   -> b' a'     (occurred 2335 times)
merge   5: b' t' + b'h'  -> b' th'    (occurred 2253 times)
merge   6: b'i' + b'n'   -> b'in'     (occurred 2011 times)
merge   7: b't' + b' '   -> b't '     (occurred 1904 times)
merge   8: b'e' + b'r'   -> b'er'     (occurred 1813 times)
merge   9: b'd' + b' '   -> b'd '     (occurred 1703 times)
merge  10: b'o' + b'u'   -> b'ou'     (occurred 1554 times)
merge  11: b' ' + b's'   -> b' s'     (occurred 1467 times)
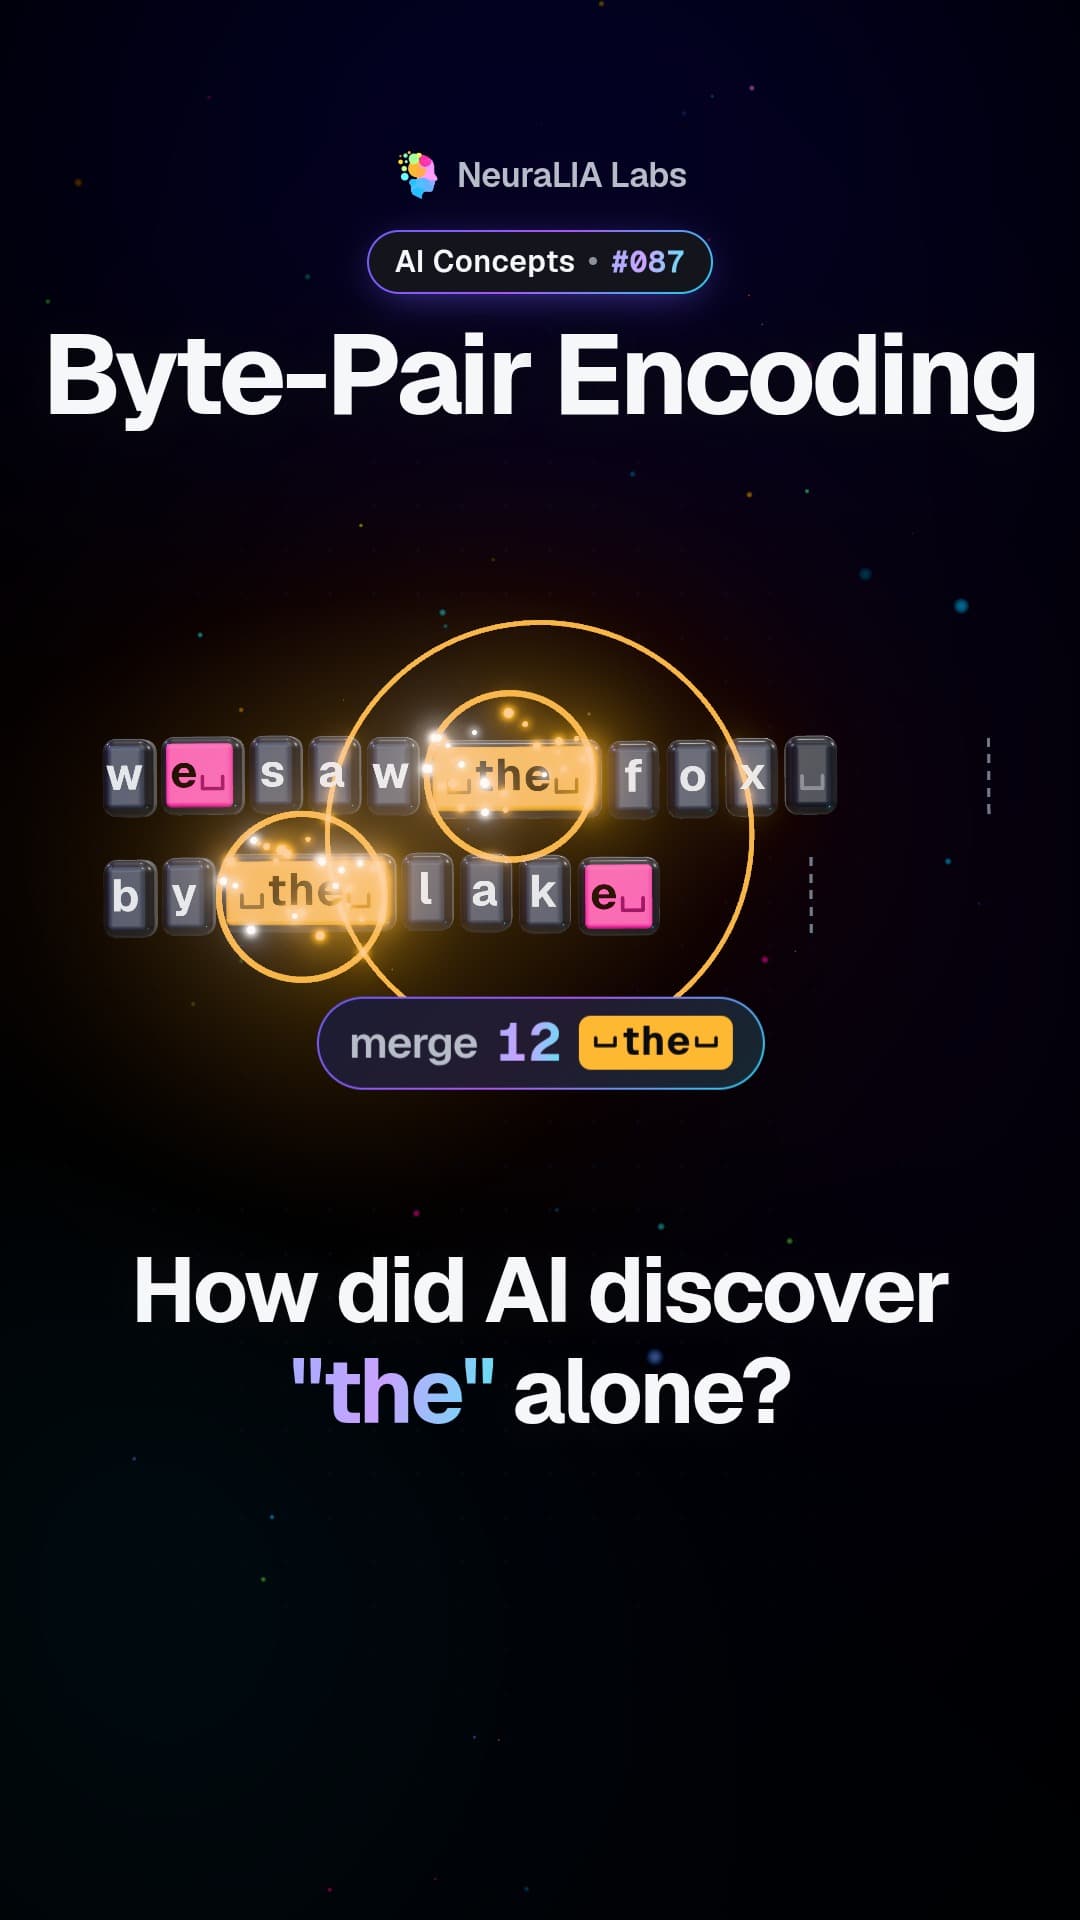
merge  12: b' th' + b'e '-> b' the '  (occurred 1270 times)
У цьому списку варто виділити три речі.
Merge 12 — це слово «the»: з пробілом перед ним і пробілом після нього, як єдина одиниця, відкрита на дванадцятій ітерації циклу, який рахує пари. Ніхто не давав словник. Воно там, бо ці п’ять байтів співтрапляються частіше за будь-які інші п’ять в англійській.
Merge 3 — це взагалі не текст. \xe2\x80 — це перші два байти UTF-8-кодування типографської пунктуації: довге тире, фігурні лапки. Алгоритм не має уявлення, що існує UTF-8, і щойно заново відкрив шматок його структури, бо багатобайтові кодування за визначенням є послідовностями байтів, які завжди з’являються разом.
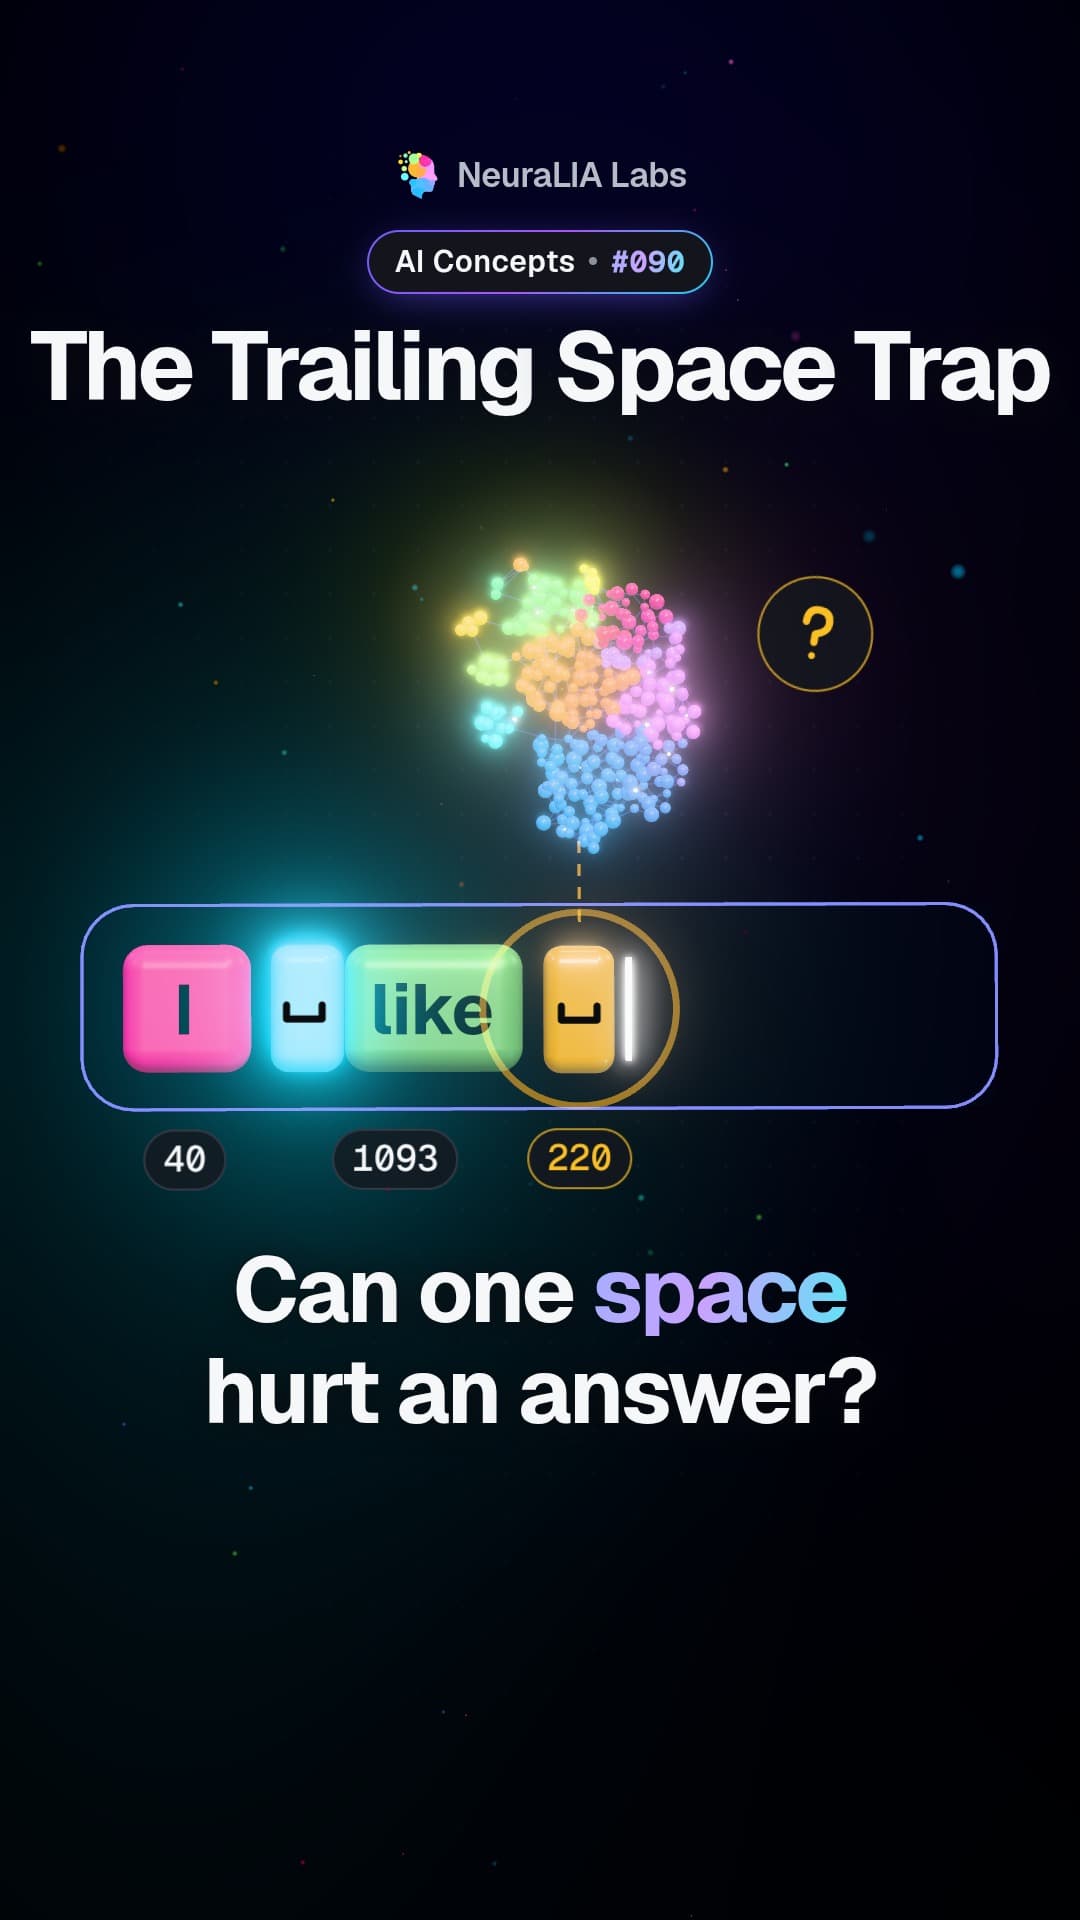
Більшість ранніх merges містять пробіл, і пробіл зазвичай стоїть ліворуч. Звідси походить одна з найзаплутаніших практичних поведінок, до якої ми скоро повернемося.
Компроміс розміру словника
Посилання на розділ: Компроміс розміру словникаКожен merge робить послідовність коротшою, а словник — більшим. Наскільки далеко це просувати, справді важливе рішення, і його можна виміряти — тут на тих самих 151 191 байті:
| розмір словника | отримані tokens | стиснення (байти на token) |
|---|---|---|
| 300 | 101 065 | 1.50 |
| 512 | 68 249 | 2.22 |
| 1,024 | 50 369 | 3.00 |
| 2,048 | 39 306 | 3.85 |
| 4,096 | 30 757 | 4.92 |
Спадна віддача — очевидна. Подвоєння з 512 до 1024 дає 0,78 байта на token; подвоєння з 2048 до 4096 дає 1,07 — тут краще лише тому, що корпус достатньо малий, аби довші merges і далі окупалися. На справжньому корпусі крива різко вирівнюється.
І вартість більшого словника — це не лише пам’ять. Кожному token потрібен рядок embedding, а ще дорожче те, що вихідний шар моделі має видавати оцінку для кожного запису словника на кожному кроці, тож фінальне множення матриць масштабується з розміром словника. Реальні моделі лежать між 32 000 і 200 000: GPT-2 використовувала 50 257, cl100k у GPT-4 має 100 277, o200k у GPT-4o приблизно подвоює це число. Тренд іде вгору, і причина — в наступному розділі.
Рахунок за мовами
Посилання на розділ: Рахунок за мовамиОсь той самий абзац у перекладі, виміряний реальними tokenizers, які постачає OpenAI:
| мова | символи | tokens (cl100k) | tokens (o200k) | tokens/char | накладні витрати проти англійської |
|---|---|---|---|---|---|
| Англійська | 164 | 31 | 31 | 0.189 | — |
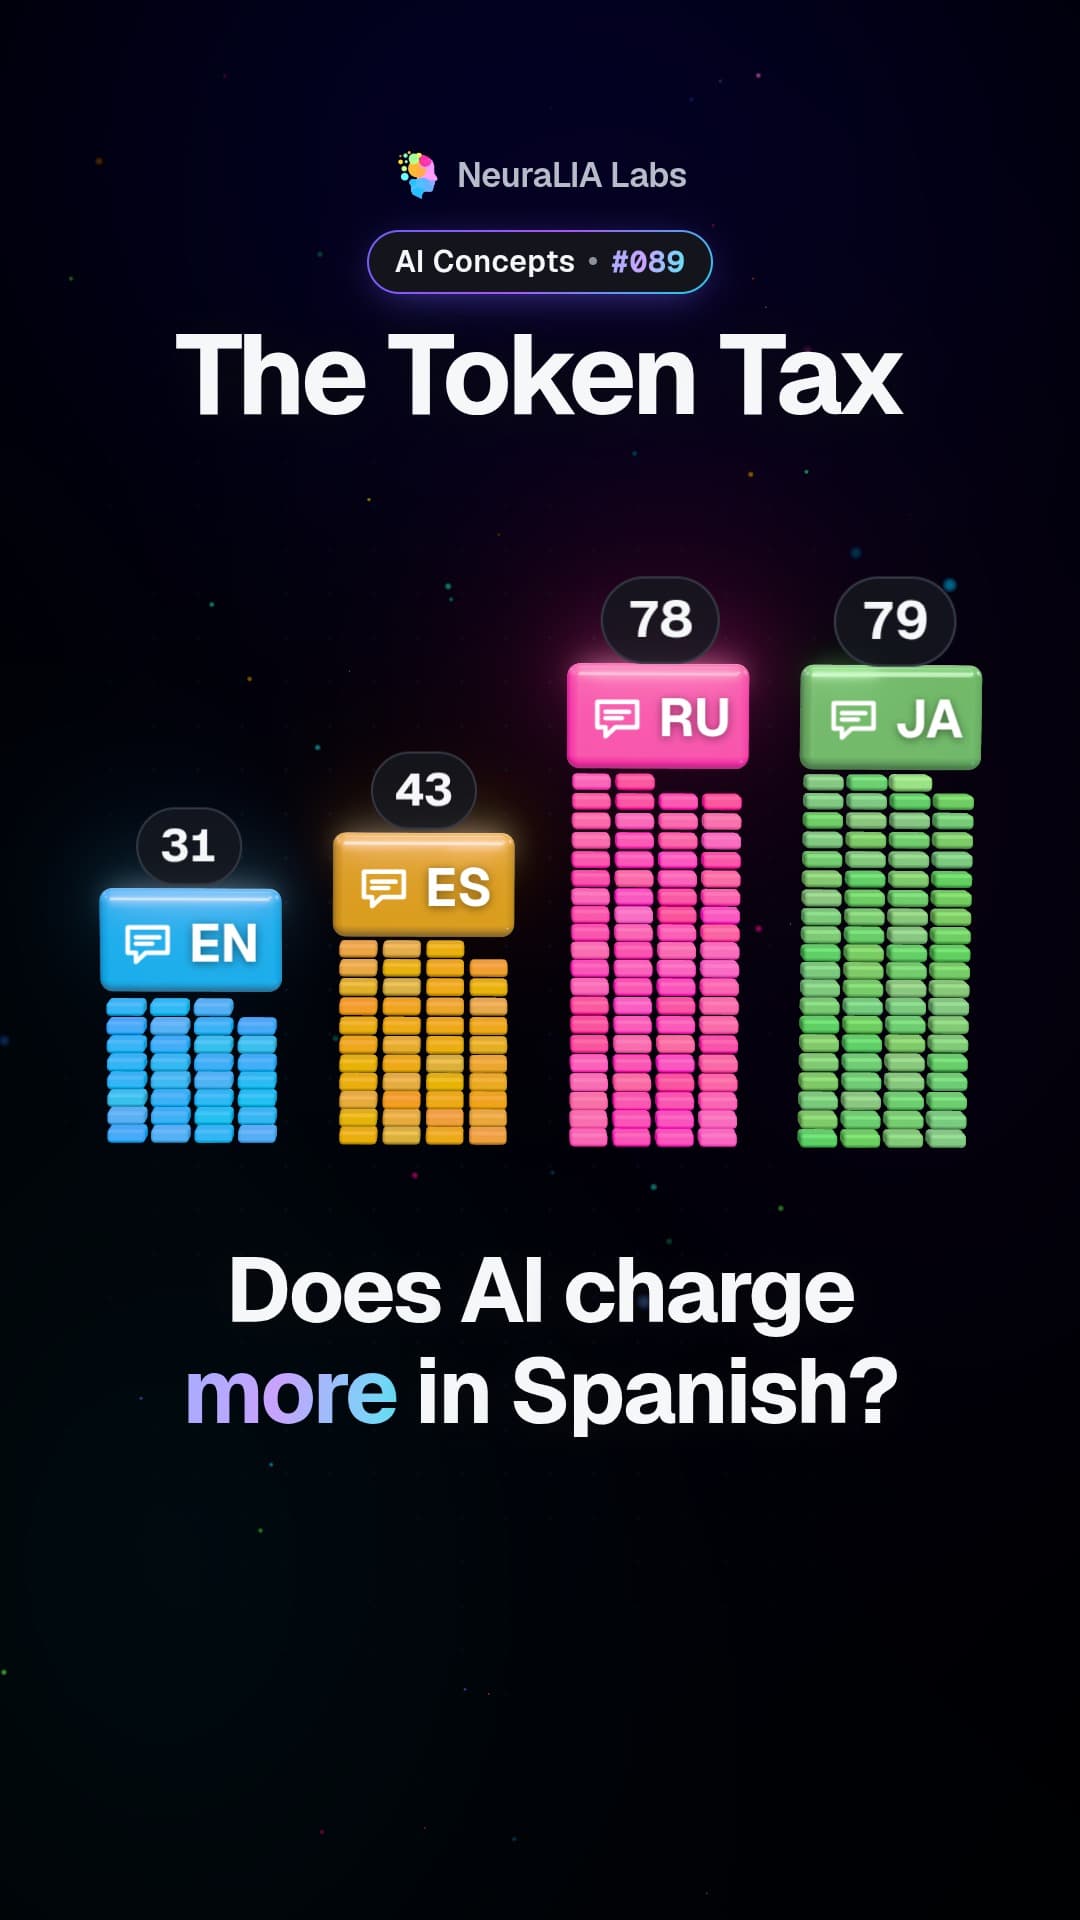
| Іспанська | 169 | 43 | 36 | 0.254 | +39 % |
| Російська | 178 | 78 | 43 | 0.438 | +152 % |
| Японська | 72 | 79 | 58 | 1.097 | +155 % |
Той самий зміст, те саме значення, і з cl100k російська версія споживає у два з половиною рази більше tokens. Оскільки API тарифікуються за token, а context windows вимірюються в tokens, це не лінгвістична цікавинка — це рядок у бюджеті, коротше ефективне context window і повільніша відповідь, усе три одночасно, для всіх, хто не працює англійською.
Механізм — у навчальних даних. Tokenizer, навчений переважно на англійській, витрачає свій бюджет merges на англійські послідовності байтів. Іспанська має спільний латинський алфавіт, тож усе ще отримує частину вигоди; російська майже не отримує нічого, бо кириличні символи займають два байти в UTF-8, і небагато з цих пар були достатньо частими в навчальному корпусі, щоб заслужити merge. З японською ще гірше: три байти на символ, і 72 символи стають 79 tokens — tokens більше, ніж символів.
Стовпець o200k показує, що цю проблему можна розв’язати — і її вже розв’язують. Подвоєння словника й перебалансування навчальних даних зменшує іспанські накладні витрати з +39 % до +16 %, а російські — з +152 % до +39 %. Це справжня причина, чому словники продовжують зростати: не стиснення заради стиснення, а факт, що попереднє покоління тихо виставляло значній частині світу додатковий рахунок.
Кодування і чому порядок merges важливий
Посилання на розділ: Кодування і чому порядок merges важливийНавчання породило впорядкований список merges. Кодування нового тексту відтворює його — і має відтворювати в тому самому порядку, бо merge 12 об’єднує результати merges 5 і 1. Застосуйте їх в іншому порядку — і отримаєте іншу, неправильну tokenization, яка не збігатиметься ні з чим, що модель бачила під час навчання.
    def encode(self, text):
        ids = list(text.encode("utf-8"))
        while len(ids) >= 2:
            stats = get_stats(ids)
            # the pair whose merge came FIRST during training wins
            pair = min(stats, key=lambda p: self.merges.get(p, float("inf")))
            if pair not in self.merges:
                break
            ids = merge(ids, pair, self.merges[pair])
        return ids

    def decode(self, ids):
        return b"".join(self.vocab[i] for i in ids).decode("utf-8", errors="replace")
Декодування в порівнянні тривіальне: знайти байти кожного id, склеїти, декодувати як UTF-8. Зверніть увагу на errors="replace": модель може видати послідовність tokens, яка закінчується посеред символу, і це не гіпотетика — саме це трапляється, коли streaming-відповідь обрізають посеред emoji, тому streaming API буферизують часткові байти, а не декодують token за token.
Round-trip працює на будь-чому, і це обіцянка байтового BPE:
'strawberry'                            -> 6 tokens, decode == original: True
'Alice was beginning to get very tired' -> 14 tokens, decode == original: True
'café — naïve — 日本語' -> 23 tokens, decode == original: TrueУсе інше, що насправді є тим самим
Посилання на розділ: Усе інше, що насправді є тим самимКоли механізм зрозумілий, набір на вигляд не пов’язаних скарг виявляється однією й тією самою скаргою.
Арифметика. Числа не розбиваються послідовно:
1234     -> 2 tokens  ['123', '4']
12345    -> 2 tokens  ['123', '45']
1000000  -> 3 tokens  ['100', '000', '0']
3.14159  -> 4 tokens  ['3', '.', '141', '59']
2024     -> 2 tokens  ['202', '4']
Щоб додати 1234 і 12345, модель спершу має з’ясувати, що ['123','4'] і ['123','45'] — це числа, чиї цифри вирівнюються певним способом, причому вирівнювання різне для кожної пари чисел. Цифри числа не перебувають в одних і тих самих місцях від одного числа до наступного. Деякі новіші tokenizers примусово розбивають цифри на стабільні групи по три саме для усунення цієї перешкоди, і моделі, навчені з ними, вимірювано краще справляються з арифметикою.
Відступи Python.
'    x = 1'      -> 5 tokens  ['   ', ' x', ' =', ' ', '1']
'        x = 1'  -> 5 tokens  ['       ', ' x', ' =', ' ', '1']
'\tx = 1'        -> 4 tokens  ['\tx', ' =', ' ', '1']
Чотири пробіли й вісім пробілів — це різні одиночні tokens, а tab злитий із символом після нього. Відступ, який у Python є синтаксисом, поданий непослідовно — це значна частина причини, чому моделі раніше генерували Python із ледь помітно неправильними відступами, і чому орієнтовані на код tokenizers додають явні tokens для поширених послідовностей відступів.
Правопис і розвертання. Та сама причина, що й із підрахунком r: просити модель розвернути strawberry — це просити її переставити літери всередині трьох непрозорих id. Моделі роблять це, бо запам’ятали написання під час навчання, а не тому, що дивляться на літери, тому добре справляються з частими словами й погано — з рідкісними.
Glitch tokens. Найяскравіший випадок — SolidGoldMagikarp і набір схожих рядків, які змушували GPT-2 і GPT-3 поводитися химерно: відмовлятися повторювати їх, видавати непов’язаний результат, інколи ображати користувача. Пояснення буденне й прямо випливає з того, що tokenizer навчається окремо від моделі: ці рядки були частими в навчальному корпусі tokenizer (це були імена користувачів Reddit), тож заслужили власний token, але були рідкісними або відсутніми в навчальному корпусі моделі. Результат — рядок embedding, який ініціалізували випадково й майже ніколи не оновлювали. Модель має символ, якого вона фактично ніколи не бачила, і її поведінка там — це те, чим випадково виявилася випадкова ініціалізація.
WordPiece, який використовує BERT, відрізняється від BPE правилом вибору: замість об’єднувати найчастішу пару, він об’єднує пару, яка найбільше збільшує likelihood навчальних даних, — тобто нормалізує за тим, наскільки поширені частини вже є, тому пара з двох рідкісних фрагментів може перемогти пару з двох частих.
Unigram від Kudo працює навпаки: починає з великого кандидатного словника й ітеративно видаляє частини, вилучення яких найменше шкодить likelihood корпусу. Він також призначає імовірність кожній сегментації, що дає змогу семплювати різні tokenizations того самого рядка як регуляризатор.
SentencePiece — реалізація, яку використовує більшість неангломовних моделей. Її внесок у тому, що вона трактує вхід як сирий потік без жодної попередньої tokenization, кодує пробіл як видимий символ, а отже працює однаково для мов, які не відокремлюють слова пробілами. Під капотом вона може запускати або BPE, або Unigram.
Чого це коштує і що дає
Посилання на розділ: Чого це коштує і що даєTokenizer — це інтерфейс із втратами між текстом і числами, і кожна дивна поведінка в цьому розділі — це інтерфейс, який просвічує назовні. Варто чітко сказати, що цей обмін свідомий: байтовий BPE означає, що жоден вхід ніколи не буде непредставним, послідовності в чотири-п’ять разів коротші, ніж були б символи, а часті слова приходять цілими.
Ціна в тому, що атоми моделі — не наші атоми. Вона міркує про текст, який не може написати по літерах, в одиницях, вибраних частотним підрахунком над корпусом, якого вона не бачила, із мовною вартістю, про яку ніхто не домовлявся.
Куди це веде далі
Посилання на розділ: Куди це веде даліТепер у вас є послідовність цілих чисел. Це формат входу для всього в решті Частини II.
Чого у вас немає — то це жодної причини, чому одне ціле число має йти за іншим. Наступний розділ вводить ціль, на якій навчається кожна мовна модель, і вона вражаюче проста: маючи tokens дотепер, передбачити наступний. Ця єдина ціль — без labels, без annotation, просто текст із його власним майбутнім як target — перетворює весь інтернет на навчальні дані, і саме звідси походять перші справжні подання моделі.
Вона також вимагає, щоб ланцюгове правило ймовірності з розділу 2 було абсолютно точним, бо твердження, що передбачати по одному token за раз — те саме, що моделювати цілі документи, є факторизацією, а не метафорою.
Розділ 8 — це autoregressive objective, embeddings і перше місце, де модель вивчає щось, чого туди ніхто не закладав.
Джерела й метод
Посилання на розділ: Джерела й методKudo, T. Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates (arXiv:1804.10959) вводить модель Unigram; Kudo and Richardson, SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing (arXiv:1808.06226) — це реалізація, яку використовує більшість багатомовних моделей; Schuster and Nakajima, Japanese and Korean Voice Search (ICASSP 2012) — джерело WordPiece. Let’s build the GPT Tokenizer Андрея Карпаті та супровідний репозиторій karpathy/minbpe — прямі предки коду в цьому розділі й ідуть значно далі, включно з regex GPT-4 та обробкою special-token. Розділ 6 курсу Hugging Face LLM Course розглядає три алгоритми поруч із пропрацьованими прикладами.
Примітки
Посилання на розділ: Примітки-
Gage, P. A New Algorithm for Data Compression. The C Users Journal 12(2), pp. 23–38 (1994). Byte-pair encoding як схема стиснення за двадцять два роки до того, як хтось використав її для мовних моделей. ↩
-
Sennrich, R., Haddow, B. and Birch, A. Neural Machine Translation of Rare Words with Subword Units. arXiv:1508.07909 (2015; ACL 2016). Стаття, яка принесла BPE в NLP, мотивована словами out-of-vocabulary у перекладі. ↩
-
Radford, A., Wu, J., Child, R., Luan, D., Amodei, D. and Sutskever, I. Language Models are Unsupervised Multitask Learners (2019). Розділ 2.2 вводить байтовий BPE з regex попередньої tokenization, який обговорювався вище. ↩
Цей розділ у відео
Короткі відео, що просто пояснюють ідеї з цього розділу.
 #05
Tokens: how AI chops your words into numbered pieces
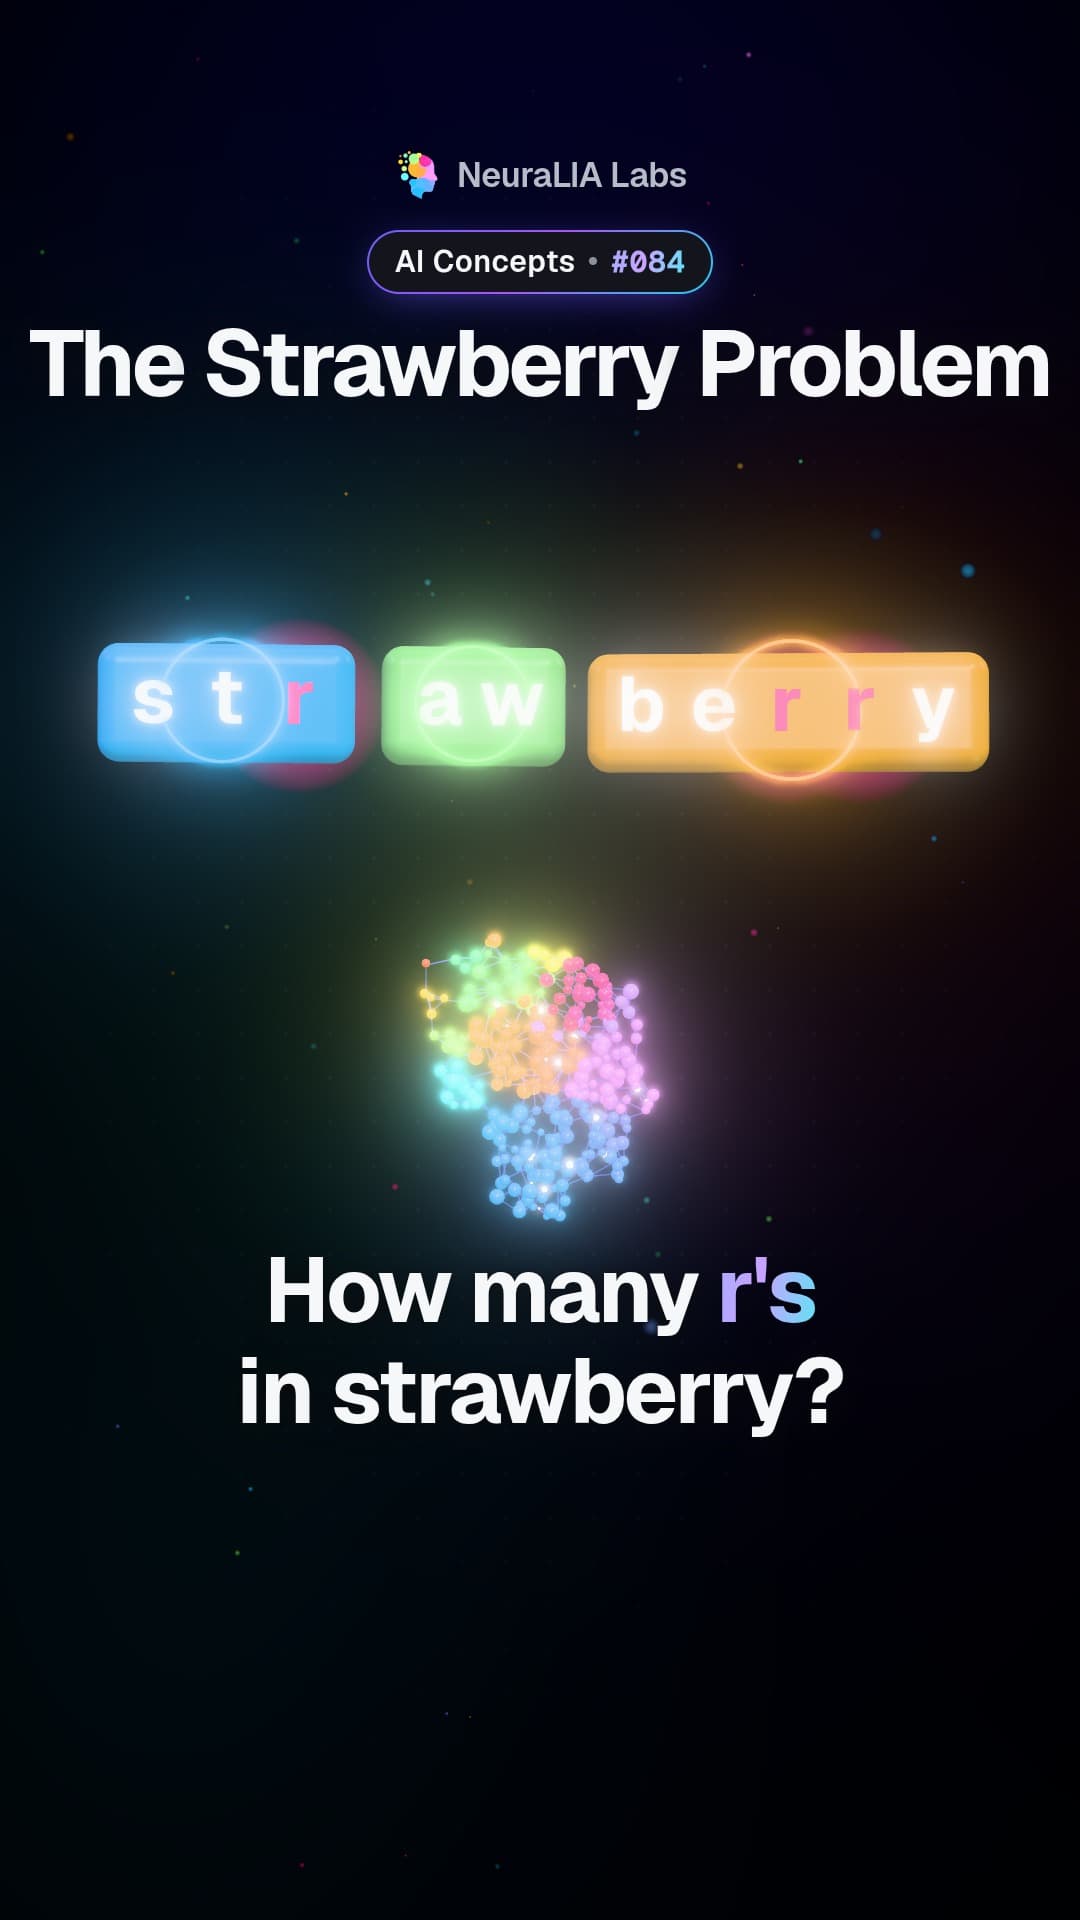 #084
The strawberry problem: why AI can miscount the r's in a word
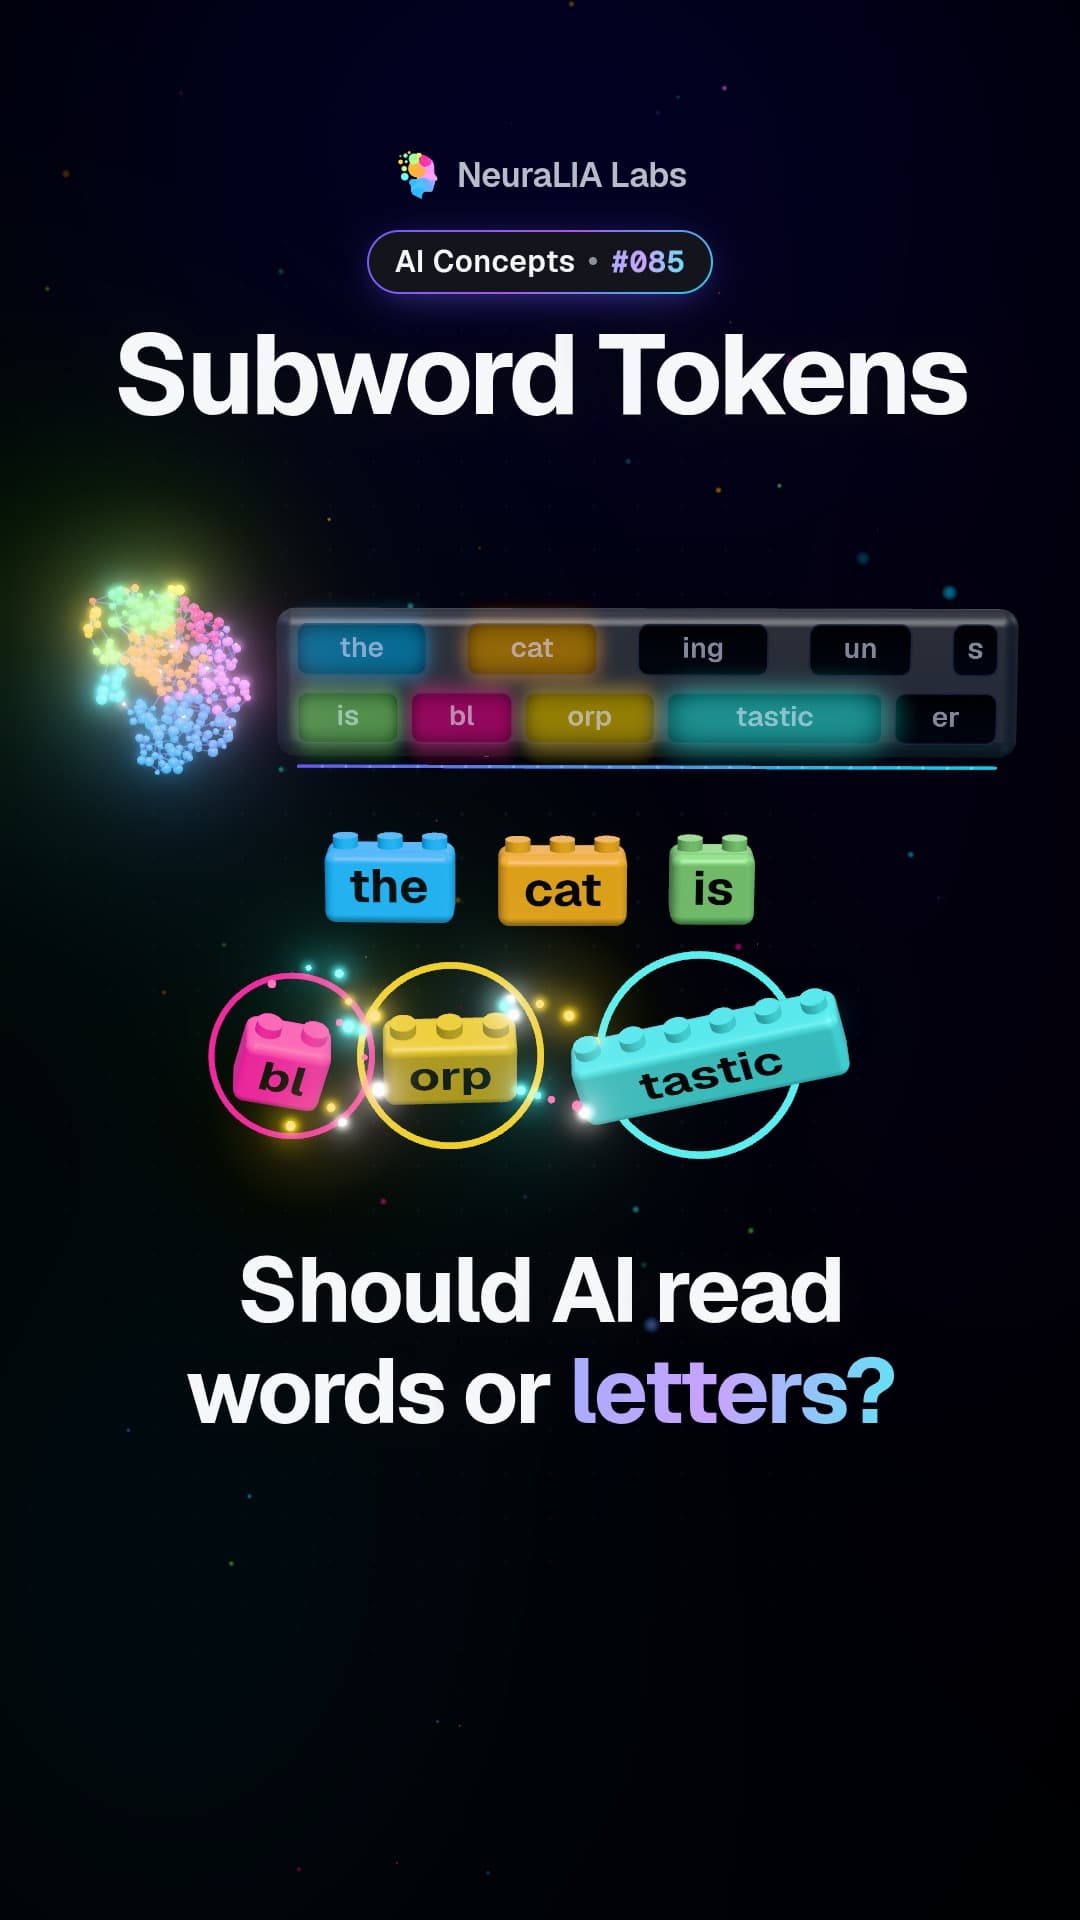 #085
Subword tokens: the middle ground between whole words and letters
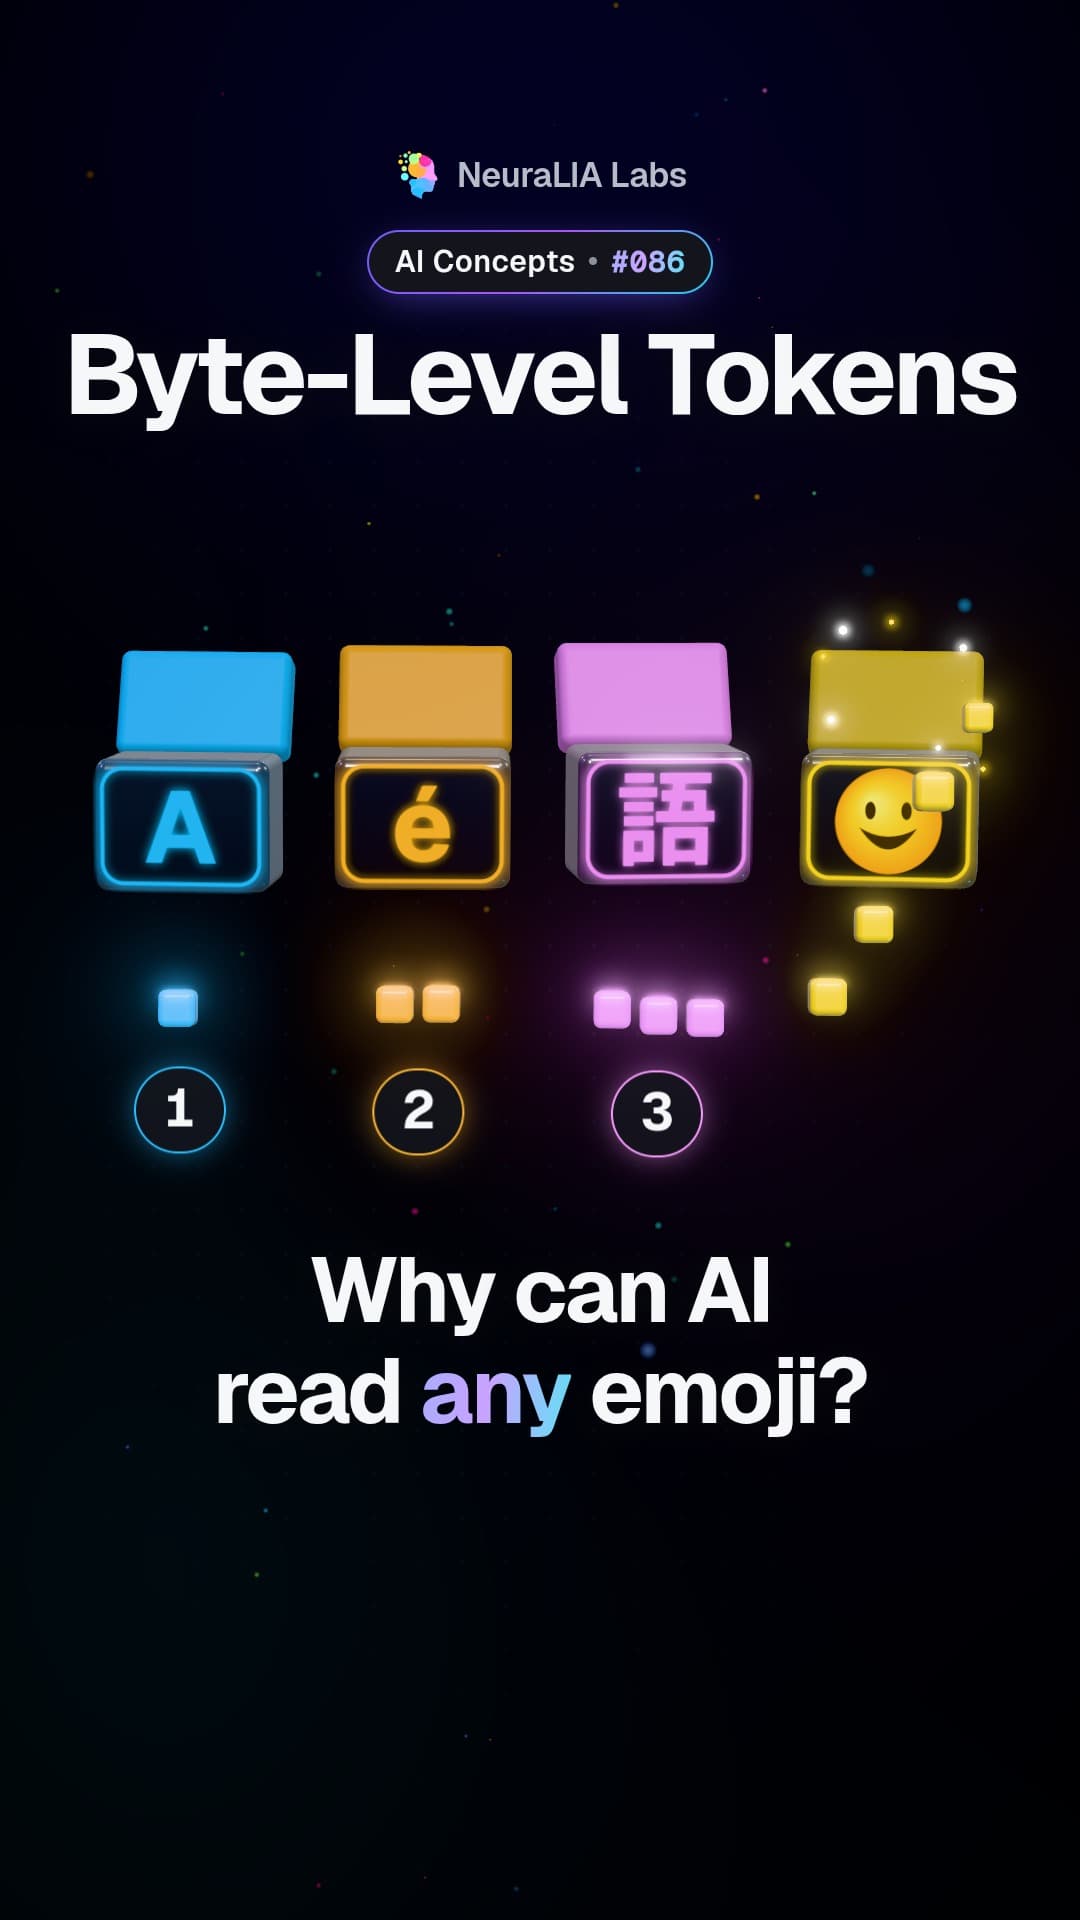 #086
Byte-level tokens: how AI can read any language, symbol or emoji
 #087
Byte-pair encoding: the 1994 compression trick that splits text for AI
 #088
Vocabulary size: how many text pieces an AI model should know
 #089
The token tax: why the same message costs more in some languages
 #090
Trailing space trap: why one invisible space can weaken an AI reply
 #091
Number tokenization: why AI reads digits in uneven chunks
 #092
Glitch tokens: the usernames that made AI models misbehave
 #093
WordPiece: why the most surprising pair beats the most common one
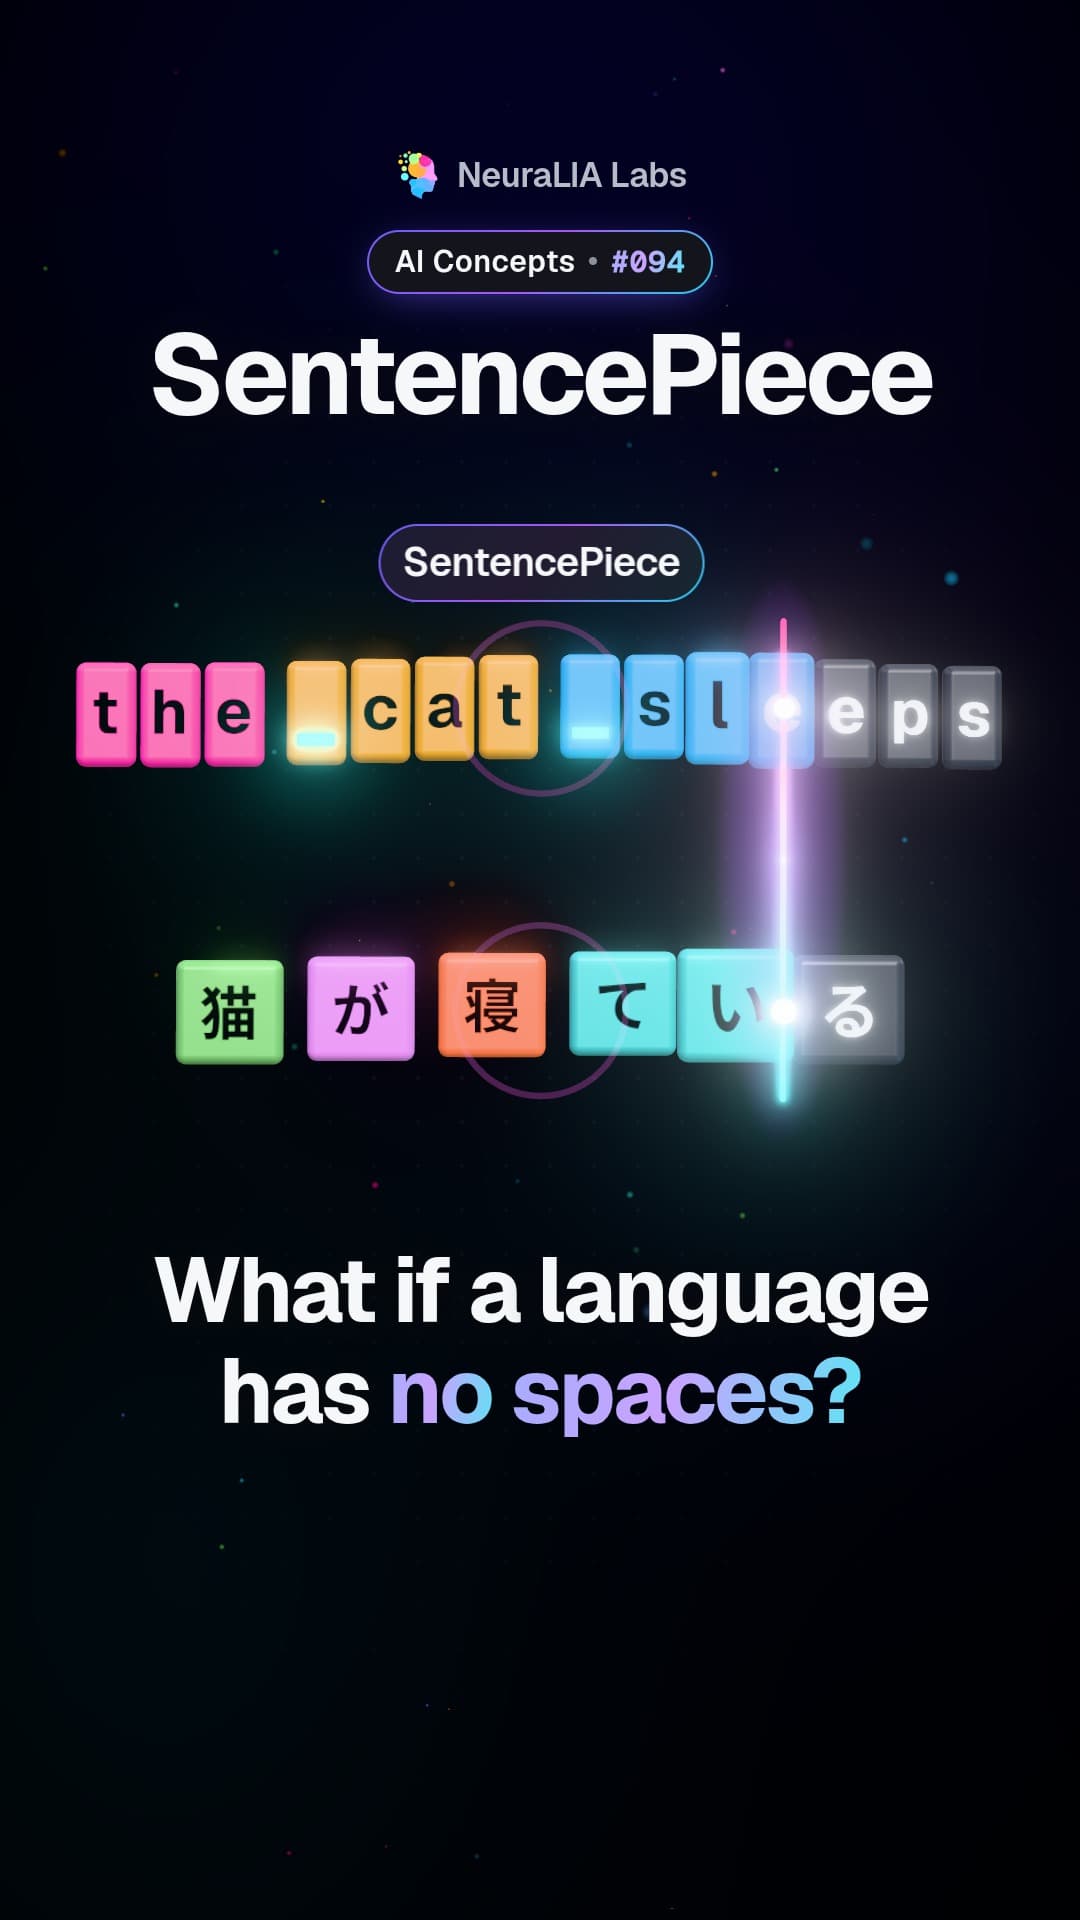 #094
SentencePiece: how AI splits text in languages without spaces