
 #01
Видео
AI в коротких видео
Одна идея в каждом видео, простым языком. Каждое ведёт к главе нашего бесплатного курса, где всё объяснено шаг за шагом.
Начните здесь AI 101
- #01
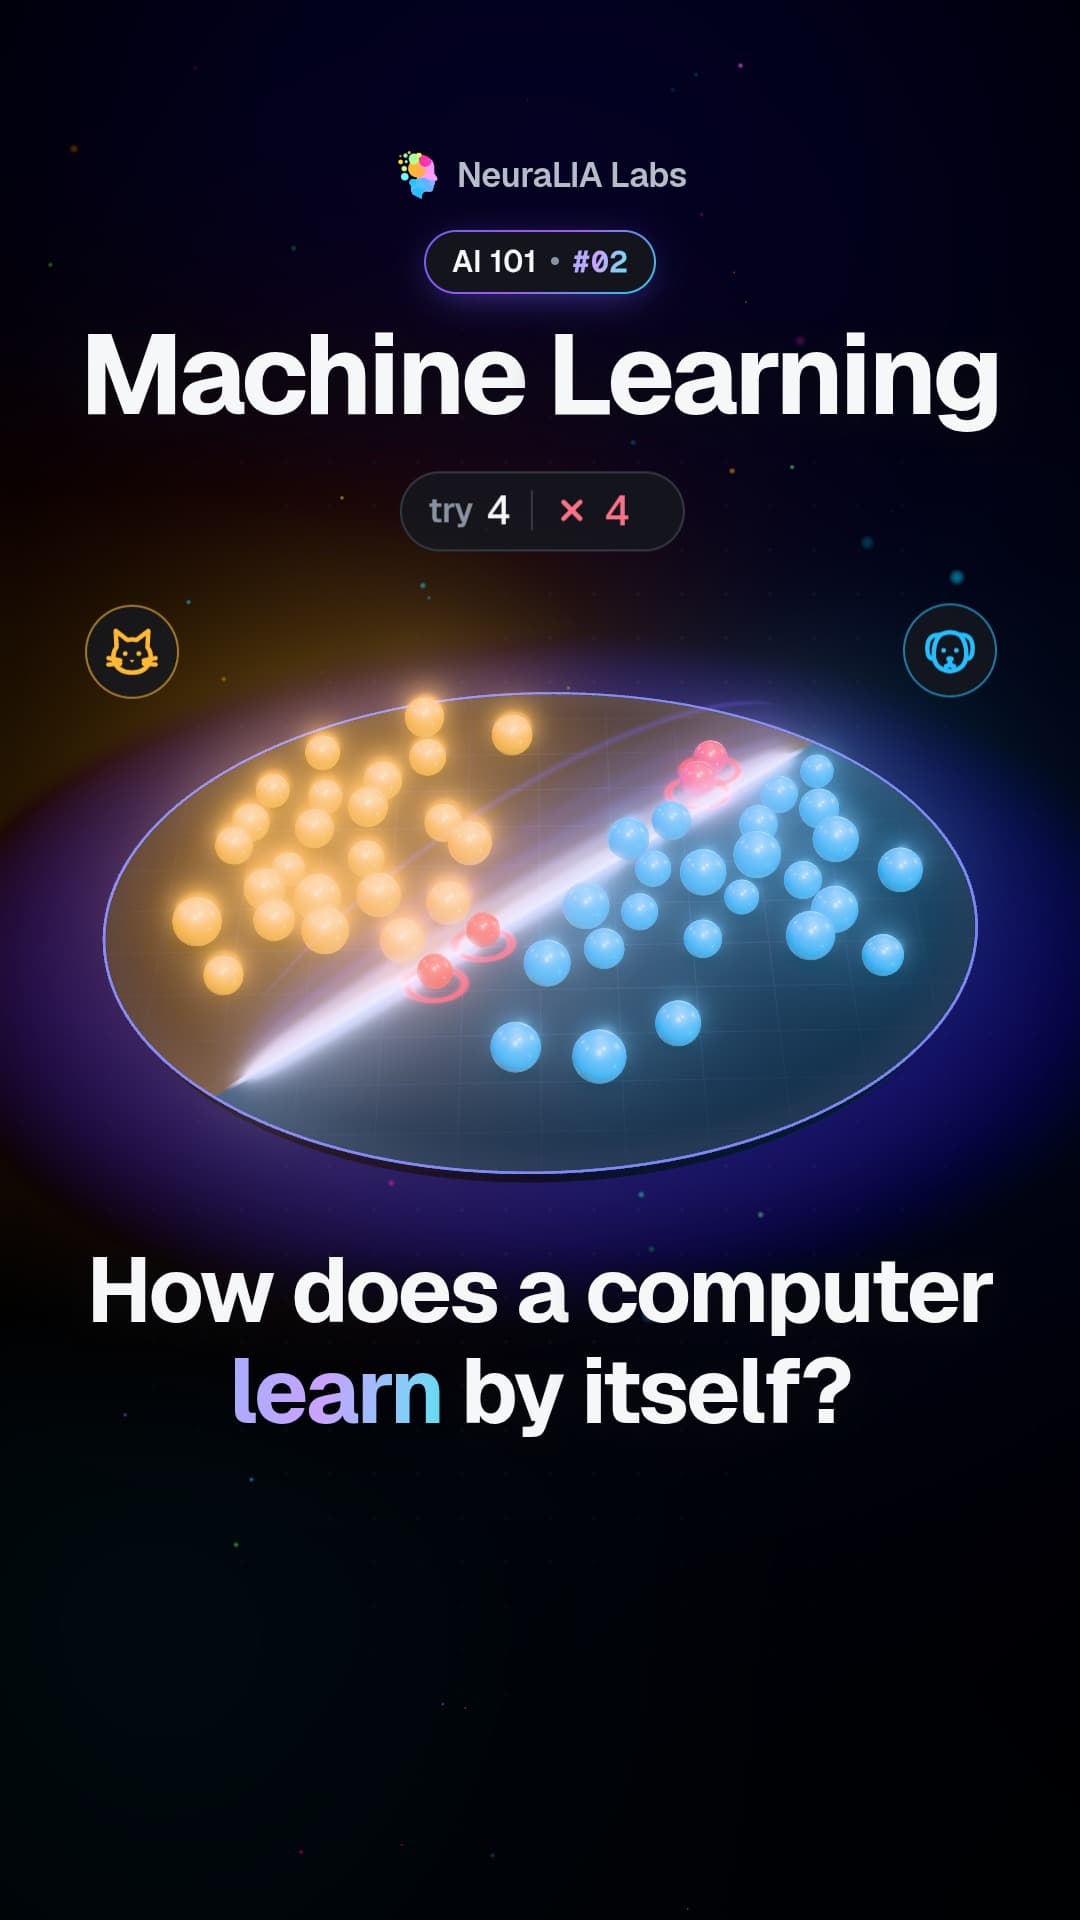 #02
Machine learning: how a computer draws its own dividing line
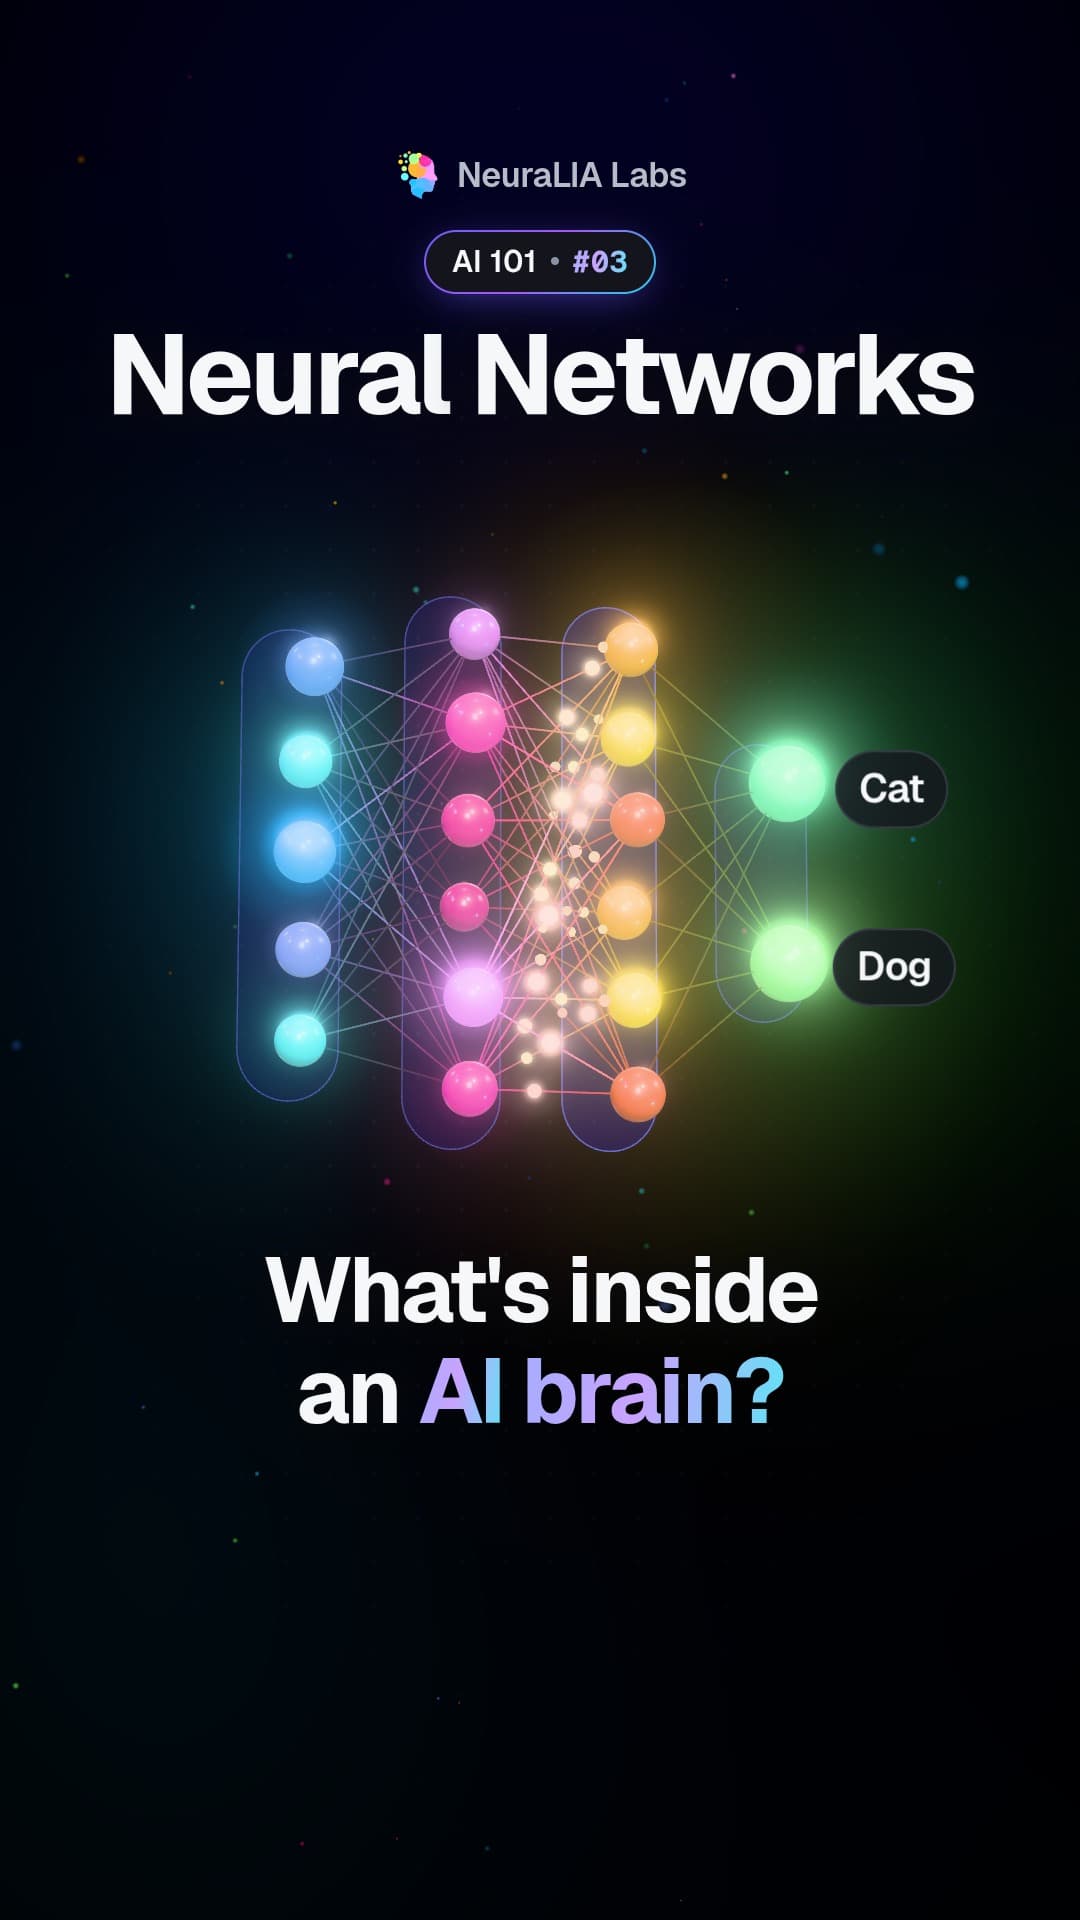 #03
Neural networks: layers of tiny calculators passing signals on
 #04
How AI learns: guess, measure the error, nudge, repeat
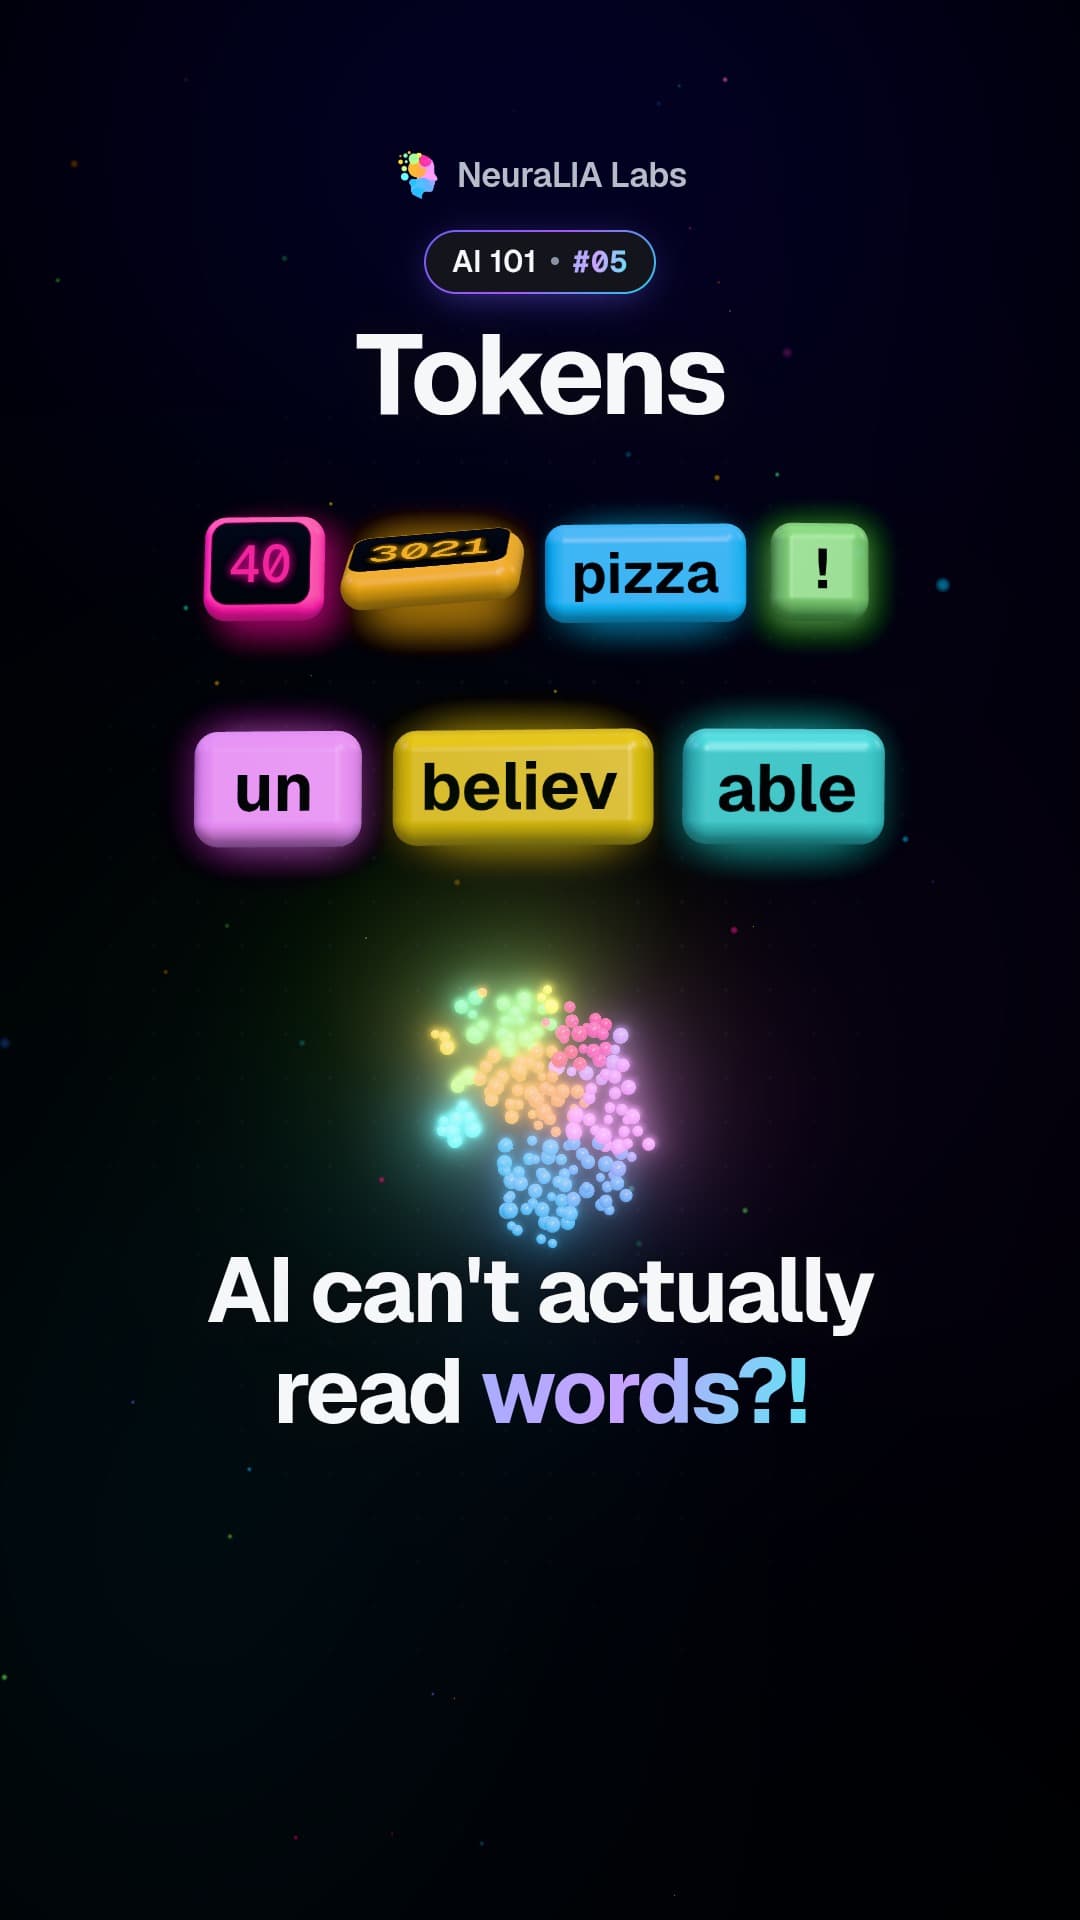 #05
Tokens: how AI chops your words into numbered pieces
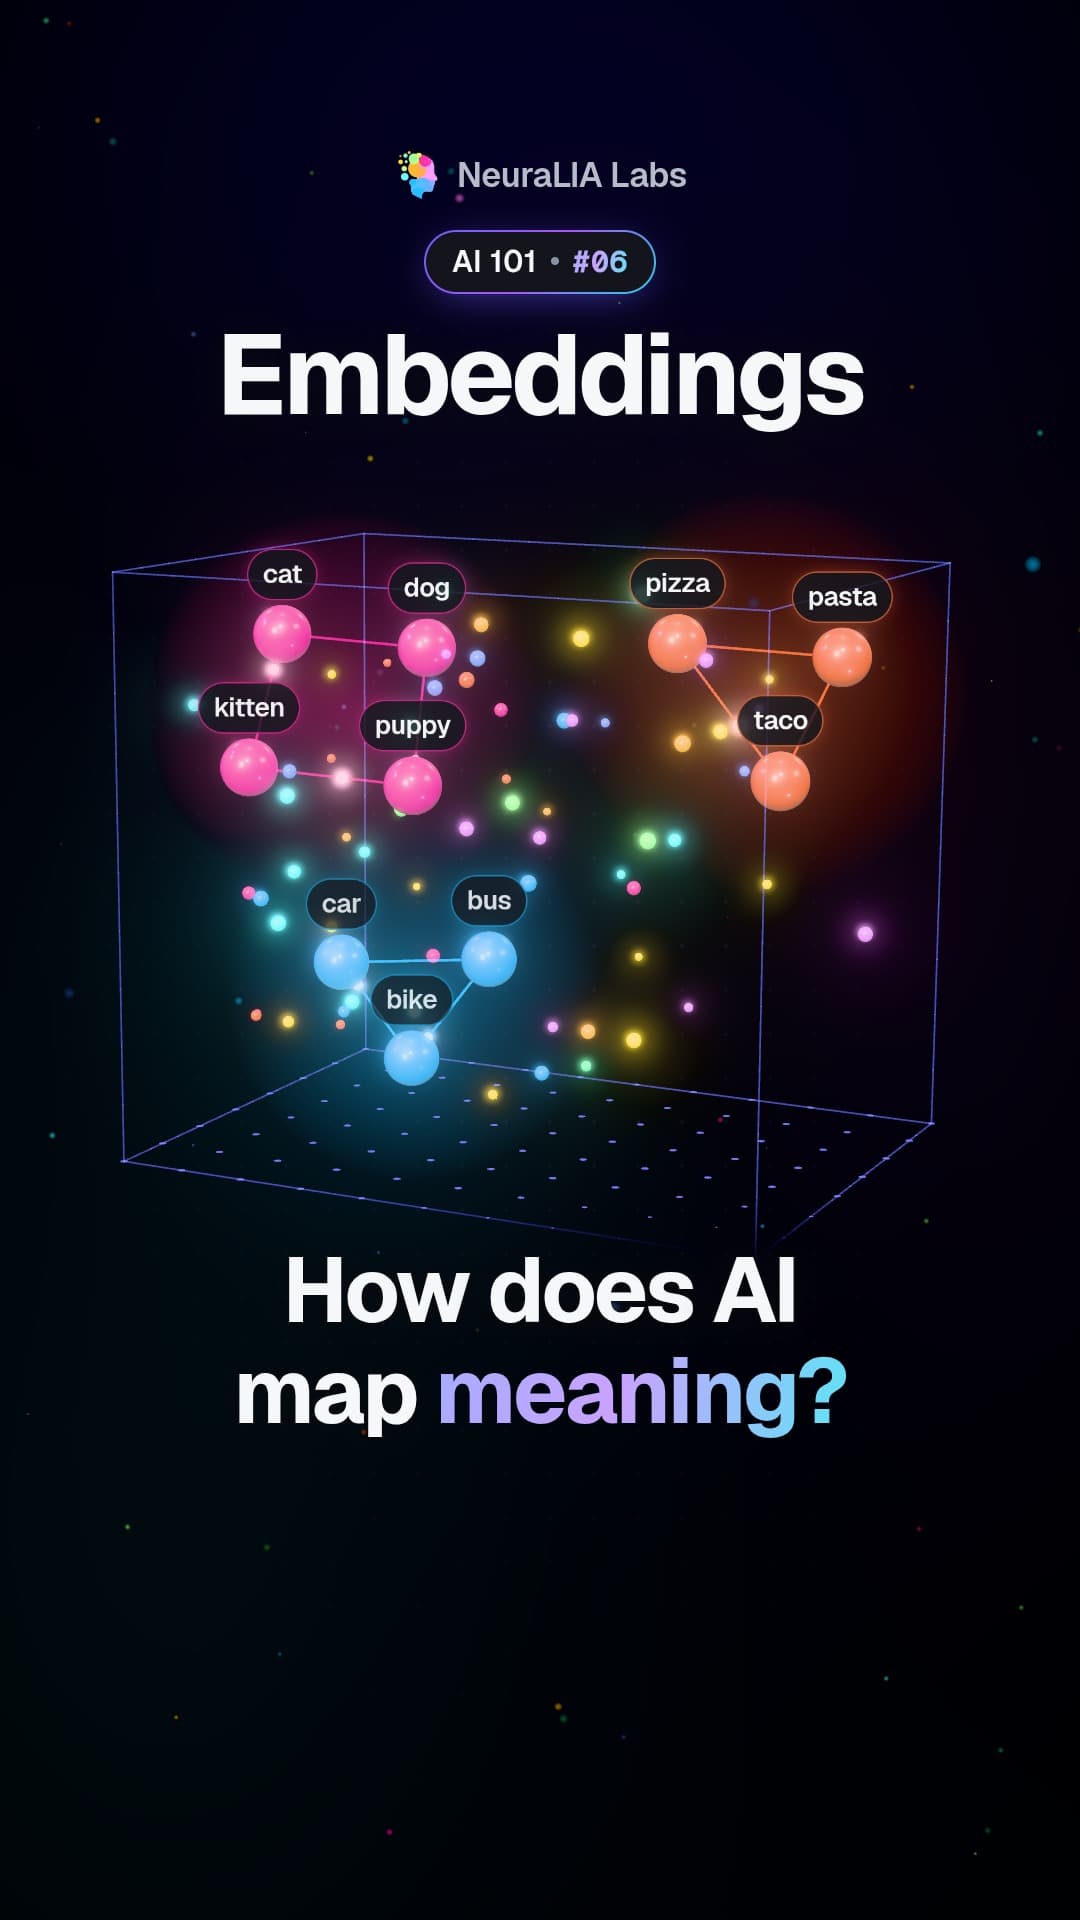 #06
Embeddings: why a puppy lands closer to a dog than to a pizza
Последние
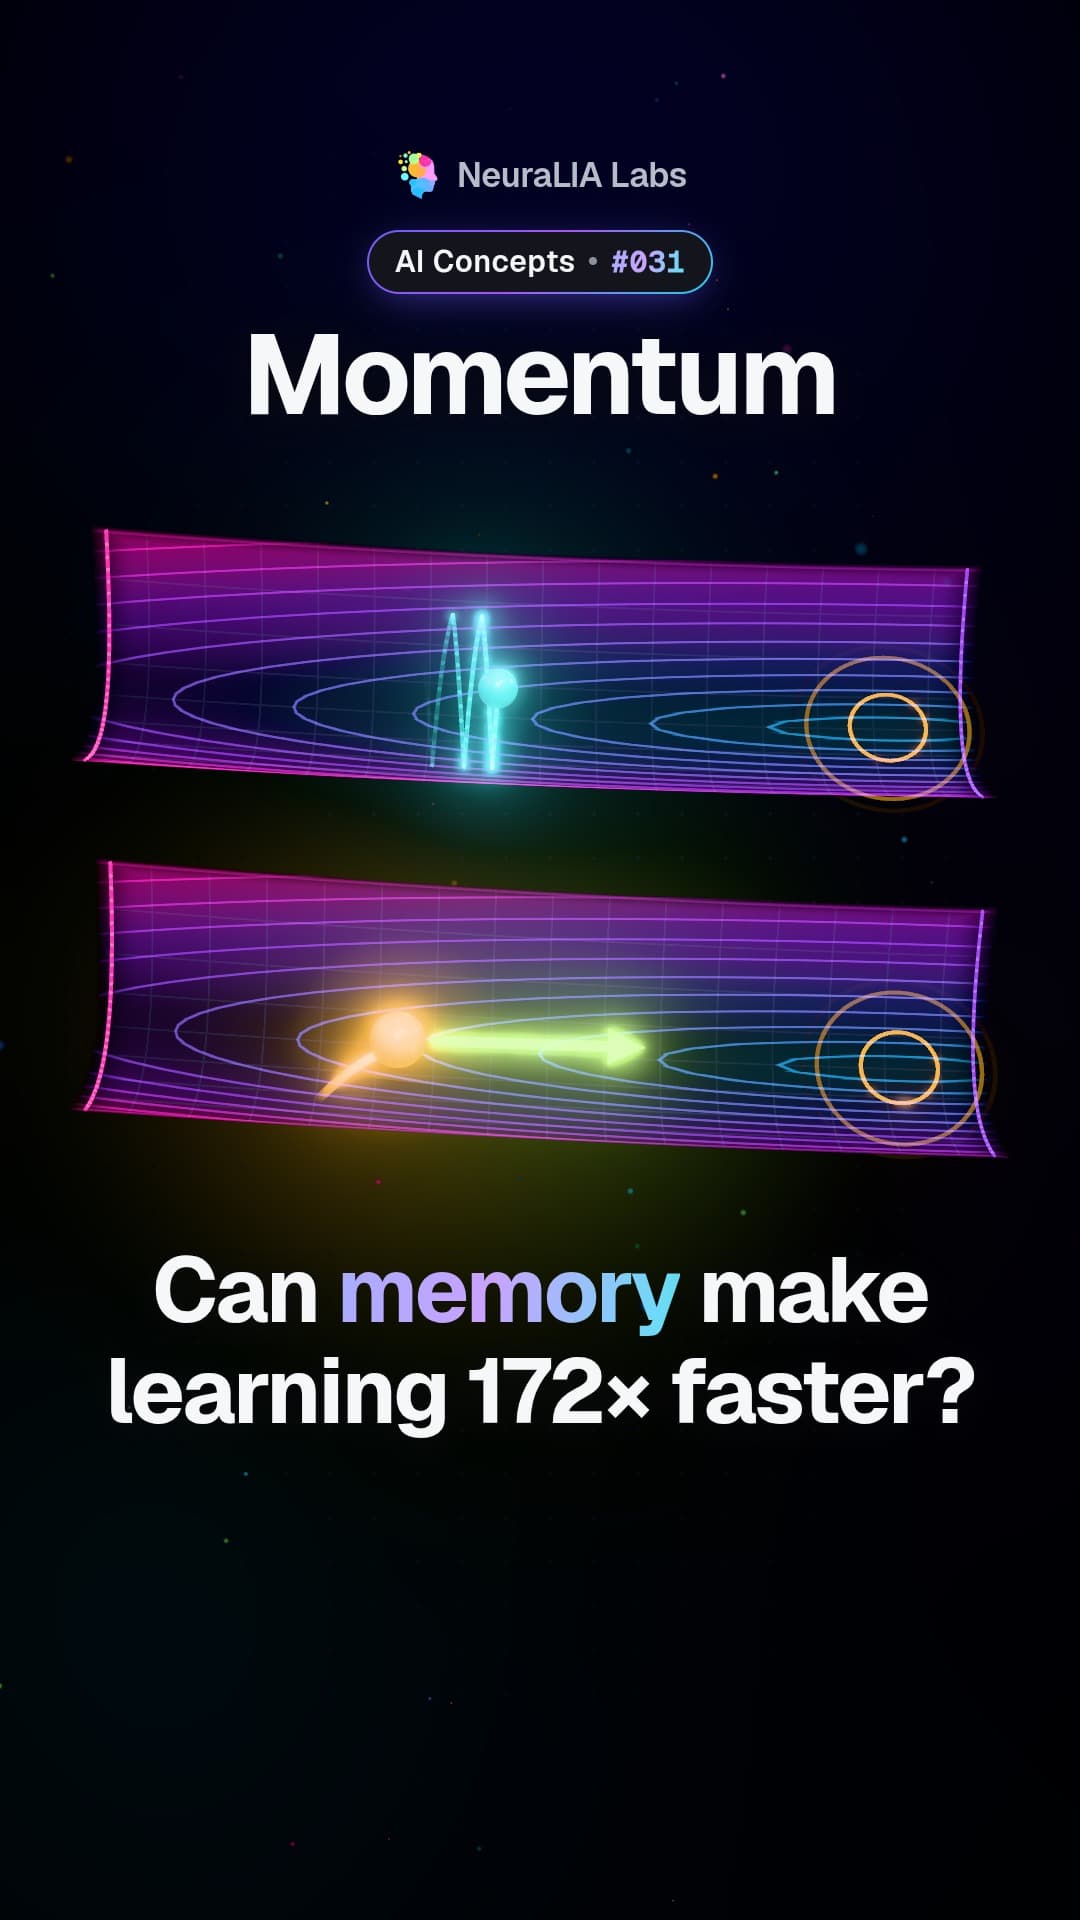 #031
Momentum: how remembering past steps stops AI training zigzagging
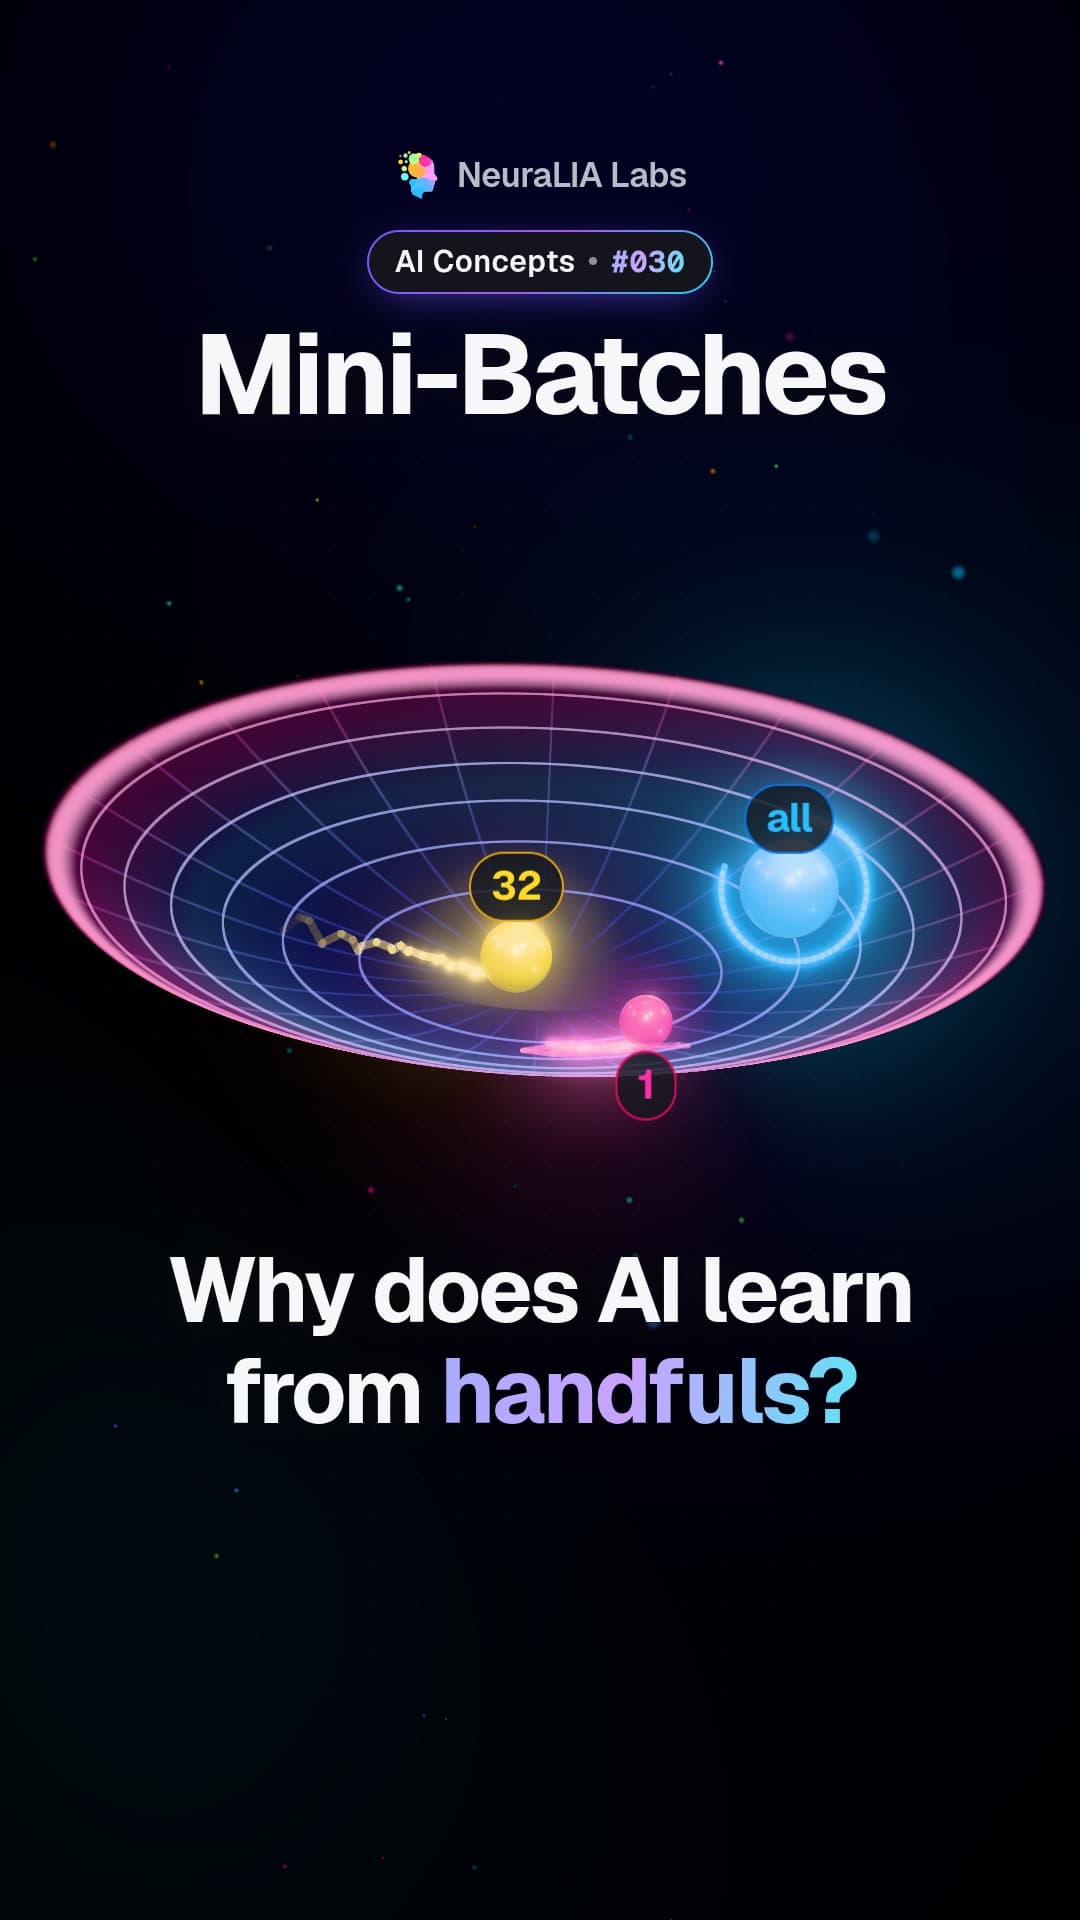 #030
Mini-batches: why AI learns faster from a random handful of data
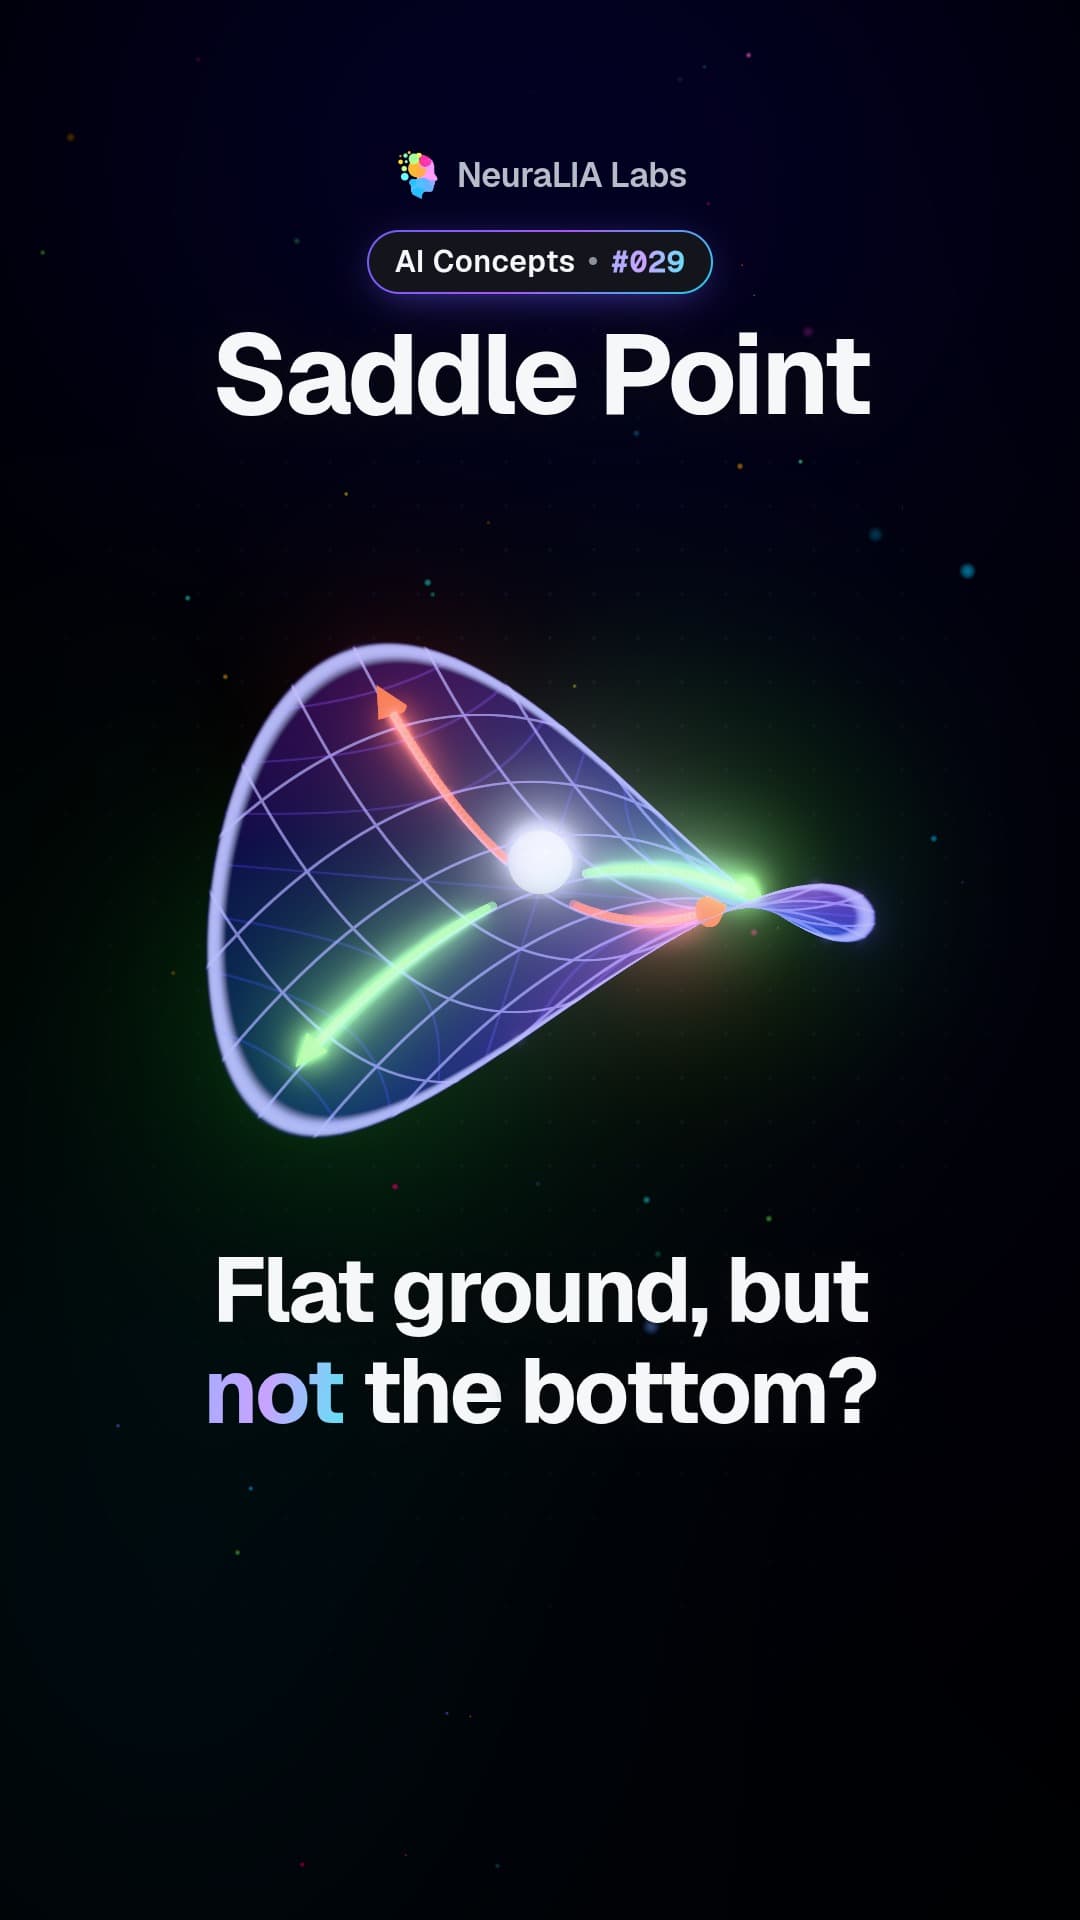 #029
Saddle points: where AI training looks stuck but has a way down
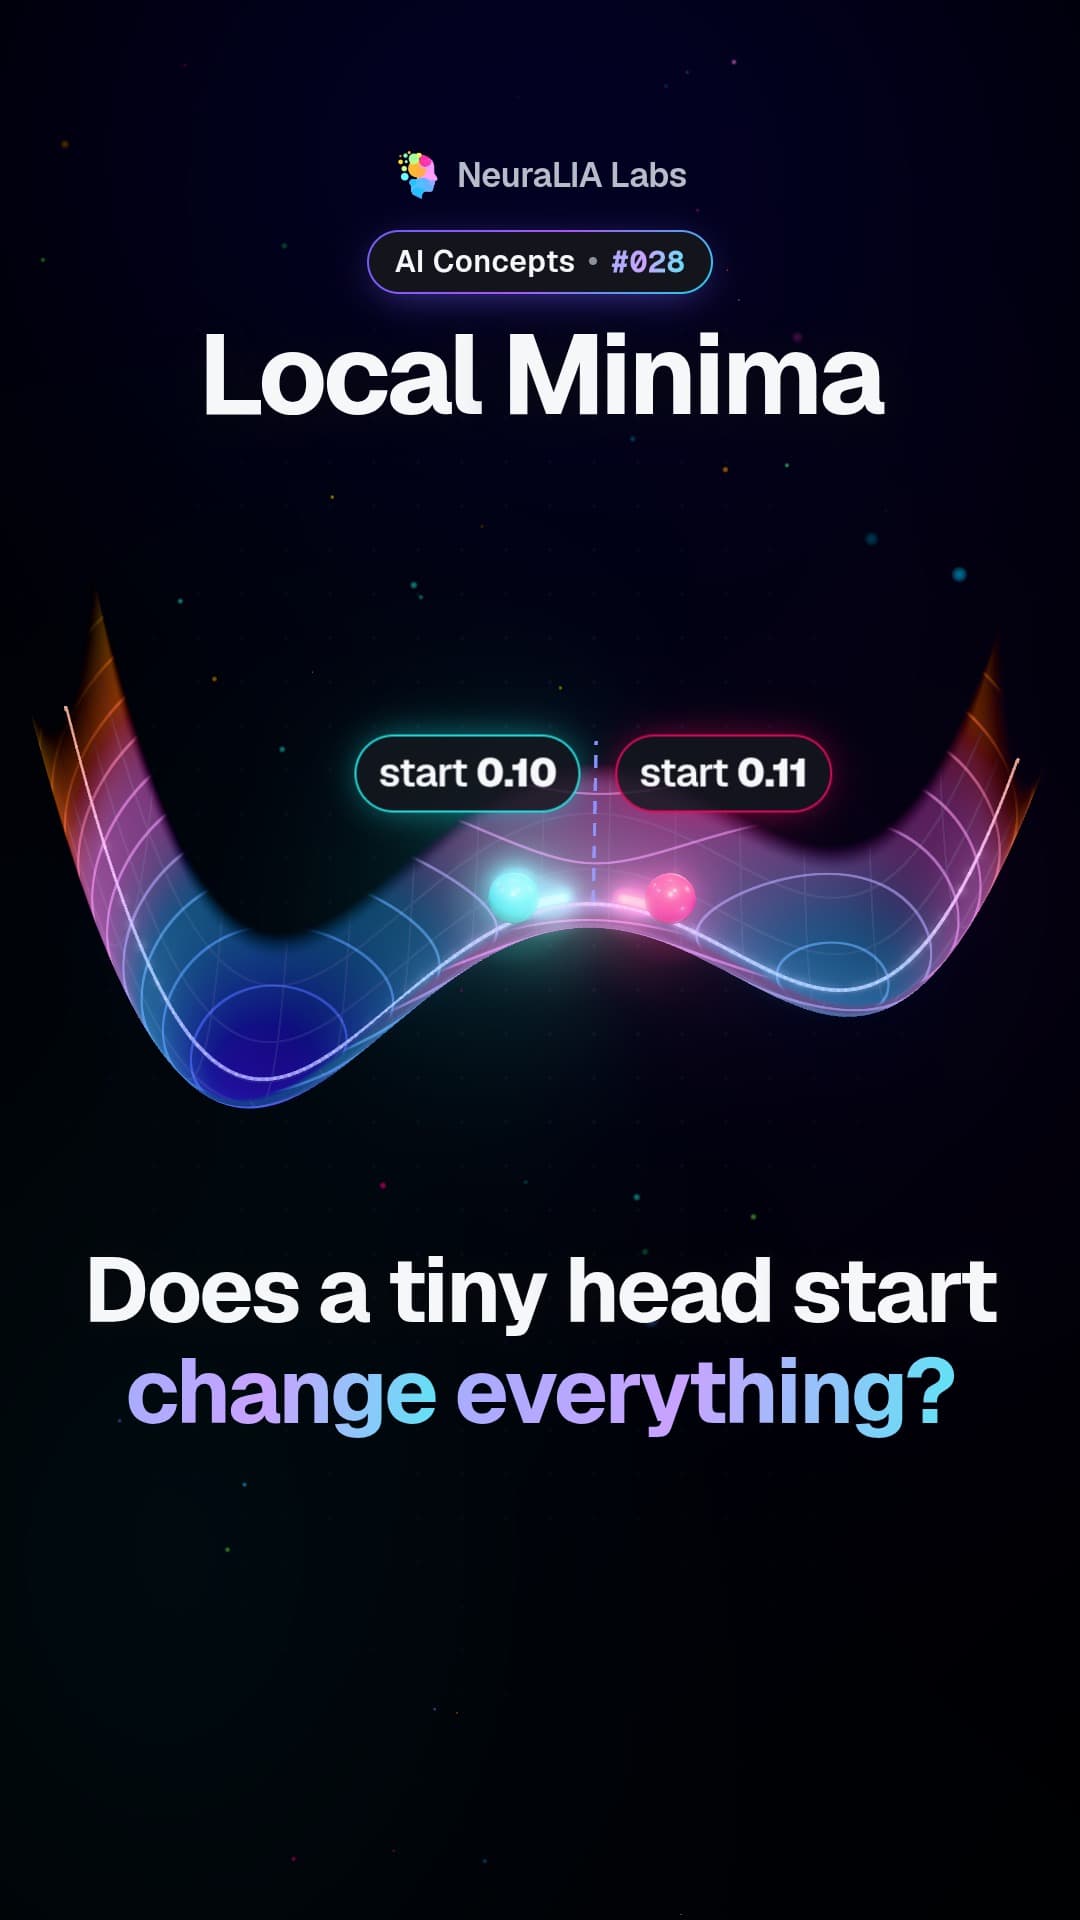 #028
Local minima: why AI training can settle for second best
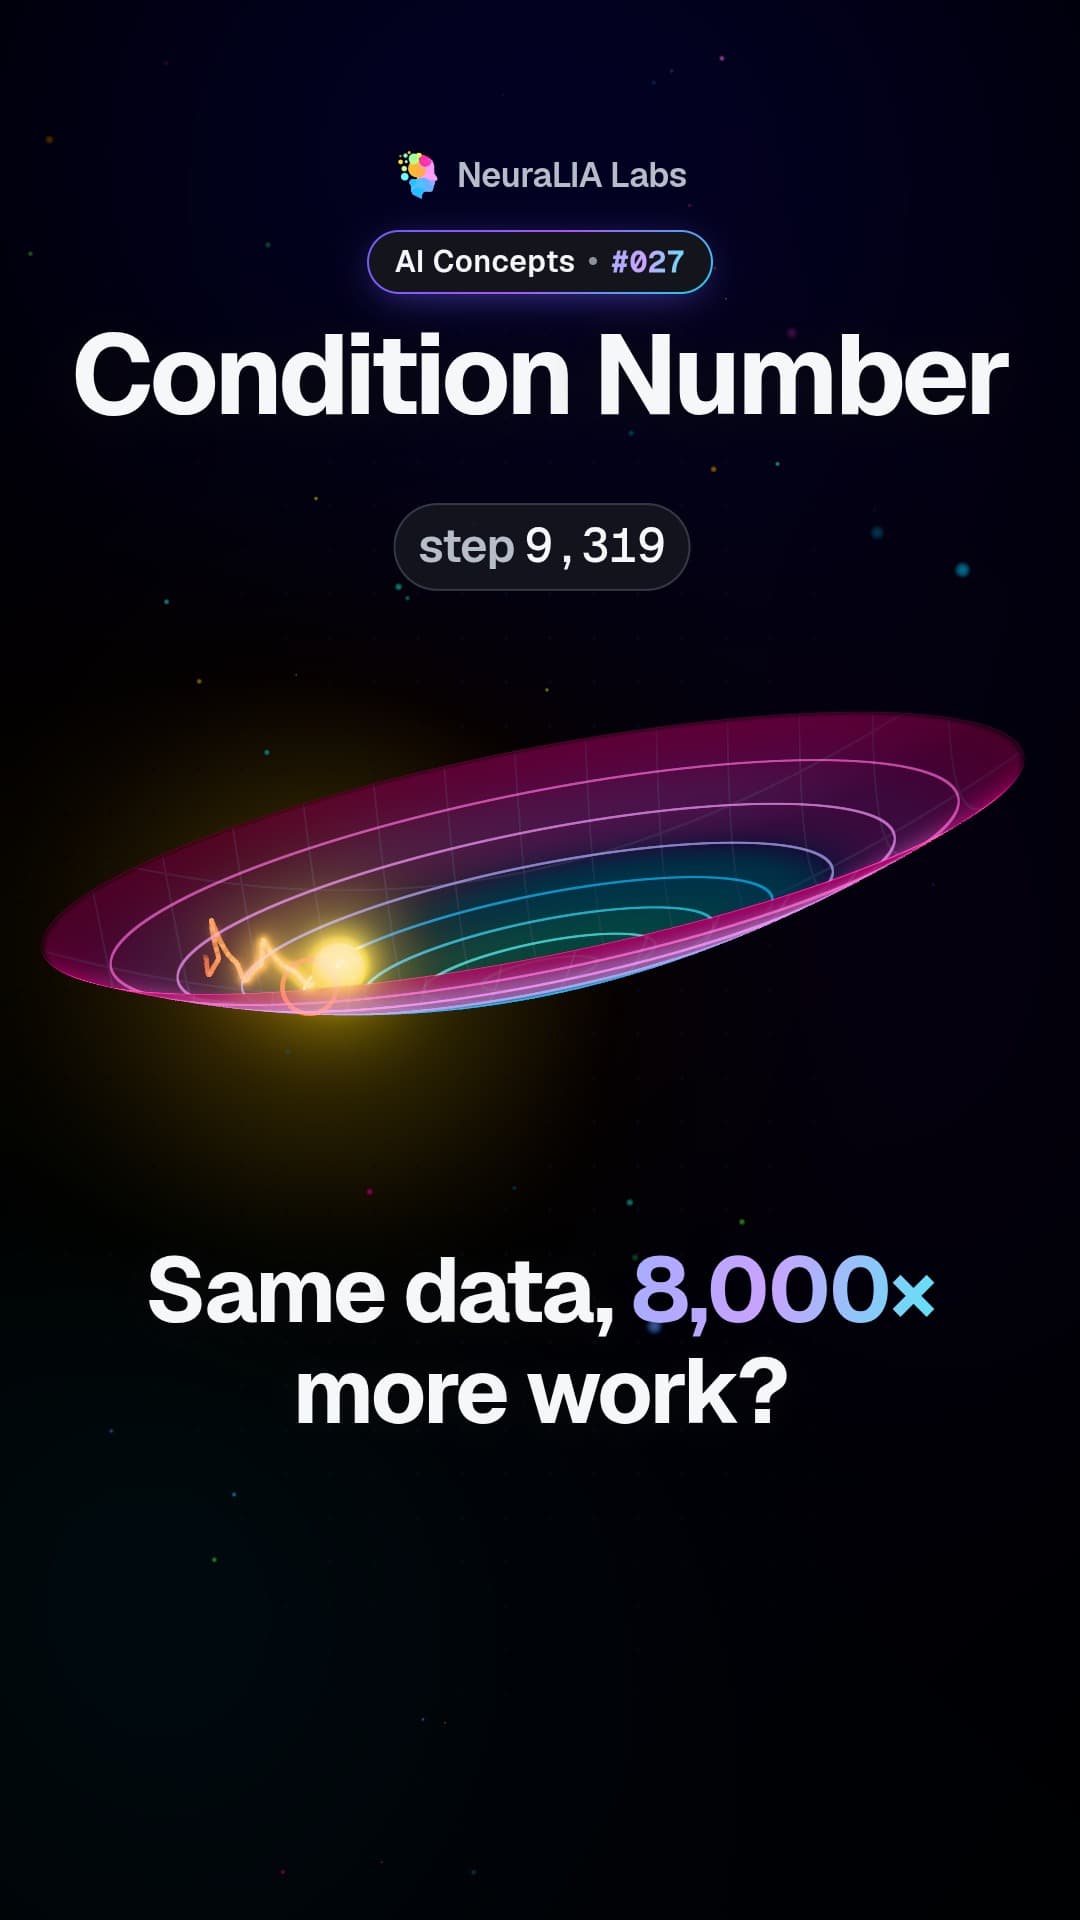 #027
Condition number: why a stretched valley makes AI training crawl
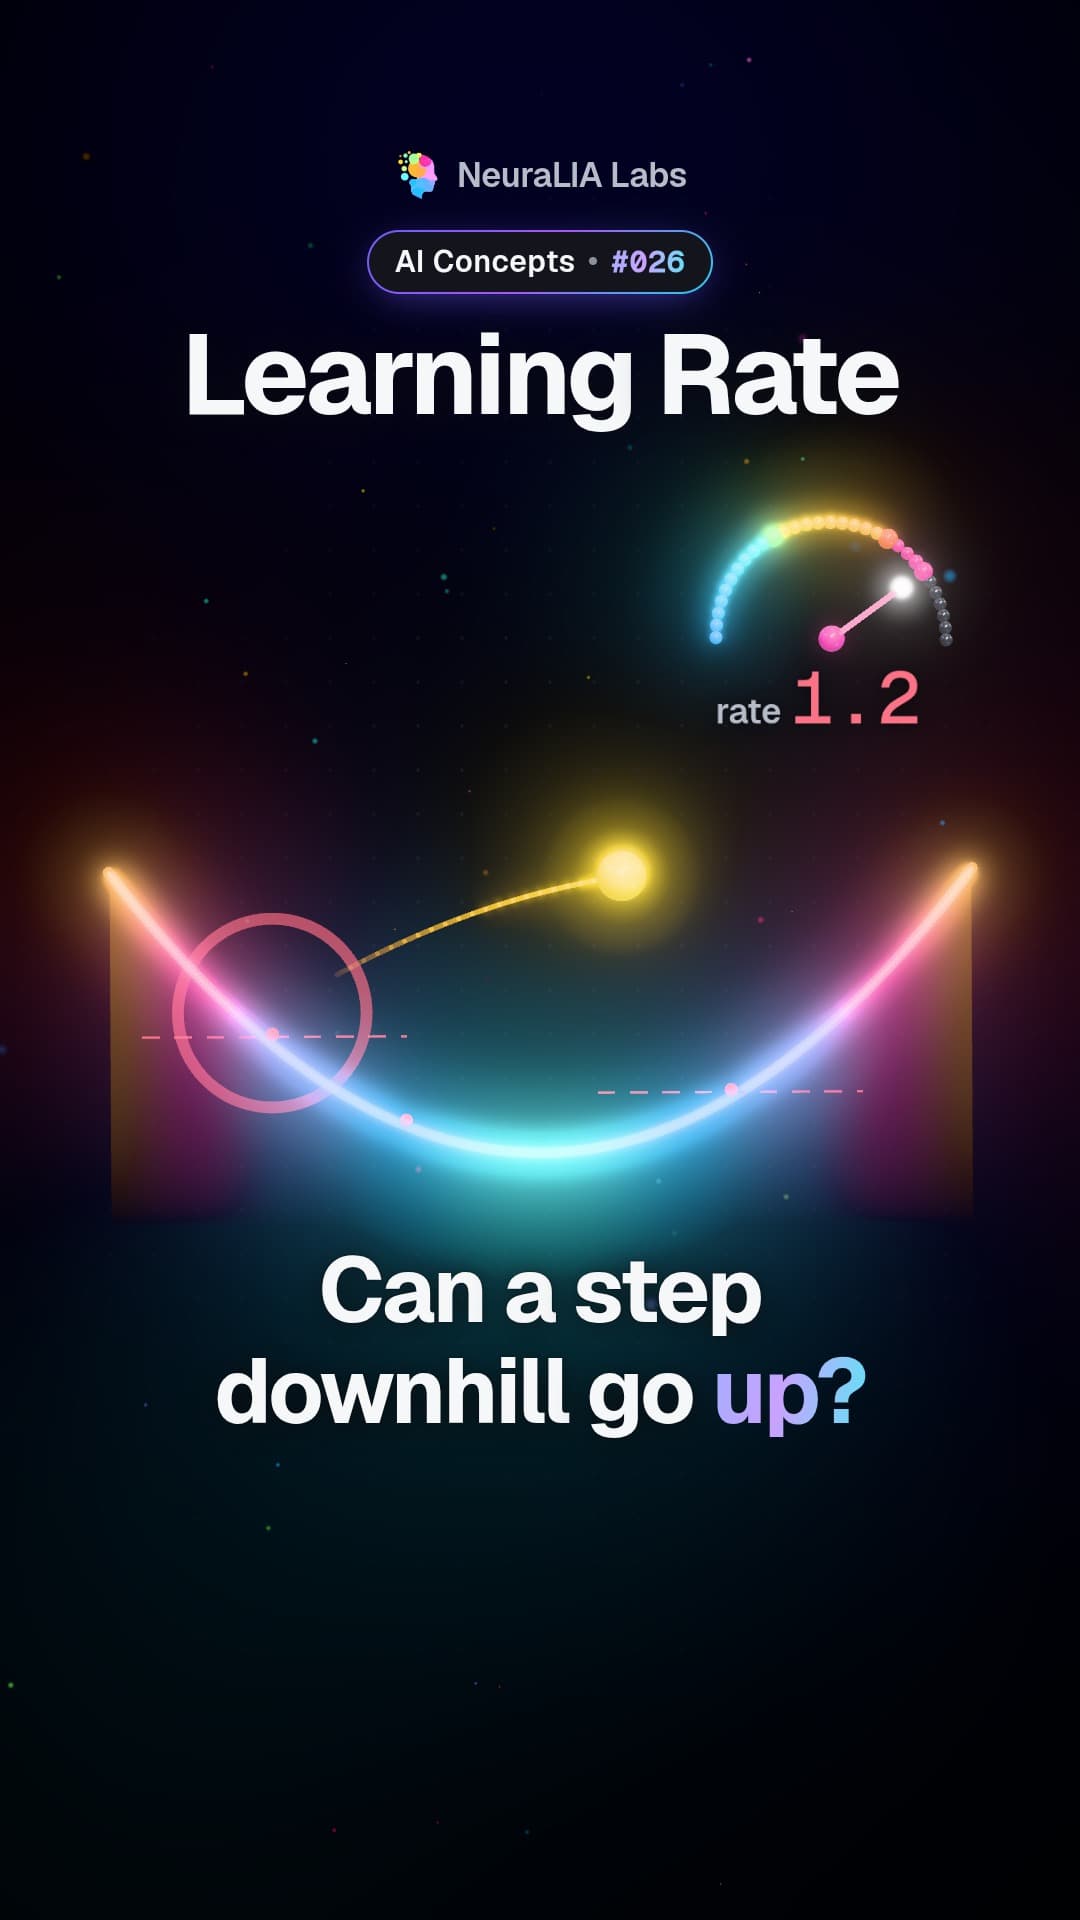 #026
Learning rate: the step size with a ceiling you can calculate
 #025
Gradient descent: how AI finds its way downhill in small steps
 #024
Gradient: the arrow that points uphill, and why AI walks the other way
 #023
Chain rule: how AI traces the effect of every layer
 #022
Derivative: how much the result moves when you nudge one input
 #021
Grid search: why you cannot train an AI by trying every setting
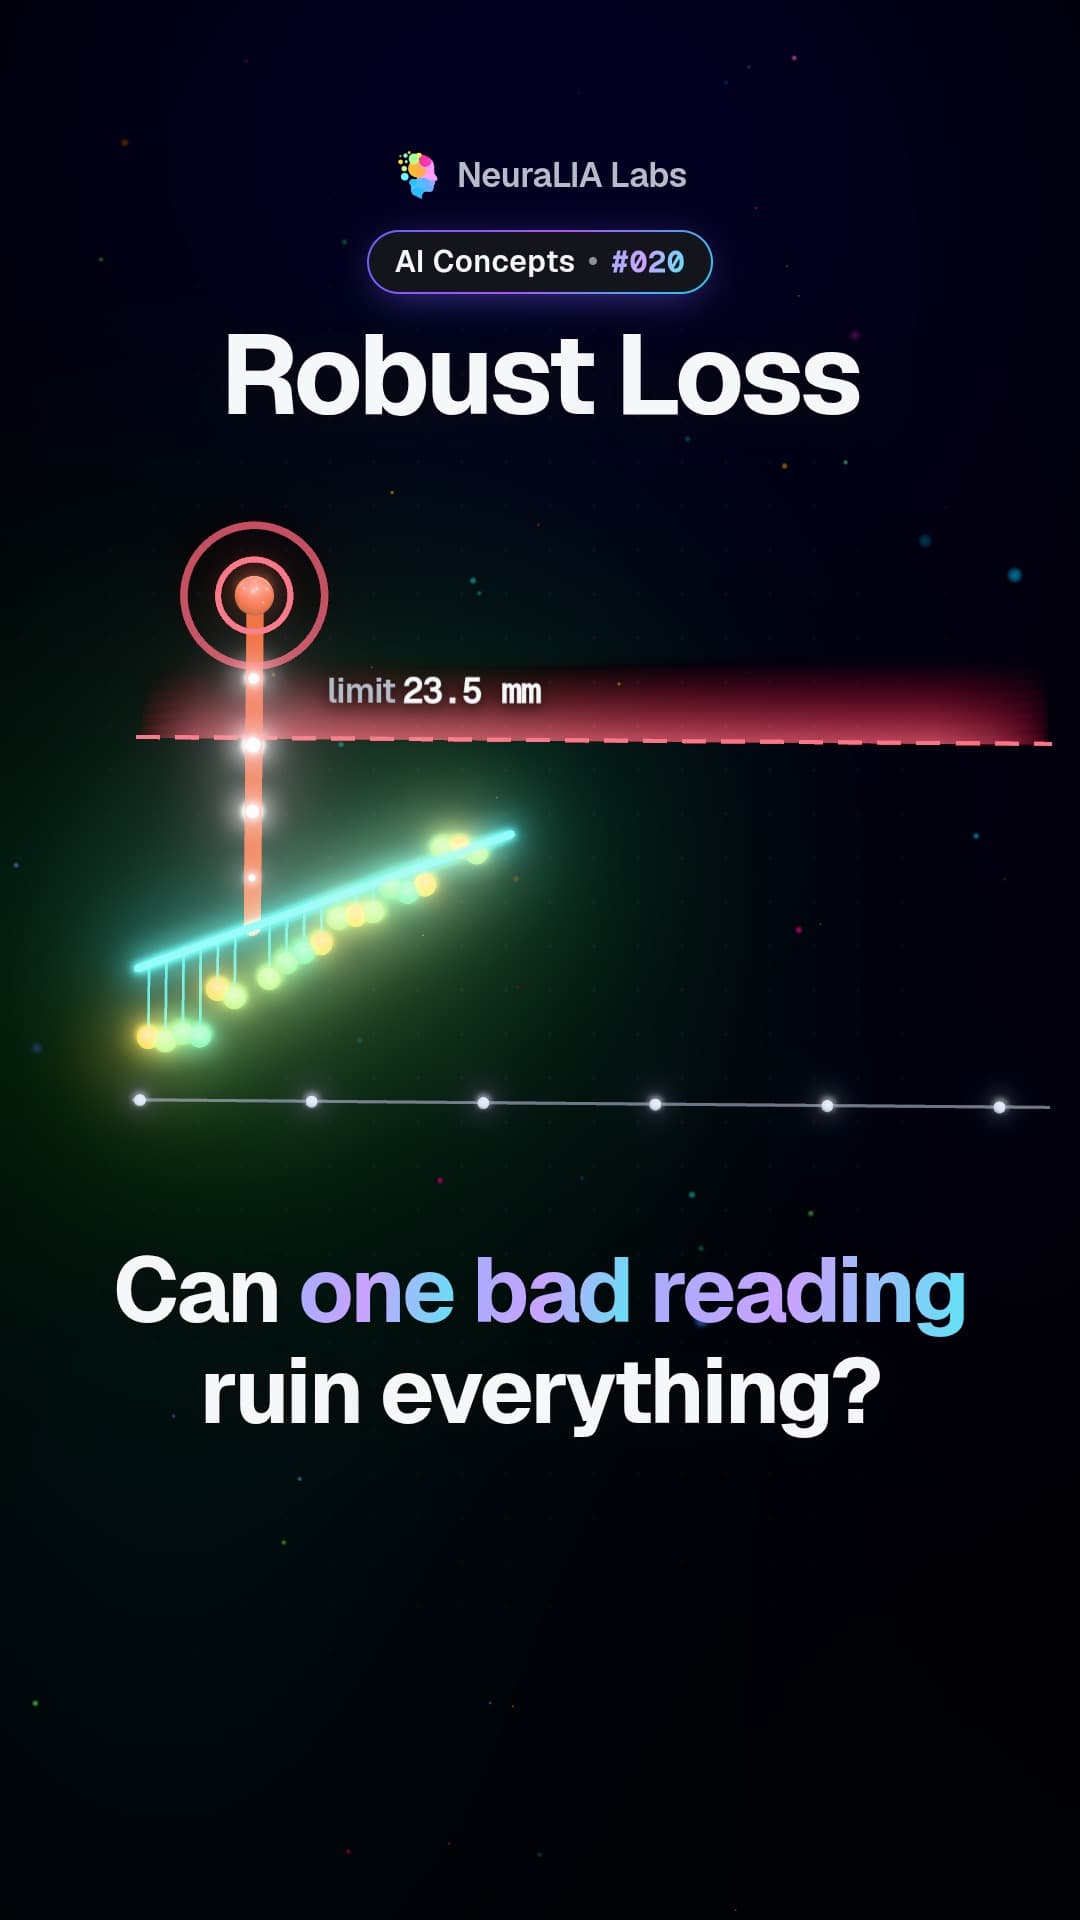 #020
Robust loss: stop one wild reading from wrecking your forecast
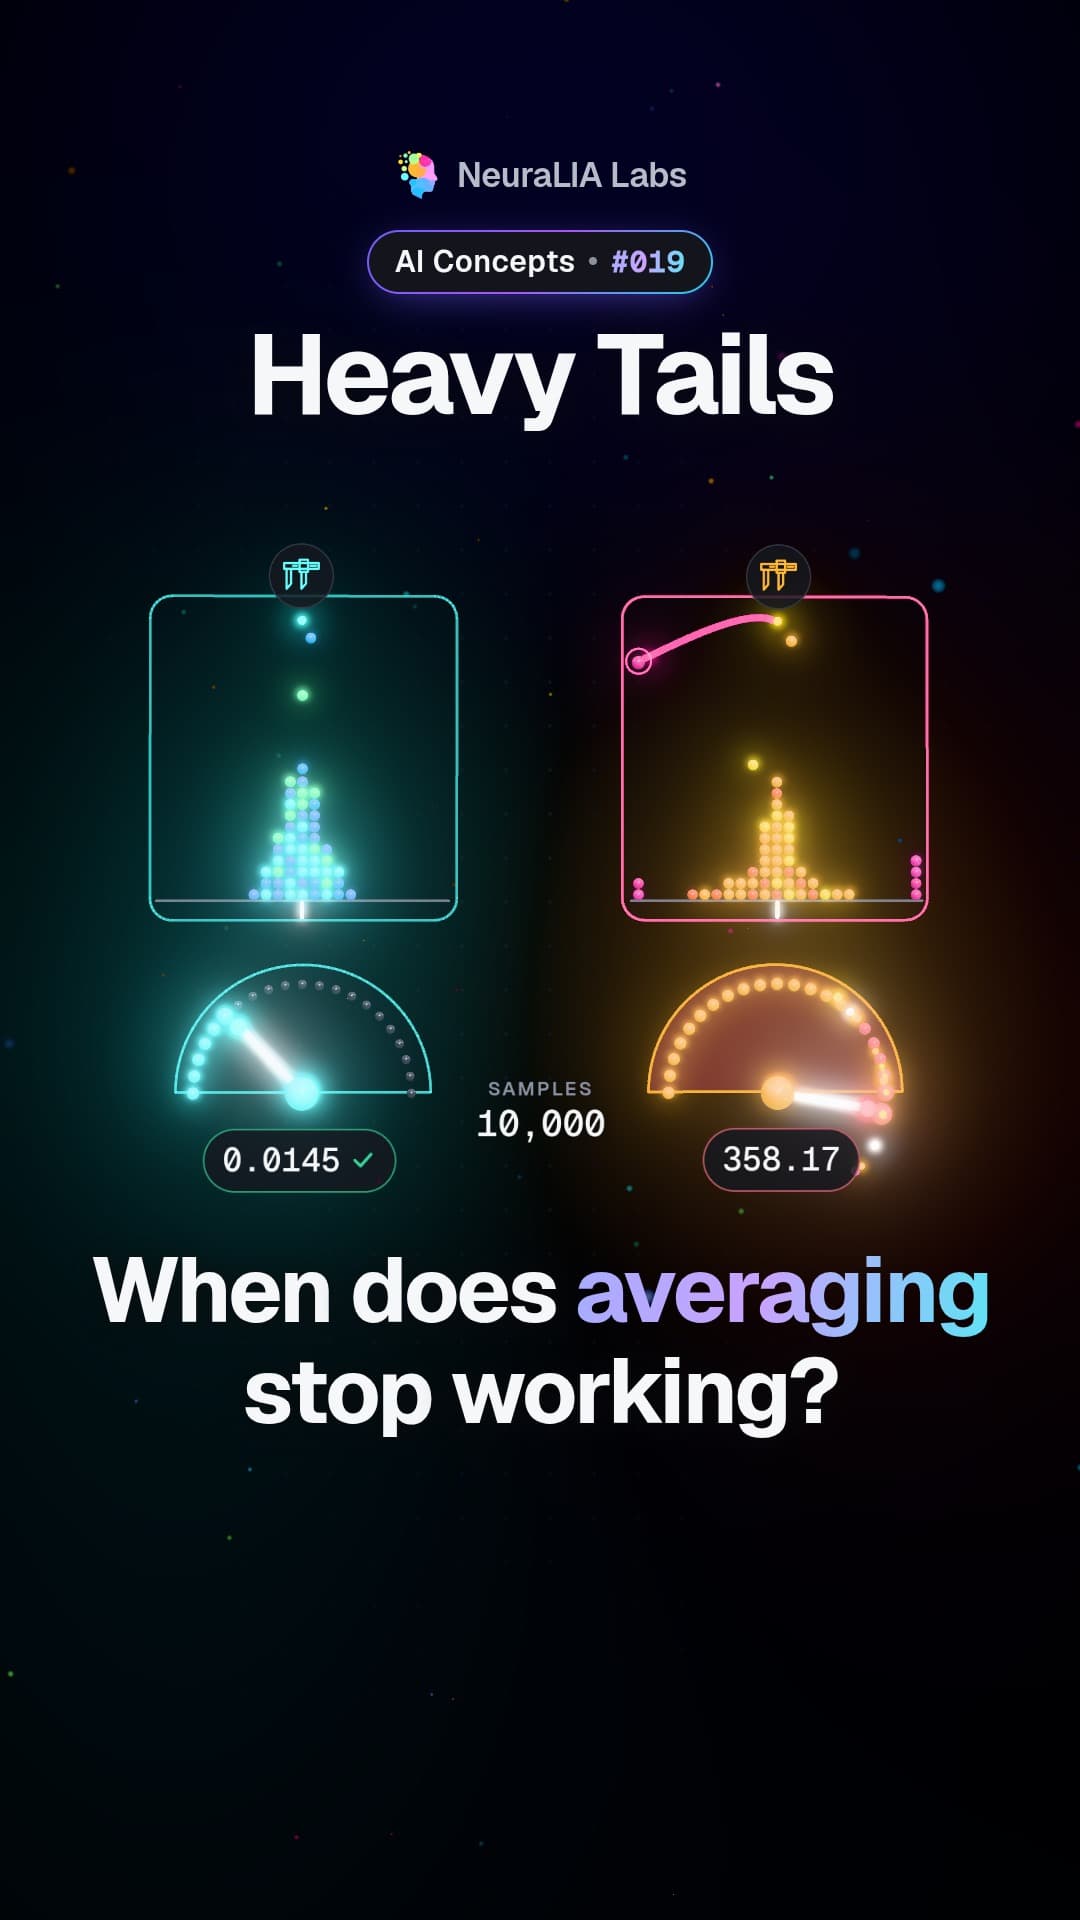 #019
Heavy tails: when rare, huge errors break the usual average
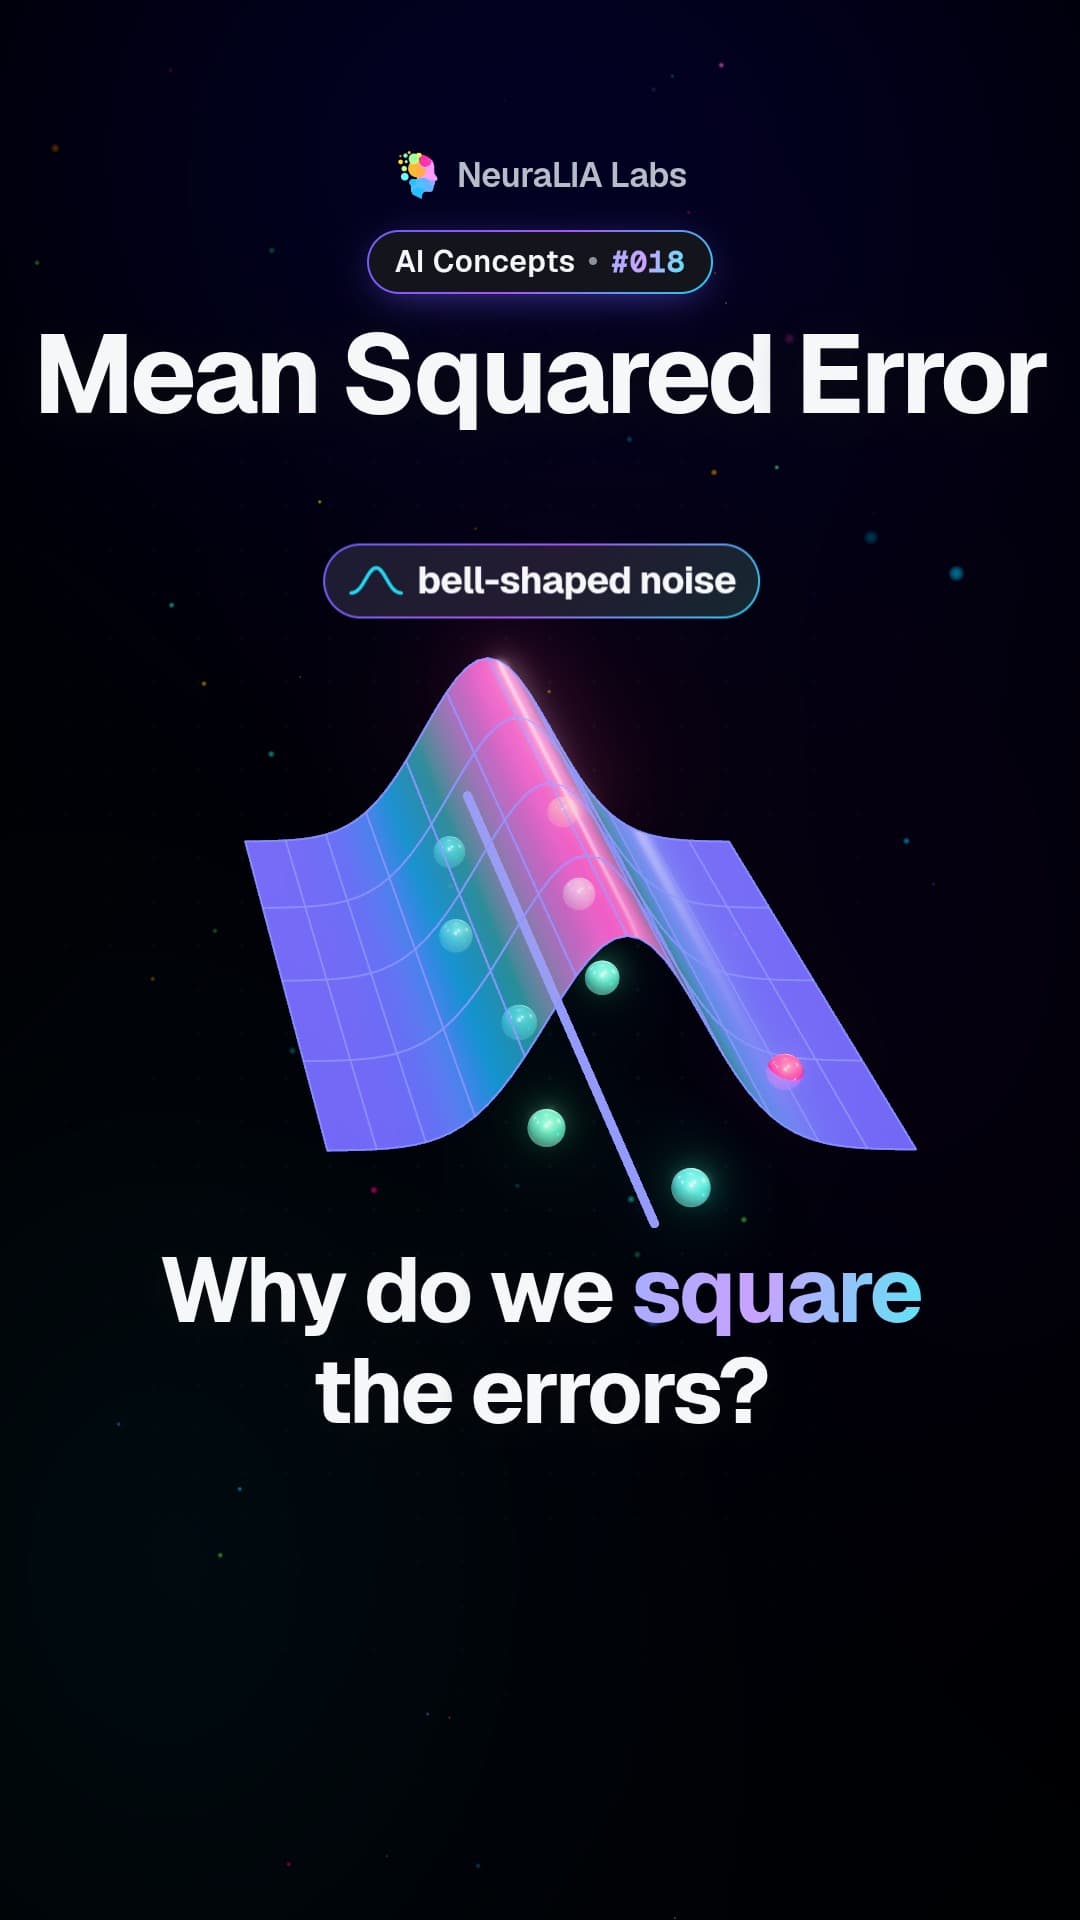 #018
Mean squared error: the hidden bet behind squaring your mistakes
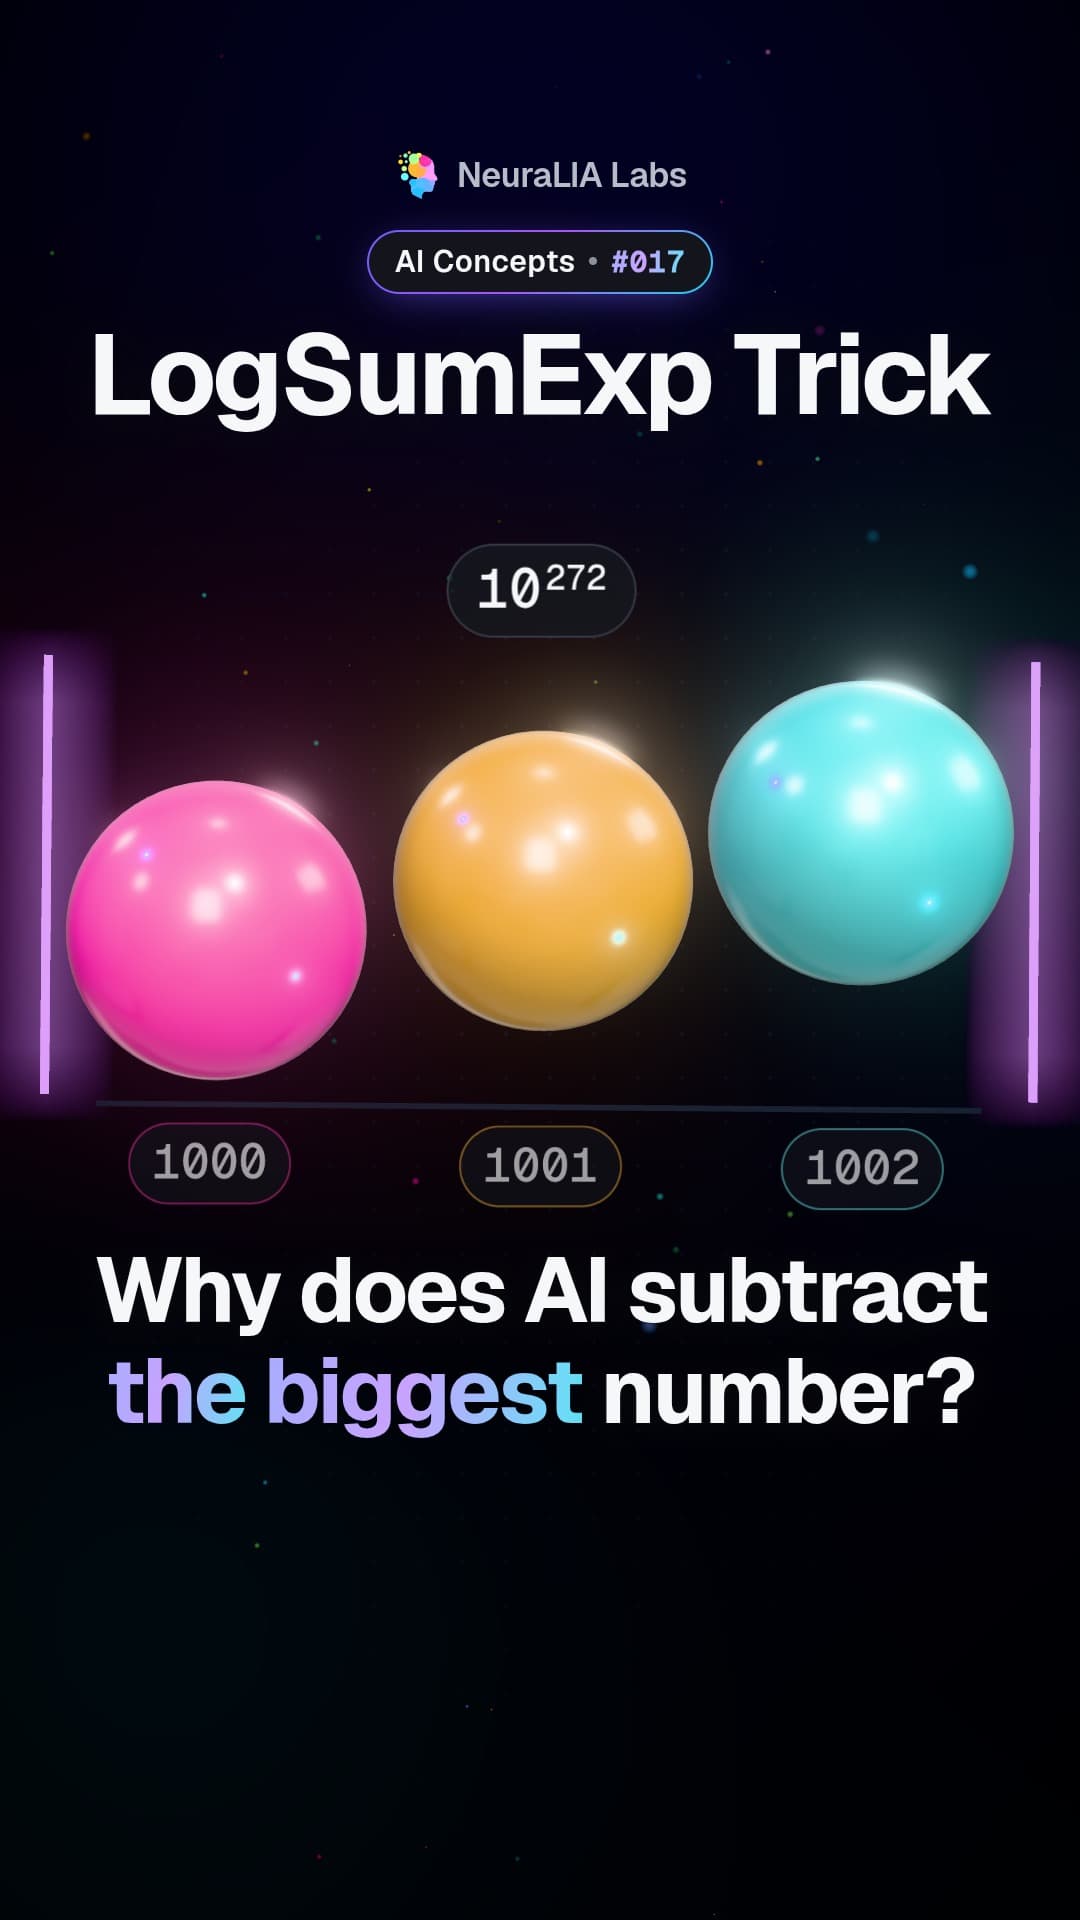 #017
The LogSumExp trick: one subtraction that stops AI math overflowing
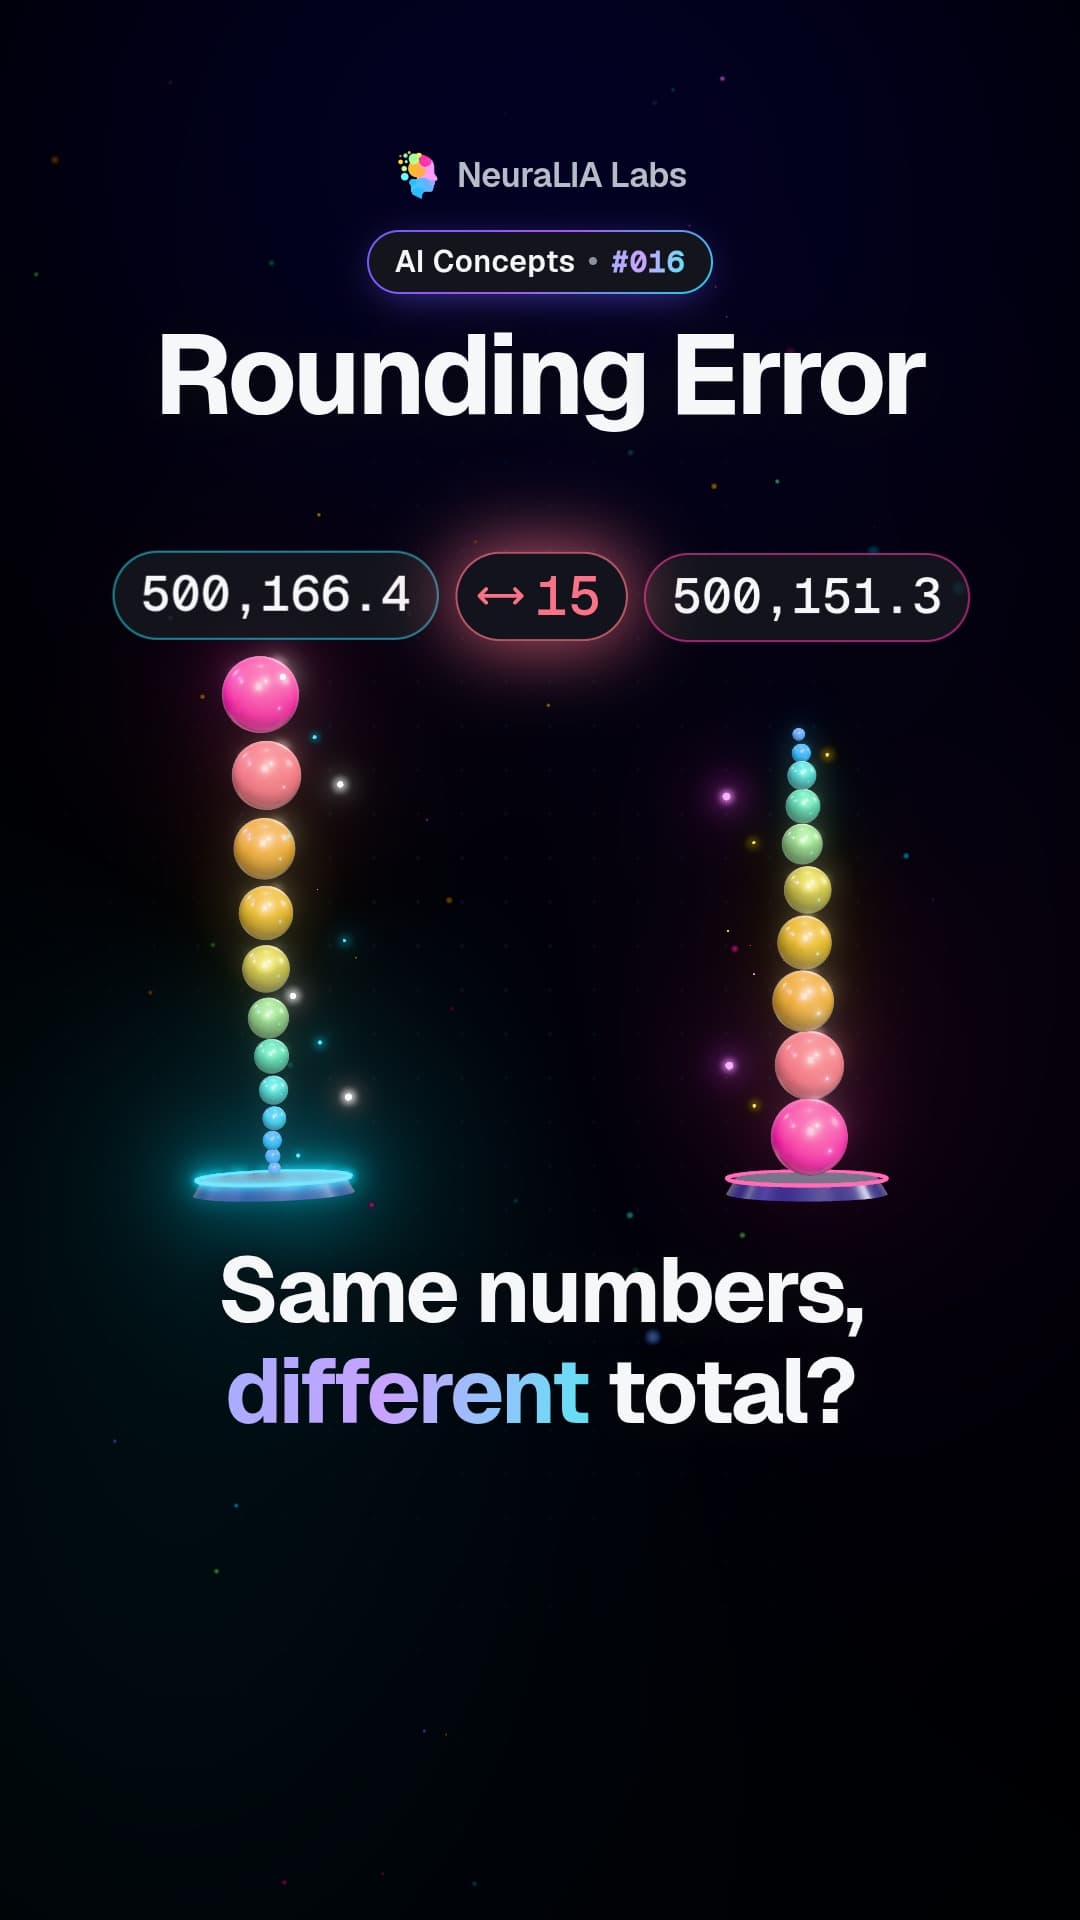 #016
Rounding error: why adding the same numbers can give two answers
 #015
Floating-point numbers: why your computer cannot hold every number
 #014
Negative log-likelihood: turning a fragile product into a calm sum
 #013
Maximum likelihood: the answer that makes your data least surprising
 #012
Bayes' rule: reasoning backwards from a clue to its most likely cause
 #011
Chain rule of probability: how AI scores a sentence word by word
 #010
Loss landscape: training an AI means finding the bottom of a valley
 #009
Loss function: the scoring rule that decides which answer wins
 #008
Feature engineering: the human choice that can beat the algorithm
По главам курса
- 1Перцептрон с нуля: что вычисляет нейрон10 видео
- 2Откуда берётся loss function: likelihood, а не соглашение12 видео
- 3Вниз по склону: Gradient Descent и два шага, которые все пропускают12 видео
- 4Классификация, перекрёстная энтропия и как не обмануть себя
- 5Backpropagation с нуля: сначала движок, потом сеть1 видео
- 6Заставить сеть учиться — и обобщать
- 7Собираем BPE-tokenizer: почему модель не может посчитать буквы R1 видео
- 8Предсказание next-token: embeddings и что означает перплексия1 видео
- 9Attention и блок transformer: вывод из среднего
- 10Предобучение LLM: данные, compute, scaling laws и стоимость
- 11От базовой модели к ассистенту: SFT, RLHF, DPO и GRPO
- 12Chain of Thought, RLVR и Test-Time Compute: измерения
- 13Как удешевить inference: KV Cache, batching и quantization
- 14Первый production-вызов LLM: streaming, retries и timeouts
- 15Prompt engineering в цифрах: что меняет ответ
- 16Context window, tokens и счет: измерено
- 17Temperature, top-p и детерминизм, которого у вас нет
- 18Tool calling и структурированные выходные данные: контракт, который держится
- 19RAG в production: chunking, поиск и честные цитаты
- 20Fine-tuning, retrieval или prompt? Решает экономика
- 21Multimodal Pricing: за что на самом деле платят в изображениях, аудио и видео
- 22Что такое AI agent: пять классических типов и два спорящих определения
- 23Собираем agent harness: цикл и пять выходов из него
- 24Context engineering: почему ваш agent глупеет на 40-м ходе
- 25Оркестрация multi-agent: пять паттернов и когда выигрывает один
- 26MCP по спецификации: что на самом деле такое сервер
- 27Запускаем MCP server: TypeScript и Python в цифрах
- 28Agent Skills и SKILL.md: прогрессивное раскрытие, измеренное
- 29Оценка LLM: от публичных benchmarks до вашего golden set
- 30Prompt injection и летальная триада: защита реального agent