
BPE Tokenizerを作る:モデルがRの数を数えられない理由
60行でbyte-pair encoderを訓練し、「the」を自力で発見する様子を見て、スペイン語の段落が39 %高くなる理由を測ります。
このページの内容
司法試験に合格できるモデルに、strawberry に含まれる文字 r はいくつかと尋ねると、かなりの確率で「2つ」と答えます。
よくある説明は、language model は「数えるのが苦手」だとか「本当には理解していない」だとかいうものです。どちらも反証不能で、しかも理由ではありません。理由は機械的なもので、モデルが動く前に起きています。そしてそれは次の1行で見えます。
'strawberry' -> 3 tokens [496, 675, 15717] ['str', 'aw', 'berry']モデルは10個の文字を見ていません。3つの数値を見ています。r を数えるには、token 496 の同一性だけから、見えない文字列の中に r がいくつあるかを知り、675 と 15717 についても同じことをして足し合わせる必要があります。つまり、アクセスできない表現について質問されているのです。
この章では、その3つの数値を生み出すものを作ります。約60行で、主要なモデルが使っているのと同じアルゴリズムです。一度書いてみれば、無関係に見える十数個の奇妙な挙動が、1つの原因に収束します。
なぜ文字でも単語でもないのか
セクション「なぜ文字でも単語でもないのか」へのリンクテキストをネットワークに渡す方法として、すぐ思いつくものが2つあります。どちらも失敗しますが、その失敗を理解する価値があります。失敗の形が、解決策の形を決めるからです。
単語。 スペースで分割し、各単語に番号を割り当てる。英語には数十万の語形があり、モデルはそれぞれに embedding 行を必要とするため、語彙、そしてすべての項目にスコアを出さなければならない出力層が巨大になります。さらに悪いのは inference 時です。訓練中にモデルが見たことのない単語には番号がありません。これが out-of-vocabulary 問題で、一般的な応急処置は未知のものをすべて単一の <UNK> token に写像することですが、それでは情報を捨ててしまいます。また「単語」は明確に定義された概念ではありません。中国語や日本語は単語の間にスペースを置きませんし、ドイツ語は名詞をいくらでも複合できます。
文字。 out-of-vocabulary 問題はなく、語彙は100個強の記号で済みます。しかしシーケンスが非常に長くなり、第9章で見るように attention のコストはシーケンス長に対して二次的に増えます。1000語の文書はおよそ5000文字です。本来必要な長さの4〜5倍のシーケンスになり、その代償は二次関数です。しかも各文字は単体ではほとんど意味を持たないため、最初の数層は tokenizer がそのまま渡せたはずの単語を組み立て直すことに費やされます。
答えはその中間、subword です。よく使われる単語は1つの token になり、珍しい単語は部品に分かれます。そして部品は最終的に個々の byte まで落ちるため、未知のものは決してありません。面白いのは、誰も分割を設計していないことです。tokenizer は訓練されます。モデルと同じ種類のデータで訓練され、どの byte シーケンスに固有の番号を与える価値があるかを、それらが一緒に出現する頻度を数えることで学びます。
Byte-pair encoding
セクション「Byte-pair encoding」へのリンクこのアルゴリズムは1994年に生まれたもので、もともとは 圧縮 アルゴリズムでした。Philip Gage は C Users Journal で、隣接する byte の最頻ペアをデータ内に出現しない byte で繰り返し置き換えることでファイルを小さくする方法として発表しました。1 そのまま22年間置かれていましたが、2016年に Sennrich、Haddow、Birch が機械翻訳の out-of-vocabulary 問題を解決するために転用しました。2 今では、実質的にすべての大規模 language model が読む方法です。
訓練ループは、次の4ステップの繰り返しです。
byte から始める
セクション「byte から始める」へのリンク訓練テキストを UTF-8 としてエンコードします。0〜255 のすべての byte 値が token です。語彙サイズは256です。
隣接ペアを数える
セクション「隣接ペアを数える」へのリンクシーケンスを走査し、隣り合う token の各ペアが何回出現するかを数えます。
最頻ペアをマージする
セクション「最頻ペアをマージする」へのリンク勝者を取り、そのための新しい token id を作り、シーケンス中のすべての出現を置き換えます。語彙は1つ増え、シーケンスは短くなります。
マージを記録し、繰り返す
セクション「マージを記録し、繰り返す」へのリンクそのペアと、それがなった id を順番に保存します。この順序付きリストこそが tokenizer です。後で新しいテキストをエンコードするために必要なものはすべてここにあります。
トレーナー全体は次のとおりです。
def get_stats(ids):
    counts = {}
    for a, b in zip(ids, ids[1:]):
        counts[(a, b)] = counts.get((a, b), 0) + 1
    return counts


def merge(ids, pair, idx):
    out, i = [], 0
    while i < len(ids):
        if i < len(ids) - 1 and ids[i] == pair[0] and ids[i + 1] == pair[1]:
            out.append(idx)
            i += 2
        else:
            out.append(ids[i])
            i += 1
    return out


class BPE:
    def __init__(self):
        self.merges = {}
        self.vocab = {i: bytes([i]) for i in range(256)}

    def train(self, text, vocab_size):
        ids = list(text.encode("utf-8"))
        for i in range(vocab_size - 256):
            stats = get_stats(ids)
            if not stats:
                break
            pair = max(stats, key=stats.get)
            idx = 256 + i
            ids = merge(ids, pair, idx)
            self.merges[pair] = idx
            self.vocab[idx] = self.vocab[pair[0]] + self.vocab[pair[1]]
return idsマージが生まれるところを見る
セクション「マージが生まれるところを見る」へのリンク151,191 byte の英語散文で実行し、最初の12個のマージを発生した順に出力します。ここはゆっくり読む価値があります。アルゴリズムには英語について何も教えていないからです。
merge   1: b'e' + b' '   -> b'e '     (occurred 4433 times)
merge   2: b' ' + b't'   -> b' t'     (occurred 3302 times)
merge   3: b'\xe2' + b'\x80' -> b'\xe2\x80'  (occurred 3247 times)
merge   4: b' ' + b'a'   -> b' a'     (occurred 2335 times)
merge   5: b' t' + b'h'  -> b' th'    (occurred 2253 times)
merge   6: b'i' + b'n'   -> b'in'     (occurred 2011 times)
merge   7: b't' + b' '   -> b't '     (occurred 1904 times)
merge   8: b'e' + b'r'   -> b'er'     (occurred 1813 times)
merge   9: b'd' + b' '   -> b'd '     (occurred 1703 times)
merge  10: b'o' + b'u'   -> b'ou'     (occurred 1554 times)
merge  11: b' ' + b's'   -> b' s'     (occurred 1467 times)
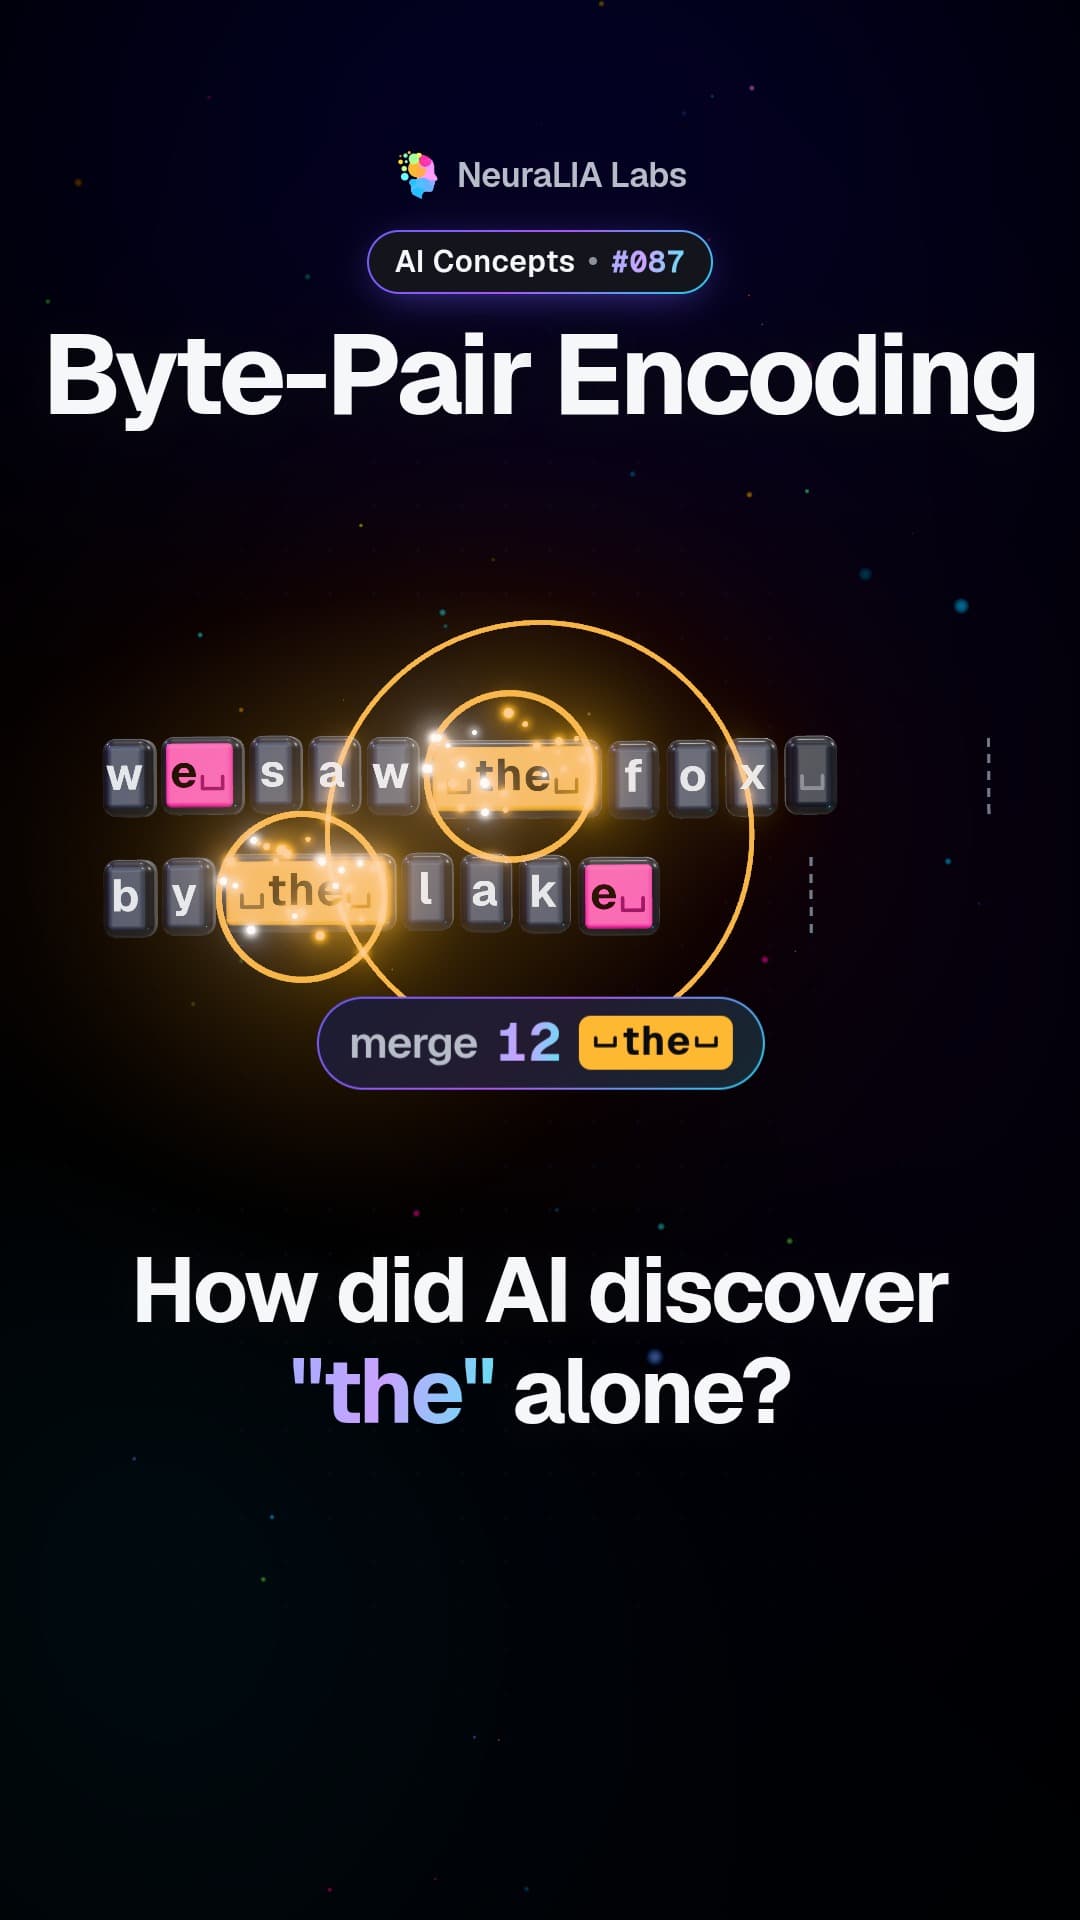
merge  12: b' th' + b'e '-> b' the '  (occurred 1270 times)
このリストでは3つの点に注目する価値があります。
マージ12は単語「the」です。前後のスペースを含んだ1つの単位として、ペアを数えるループの12回目の反復で発見されました。誰も辞書を与えていません。英語ではこの5つの byte が他のどの5つの byte よりも一緒に出現するから、そこにあるのです。
マージ3はテキストですらありません。 \xe2\x80 は、タイポグラフィ上の句読点、つまり em dash や curly quote の UTF-8 エンコードの最初の2 byte です。アルゴリズムは UTF-8 の存在を知りません。それでもその構造の一部を再発見しています。multi-byte エンコードは、構造上、常に一緒に現れる byte のシーケンスだからです。
初期のマージの多くはスペースを含みます。そしてそのスペースはたいてい 左側 にあります。これが、実務で最も混乱を招く挙動の1つの起源です。すぐに戻ってきます。
語彙サイズのトレードオフ
セクション「語彙サイズのトレードオフ」へのリンクマージを1回行うたびに、シーケンスは短くなり、語彙は大きくなります。どこまで進めるかは本物の判断であり、測定できます。ここでは同じ151,191 byte で見ます。
| 語彙サイズ | 結果の token 数 | 圧縮率(byte/token) |
|---|---|---|
| 300 | 101,065 | 1.50 |
| 512 | 68,249 | 2.22 |
| 1,024 | 50,369 | 3.00 |
| 2,048 | 39,306 | 3.85 |
| 4,096 | 30,757 | 4.92 |
収穫逓減は目に見えます。512 から 1024 へ倍増して得られるのは token あたり 0.78 byte。2048 から 4096 への倍増では 1.07 です。ここで後者のほうが良いのは、このコーパスが小さいため、長いマージがまだ効いているからにすぎません。実際のコーパスでは曲線はかなり平坦になります。
語彙を大きくするコストはメモリだけではありません。各 token には embedding 行が必要です。そしてさらに高価なことに、モデルの出力層は 各ステップで語彙内のすべての項目 にスコアを出さなければならないため、最後の行列積は語彙サイズに比例して拡大します。実際のモデルは 32,000 から 200,000 の間にあります。GPT-2 は 50,257、GPT-4 の cl100k は 100,277、GPT-4o の o200k はそのおよそ2倍です。傾向は上向きで、その理由は次の節にあります。
言語別の請求額
セクション「言語別の請求額」へのリンク同じ段落を翻訳し、OpenAI が提供している実際の tokenizer で測定したものです。
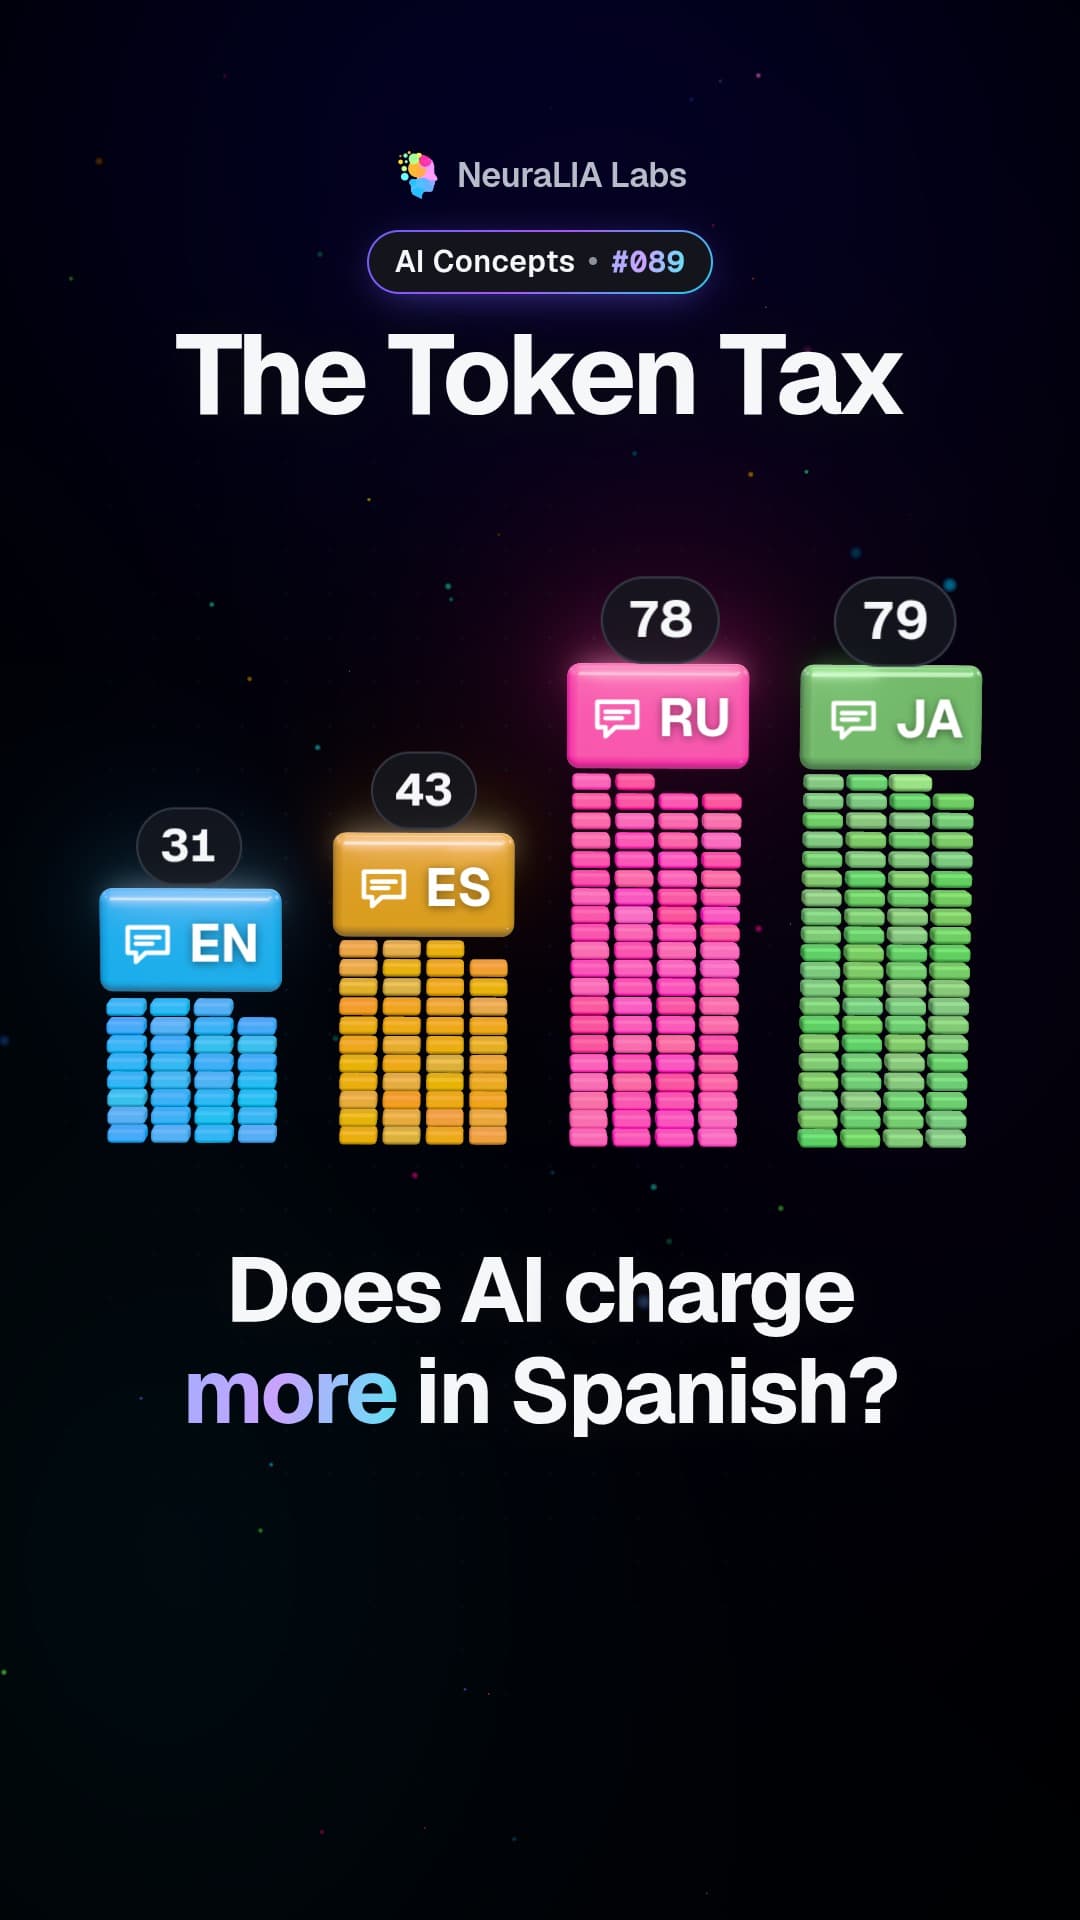
| 言語 | 文字数 | token 数(cl100k) | token 数(o200k) | token/文字 | 英語比のオーバーヘッド |
|---|---|---|---|---|---|
| English | 164 | 31 | 31 | 0.189 | — |
| Spanish | 169 | 43 | 36 | 0.254 | +39 % |
| Russian | 178 | 78 | 43 | 0.438 | +152 % |
| Japanese | 72 | 79 | 58 | 1.097 | +155 % |
同じ内容、同じ意味であっても、cl100k ではロシア語版は2.5倍の token を消費します。API は token ごとに課金され、context window は token で測られます。これは言語学的な珍しさではありません。英語で仕事をしないすべての人にとって、予算の1行であり、実効 context window の短縮であり、応答の遅延でもあります。その3つが同時に起きます。
仕組みは訓練データです。主に英語で訓練された tokenizer は、マージの予算を英語の byte シーケンスに費やします。スペイン語はラテンアルファベットを共有しているので、まだある程度の恩恵を受けます。ロシア語はほとんど受けません。キリル文字は UTF-8 で2 byte を使い、そのペアのうち訓練コーパスで十分に頻出してマージを獲得したものが少ないからです。日本語はさらに悪いです。1文字あたり3 byte で、72文字が79 token になります。文字数より token 数のほうが多い のです。
o200k の列は、これが解ける問題であり、実際に解かれつつあることを示しています。語彙を倍増し、訓練データのバランスを取り直すことで、スペイン語のオーバーヘッドは +39 % から +16 % に、ロシア語は +152 % から +39 % に下がります。語彙が増え続ける本当の理由はこれです。圧縮それ自体のためではなく、前世代が世界の大きな一部にひそかに追加料金を課していたからです。
エンコードと、マージ順序が重要な理由
セクション「エンコードと、マージ順序が重要な理由」へのリンク訓練によって、順序付きのマージ一覧が得られました。新しいテキストをエンコードするときは、それを再生します。そして 同じ順序で 再生しなければなりません。マージ12はマージ5とマージ1の結果を組み合わせるからです。違う順序で適用すると、別の、誤った tokenization になり、モデルが訓練中に見たものと一致しません。
    def encode(self, text):
        ids = list(text.encode("utf-8"))
        while len(ids) >= 2:
            stats = get_stats(ids)
            # the pair whose merge came FIRST during training wins
            pair = min(stats, key=lambda p: self.merges.get(p, float("inf")))
            if pair not in self.merges:
                break
            ids = merge(ids, pair, self.merges[pair])
        return ids

    def decode(self, ids):
        return b"".join(self.vocab[i] for i in ids).decode("utf-8", errors="replace")
デコードはそれに比べれば簡単です。各 id の byte を引き、連結し、UTF-8 としてデコードします。errors="replace" に注意してください。モデルは文字の途中で終わる token シーケンスを出力できます。これは仮定の話ではありません。streaming 応答が絵文字の途中で切られたときに起きることです。だから streaming API は token ごとにデコードするのではなく、部分的な byte をバッファします。
byte-level BPE の約束どおり、何であっても往復できます。
'strawberry'                            -> 6 tokens, decode == original: True
'Alice was beginning to get very tired' -> 14 tokens, decode == original: True
'café — naïve — 日本語' -> 23 tokens, decode == original: True他のすべての正体もこれ
セクション「他のすべての正体もこれ」へのリンク仕組みが明らかになると、無関係に見える不満の集合が、同じ不満だったことが分かります。
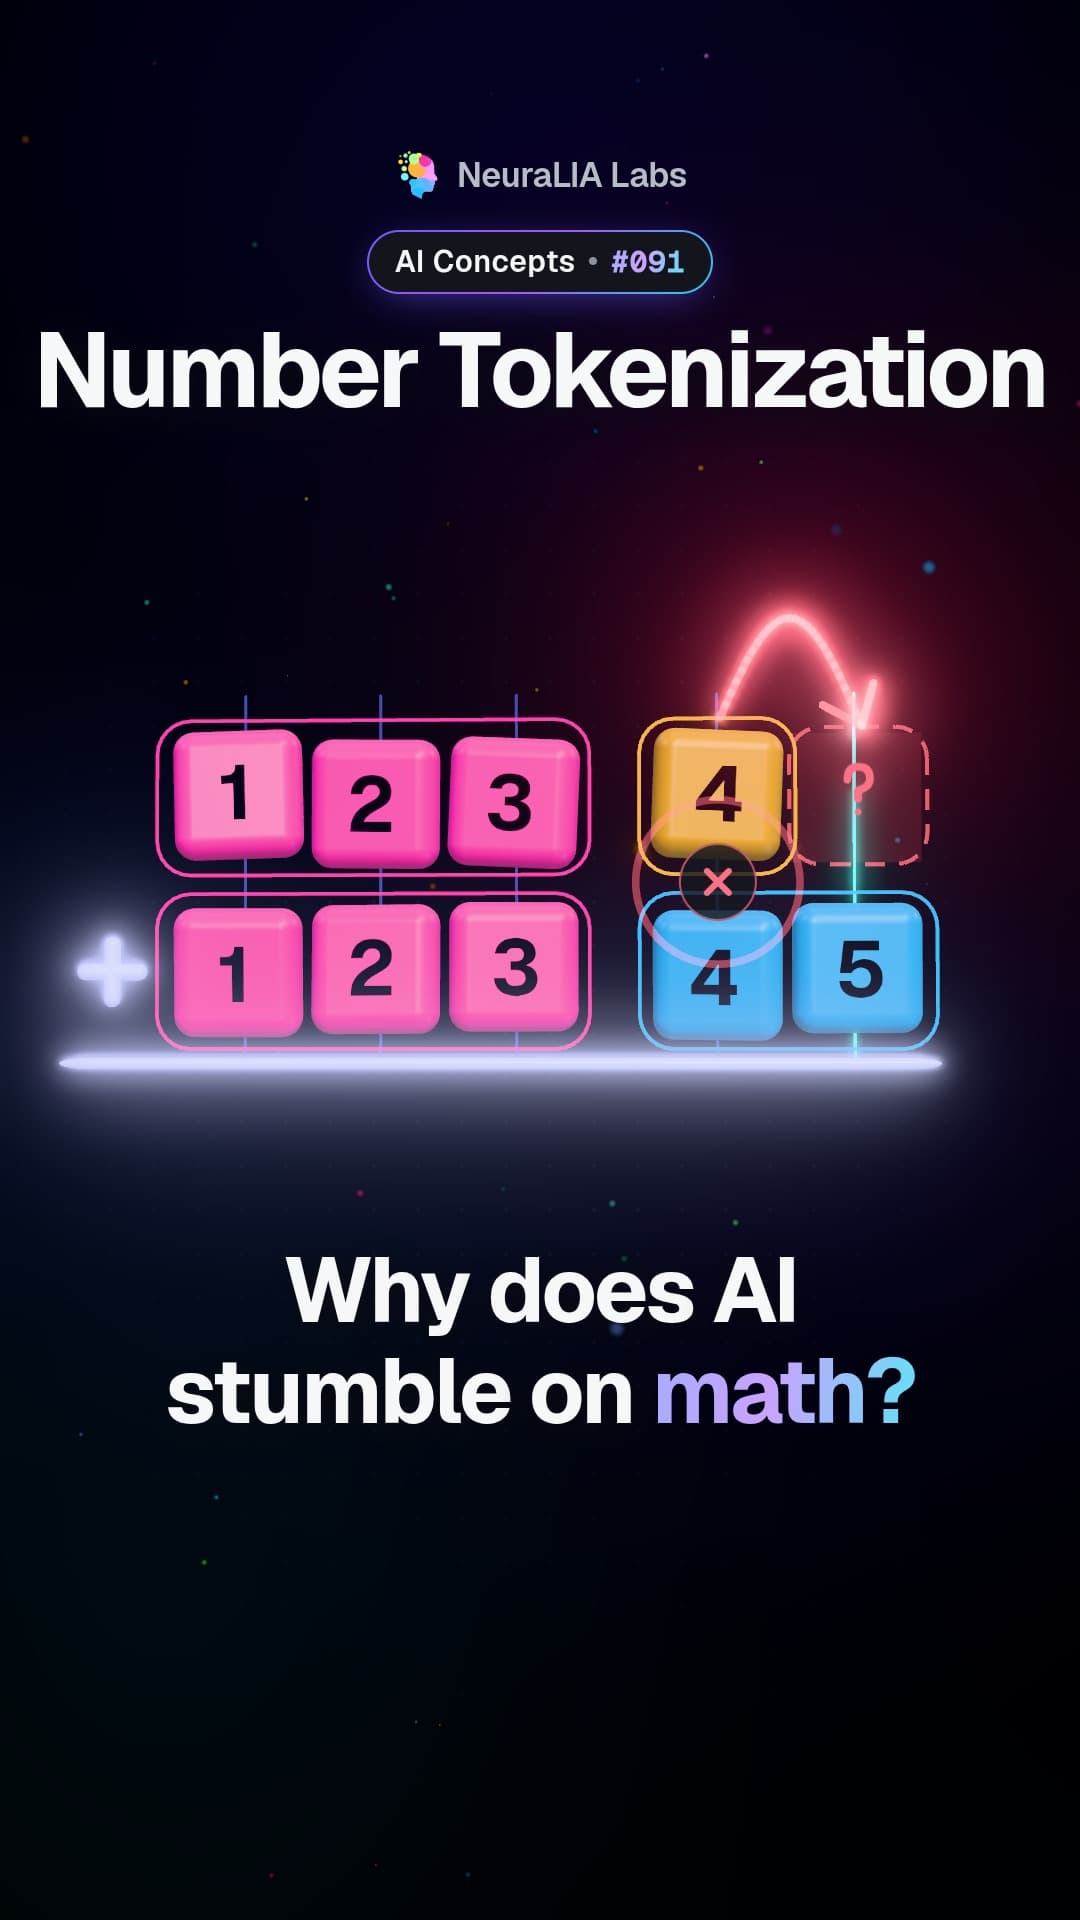
算術。 数値は一貫した方法では分割されません。
1234     -> 2 tokens  ['123', '4']
12345    -> 2 tokens  ['123', '45']
1000000  -> 3 tokens  ['100', '000', '0']
3.14159  -> 4 tokens  ['3', '.', '141', '59']
2024     -> 2 tokens  ['202', '4']
1234 と 12345 を足すには、モデルはまず ['123','4'] と ['123','45'] が特定の形で桁位置をそろえるべき数値だと理解しなければなりません。そしてそのそろえ方は数値の組ごとに異なります。ある数の数字は、次の数でも同じ場所にあるわけではありません。新しい tokenizer の中には、まさにこの障害を取り除くため、数字を一貫して3桁ごとのグループに分割させるものがあります。そうした tokenizer で訓練されたモデルは、算術で測定可能なほど良くなります。
Python のインデント。
'    x = 1'      -> 5 tokens  ['   ', ' x', ' =', ' ', '1']
'        x = 1'  -> 5 tokens  ['       ', ' x', ' =', ' ', '1']
'\tx = 1'        -> 4 tokens  ['\tx', ' =', ' ', '1']
4つのスペースと8つのスペースは 異なる単一 token であり、タブはその後の文字と融合しています。Python では構文であるインデントが、一貫しない形で表現されています。これが、かつてモデルが微妙にインデントを間違えた Python を生成しがちだった大きな理由であり、コード向け tokenizer が一般的なインデント幅に明示的な token を追加する理由でもあります。
綴りと反転。 原因は r を数える話と同じです。モデルに strawberry を逆順にさせることは、3つの不透明な id の中にある文字を並べ替えさせることです。モデルは見ているからではなく、訓練中に綴りを記憶したことでそれを行います。だから一般的な単語ではうまくでき、珍しい単語では下手なのです。
Glitch token。 最も印象的な事例は SolidGoldMagikarp と、それに似た文字列群です。これらは GPT-2 と GPT-3 を奇妙に振る舞わせました。繰り返しを拒んだり、無関係な出力を生成したり、ときにはユーザーを侮辱したりしました。説明は平凡で、tokenizer がモデルとは別に訓練されるという事実から直接導かれます。これらの文字列は tokenizer の訓練コーパスでは頻出していたため(Reddit のユーザー名でした)、固有の token を獲得しました。しかしモデルの訓練コーパスでは稀か存在しませんでした。その結果、ランダムに初期化され、ほとんど更新されなかった embedding 行ができました。モデルには、実質的に一度も見たことのない記号があり、そこでの挙動はランダム初期化がたまたまどうだったかにすぎません。
WordPiece は BERT で使われており、BPE とは選択規則が異なります。最も 頻出する ペアをマージするのではなく、訓練データの尤度を最も高めるペアをマージします。これは部品がすでにどれほど一般的かで正規化するため、2つの珍しい部品のペアが、2つの一般的な部品のペアに勝つことがあります。
Kudo の Unigram は逆向きに働きます。大きな候補語彙から始め、削除してもコーパス尤度への悪影響が最も小さい部品を反復的に 取り除きます。また、各 segmentation に確率を与えるため、同じ文字列の異なる tokenization を regularizer としてサンプリングできます。
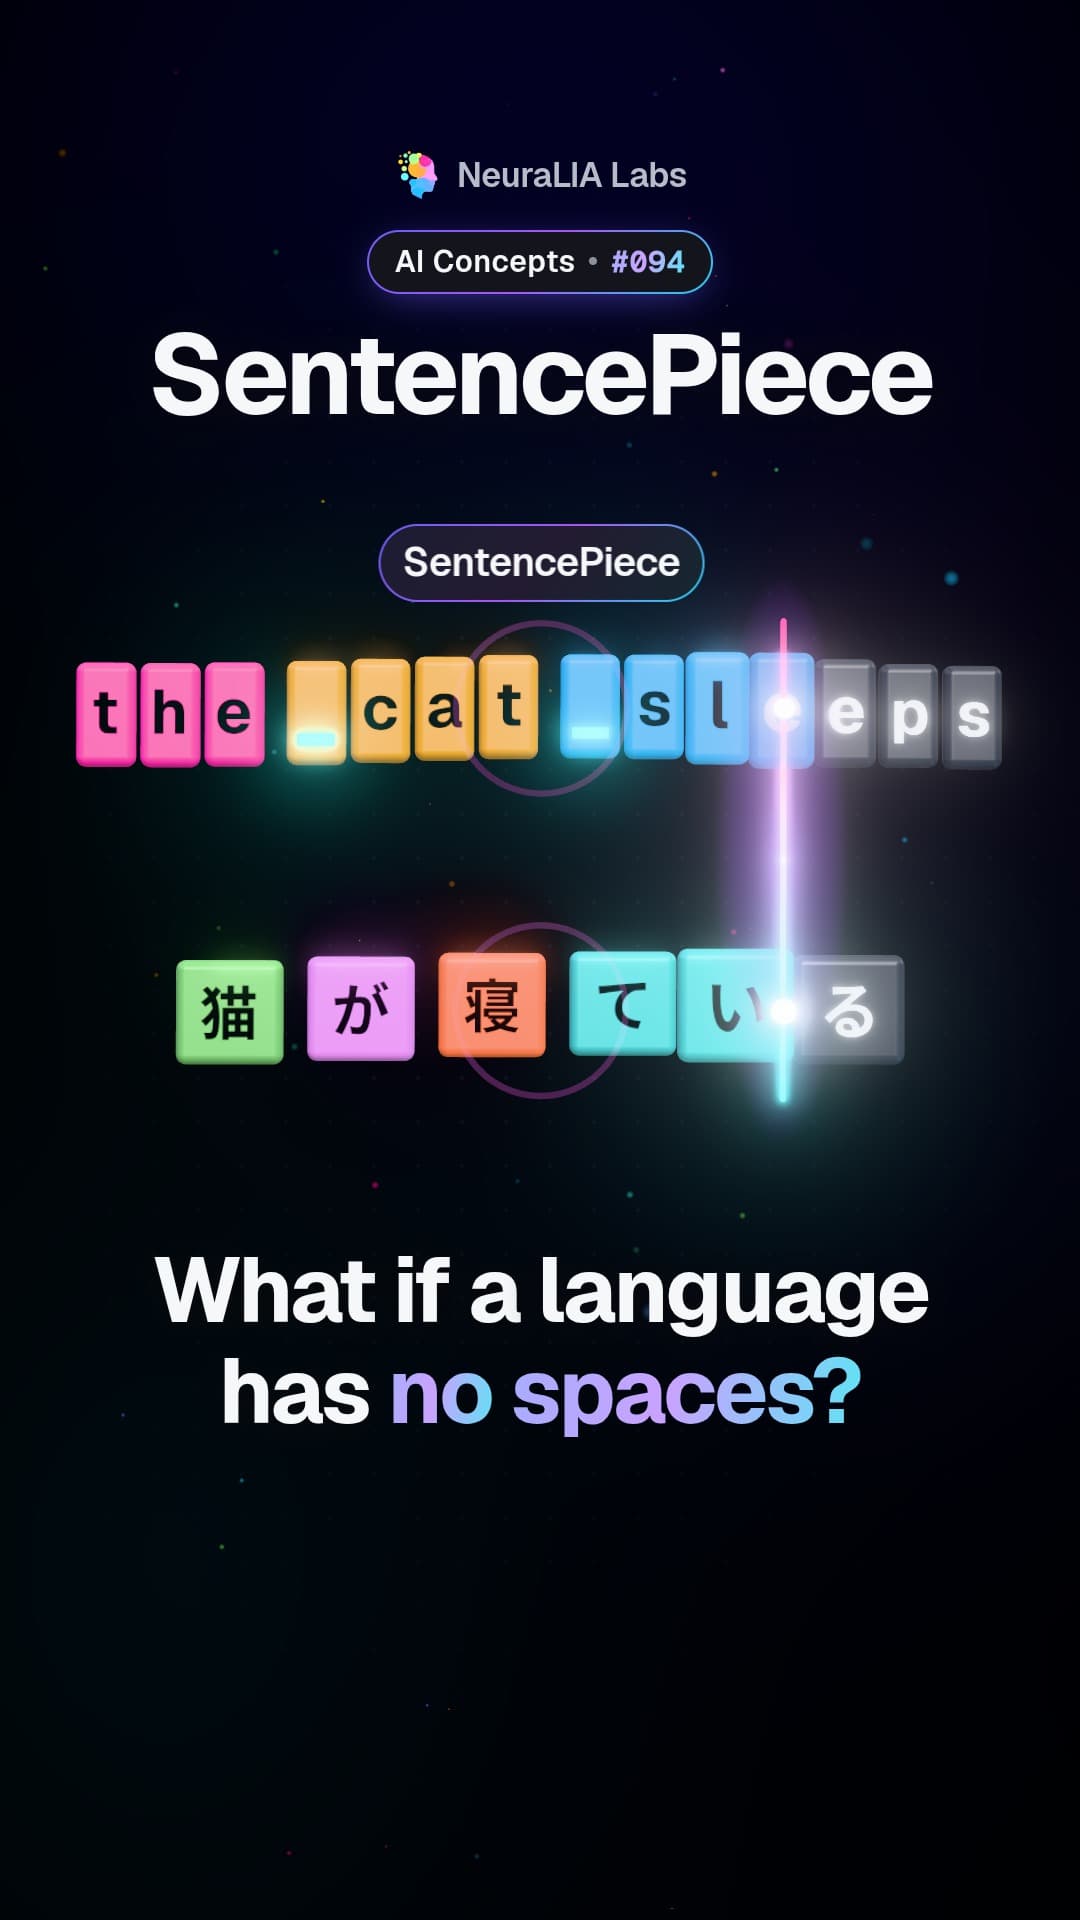
SentencePiece は、英語以外のモデルの多くが使う実装です。その貢献は、pre-tokenization を一切行わず入力を raw stream として扱い、スペースを可視文字としてエンコードすることです。これにより、単語をスペースで区切らない言語でもまったく同じように動きます。内部では BPE と Unigram のどちらも実行できます。
そのコストと、得られるもの
セクション「そのコストと、得られるもの」へのリンクtokenizer はテキストと数値の間にある損失のあるインターフェースであり、この章の奇妙な挙動はすべて、そのインターフェースが透けて見えているものです。この取引が意図的なものだとはっきりさせておく価値があります。byte-level BPE によって、表現不能な入力は存在せず、シーケンスは文字で扱う場合より4〜5倍短くなり、一般的な単語はそのまま届きます。
その代償は、モデルの原子が私たちの原子ではないことです。モデルは綴ることのできないテキストについて、モデル自身が見ていないコーパス上の頻度カウントで選ばれた単位で推論し、誰も交渉していない言語別コストを負います。
次に進む場所
セクション「次に進む場所」へのリンクこれで整数のシーケンスが手に入りました。これが Part II の残りすべての入力形式です。
まだ持っていないのは、ある整数の次に別の整数が続く理由です。次の章では、すべての language model が訓練される目的関数を導入します。それは驚くほど単純です。ここまでの tokens が与えられたとき、次の token を予測する。この単一の目的、ラベルも注釈もなく、テキスト自身の未来をターゲットにするだけの目的が、インターネット全体を訓練データに変えます。そしてモデルの最初の本物の表現は、そこから生まれます。
また、第2章の確率の連鎖律が正確であることも必要です。なぜなら、1つずつ token を予測することが文書全体をモデル化することと同じだという主張は、比喩ではなく因数分解だからです。
第8章 は autoregressive objective、embeddings、そしてモデルが誰も入れていない何かを初めて学ぶ場所です。
出典と方法
セクション「出典と方法」へのリンクKudo, T. Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates(arXiv:1804.10959)は Unigram model を導入しています。Kudo and Richardson, SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing(arXiv:1808.06226)は、多くの multilingual model が使う実装です。Schuster and Nakajima, Japanese and Korean Voice Search (ICASSP 2012) は WordPiece の起源です。Andrej Karpathy の Let's build the GPT Tokenizer と付属の karpathy/minbpe repository は、この章のコードの直接の祖先であり、GPT-4 regex や special-token handling など、さらに先まで扱っています。Hugging Face LLM Course の第6章では、3つのアルゴリズムを worked example とともに並べて解説しています。
参考文献
セクション「参考文献」へのリンク-
Gage, P. A New Algorithm for Data Compression. The C Users Journal 12(2), pp. 23–38 (1994). language model に使われる22年前の、圧縮手法としての byte-pair encoding。 ↩
-
Sennrich, R., Haddow, B. and Birch, A. Neural Machine Translation of Rare Words with Subword Units. arXiv:1508.07909 (2015; ACL 2016). 翻訳における out-of-vocabulary words を動機として、BPE を NLP に持ち込んだ論文。 ↩
-
Radford, A., Wu, J., Child, R., Luan, D., Amodei, D. and Sutskever, I. Language Models are Unsupervised Multitask Learners (2019). セクション2.2で、上で説明した pre-tokenization regex を伴う byte-level BPE を導入しています。 ↩
この章を動画で見る
この章のアイデアをわかりやすく解説する短い動画です。
 #05
Tokens: how AI chops your words into numbered pieces
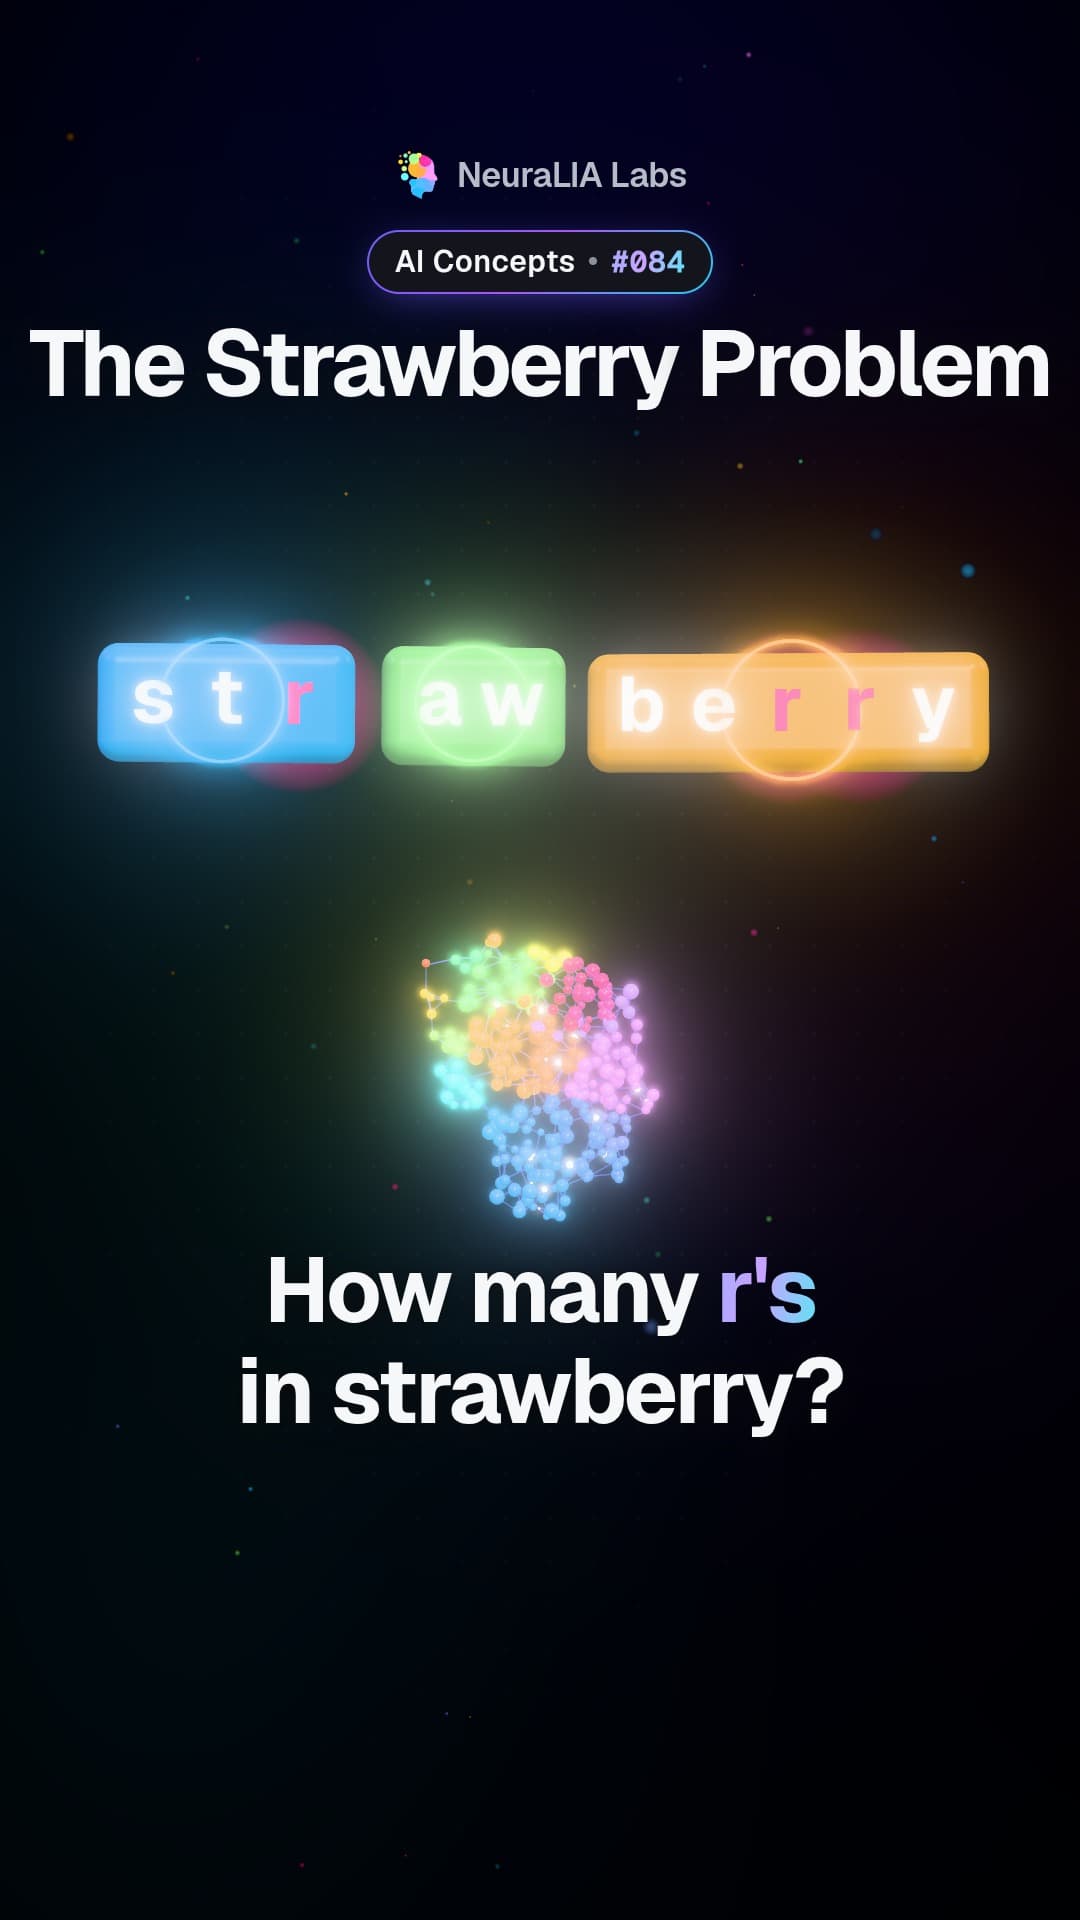 #084
The strawberry problem: why AI can miscount the r's in a word
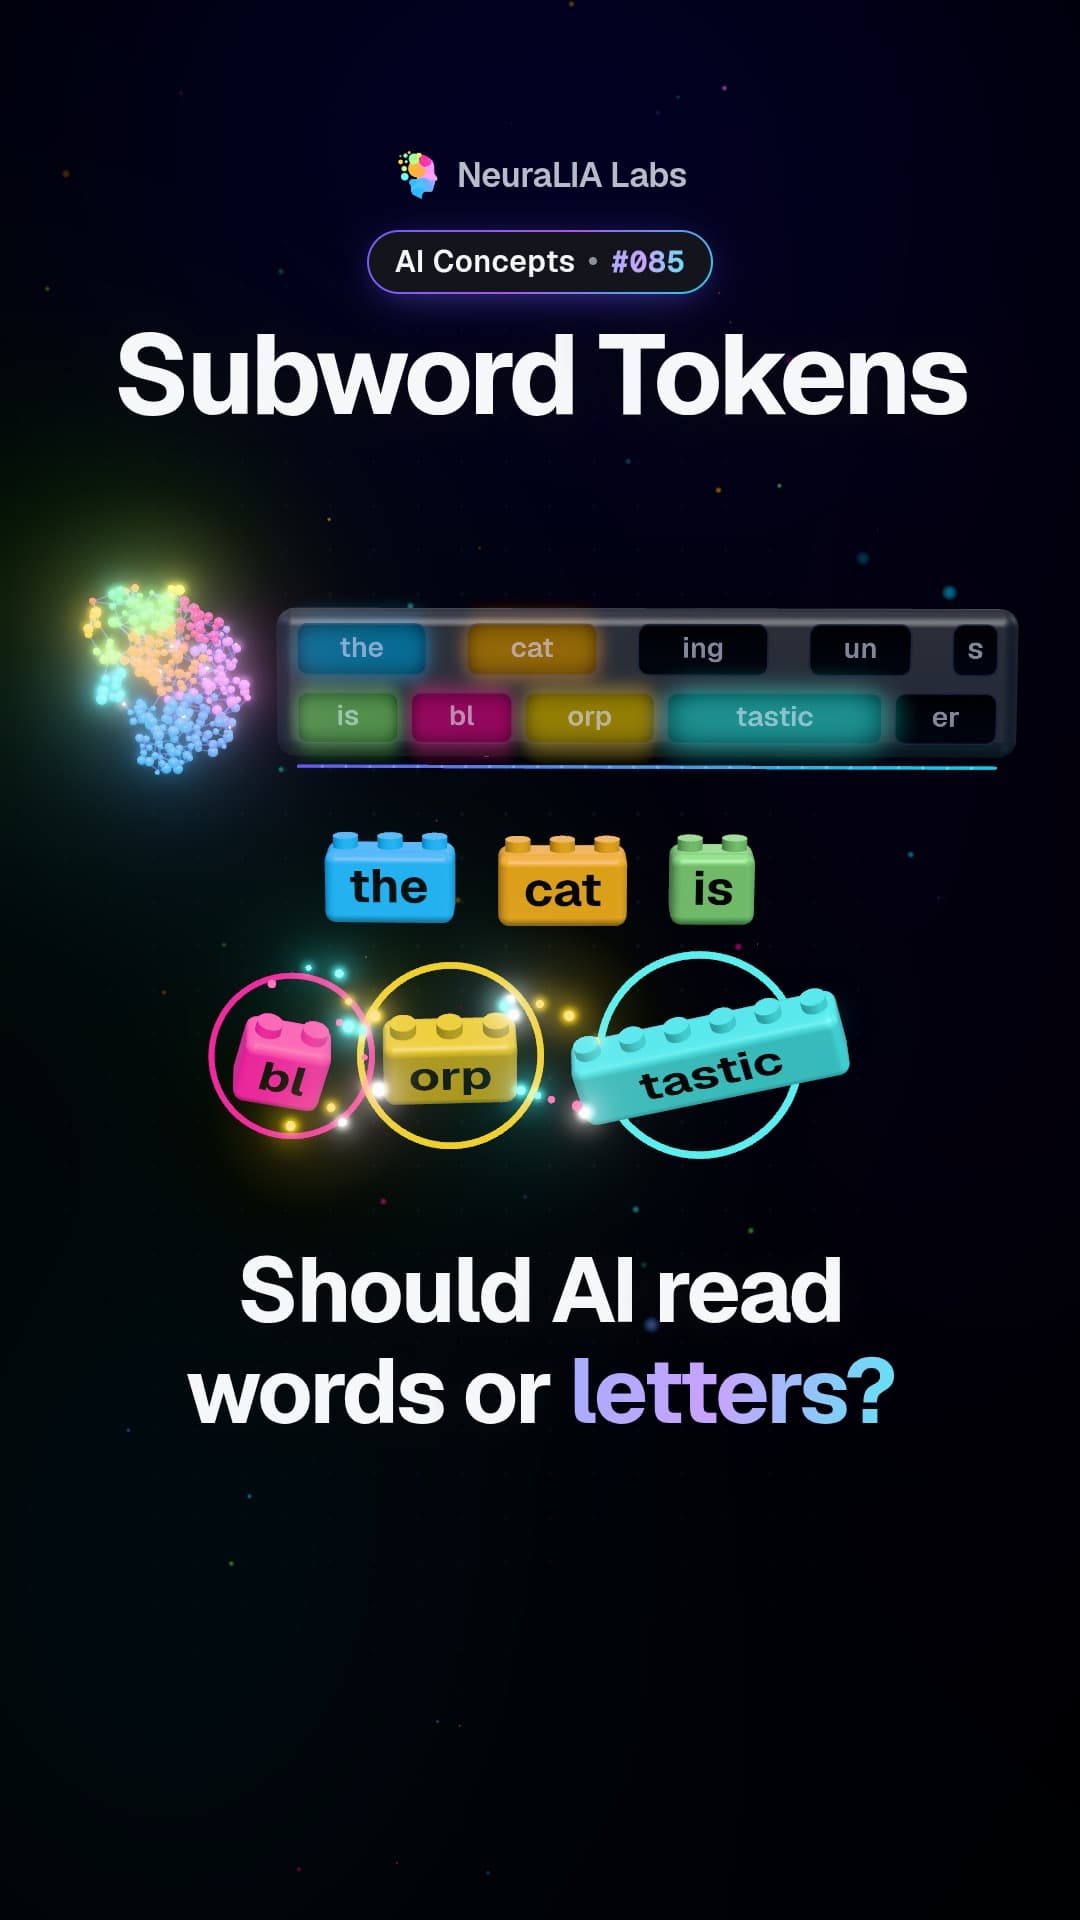 #085
Subword tokens: the middle ground between whole words and letters
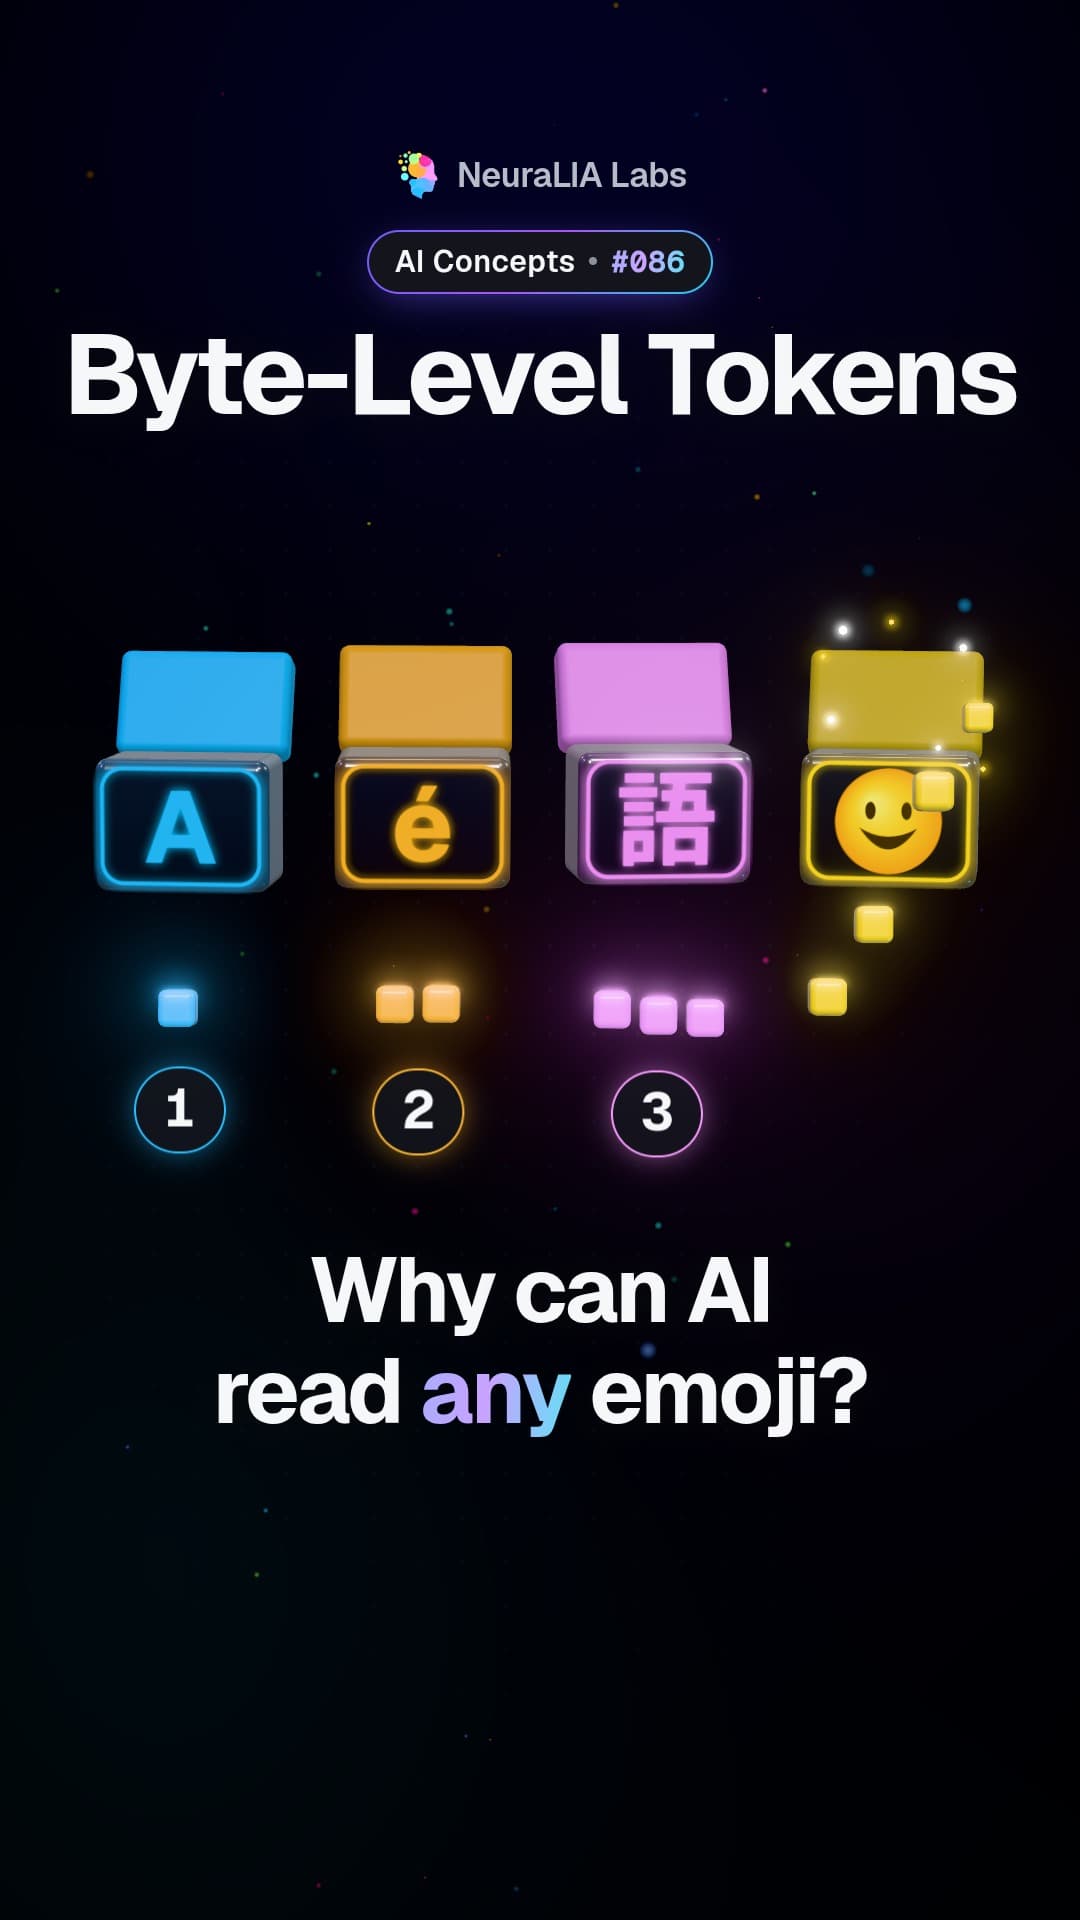 #086
Byte-level tokens: how AI can read any language, symbol or emoji
 #087
Byte-pair encoding: the 1994 compression trick that splits text for AI
 #088
Vocabulary size: how many text pieces an AI model should know
 #089
The token tax: why the same message costs more in some languages
 #090
Trailing space trap: why one invisible space can weaken an AI reply
 #091
Number tokenization: why AI reads digits in uneven chunks
 #092
Glitch tokens: the usernames that made AI models misbehave
 #093
WordPiece: why the most surprising pair beats the most common one
 #094
SentencePiece: how AI splits text in languages without spaces