
Bygg en BPE Tokenizer: Därför kan din modell inte räkna r:en
Träna en byte-pair encoder på 60 rader, se den upptäcka ordet ”the” själv och mät varför ett stycke kostar 39 % mer på spanska.
På den här sidan
Fråga en modell som kan klara en advokatexamen hur många bokstaven r det finns i strawberry, och chansen är rätt god att den svarar två.
Den vanliga förklaringen är att språkmodeller är ”dåliga på att räkna” eller ”inte riktigt förstår”. Båda är omöjliga att motbevisa, och ingen av dem är orsaken. Orsaken är mekanisk, den uppstår innan modellen körs, och du kan se den på en rad:
'strawberry' -> 3 tokens [496, 675, 15717] ['str', 'aw', 'berry']Modellen tittar inte på tio bokstäver. Den tittar på tre tal. För att räkna r:en skulle den behöva veta, enbart från identiteten hos token 496, hur många r som finns inuti en sträng den inte kan se — och sedan göra samma sak för 675 och 15717 och addera dem. Den får en fråga om en representation som den inte har tillgång till.
Det här kapitlet bygger det som producerar de tre talen. Det tar ungefär sextio rader, det är samma algoritm som alla stora modeller använder, och när du väl har skrivit den faller ett dussin till synes orelaterade egenheter tillbaka på en enda orsak.
Varför inte bokstäver, och varför inte ord
Länk till avsnittet: Varför inte bokstäver, och varför inte ordDet finns två uppenbara sätt att mata text till ett nätverk, och båda misslyckas av skäl som är värda att förstå, eftersom misslyckandet formar lösningen.
Ord. Dela på mellanslag, ge varje ord ett tal. Engelska har hundratusentals ordformer och modellen behöver en embedding-rad för var och en, så vokabulären — och utmatningslagret, som måste producera ett värde för varje post — blir enorm. Värre är vad som händer vid inference: ett ord som modellen aldrig såg under träning har inget tal. Det är problemet med ord utanför vokabulären, och den vanliga nödlösningen är att mappa allt okänt till en enda <UNK> token, vilket kastar bort informationen. Dessutom är ”ord” inte ett väldefinierat begrepp: kinesiska och japanska sätter inte mellanslag mellan ord, och tyska kan sammansätta substantiv med andra substantiv i all oändlighet.
Tecken. Inget problem med ord utanför vokabulären, och en vokabulär på drygt hundra symboler. Men sekvenserna blir väldigt långa, och kapitel 9 kommer att visa att attention-kostnaden växer kvadratiskt med sekvenslängden. Ett dokument på 1000 ord är omkring 5000 tecken — en sekvens som är fyra till fem gånger längre än den behöver vara, till ett kvadratiskt pris. Och varje tecken bär nästan ingen mening på egen hand, så de första lagren går åt till att sätta ihop ord som tokenizer kunde ha lämnat över intakta.
Svaret ligger mellan dem: subwords. Vanliga ord blir en token, sällsynta ord delas i delar, och inget är någonsin okänt eftersom delarna i botten är enskilda bytes. Det intressanta är att ingen designar uppdelningen. Tokenizer tränas, på samma typ av data som modellen, och den lär sig vilka bytesekvenser som förtjänar ett eget tal genom att räkna hur ofta de förekommer tillsammans.
Byte-pair encoding
Länk till avsnittet: Byte-pair encodingAlgoritmen är från 1994, och den var en komprimeringsalgoritm. Philip Gage publicerade den i C Users Journal som ett sätt att krympa filer genom att upprepade gånger ersätta det vanligaste paret av intilliggande bytes med en byte som inte förekommer i datan.1 Där låg den i tjugotvå år, tills Sennrich, Haddow och Birch 2016 använde om den för maskinöversättning för att lösa problemet med ord utanför vokabulären.2 I dag är det i praktiken så varje stor språkmodell läser.
Träningsloopen är fyra steg som upprepas:
Börja med bytes
Länk till avsnittet: Börja med bytesKoda träningstexten som UTF-8. Varje bytevärde 0–255 är en token. Vokabulärstorlek: 256.
Räkna intilliggande par
Länk till avsnittet: Räkna intilliggande parGå igenom sekvensen och räkna hur ofta varje par av angränsande tokens förekommer.
Slå ihop det vanligaste paret
Länk till avsnittet: Slå ihop det vanligaste paretTa vinnaren, skapa ett nytt token id för det och ersätt varje förekomst i sekvensen. Vokabulären växer med ett; sekvensen blir kortare.
Spara sammanslagningen och upprepa
Länk till avsnittet: Spara sammanslagningen och upprepaLagra paret och det id det blev, i ordning. Den ordnade listan är tokenizer — den är allt som behövs för att koda ny text senare.
Här är hela tränaren:
def get_stats(ids):
    counts = {}
    for a, b in zip(ids, ids[1:]):
        counts[(a, b)] = counts.get((a, b), 0) + 1
    return counts


def merge(ids, pair, idx):
    out, i = [], 0
    while i < len(ids):
        if i < len(ids) - 1 and ids[i] == pair[0] and ids[i + 1] == pair[1]:
            out.append(idx)
            i += 2
        else:
            out.append(ids[i])
            i += 1
    return out


class BPE:
    def __init__(self):
        self.merges = {}
        self.vocab = {i: bytes([i]) for i in range(256)}

    def train(self, text, vocab_size):
        ids = list(text.encode("utf-8"))
        for i in range(vocab_size - 256):
            stats = get_stats(ids)
            if not stats:
                break
            pair = max(stats, key=stats.get)
            idx = 256 + i
            ids = merge(ids, pair, idx)
            self.merges[pair] = idx
            self.vocab[idx] = self.vocab[pair[0]] + self.vocab[pair[1]]
return idsSe sammanslagningarna födas
Länk till avsnittet: Se sammanslagningarna födasKör den på 151 191 bytes engelsk prosa och skriv ut de första tolv sammanslagningarna när de sker. Det här är delen som är värd att läsa långsamt, eftersom ingen berättade något om engelska för algoritmen:
merge   1: b'e' + b' '   -> b'e '     (occurred 4433 times)
merge   2: b' ' + b't'   -> b' t'     (occurred 3302 times)
merge   3: b'\xe2' + b'\x80' -> b'\xe2\x80'  (occurred 3247 times)
merge   4: b' ' + b'a'   -> b' a'     (occurred 2335 times)
merge   5: b' t' + b'h'  -> b' th'    (occurred 2253 times)
merge   6: b'i' + b'n'   -> b'in'     (occurred 2011 times)
merge   7: b't' + b' '   -> b't '     (occurred 1904 times)
merge   8: b'e' + b'r'   -> b'er'     (occurred 1813 times)
merge   9: b'd' + b' '   -> b'd '     (occurred 1703 times)
merge  10: b'o' + b'u'   -> b'ou'     (occurred 1554 times)
merge  11: b' ' + b's'   -> b' s'     (occurred 1467 times)
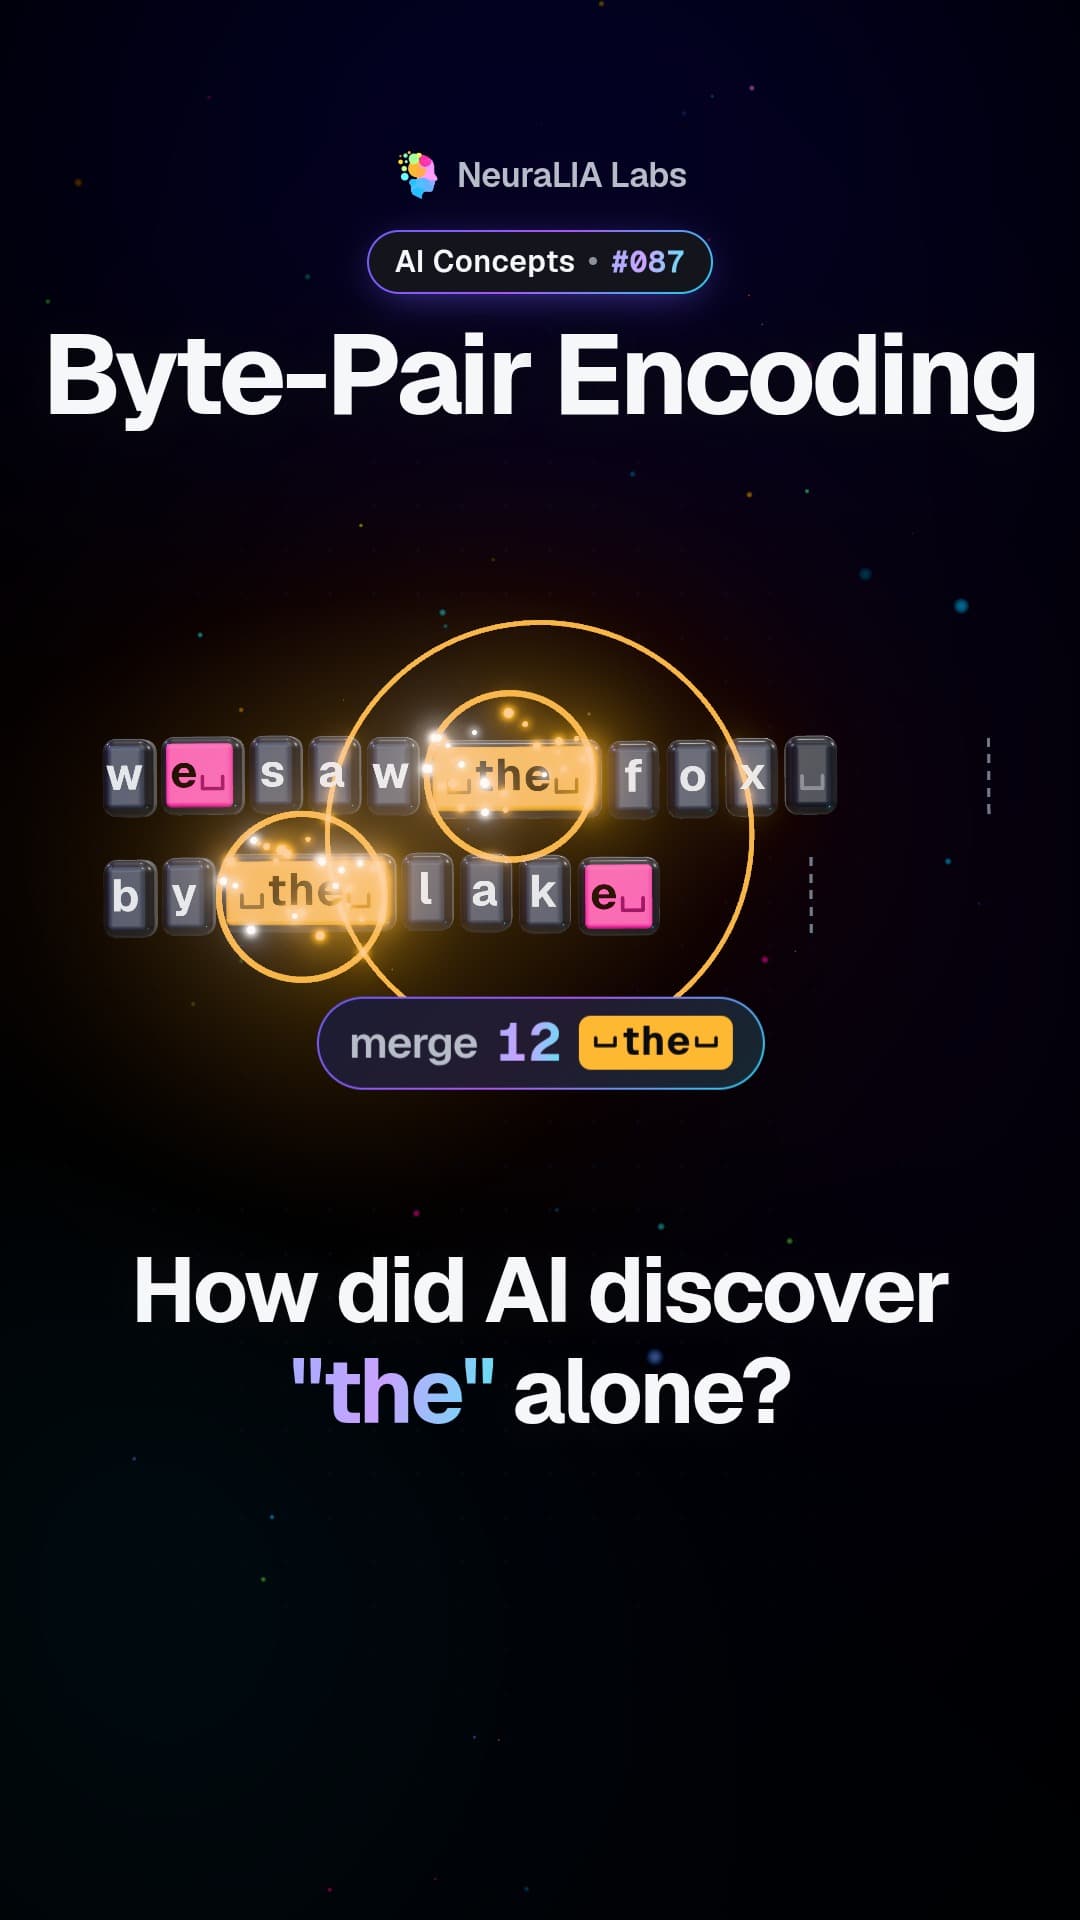
merge  12: b' th' + b'e '-> b' the '  (occurred 1270 times)
Tre saker i den listan är värda att peka på.
Sammanslagning 12 är ordet ”the” — med mellanslaget före och mellanslaget efter, som en enda enhet, upptäckt på tolfte iterationen av en loop som räknar par. Ingen levererade en ordbok. Den finns där eftersom de fem bytesen förekommer tillsammans oftare än några andra fem i engelska.
Sammanslagning 3 är inte text alls. \xe2\x80 är de två första bytesen i UTF-8-kodningen av typografisk interpunktion — tankstrecket, de böjda citattecknen. Algoritmen har ingen aning om att UTF-8 finns, och den har precis återupptäckt en del av dess struktur, eftersom flerbyteskodningar per konstruktion är sekvenser av bytes som alltid uppträder tillsammans.
De flesta tidiga sammanslagningar innehåller ett mellanslag, och mellanslaget ligger oftast till vänster. Det är ursprunget till ett av de mest förvirrande beteendena i praktiken, som vi återkommer till strax.
Avvägningen i vokabulärstorlek
Länk till avsnittet: Avvägningen i vokabulärstorlekVarje sammanslagning gör sekvensen kortare och vokabulären större. Hur långt man ska driva det är ett verkligt beslut, och det går att mäta — här på samma 151 191 bytes:
| vokabulärstorlek | resulterande tokens | komprimering (bytes per token) |
|---|---|---|
| 300 | 101 065 | 1,50 |
| 512 | 68 249 | 2,22 |
| 1 024 | 50 369 | 3,00 |
| 2 048 | 39 306 | 3,85 |
| 4 096 | 30 757 | 4,92 |
Avtagande avkastning, tydligt. En fördubbling från 512 till 1024 köper 0,78 bytes per token; en fördubbling från 2048 till 4096 köper 1,07 — bättre här bara för att korpusen är liten nog för att längre sammanslagningar fortfarande ska löna sig. På en verklig korpus planar kurvan ut kraftigt.
Och kostnaden för en större vokabulär är inte bara minne. Varje token behöver en embedding-rad, och — dyrare — modellens utmatningslager måste producera ett värde för varje post i vokabulären vid varje steg, så den sista matrismultiplikationen skalar med vokabulärstorleken. Verkliga modeller ligger mellan 32 000 och 200 000: GPT-2 använde 50 257, GPT-4:s cl100k använder 100 277, GPT-4o:s o200k ungefär fördubblar det. Trenden går uppåt, och skälet finns i nästa avsnitt.
Fakturan, språk för språk
Länk till avsnittet: Fakturan, språk för språkHär är samma stycke, översatt, mätt med de verkliga tokenizers som OpenAI levererar:
| språk | tecken | tokens (cl100k) | tokens (o200k) | tokens/tecken | påslag jämfört med engelska |
|---|---|---|---|---|---|
| Engelska | 164 | 31 | 31 | 0,189 | — |
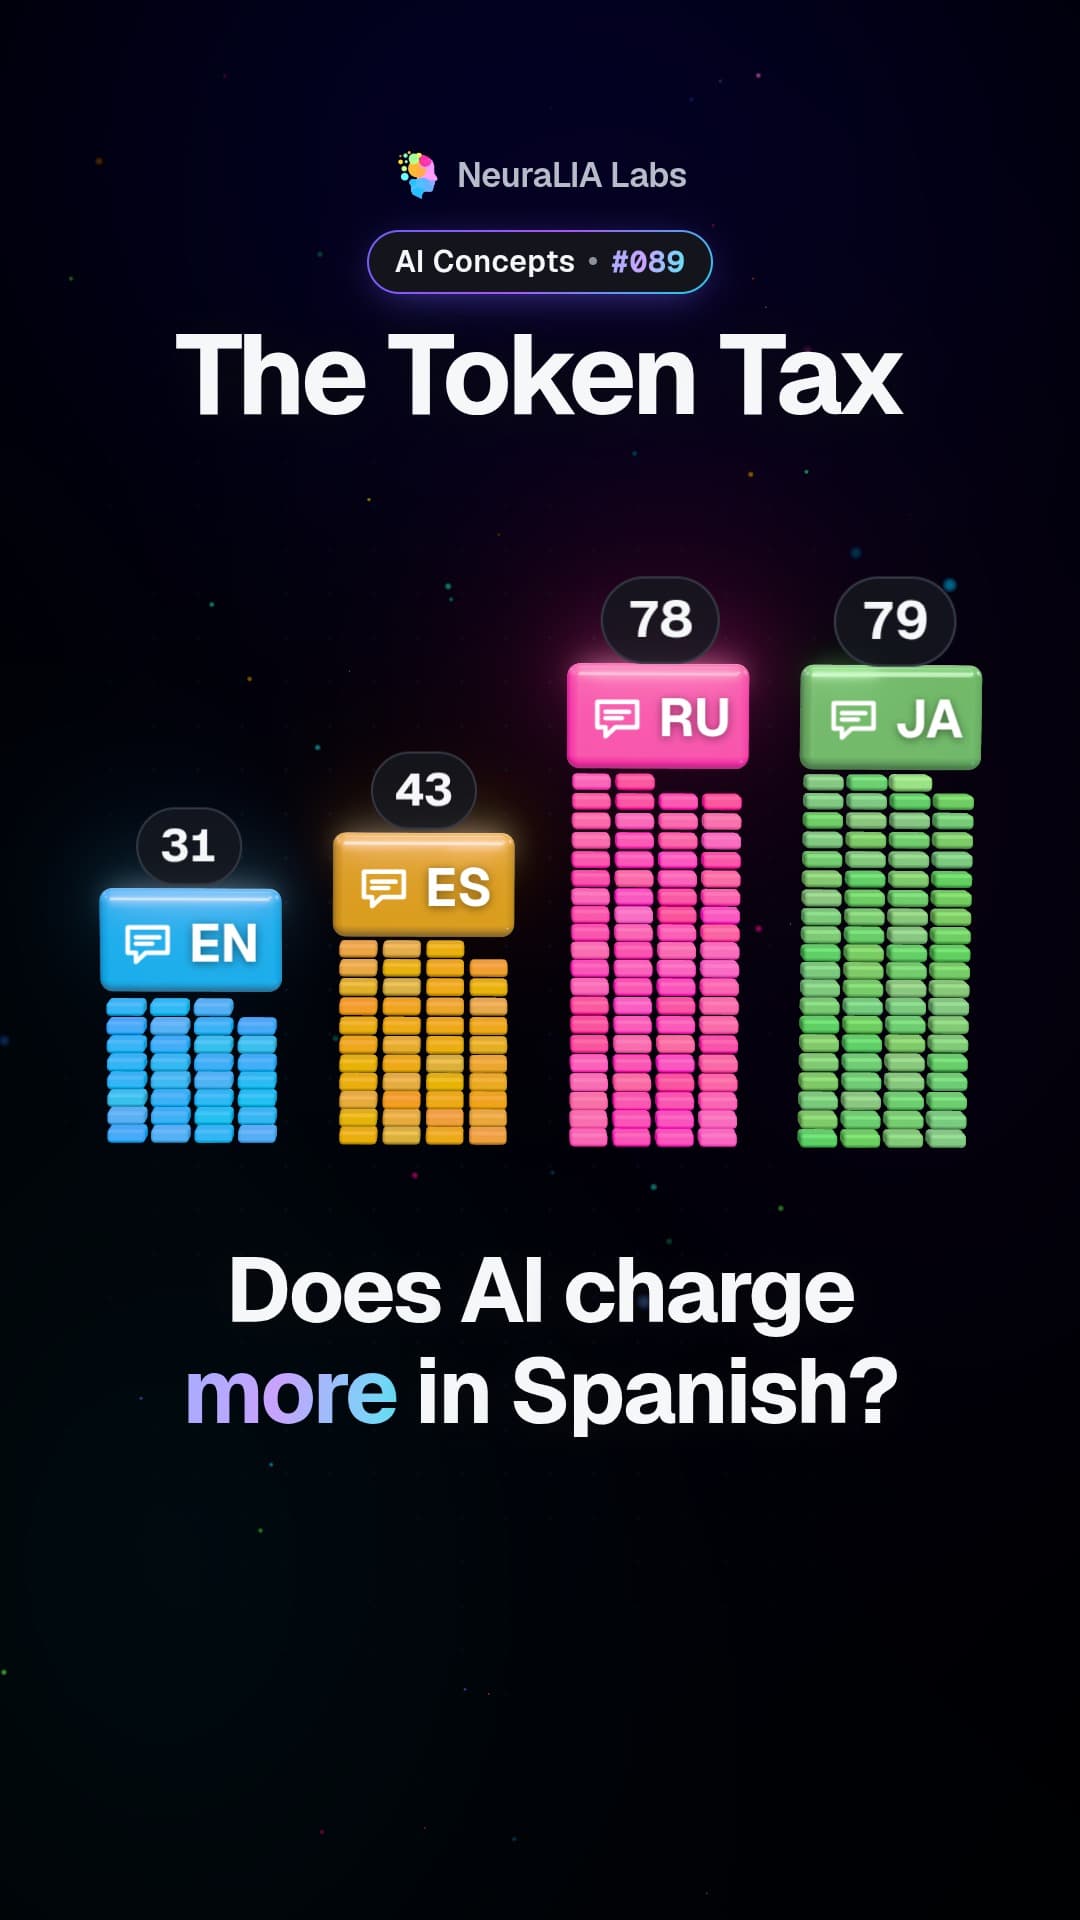
| Spanska | 169 | 43 | 36 | 0,254 | +39 % |
| Ryska | 178 | 78 | 43 | 0,438 | +152 % |
| Japanska | 72 | 79 | 58 | 1,097 | +155 % |
Samma innehåll, samma betydelse, och med cl100k förbrukar den ryska versionen två och en halv gånger så många tokens. Eftersom API:er fakturerar per token och context windows mäts i tokens är det inte en lingvistisk kuriositet — det är en rad i en budget, en kortare effektiv context window och ett långsammare svar, alla tre på en gång, för alla som inte arbetar på engelska.
Mekanismen är träningsdatan. En tokenizer som främst tränats på engelska lägger sin sammanslagningsbudget på engelska bytesekvenser. Spanska delar det latinska alfabetet och får därför fortfarande viss nytta; ryska får nästan ingen, eftersom kyrilliska tecken tar två bytes i UTF-8 och få av de paren var tillräckligt vanliga i träningskorpusen för att förtjäna en sammanslagning. Japanska är ännu värre: tre bytes per tecken, och 72 tecken blir 79 tokens — fler tokens än tecken.
Kolumnen o200k visar att det här är ett lösbart problem och att det håller på att lösas. Att fördubbla vokabulären och balansera om träningsdatan sänker påslaget för spanska från +39 % till +16 %, och för ryska från +152 % till +39 %. Det är den verkliga anledningen till att vokabulärerna fortsätter att växa: inte komprimering för sin egen skull, utan att den föregående generationen i tysthet tog extra betalt av en stor del av världen.
Kodning, och varför sammanslagningarnas ordning spelar roll
Länk till avsnittet: Kodning, och varför sammanslagningarnas ordning spelar rollTräningen producerade en ordnad lista med sammanslagningar. Kodning av ny text spelar upp den igen — och den måste spela upp den i samma ordning, eftersom sammanslagning 12 kombinerar resultaten av sammanslagning 5 och 1. Tillämpa dem i en annan ordning och du får en annan, felaktig tokenisering som inte matchar något modellen såg under träningen.
    def encode(self, text):
        ids = list(text.encode("utf-8"))
        while len(ids) >= 2:
            stats = get_stats(ids)
            # the pair whose merge came FIRST during training wins
            pair = min(stats, key=lambda p: self.merges.get(p, float("inf")))
            if pair not in self.merges:
                break
            ids = merge(ids, pair, self.merges[pair])
        return ids

    def decode(self, ids):
        return b"".join(self.vocab[i] for i in ids).decode("utf-8", errors="replace")
Avkodning är trivialt i jämförelse: slå upp varje id:s bytes, konkatenera och avkoda som UTF-8. Notera errors="replace": en modell kan mata ut en token-sekvens som slutar mitt i ett tecken, och det är inte hypotetiskt — det är vad som händer när ett streamat svar kapas mitt i en emoji, vilket är varför streaming-API:er buffrar partiella bytes i stället för att avkoda token för token.
Rundresan fungerar på vad som helst, vilket är löftet med byte-level BPE:
'strawberry'                            -> 6 tokens, decode == original: True
'Alice was beginning to get very tired' -> 14 tokens, decode == original: True
'café — naïve — 日本語' -> 23 tokens, decode == original: TrueAllt annat som egentligen är detta
Länk till avsnittet: Allt annat som egentligen är dettaNär mekanismen väl är tydlig visar sig en uppsättning till synes orelaterade klagomål vara samma klagomål.
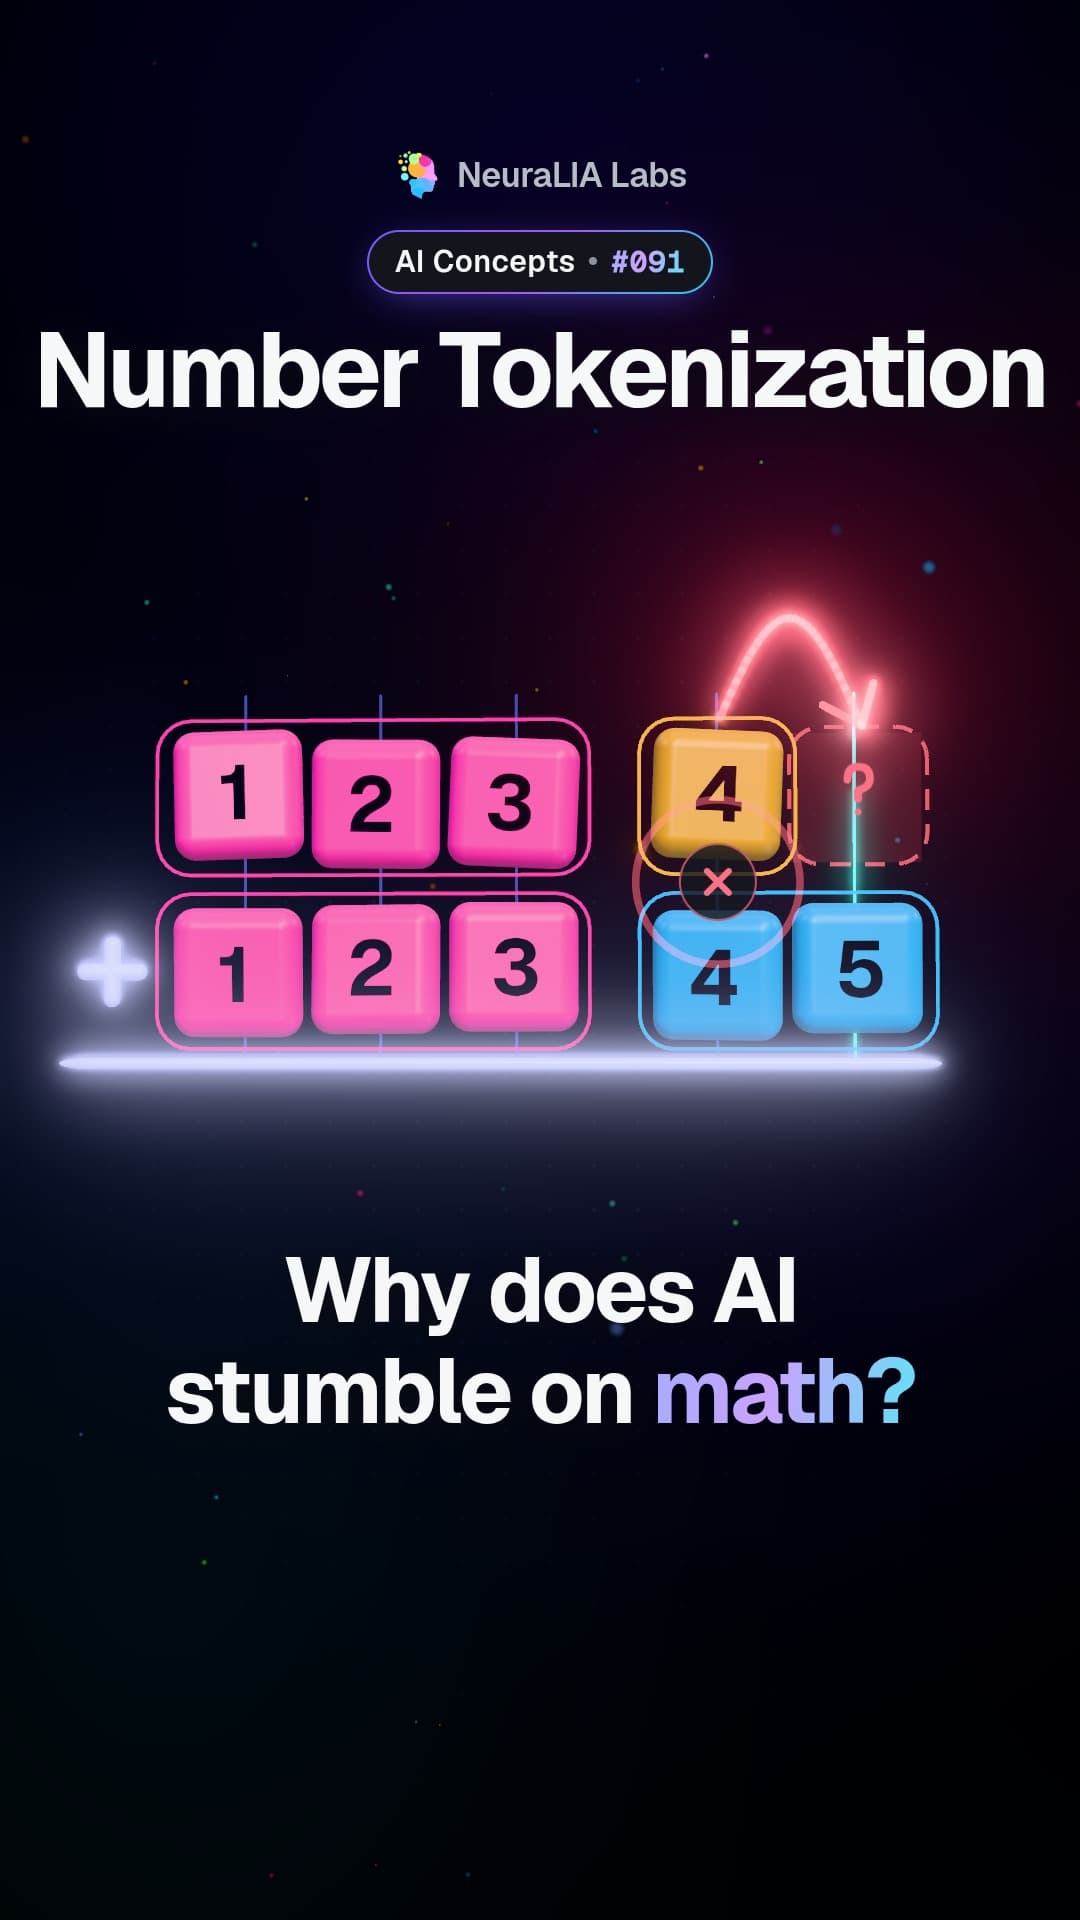
Aritmetik. Tal delas inte på något konsekvent sätt:
1234     -> 2 tokens  ['123', '4']
12345    -> 2 tokens  ['123', '45']
1000000  -> 3 tokens  ['100', '000', '0']
3.14159  -> 4 tokens  ['3', '.', '141', '59']
2024     -> 2 tokens  ['202', '4']
För att addera 1234 och 12345 måste modellen först räkna ut att ['123','4'] och ['123','45'] är tal vars siffror linjerar på ett visst sätt — och linjeringen skiljer sig för varje par av tal. Siffrorna i ett tal finns inte på samma platser från ett tal till nästa. Vissa nyare tokenizers tvingar siffror att delas i konsekventa grupper om tre just för att ta bort detta hinder, och modeller som tränats med dem är mätbart bättre på aritmetik.
Python-indrag.
'    x = 1'      -> 5 tokens  ['   ', ' x', ' =', ' ', '1']
'        x = 1'  -> 5 tokens  ['       ', ' x', ' =', ' ', '1']
'\tx = 1'        -> 4 tokens  ['\tx', ' =', ' ', '1']
Fyra mellanslag och åtta mellanslag är olika enskilda tokens, och en tab är sammansmält med tecknet efter den. Indrag, som i Python är syntax, representeras inkonsekvent — vilket är en stor del av varför modeller brukade producera Python med subtilt felaktiga indrag, och varför kodfokuserade tokenizers lägger till explicita tokens för vanliga indrag.
Stavning och baklängesvändning. Samma orsak som när man räknar r:en: att be en modell vända strawberry baklänges är att be den ordna om bokstäver inuti tre ogenomskinliga id:n. Modeller gör det genom att ha memorerat stavningar under träningen snarare än genom att titta, vilket är varför de gör det bra för vanliga ord och dåligt för sällsynta.
Glitch tokens. Det mest slående fallet är SolidGoldMagikarp och en uppsättning liknande strängar som fick GPT-2 och GPT-3 att bete sig bisarrt — vägra upprepa dem, producera orelaterad output, ibland förolämpa användaren. Förklaringen är vardaglig och följer direkt av att tokenizer tränas separat från modellen: de strängarna var vanliga i tokenizerns träningskorpus (de var Reddit-användarnamn), så de fick en egen token, men var sällsynta eller frånvarande i modellens träningskorpus. Resultatet är en embedding-rad som initialiserades slumpmässigt och nästan aldrig uppdaterades. Modellen har en symbol den i praktiken aldrig har sett, och dess beteende där blir vad den slumpmässiga initialiseringen råkade ge.
WordPiece, som används av BERT, skiljer sig från BPE i urvalsregeln: i stället för att slå ihop det mest frekventa paret slår den ihop det par som ökar sannolikheten för träningsdatan mest — vilket normaliserar efter hur vanliga delarna redan är, så ett par av två sällsynta delar kan slå ett par av två vanliga.
Unigram, från Kudo, arbetar baklänges: börja med en stor kandidatvokabulär och ta bort de delar vars borttagning skadar korpusens sannolikhet minst. Den ger också en sannolikhet till varje segmentering, vilket gör det möjligt att sampla olika tokeniseringar av samma sträng som regularisering.
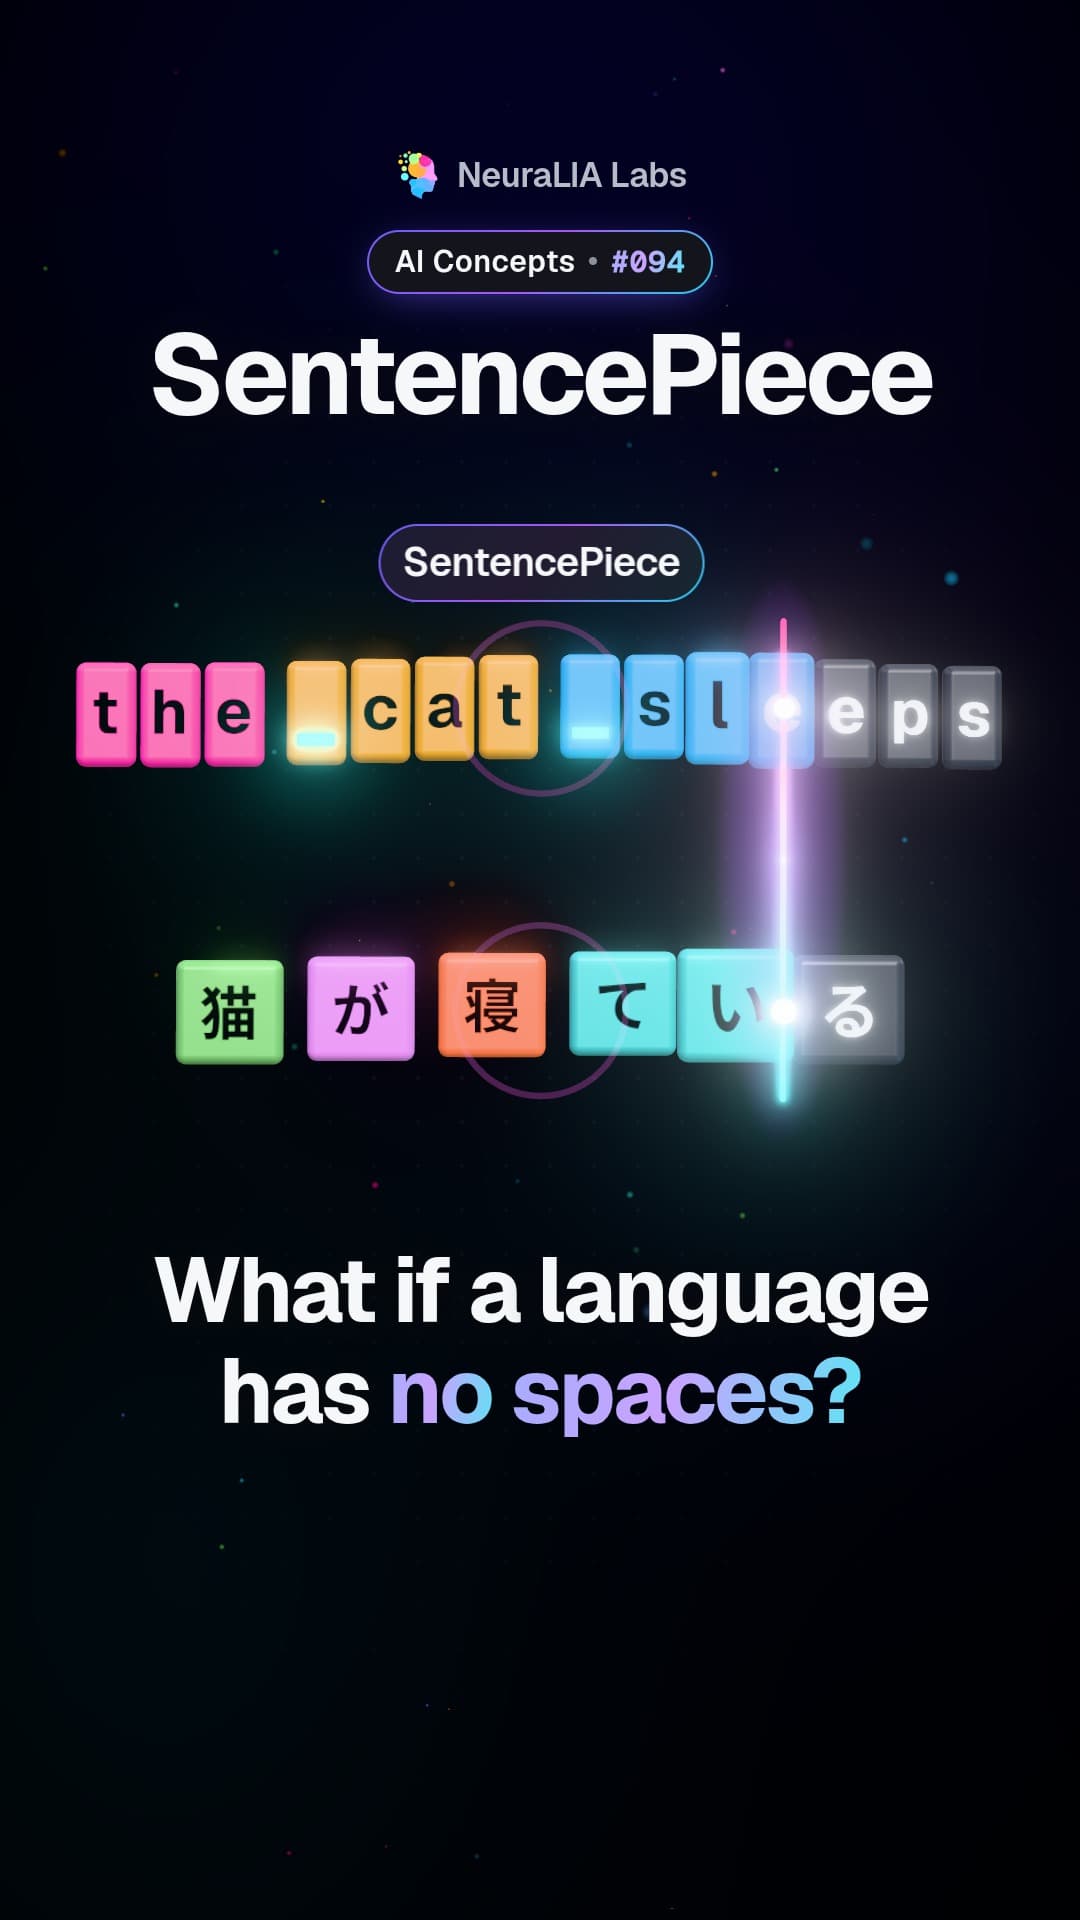
SentencePiece är den implementation som de flesta icke-engelska modeller använder. Dess bidrag är att behandla input som en rå ström utan någon pre-tokenization alls och koda mellanslaget som ett synligt tecken, vilket betyder att den fungerar likadant för språk som inte separerar ord med mellanslag. Den kan köra antingen BPE eller Unigram under ytan.
Vad det här kostar, och vad det ger
Länk till avsnittet: Vad det här kostar, och vad det gerEn tokenizer är ett förlustbringande gränssnitt mellan text och tal, och varje märkligt beteende i det här kapitlet är gränssnittet som lyser igenom. Det är värt att vara tydlig med att avvägningen är avsiktlig: byte-level BPE betyder att ingen input någonsin är omöjlig att representera, sekvenserna är fyra till fem gånger kortare än tecken skulle vara, och vanliga ord anländer intakta.
Priset är att modellens atomer inte är våra atomer. Den resonerar om text den inte kan stava, i enheter valda av en frekvensräkning över en korpus den inte såg, med en kostnad per språk som ingen förhandlade om.
Vart det leder härnäst
Länk till avsnittet: Vart det leder härnästDu har nu en sekvens av heltal. Det är input-formatet för allt i resten av del II.
Det du inte har är någon anledning till att ett heltal ska följa ett annat. Nästa kapitel introducerar målet som varje språkmodell tränas på, och det är förbluffande enkelt: givet hittillsvarande tokens, förutsäg nästa. Det enda målet — inga etiketter, ingen annotering, bara text med sin egen framtid som target — är vad som gör hela internet till träningsdata, och det är där modellens första verkliga representationer kommer ifrån.
Det kräver också att kedjeregeln för sannolikhet från kapitel 2 blir exakt rätt, eftersom påståendet att förutsäga en token i taget är samma sak som att modellera hela dokument är en faktorisering, inte en metafor.
Kapitel 8 handlar om det autoregressiva målet, embeddings och den första plats där en modell lär sig något som ingen lade dit.
Källor och metod
Länk till avsnittet: Källor och metodKudo, T. Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates (arXiv:1804.10959) introducerar Unigram-modellen; Kudo och Richardson, SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing (arXiv:1808.06226) är den implementation som de flesta flerspråkiga modeller använder; Schuster och Nakajima, Japanese and Korean Voice Search (ICASSP 2012) är ursprunget till WordPiece. Andrej Karpathys Let's build the GPT Tokenizer och det tillhörande karpathy/minbpe-repositoryt är de direkta föregångarna till koden i det här kapitlet och går betydligt längre, inklusive GPT-4-regexen och hantering av special-token. Kapitel 6 i Hugging Face LLM Course täcker de tre algoritmerna sida vid sida med genomarbetade exempel.
Referenser
Länk till avsnittet: Referenser-
Gage, P. A New Algorithm for Data Compression. The C Users Journal 12(2), s. 23–38 (1994). Byte-pair encoding som komprimeringsmetod, tjugotvå år innan någon använde den för språkmodeller. ↩
-
Sennrich, R., Haddow, B. och Birch, A. Neural Machine Translation of Rare Words with Subword Units. arXiv:1508.07909 (2015; ACL 2016). Artikeln som tog BPE till NLP, motiverad av ord utanför vokabulären i översättning. ↩
-
Radford, A., Wu, J., Child, Luan, D., Amodei, D. och Sutskever, I. Language Models are Unsupervised Multitask Learners (2019). Avsnitt 2.2 introducerar byte-level BPE med den pre-tokenization-regex som diskuteras ovan. ↩
Det här kapitlet på video
Korta videor som förklarar idéer från det här kapitlet på enkelt språk.
 #05
Tokens: how AI chops your words into numbered pieces
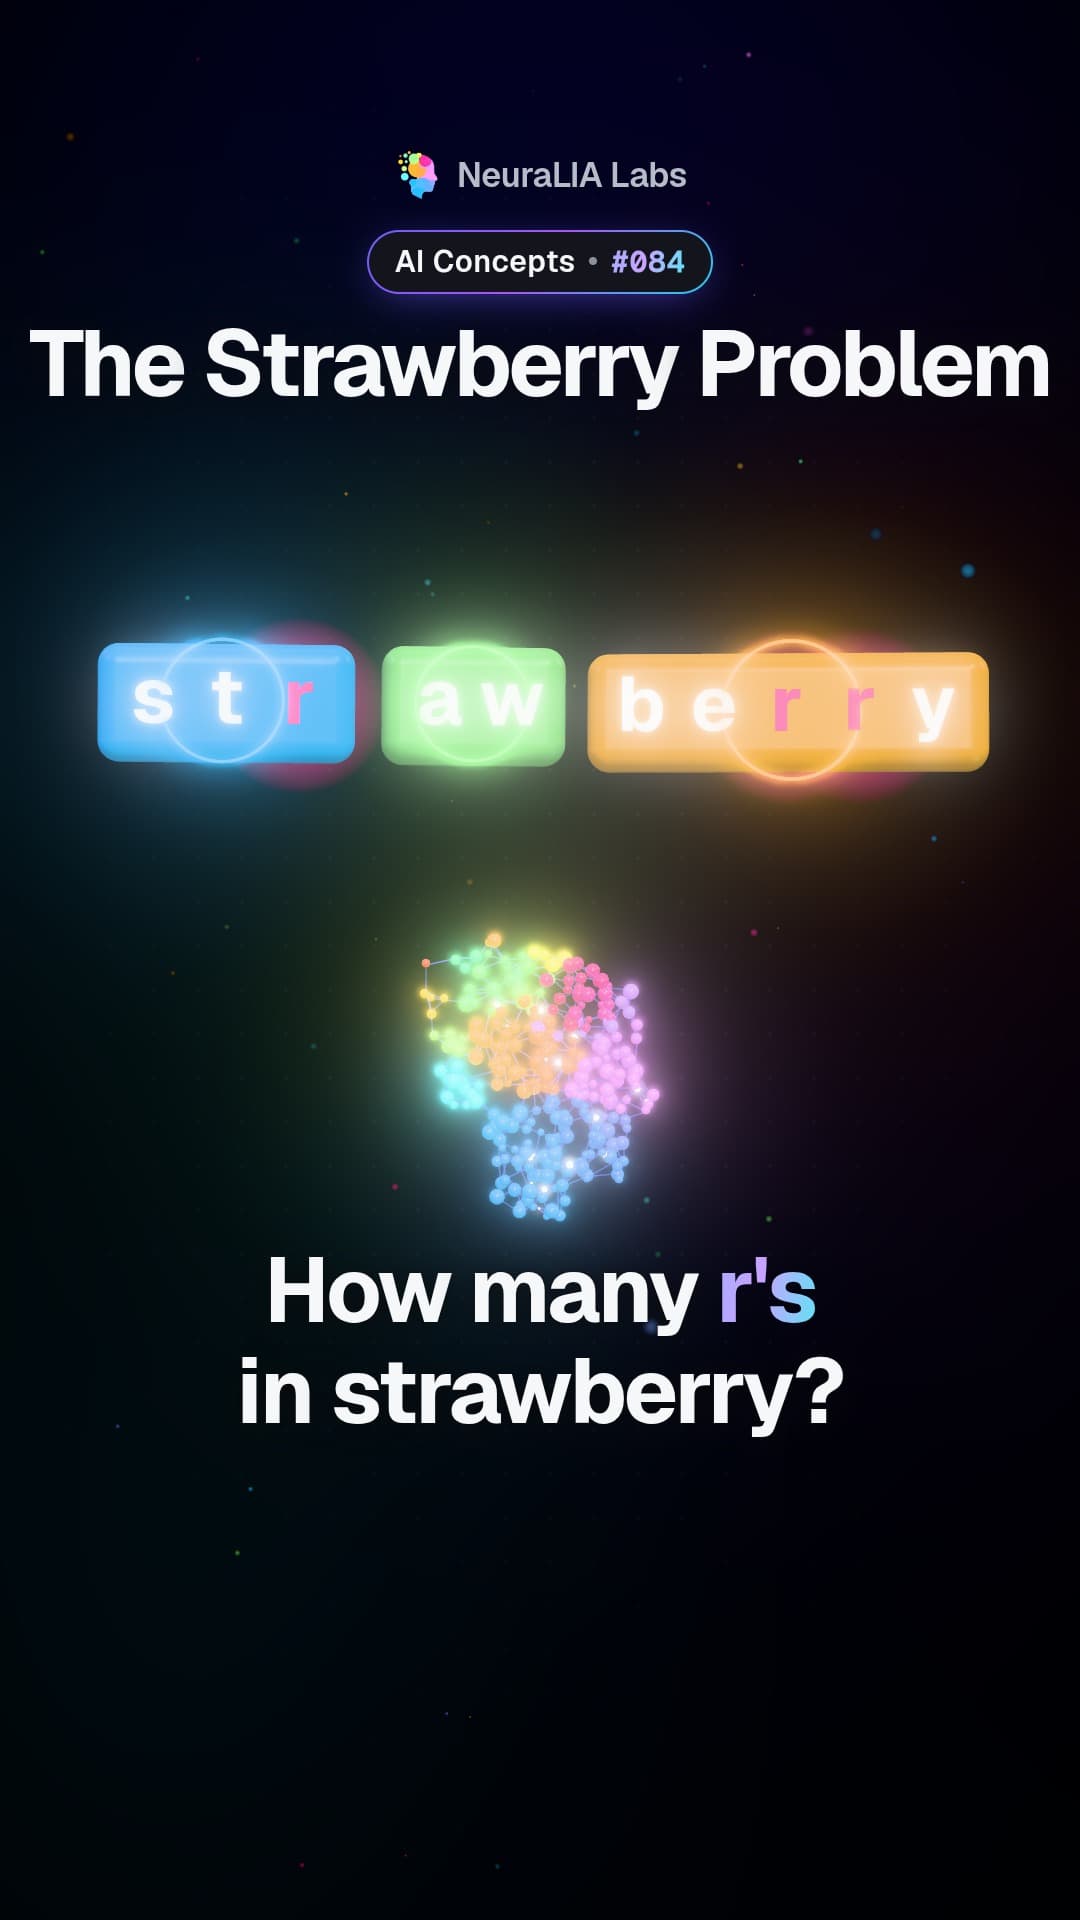 #084
The strawberry problem: why AI can miscount the r's in a word
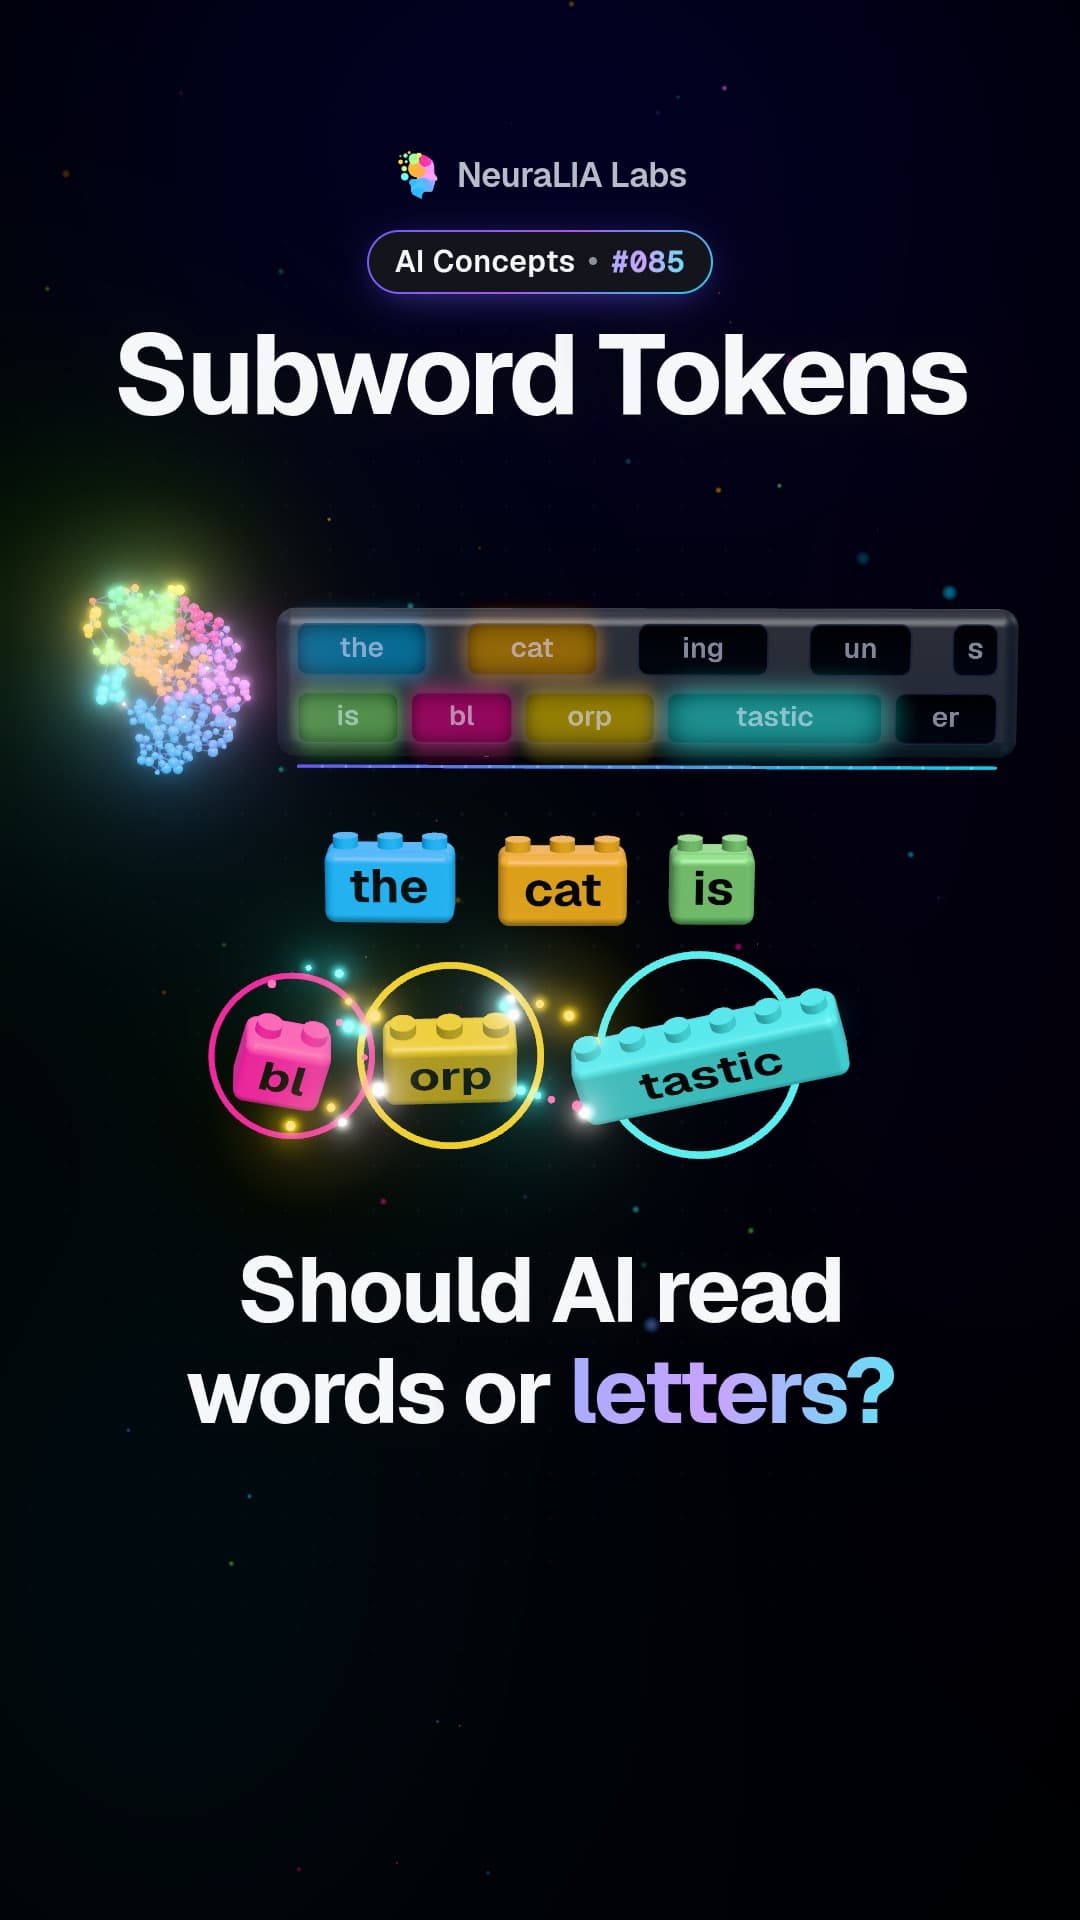 #085
Subword tokens: the middle ground between whole words and letters
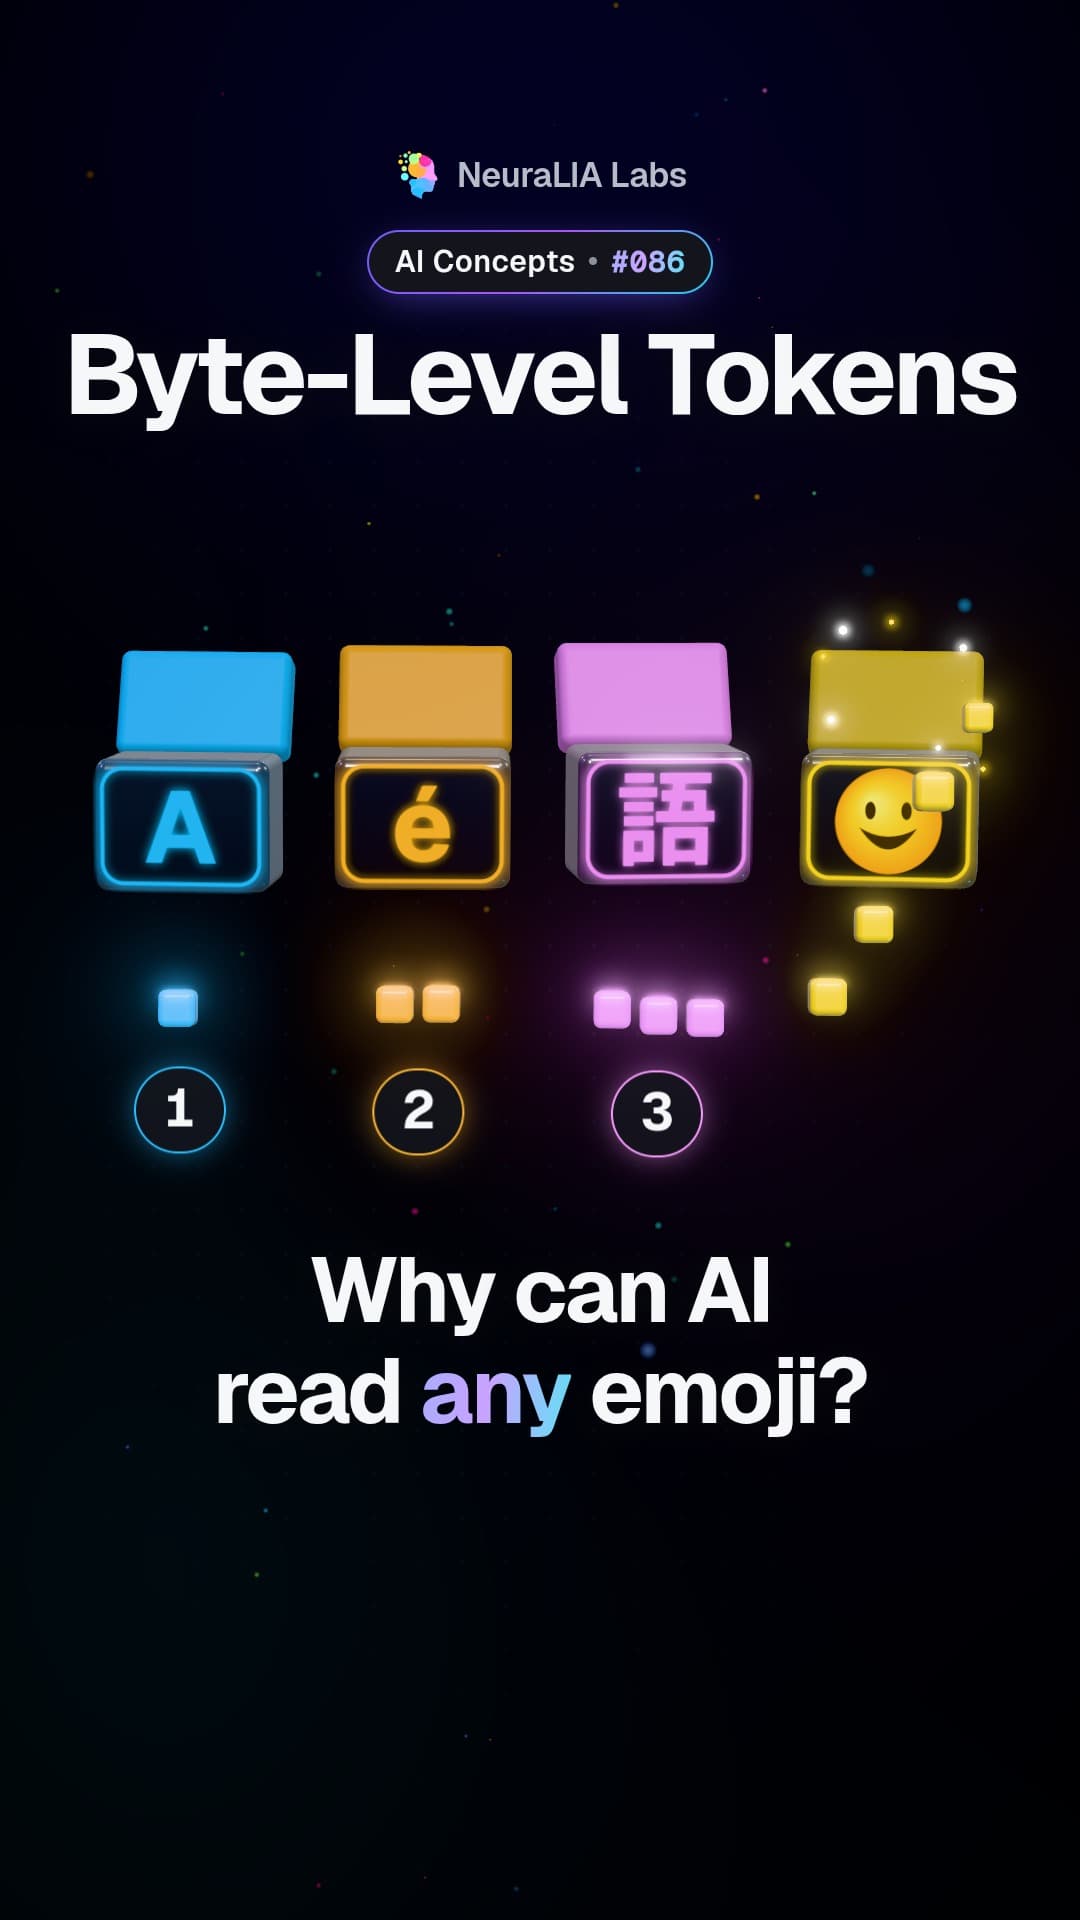 #086
Byte-level tokens: how AI can read any language, symbol or emoji
 #087
Byte-pair encoding: the 1994 compression trick that splits text for AI
 #088
Vocabulary size: how many text pieces an AI model should know
 #089
The token tax: why the same message costs more in some languages
 #090
Trailing space trap: why one invisible space can weaken an AI reply
 #091
Number tokenization: why AI reads digits in uneven chunks
 #092
Glitch tokens: the usernames that made AI models misbehave
 #093
WordPiece: why the most surprising pair beats the most common one
 #094
SentencePiece: how AI splits text in languages without spaces