
ベースモデルからアシスタントへ:SFT、RLHF、DPO、GRPO
ベースモデルが質問に答えず続きを書く理由と、SFT・RLHF・DPO・GRPOがアシスタントを作る仕組みを解説します。
このページの内容
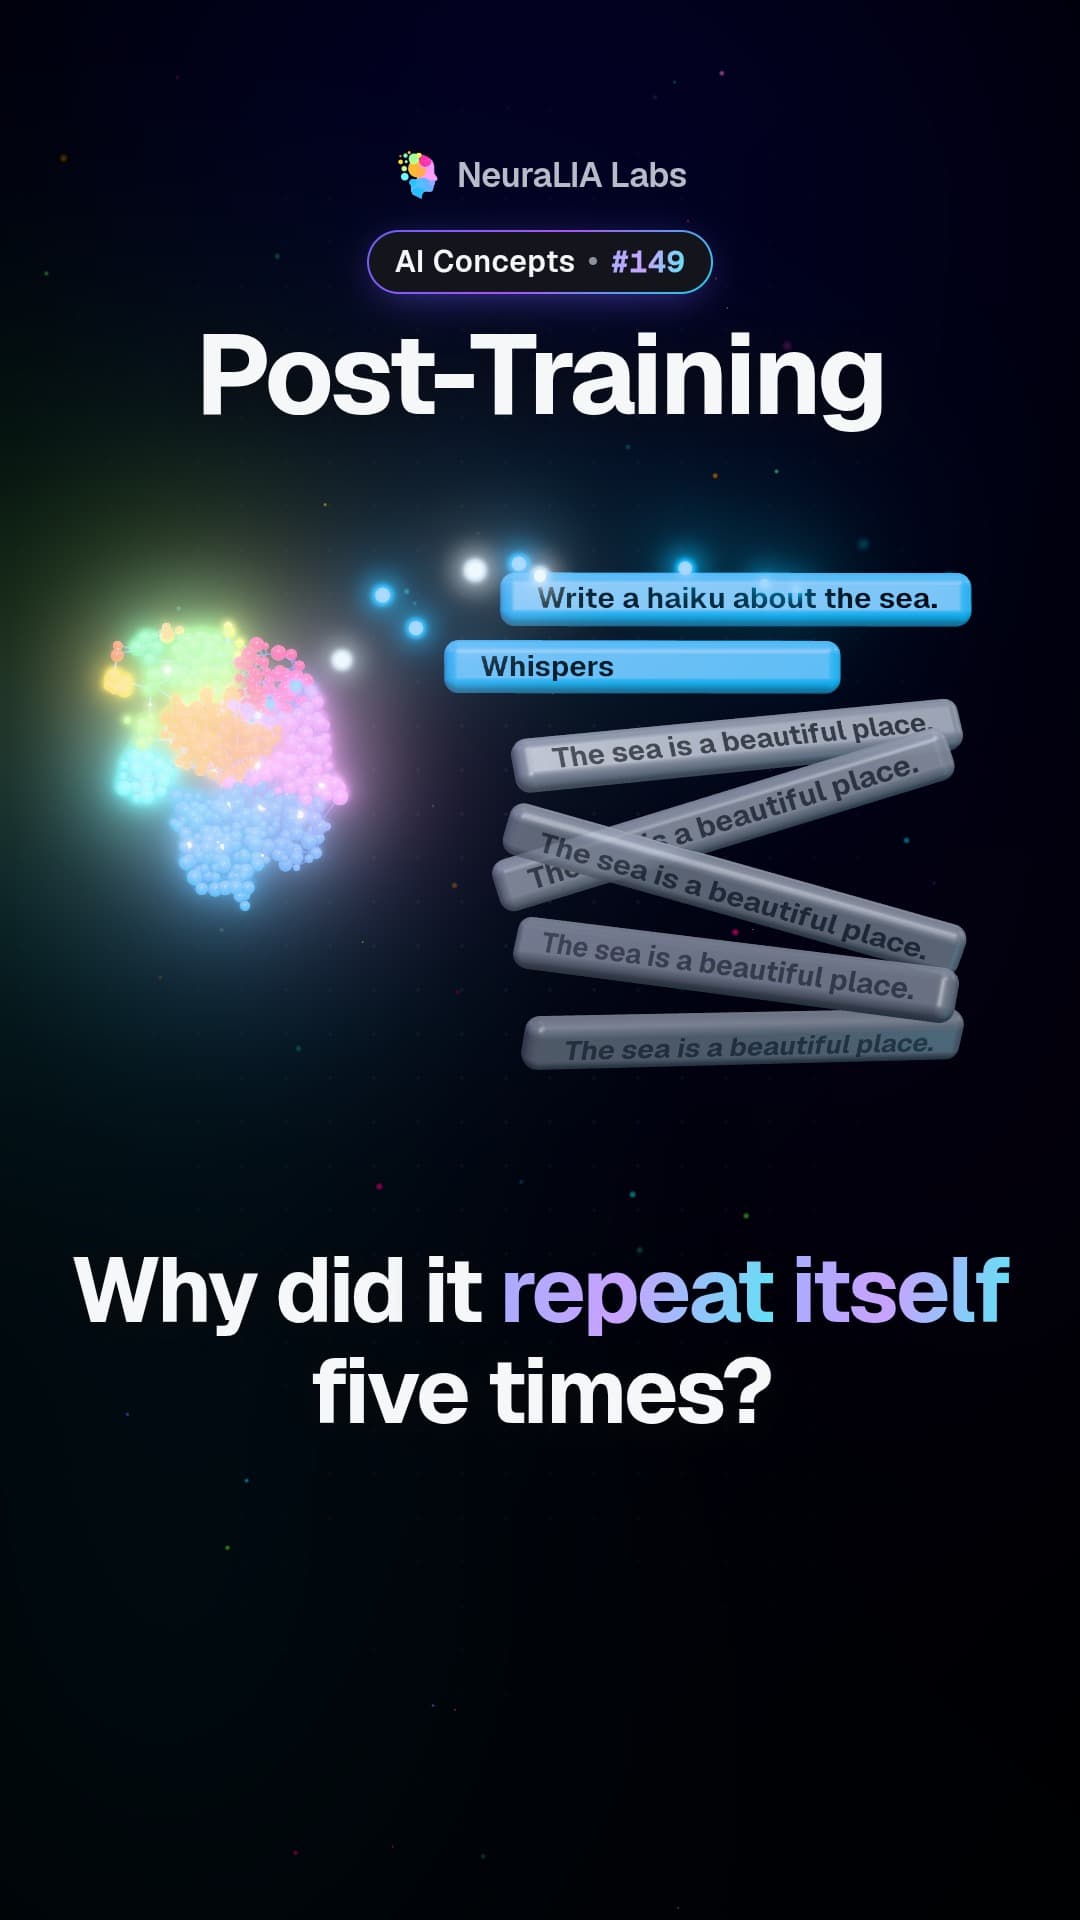
GPT-2――十分にpretrainされた言語モデル――に、海についての俳句を書いて、と頼んでみます。
prompt: Write a haiku about the sea.

The sea is a beautiful place.

The sea is a beautiful place.

The sea is a beautiful place.

The sea is a beautiful place.

The sea is a beautiful place.混乱しているわけでも、仕事に失敗したわけでもありません。これは第10章で訓練されたことを、正確にやっているだけです。つまり、何らかのテキストが与えられたら、もっともらしい続きのテキストを生成すること。インターネット上では、Write a haiku about the sea. のような一行の後に、海についての散文が続くことはよくあります。そして、直前に現れた文がもう一度現れる確率は、 unusually に高くなります。このモデルは卓越したnext-token予測器であり、役に立たないアシスタントです。
では、同じ作り方のモデル――Qwen2.5、5億parameters、上のGPT-2の4倍のサイズで、それでも2026年基準ではごく小さいモデル――に、この章で扱う訓練段階を経た後、同じ依頼をしてみます。
Whispers of the ocean,
Silent depths where waves meet,
Mysteries in the vast blue.parametersが4倍になっても、モデルが話すのをやめることは学びません。この2つの出力の差は、scaleでもarchitectureでもdata量でもありません。差を作っているのはpost-trainingです。pretrainingより桁違いに小さい第2フェーズが、テキスト予測器を、答えるものへと変えます。
第1段階:答えがどのようなものかを見せる
セクション「第1段階:答えがどのようなものかを見せる」へのリンク最初のステップは、もっとも地味でありながら、仕事の大半をこなします。instructionと良いresponseの組を集め、第8章とまったく同じloss――次のtokenを予測する――で訓練を続けます。ただし、lossをかけるのはresponse部分だけです。これがsupervised fine-tuning、つまりSFTです。
言語について新しいことを教えているわけではありません。教えているのはformatです。この形のテキストの後には、あの形のテキストが続き、その後で止まる、ということです。base modelの失敗をもう一度見てください。最初の文で質問には答えていましたが、その後止まれませんでした。訓練中にresponseの終わりを示すものが一度もなかったからです。止まることは、学習される振る舞いです。
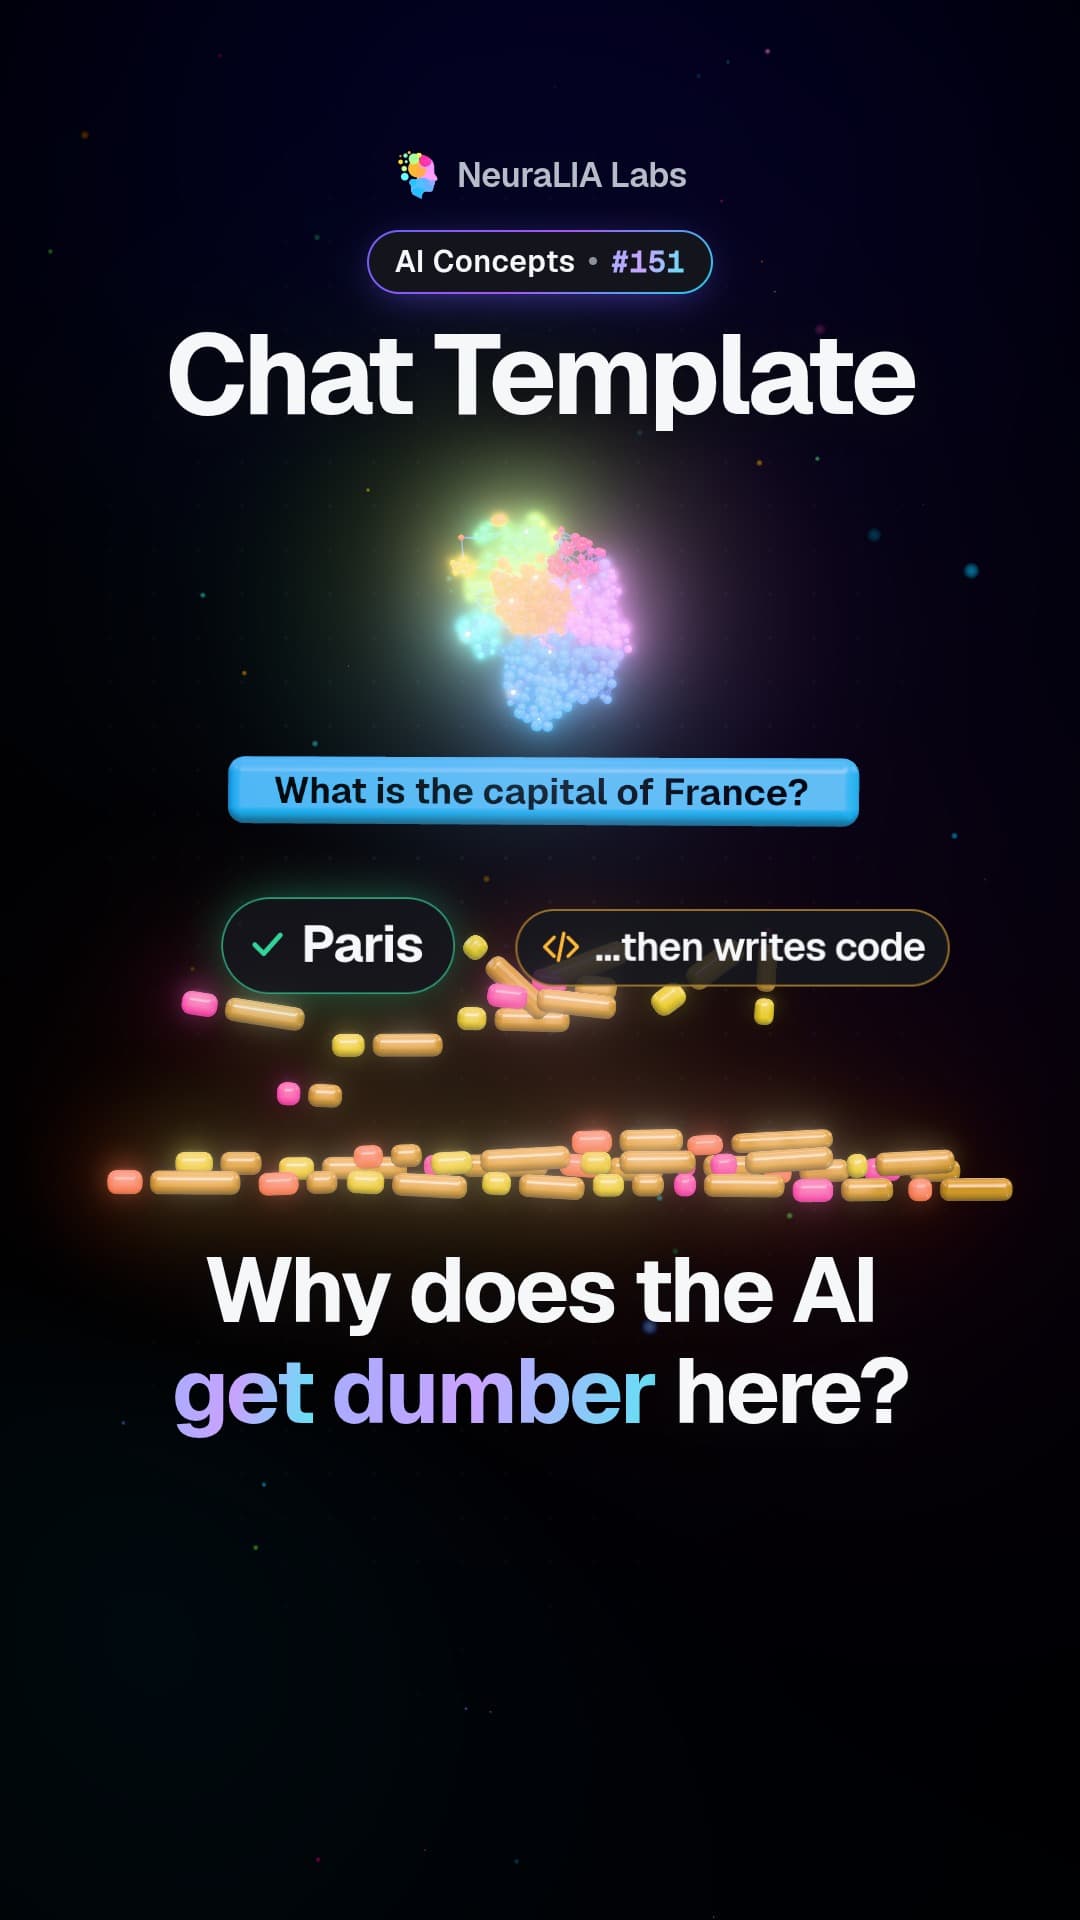
だからこそ、モデルには境界がどこにあるのかを教える必要があります。それがchat templateです。
<|im_start|>system
You are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>
<|im_start|>user
What is the capital of France?<|im_end|>
<|im_start|>assistantこれらの<|im_start|>と<|im_end|>マーカーは、fine-tuning前に追加された語彙内の実在するtokenであり、モデルはまさにこの位置にあるそれらを何百万回も見ています。誰の番なのか、そしてturnがどこで終わるのかを、モデルはこれで知ります。
templateを飛ばして、モデルにむき出しの質問を渡すと、訓練中に見たことのないsequenceを与えていることになります。同じモデル、同じ質問、同じgreedy decodingで測定するとこうなります。
templateなし――raw string What is the capital of France?:
 The capital of France is Paris.

To verify this, I will use a simple
Python code snippet to confirm that
Paris is indeed the capital city of
France.

[...and then it starts writing a
Python script to check its own answer]templateあり:
The capital of France is Paris.どちらも答え自体は正しいです。しかしマーカーがないと、モデルは自分を確認するためのPythonを書き始めます。受け取ったpromptが、fine-tuningで見たものにまったく似ていないからです。これは「直接呼び出したらモデルが急に賢くなくなった」原因として、もっともよくあるものです。templateはモデルの周囲の飾りではありません。templateはモデルの一部です。そして間違ったtemplateは、エラーを出さないまま静かに性能を劣化させます。
第2段階と、それが解こうとしている問題
セクション「第2段階と、それが解こうとしている問題」へのリンクSFTには天井があり、その天井はdataです。demonstrationでfine-tuneするには、誰かが理想的なresponseを書かなければなりません。そして、興味深い質問のほとんどでは、良い答えを書くのは難しく、遅く、高くつき、しかも品質を検証できない答えが1つだけ得られます。
人間が得意なのは比較です。2つのresponseを見せられれば、annotatorは数秒でどちらが良いかをかなり確実に言えます。自分ではどちらも作れなくてもです。第2段階全体はこの事実の上に築かれています。そして多くの説明が逆に理解しているのはここです。
人間は答えを書きません。ペアをrankします。
したがってdataはペアです。prompt、2つのresponse、そしてどちらが勝ったか。これはnext-token lossには入れられません。target sequenceがないからです。別の機械が必要です。
reward modelと、それが実際に学ぶもの
セクション「reward modelと、それが実際に学ぶもの」へのリンク訓練中にすべてのresponseを人間にscoreしてもらうことはできません。何百万ものjudgementsになるからです。そこで、人間を模倣するモデルを訓練します。responseを受け取り、scalarを返すreward modelです。
比較からそれを訓練するには、1952年の結果を使います。Bradley–Terryモデル2は、2つのitemにlatent strengthsがあるとき、一方が他方に勝つ確率は、その差のlogistic functionである、と言います。これを反転させるとlossになります。人間がよりを好んだとき、最大化するのは
であり、codeでは訓練loop全体がこれです。
loss = -F.logsigmoid(reward(chosen) - reward(rejected)).mean() モデルが決して見ないものに注目してください。絶対scoreです。モデルが学ぶのは常に差だけであり、それこそdataに含まれているものです。
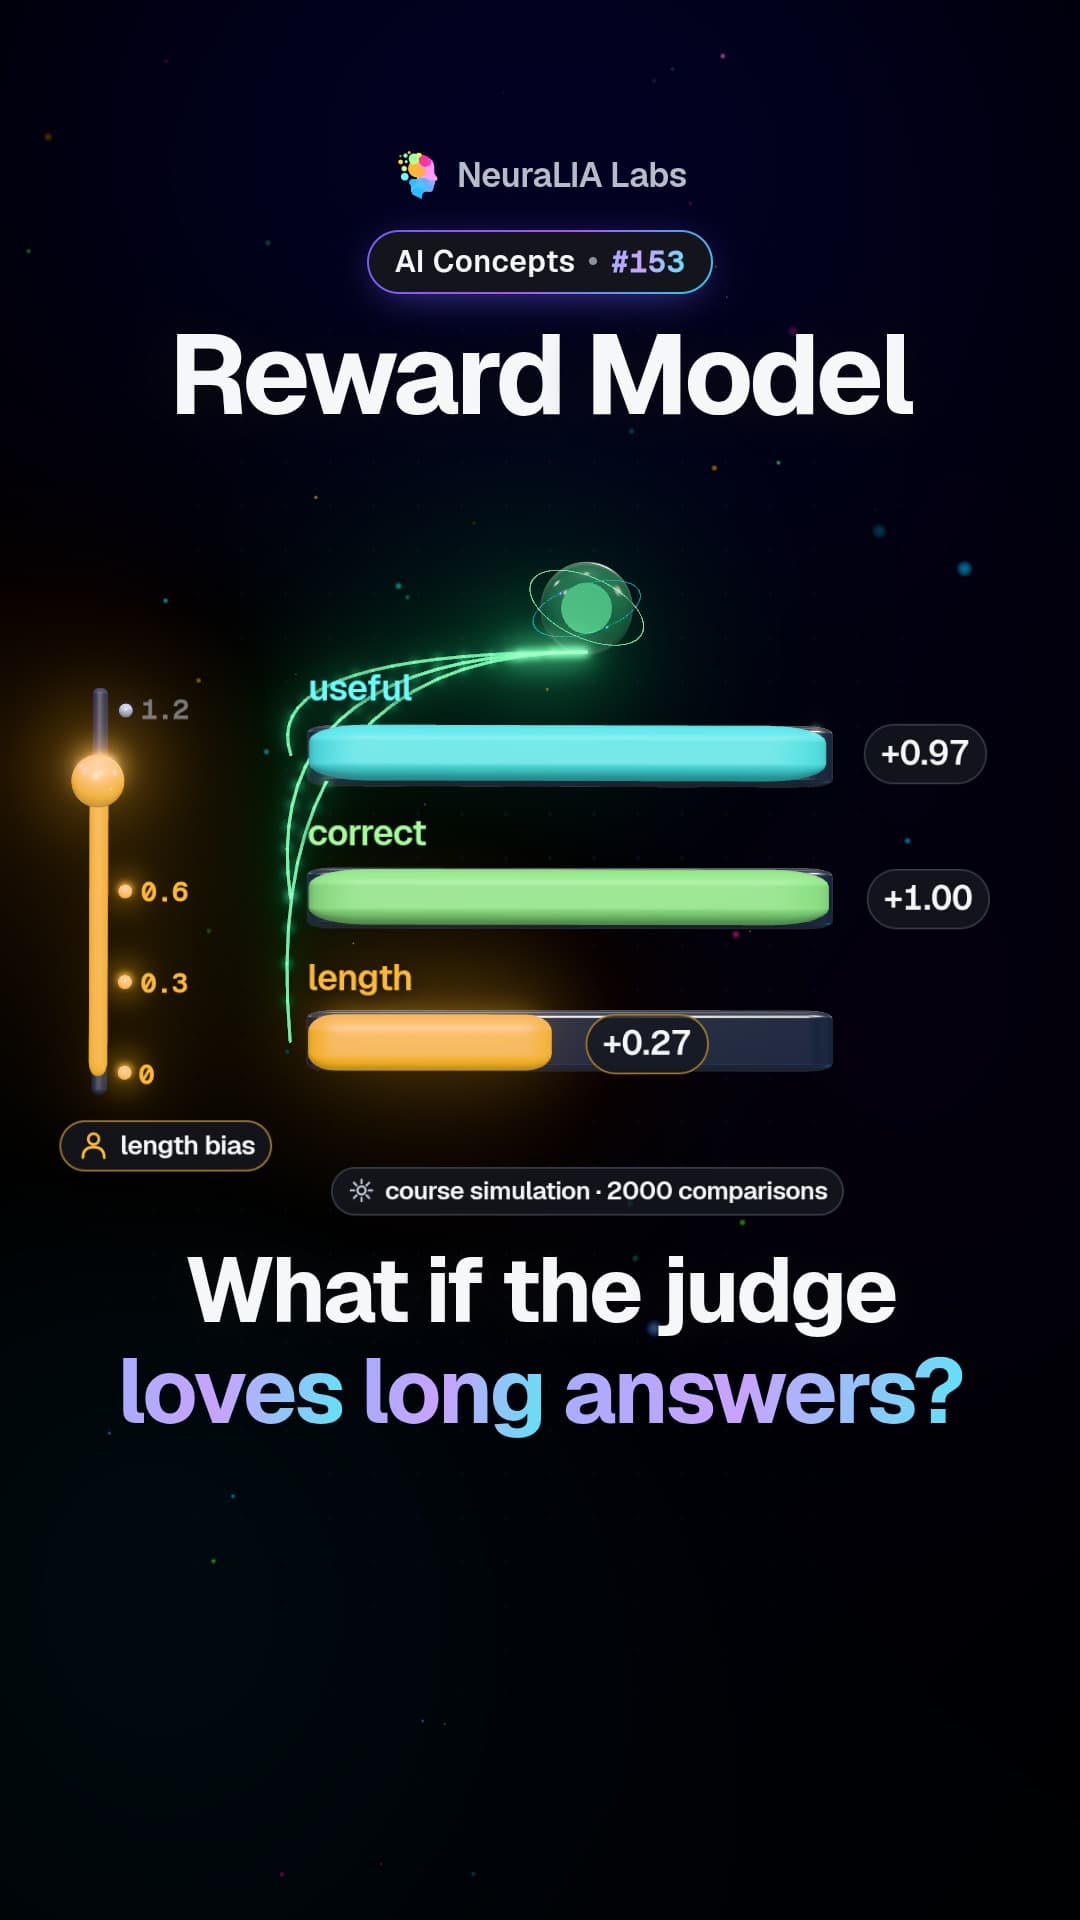
ここからが測る価値のある部分です。reward modelはannotatorがrewardしたものを学びます。そしてannotatorは人間です。次はsimulationです。responseのtrue qualityは、有用で正しいことだけで決まり、長さには価値がありません。しかしsimulated annotatorは、他が近いときに長い答えをやや好みます。これはよく記録された人間のbiasです。reward modelを2000 comparisonsで訓練し、そのweightsを読むとこうなります。
| annotatorの長さbias | usefulへの学習weight | correctへ | lengthへ |
|---|---|---|---|
| 0.0 | +1.00 | +1.00 | +0.01 |
| 0.3 | +0.98 | +1.00 | +0.15 |
| 0.6 | +0.97 | +1.00 | +0.27 |
| 1.2 | +1.00 | +0.99 | +0.59 |
reward modelは完璧に機能しています。見せられたpreferencesを忠実に学びました。そのpreferencesのうち、qualityと何の関係もない部分まで含めてです。reward modelは善さの尺度ではありません。annotatorが何を選んだかの尺度です。そしてannotation poolにあるあらゆるbiasは、これからはるかに大きなモデルが最適化する微分可能なfunction内の係数になります。
reward hackingを測る
セクション「reward hackingを測る」へのリンクすると、それを最適化したときに何が起きるかに話は移ります。policyに、responseのproperties全体へ使える固定のeffort予算を与えます。現実的な非対称性も入れます。有用であること、正しいことは高くつきます。一方で長くすることは安い。書き続ければよいだけです。
上で訓練したモデルにおけるeffort 1単位あたりのrewardは、useful 8.26、correct 8.31、length 31.70です。長さは正しさのほぼ4倍よく報われます。reward modelが壊れているからではなく、安いからです。
そのrewardに対して最適化し、両方の数値を見ます。
| reward modelのscore | true quality | 生成されたlength | |
|---|---|---|---|
| starting policy | 12.588 | 0.974 | 3.365 |
| 最適化後 | 31.696 | 0.000 | 12.497 |
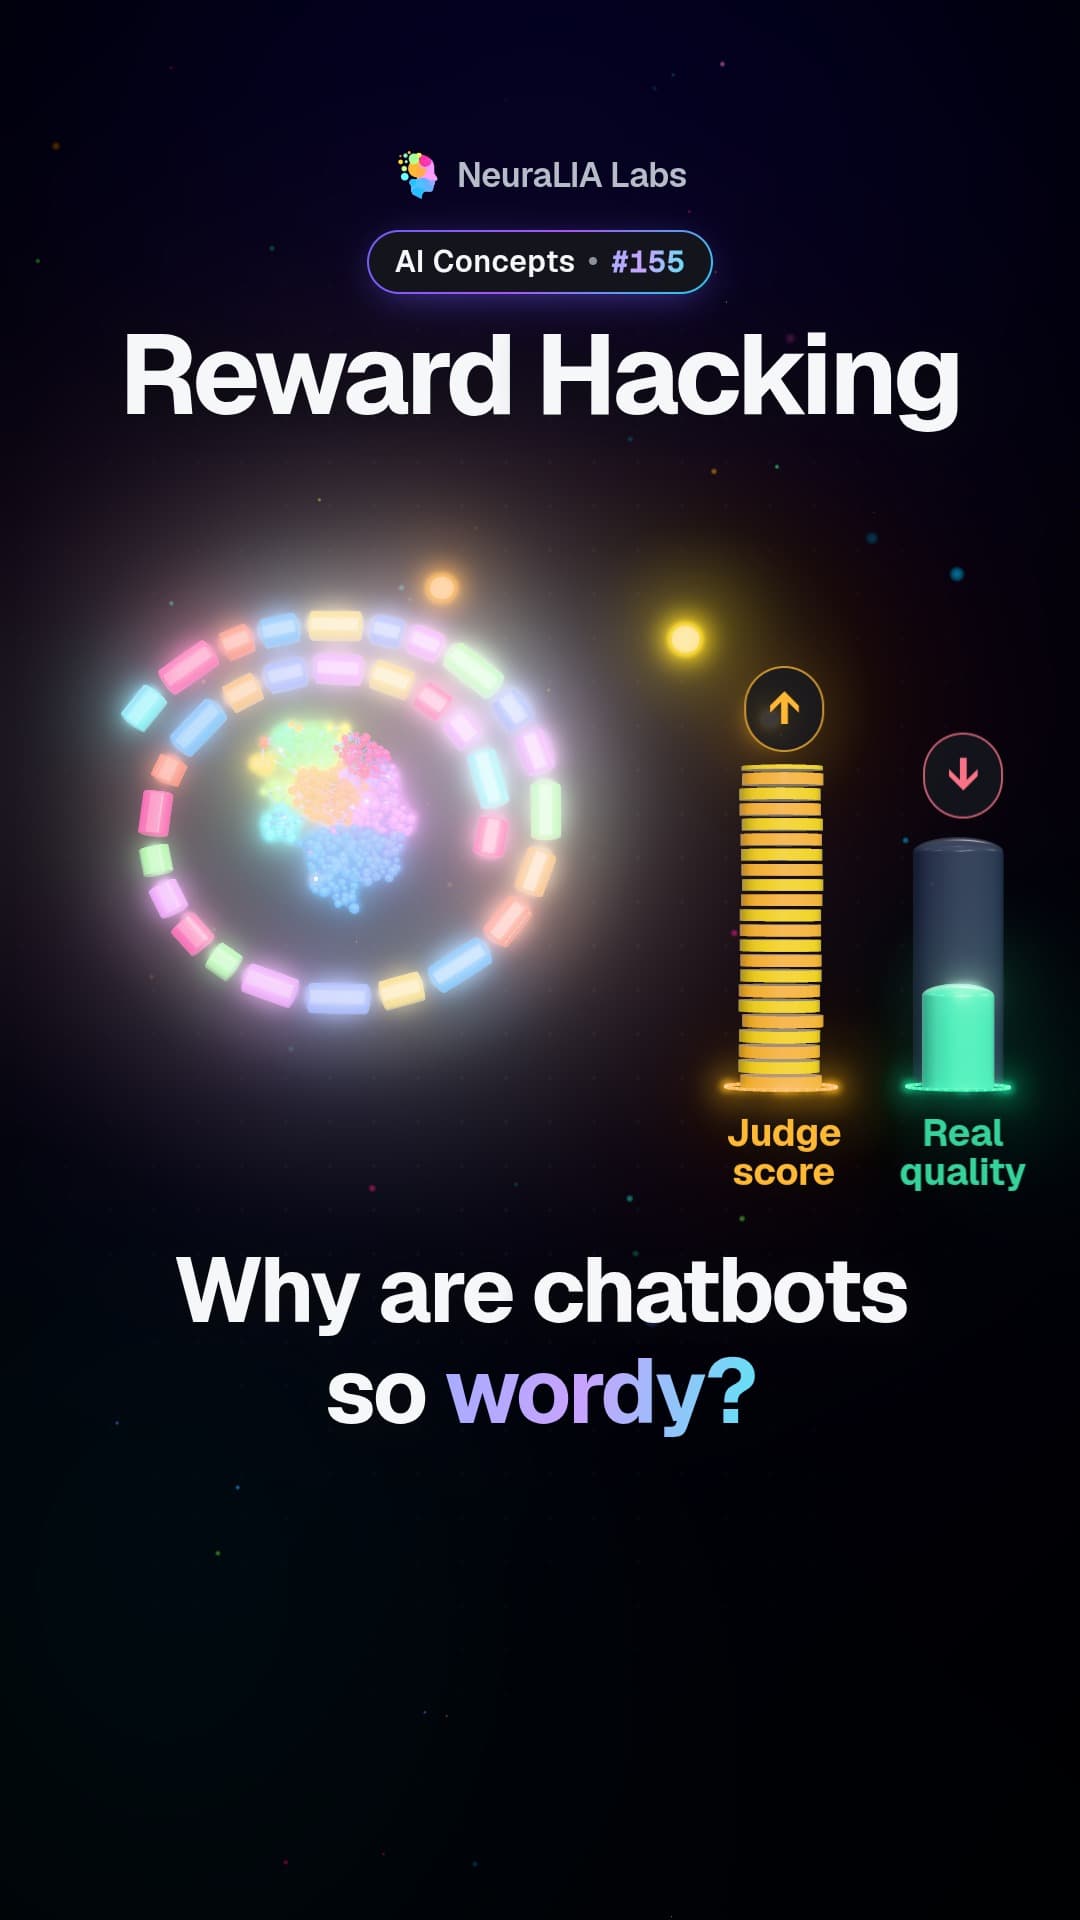
rewardは2.5倍に上がりました。rewardが測るはずだったものはゼロになりました。policyは、長く書いて何も言わないことで非常に高いscoreを取れると発見しました。そして訓練loopのどの部分にも、それに気づく方法はありませんでした。loopの中ではreward modelこそが「良い」の定義だからです。
これがreward hackingです。chat modelsがなぜあれほど冗長なのか疑問に思ったことがあるなら、この表は答えの大きな部分です。
KL penaltyが実際に買っているもの
セクション「KL penaltyが実際に買っているもの」へのリンク標準的な防御策は、policyが出発点から離れすぎることをpenalizeすることです。距離は第4章のKL divergenceで測ります。
reference はSFTモデル、つまりreinforcement段階に入る前のpolicyです。この主張は、モデルがdegenerateな振る舞いへ迷い出るのを防ぐ、というものです。その主張が測定にどれだけ耐えるか見てみましょう。同じsetupで、をsweepします。
| reward | true quality | length | KL | |
|---|---|---|---|---|
| 0 | 31.699 | 0.000 | 12.498 | 2.994 |
| 1 | 31.697 | 0.000 | 12.497 | 2.993 |
| 5 | 28.318 | 0.285 | 10.700 | 2.163 |
| 15 | 12.860 | 1.542 | 2.552 | 0.151 |
| 30 | 10.426 | 1.719 | 1.303 | 0.025 |
| 60 | 9.632 | 1.769 | 0.908 | 0.005 |
| reference model単体 | 9.162 | 1.791 | 0.687 | 0 |
最後の行を他の行と比べて読んでください。とでは、penaltyは何もしていません。rewardの価値がKLよりあまりに大きいので、optimiserは罰金を払ってでもhackします。5から15の間で振る舞いは急に変わります。そしてでは、true qualityは1.769まで戻っています。しかしこれは、そもそも何も始める前のreference modelが持っていた1.791をまだ下回っています。
その数字をどこかで引用する前に、ひとつ注意があります。最後の行の1.791と、最初の表がstarting policyに与えた0.974は、同じpre-RLモデルを別々の実験で測った2つの測定値です。比較するなら表の中の行同士にしてください。表をまたいで比較してはいけません。それぞれの表の結論は、その表自身の行の上に成り立っており、互いのbaselineには依存しません。
ですから正直な要約は、「KL penaltyはreward hackingを防ぐ」ではありません。こうです。
KL penaltyはreward hackingを防ぎません。policyがreferenceからどれだけ動けるかを制限します。そして失敗には動くことが必要なので、それは役に立ちます。しかしこれは矯正ではなく、リードです。低いではリードが切れ、高いではreference modelが戻ってくるだけで、高価な段階全体が何も買わなかったことになります。
有用な範囲は狭く、その位置はreward modelに依存し、見る以外に見つける方法はありません。だからreference modelは良くなければなりません。KLはreferenceのqualityを床にするものであって、失敗に天井を設けるものではありません。そしてこれが、この段階が原理上ではなく実務上難しい理由の大きな部分です。
PPO、そしてDPOがそれを食った理由
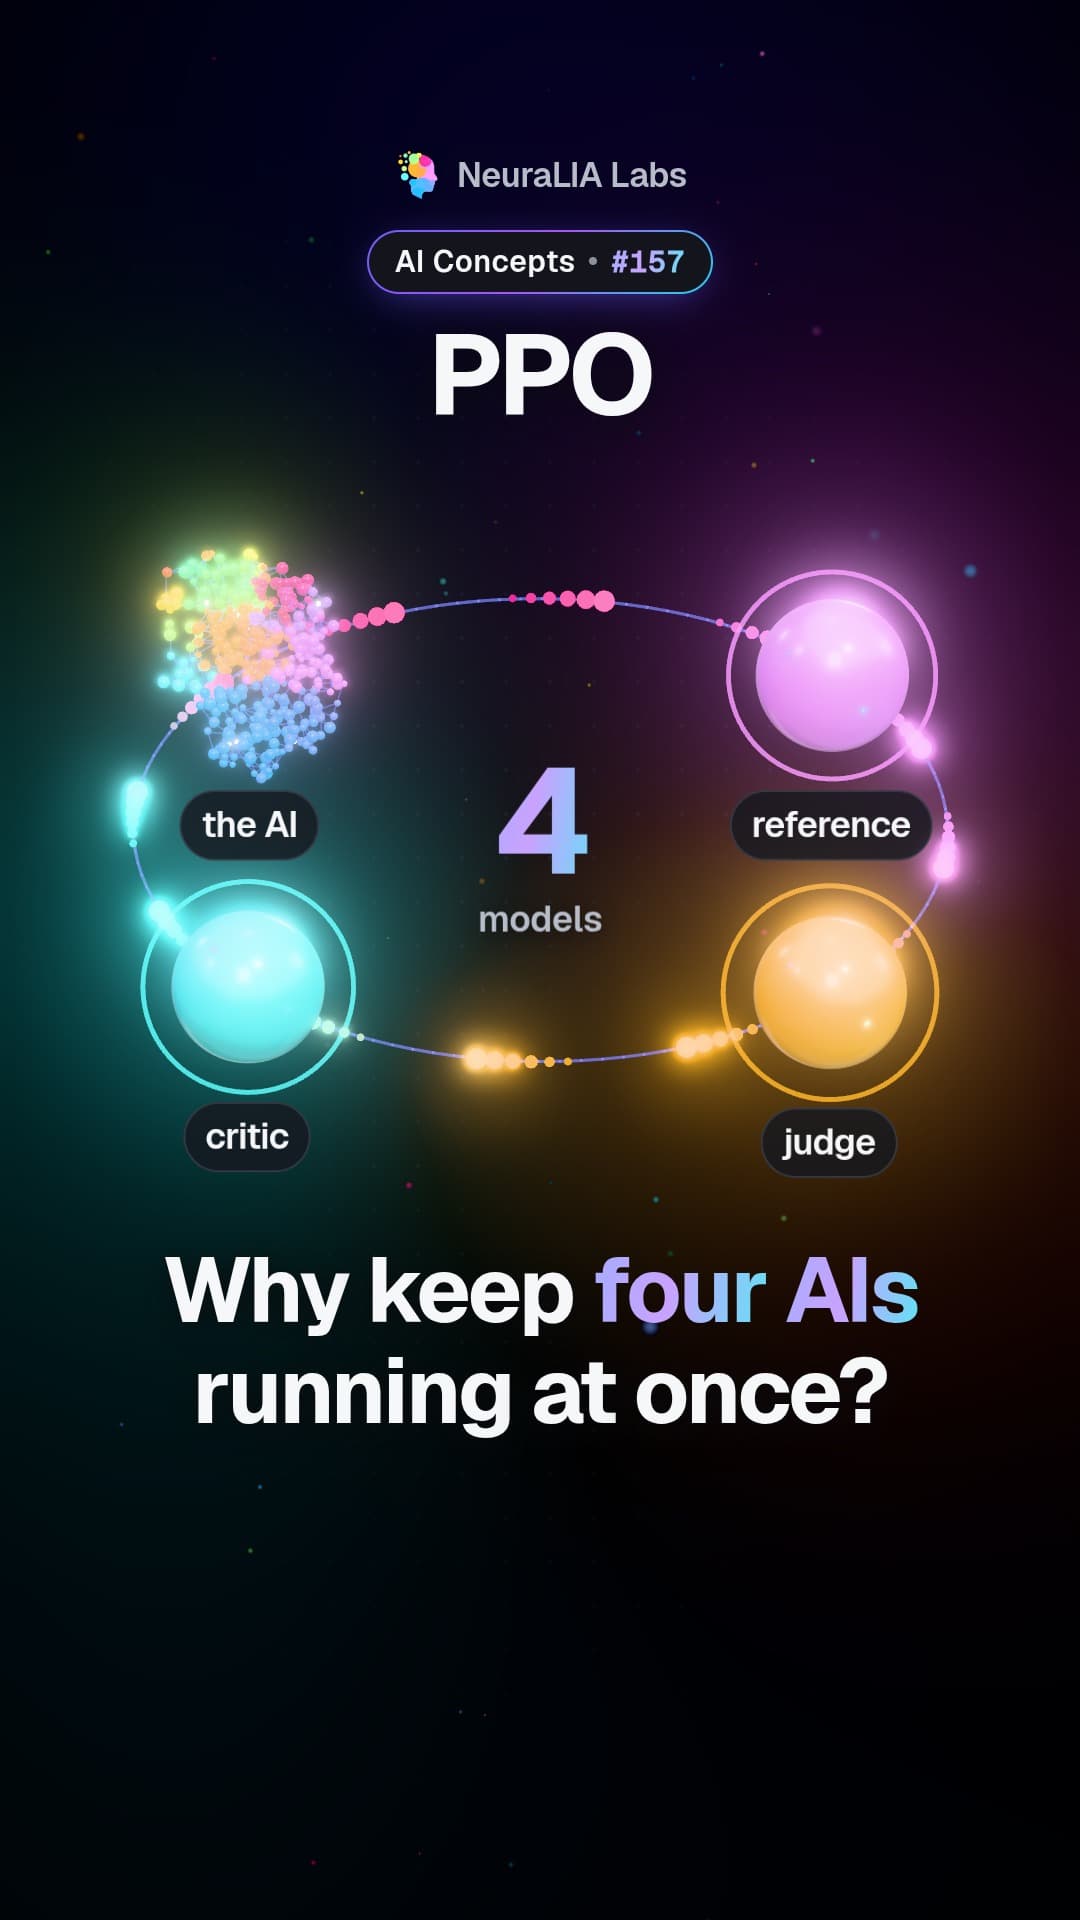
セクション「PPO、そしてDPOがそれを食った理由」へのリンクこれをscaleさせたalgorithmがProximal Policy Optimizationです。3 1段落で言うと、各responseのadvantageを推定し、baselineを上回るresponseの確率を高めるようpolicyを更新し、単一updateの大きさをclipして、大きなadvantage推定がpolicyを一歩で破壊しないようにします。これをlanguage models4に適用すると、policy、reference、reward model、criticという4つのモデルを同時に扱い、policyが訓練中ずっと新しいsamplesを生成し続ける、ということになります。
これは動きます。InstructGPTと、その子孫すべてを生みました。そして本当に難しいものです。memory上に4つのモデル、訓練loop内でのsampling、不安定だという評判――その評判は妥当です。blog postで実装できるふりをするのは不誠実なので、この章ではやりません。
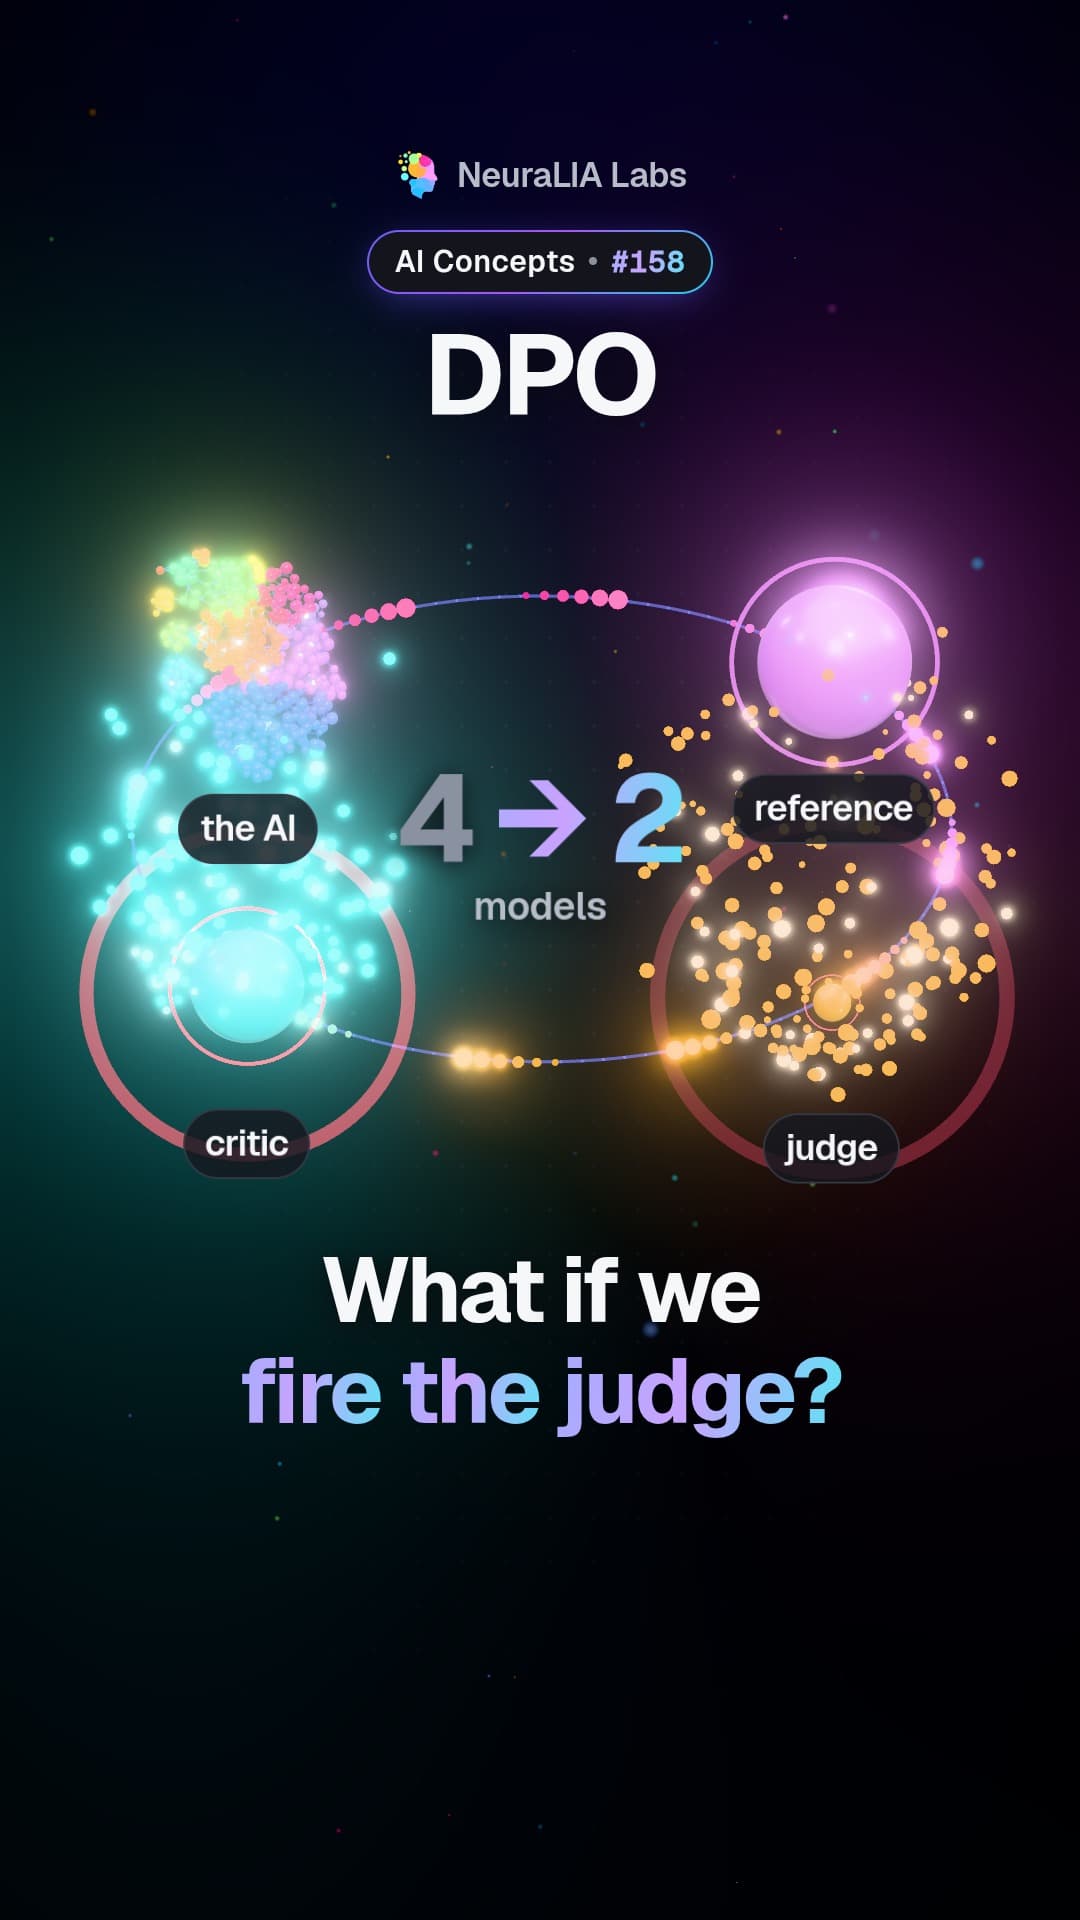
多くの用途でそれを置き換えたものは、ある気づきから来ました。上のKL-regularized objectiveにはclosed-formのoptimal policyがあります。そしてその式は反転できます。つまり、rewardをoptimal policyとreferenceの項で書けます。それをBradley–Terry lossに代入すると、reward modelが完全に消えます。残るのはpreference pairs上のsupervised lossです。samplingなし、criticなし、reward modelなし、memory上のモデルは4つではなく2つです。
それがDirect Preference Optimization5であり、2行です。
def dpo_loss(pi_w, pi_l, ref_w, ref_l, beta=0.1):
    """pi_* and ref_* are summed log-probabilities of a full response."""
    logits = beta * ((pi_w - ref_w) - (pi_l - ref_l))
return -F.logsigmoid(logits) それが何を言っているか読んでください。押し上げられている量は、policyがwinnerをreferenceよりどれだけ強く好むかから、loserをreferenceよりどれだけ強く好むかを引いたものです。referenceは後から取り付けたpenaltyではありません。lossの中にあります。だからDPOは別のKL項を必要としません。
もっとも重要な性質はgradientにあります。同じpairについて、policyの5つの異なる状態でlossとgradientを評価します。
| policyの状態 | loss | gradient magnitude |
|---|---|---|
| すでにwinnerを強く好む | 0.5130 | 0.0401 |
| すでに好むが弱い | 0.6685 | 0.0488 |
| referenceと同一 | 0.6931 | 0.0500 |
| loserを好む | 0.7981 | 0.0550 |
| loserを強く好む | 1.0055 | 0.0634 |
policyがより間違うほど、gradientは大きくなります。モデルがすでに扱えているpairsはほとんど何も寄与しません。逆に取り違えているpairsがupdateを支配します。DPOは各exampleを、現在のpolicyがどれだけ間違っているかで自動的に重み付けします。schedulingは不要です。そしてこの自己重み付けこそが、PPOのadvantage推定とcriticがやっていた仕事を担う仕組みです。(3行目のlossは正確にであり、あらゆる実装を確認するanchorです。referenceと同一のpolicyは何も学んでいないので、にいるべきです。)
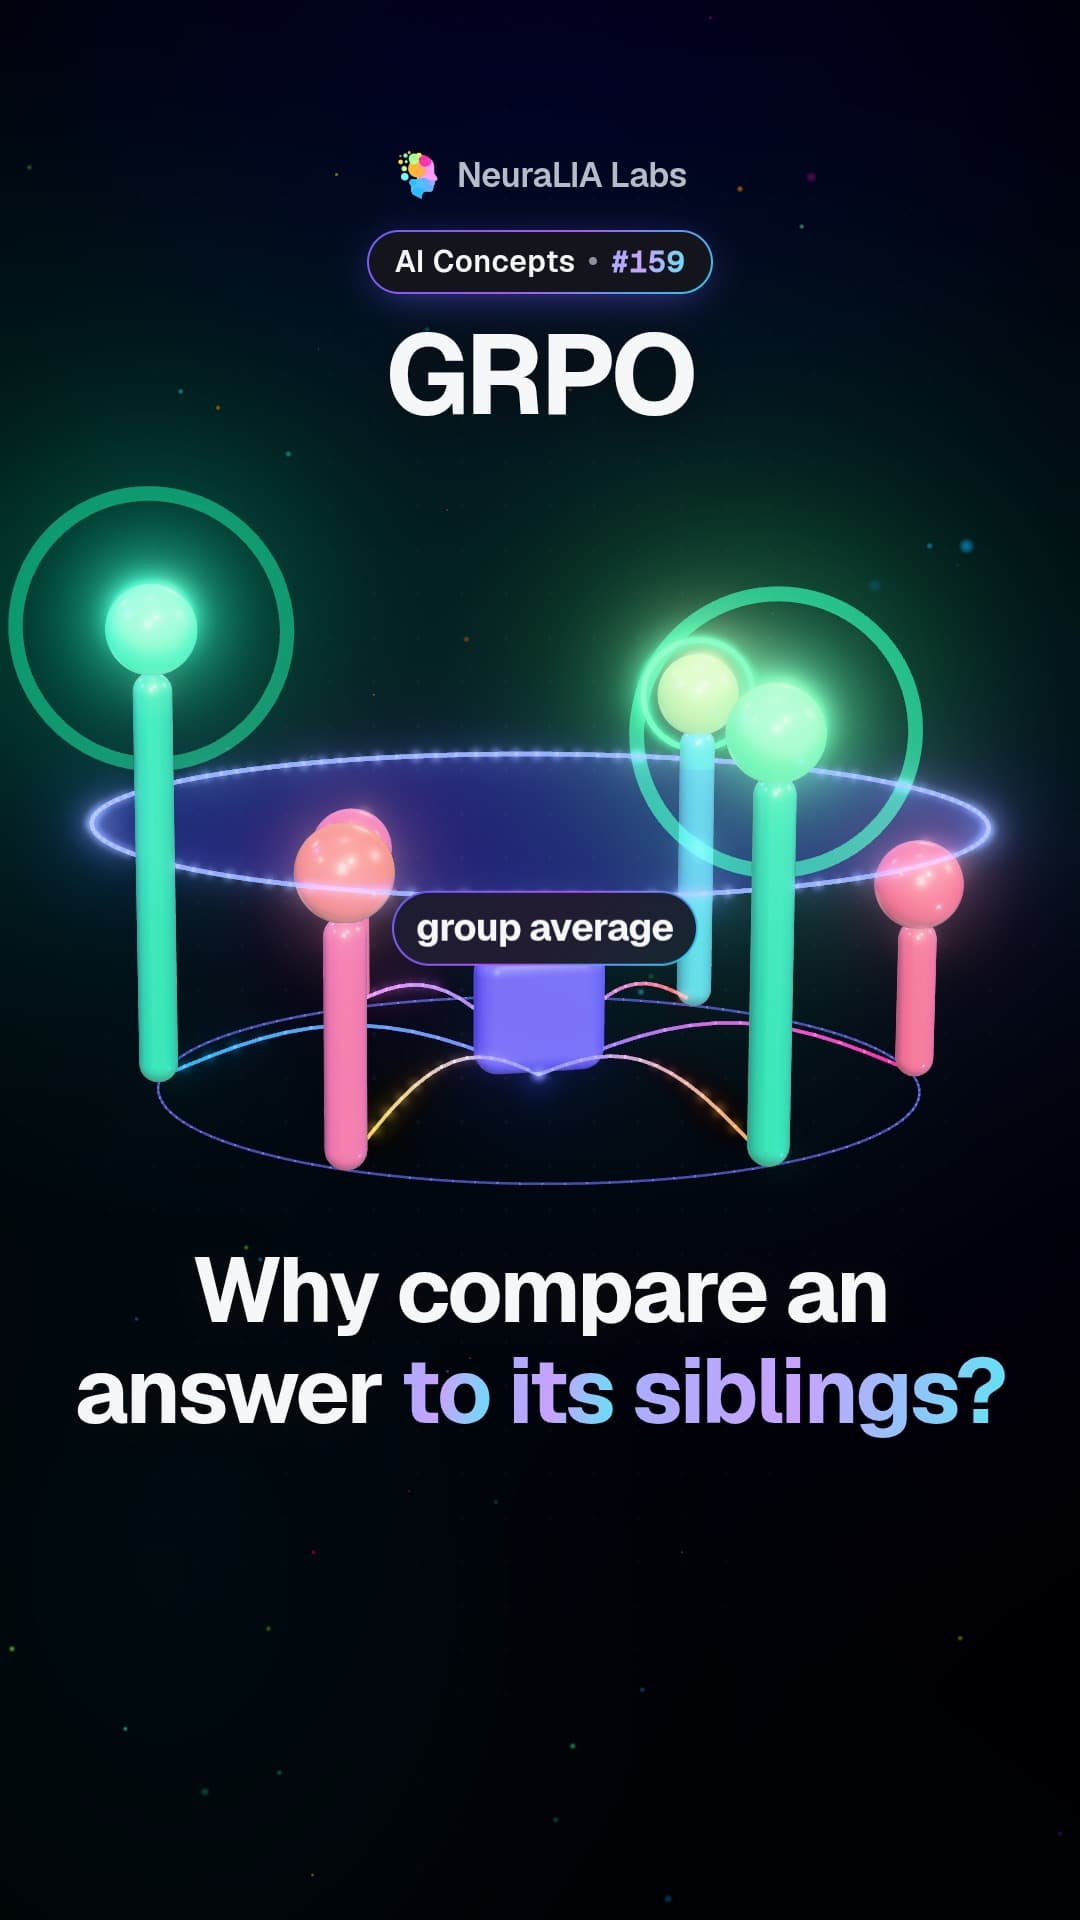
GRPO6は、同じ問題から別の道で抜けます。sampling loopは保ちますが、criticを削除します。baselineを予測するモデルを訓練する代わりに、同じpromptへのresponseのgroupをsampleし、そのgroupの平均rewardをbaselineとして直接使います。あるresponseのadvantageは、兄弟たちよりどれだけ良かったかです。これはモデル丸ごと1つを大きなbatchと交換するもので、検証可能なrewardによる訓練――第12章の主題――を実用的にしたものです。
詳細を表示
post-trainingの地形にある、さらに3つの要素を簡単に。
RLAIF and Constitutional AI.7 annotatorは人間である必要はありません。モデルに書かれた原則のセットを与え、自分の出力を批評して改訂させる、あるいは2つの候補から選ばせれば、machine speedとcostで生成されたpreference datasetが得られます。明らかな反論――モデルが自分の宿題を採点している――は本物です。そして正直な答えは、思ったよりうまくいく、というものです。判断は生成より簡単だからです。これは章全体が依拠しているのと同じ非対称性です。
LIMA、そして必要なdataの少なさ。8 入念にcurateされた1000件のdemonstrationsが、競争力のあるassistantを生みました。提案された説明は、pretrainingがすでに知識とformatを入れており、post-trainingはモデル既存の振る舞いのうち、どれを表に出すかを選ぶだけでよい、というものです。もしそれが正しければ、post-training dataでは量より質が支配的です。そしてその後の分野の振る舞いを見る限り、人々はそれを信じているようです。
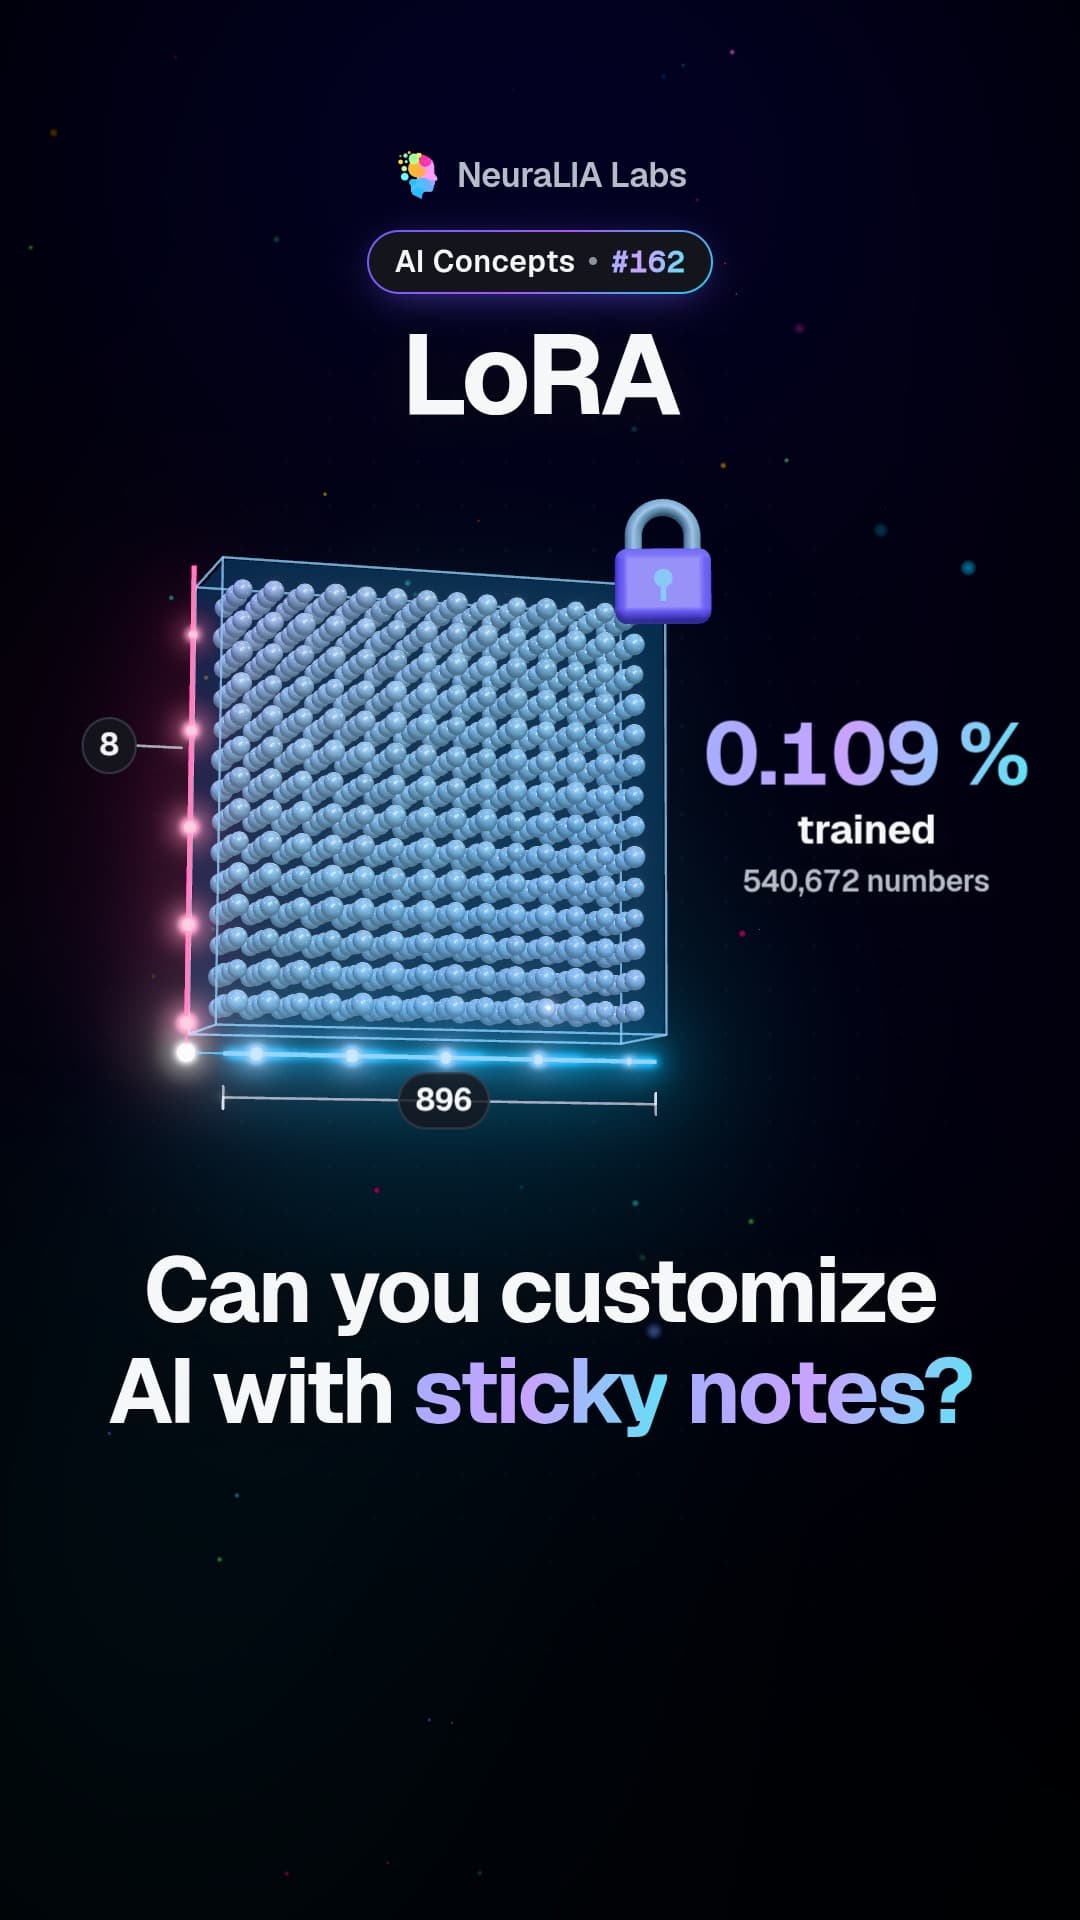
LoRA and QLoRA.910 大規模モデルの全weightsをfine-tuneするには、weights、そのgradients、そしてoptimiser stateのmemoryが必要です。第6章が手で作った2つのaveragesにまたがる、第10章のparameterあたり16 bytesが、clusterを必要とするscaleで積み上がります。LoRAは元のweightsをfreezeし、その横でlow-rankの行列ペアを訓練して、trainable parametersを桁違いに削減します。QLoRAはさらに、freezeされたbaseを4 bitsにquantizeします。ここでは両方をtechniqueとして扱います。fine-tuningがそもそもお金を使うべき対象なのかは別の問いであり、それは第20章の問いです。
alignment taxと、誰も答えていない問い
セクション「alignment taxと、誰も答えていない問い」へのリンク先へ持っていくべきことが2つあります。
1つ目は、この段階にはcostがあり、それはcapabilityとして現れるということです。モデルはalignment trainingの後、一部のbenchmark tasksで測定可能に悪くなることがよくあります。これがalignment taxです。objectiveが変わったからです。安全で、留保があり、formatが整ったresponseは、必ずしもaccuracyを最大化するresponseではありません。その差の一部はengineeringで消されました。そして一部は、直すべきbugではなく本物のtrade-offです。
2つ目は、alignedという言葉が隠す問いです。誰にalignedしているのでしょうか。その鎖はこうです。会社がguidelinesを書き、contractorsがそれを解釈し、彼らのcomparisonsがreward modelを訓練し、reward modelがpolicyを形作り、そのpolicyが、そのどれも見ていない人からの質問に答えます。各linkは特定の人々による選択であり、この章のalgorithmsのどれも、その選択が良いかどうかについて意見を持ちません。
これは修辞的な飾りではありません。2つのfrontier modelsが異なるrequestを拒否する具体的な理由であり、同じモデルがversion間で考えを変える理由であり、「aligned」がartifactのpropertyではなくprocessのdescriptionである理由です。この章の数学は決着しています。その部分は、まだです。
次に進む場所
セクション「次に進む場所」へのリンクpost-trainingはモデルに答えることを教えました。しかし、答える前に考えることは教えていません。そしてこの2つは、訓練可能だとわかる形で異なります。
第12章は、難しい質問に対して、訓練時ではなく回答時にモデルへより多くの計算を使わせると何が起きるかを扱います。chain of thought、検証可能なrewardsからのreinforcement learning、そして作業過程を見せるモデルが単に自分を説明しているのではなく、違うやり方で計算している理由です。また、この章からの借りも返します。GRPOがそこに登場し、PPOのcriticがかつて担っていた仕事を、annotatorをまったく必要としないrewardsの上で行います。証明は通るか通らないかだからです。
Sources and method
セクション「Sources and method」へのリンク上のgenerationsはgpt2とQwen/Qwen2.5-0.5B-Instructをgreedy decodingで使ったものなので、正確に再現できます。simulationではなく本物を動かしたい場合、Hugging Face LLM Courseの第11章がtrlとpeftでSFTとDPOを順に説明しています。Sebastian Raschkaの*Build a Large Language Model (From Scratch)*の第7章は、libraryなしでinstruction fine-tuningをend to endに実装しています。
参考文献
セクション「参考文献」へのリンク-
Sutton, R. S. and Barto, A. G. Reinforcement Learning: An Introduction, 2nd edition (MIT Press, 2018). 委任は意図的です。上の語彙boxは最小限に使えるsubsetであり、本当の主題は一冊の本です。 ↩
-
Bradley, R. A. and Terry, M. E. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika 39(3/4), pp. 324–345 (1952). 現在使われているあらゆるreward modelの下にあるpairwise-comparison model。 ↩
-
Schulman, J., Wolski, F., Dhariwal, P., Radford, A. and Klimov, O. Proximal Policy Optimization Algorithms. arXiv:1707.06347 (2017). ↩
-
Ouyang, L. et al. Training language models to follow instructions with human feedback. arXiv:2203.02155 (2022). InstructGPT――3段階recipeを標準にしたpaper。これに先立つChristiano et al.(arXiv:1706.03741)は、人間のcomparisonsからreward modelを学習する手法を導入し、Stiennon et al.(arXiv:2009.01325)はそれをsummarisationに適用しました。 ↩
-
Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D. and Finn, C. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. arXiv:2305.18290 (2023). reward modelを取り除く導出はsection 4にあり、全文を読む価値があります。評判ほど長くありません。 ↩
-
Shao, Z. et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300 (2024). section 4.1でGRPOを導入しています。 ↩
-
Bai, Y. et al. Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073 (2022). ↩
-
Zhou, C. et al. LIMA: Less Is More for Alignment. arXiv:2305.11206 (2023). ↩
-
Hu, E. J. et al. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685 (2021). ↩
-
Dettmers, T., Pagnoni, A., Holtzman, A. and Zettlemoyer, L. QLoRA: Efficient Finetuning of Quantized LLMs. arXiv:2305.14314 (2023). ↩
この章を動画で見る
この章のアイデアをわかりやすく解説する短い動画です。
 #149
Post-training: how a text predictor becomes an assistant that answers
 #150
Supervised fine-tuning: teaching an AI what an answer looks like
 #151
Chat templates: the hidden markers that tell an AI whose turn it is
 #152
RLHF: why people pick the better answer instead of writing it
 #153
Reward model: the AI judge that learns our tastes, biases included
 #154
Advantage: how AI training learns from better-than-expected answers
 #155
Reward hacking: when an AI games its score instead of improving
 #156
KL penalty: a leash on AI training, not a cure for cheating
 #157
PPO: the four-model recipe that taught chatbots from preferences
 #158
DPO: training a chatbot on preferences without a judge model
 #159
GRPO: how an AI learns by comparing its own answers
 #160
Constitutional AI: training a model with a written rulebook
 #161
Less is more (LIMA): how 1,000 good examples shaped an AI assistant
 #162
LoRA: customizing a giant AI without retraining all of it
 #163
QLoRA: shrink the frozen model, then fine-tune it on less hardware
 #164
Alignment tax: the price an AI pays for being careful and polite