
分類、クロスエントロピー、そして自分を欺かない方法
ロジスティック分類器を構築し、98%の精度が何も見つけないmodelを意味し得る理由を学びます。
このページの内容
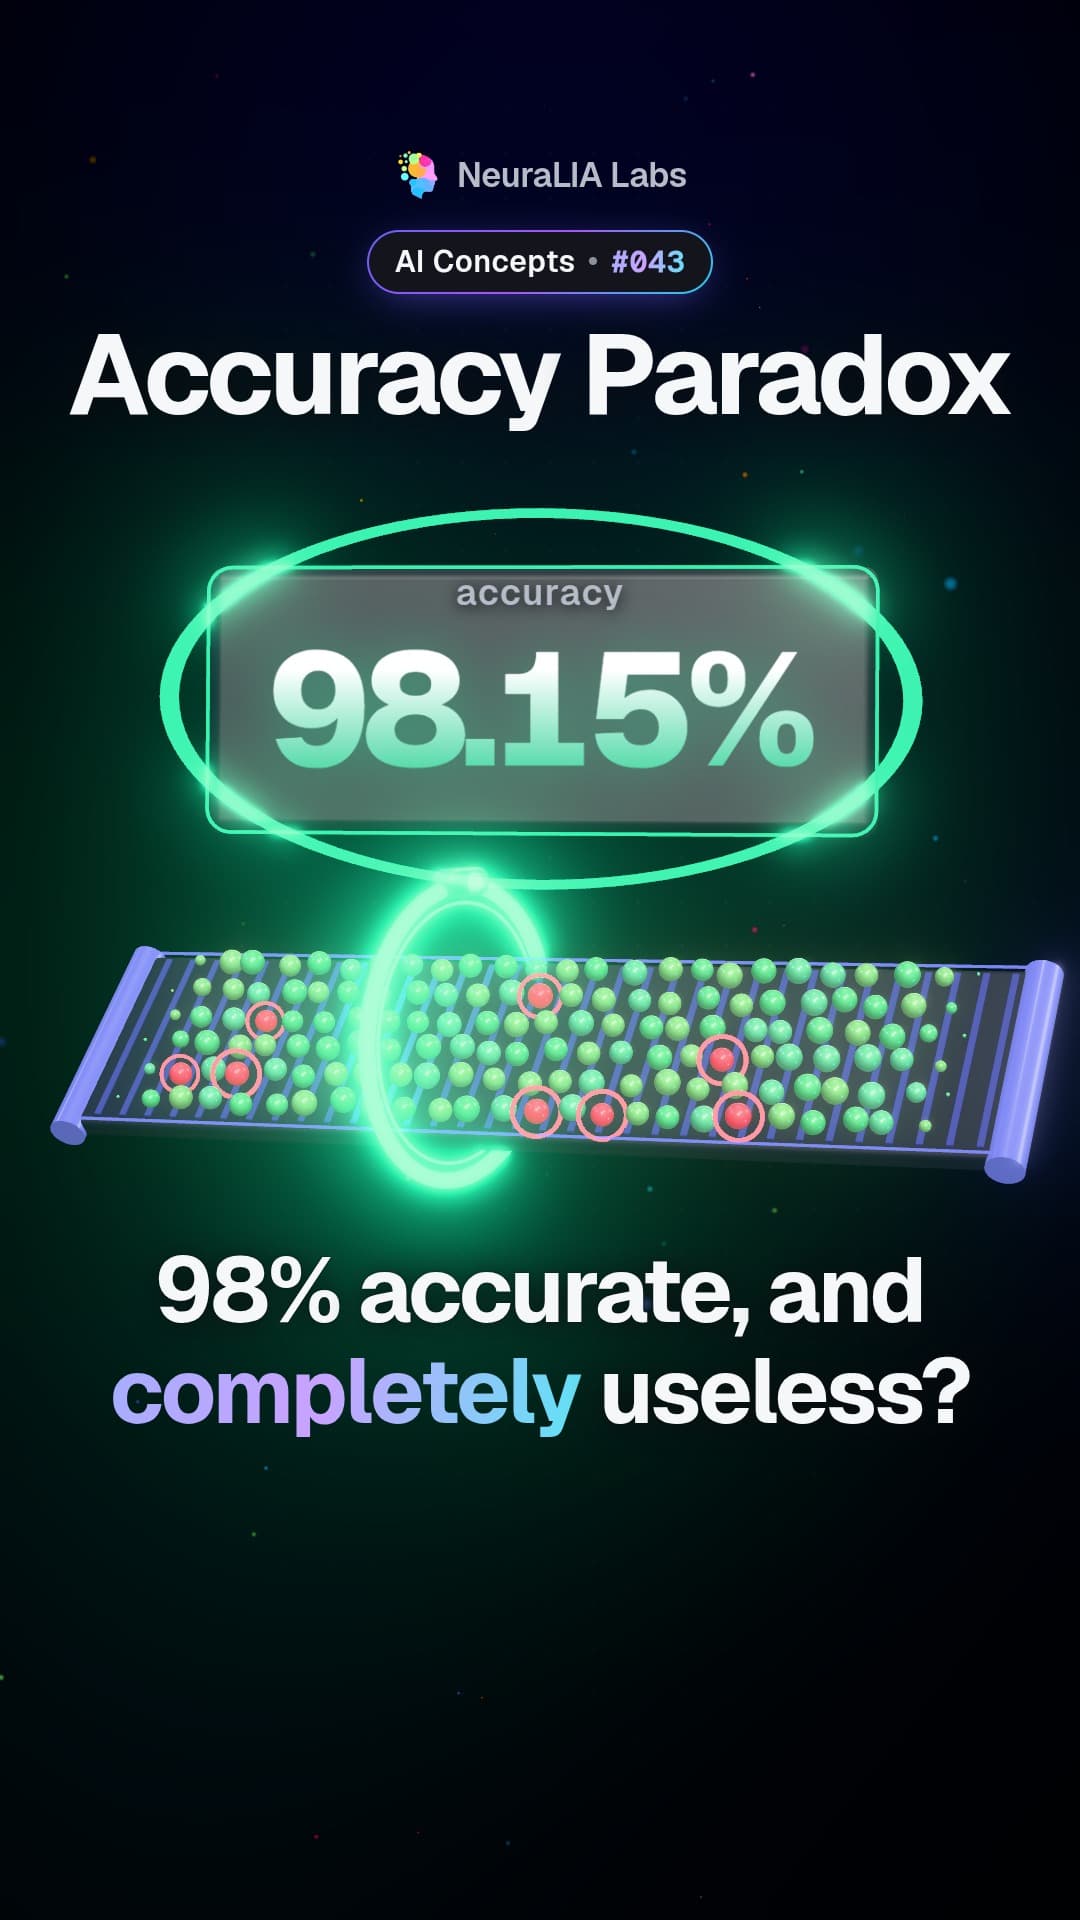
ベルトから流れてくるすべての部品について、この部品は問題ない と答えるmodelは、98.15 %の確率で正しいです。同時に、それは無価値でもあります。test setにある74個の不良部品のうち、1つも捕まえられないからです。
どちらの文も、同じmodelを説明しています。その2つの距離が、この章の内容です。
前半ではclassifierを構築します。新しく必要なものはほとんどありません。第2章では、dataがどのように生成されるかについての仮定をloss functionに変えるレシピを示し、第3章では、そのレシピが渡してくる任意のlossを下るための仕組みを示しました。この2つをyes/noの問いに適用するとlogistic regressionが出てきます。さらに新しい考え方が1つ、logit です。これは第17章で再び支払いを求められます。
後半のほうが難しい部分です。この先のコースのすべては、誰かが測定した数字によって評価されます。本当の改善と測定上の artefact を見分けられないなら、以降の章はすべて飾りになります。したがって扱うのは、confusion matrix、precision と recall、3つのsplit、leakage、そしてほとんど誰も正直に答えない問い――実際にtest exampleはいくつ必要なのか? です。
ここでの計算は20,000行にわたるため、全体を通してvectoriseしています。NumPyは第2章からずっと仕事をしてきましたし、ここから先はいちいち言及する価値もなくなります。
ベルト、ただし問いはもっとまれ
セクション「ベルト、ただし問いはもっとまれ」へのリンク第1章と同じ工場ですが、問いはより難しくなります。受け入れるか、拒否するか ではなく、問いは この部品は不良か です。そして不良はまれです。このため、この章の測定の半分は難しくなり、modelingの半分は見かけより簡単になります。
import numpy as np

rng = np.random.default_rng(4)
N = 20_000
width  = rng.normal(22.0, 0.9, N)      # millimetres
weight = rng.normal(57.0, 3.0, N)      # grams

z_true = -5.90 + 1.90 * (width - 22.0) + 0.42 * (weight - 57.0)
y = (rng.random(N) < 1 / (1 + np.exp(-z_true))).astype(float)

perm = rng.permutation(N)
train, val, test = perm[:12_000], perm[12_000:16_000], perm[16_000:]N = 20000 defects = 337 base rate = 0.0169
defects per split = 203 60 74splitは2つではなく3つです。その理由は独立した節に値するので、下で1節を割きます。今は、1つ目でtrainし、2つ目でtuneし、3つ目は見ないでください。
featuresは標準化します――平均を引き、標準偏差で割ります――ただし training statisticsだけ を使います。理由は、第1章がperceptronのconvergence boundで示した通りです。中心化されていないdataはgeometryを敵対的にします。そして、その平均をどの行から計算してよいのかは、この章の後半で現実の問いになります。
判定から確率へ
セクション「判定から確率へ」へのリンクperceptronは符号を返しました。符号では、reject と rejectだが、ほんのわずかに を区別できません。そしてその差こそ、工場がどの部品を人間に先に再検査させるかを決めるために必要なものです。
そこで第2章のレシピを文字通りたどります。labelがどのように生成されると主張するのかを書き下し、likelihoodを取り、logを取り、符号を反転するとlossが得られます。yes/noの結果に対する主張は Bernoulli 分布です。部品が不良である確率 があり、
これは「 なら 、 なら 」をコンパクトに書いただけです。そのlogを取り、符号を反転すると、1つのexampleに対するlossは
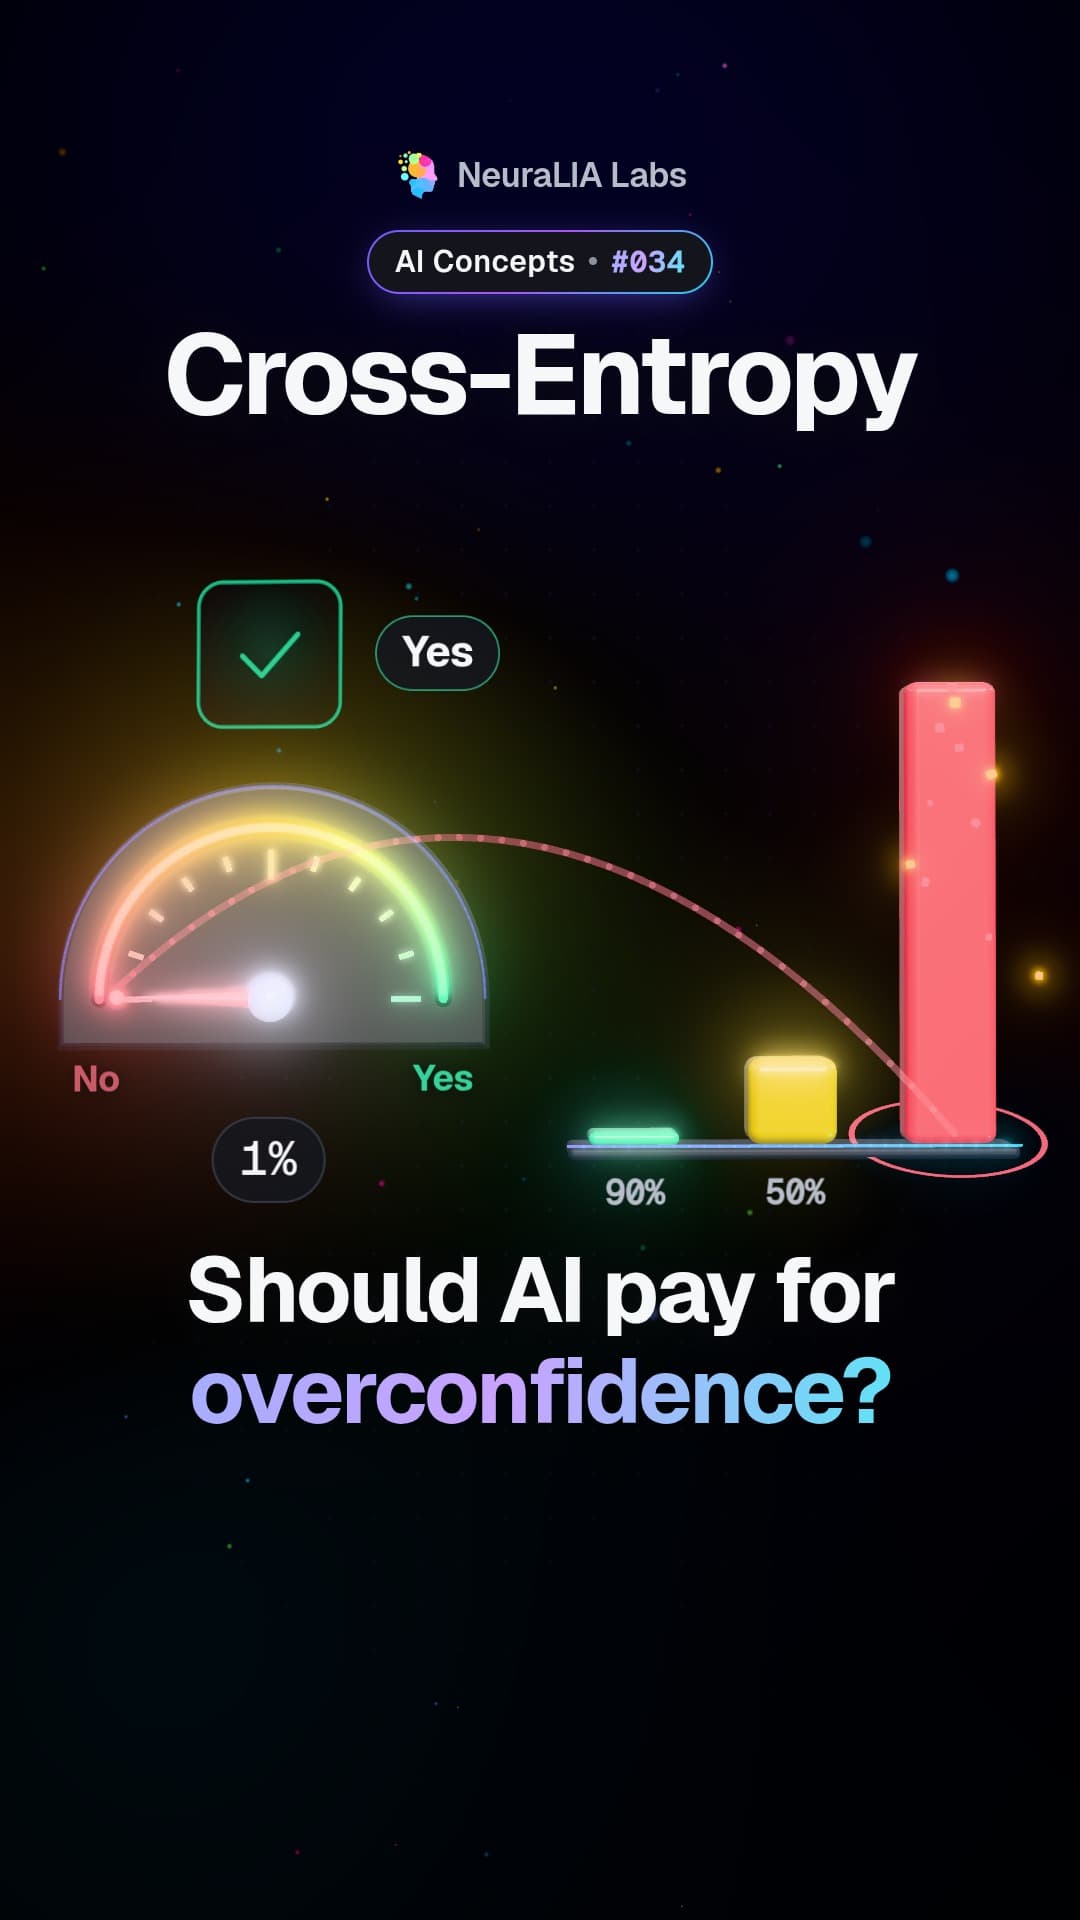
これが binary cross-entropy です。便利だから選んだのではありません。coin flipが取り得る唯一の分布のnegative log-likelihoodだからです。他に選択肢はありませんでした。
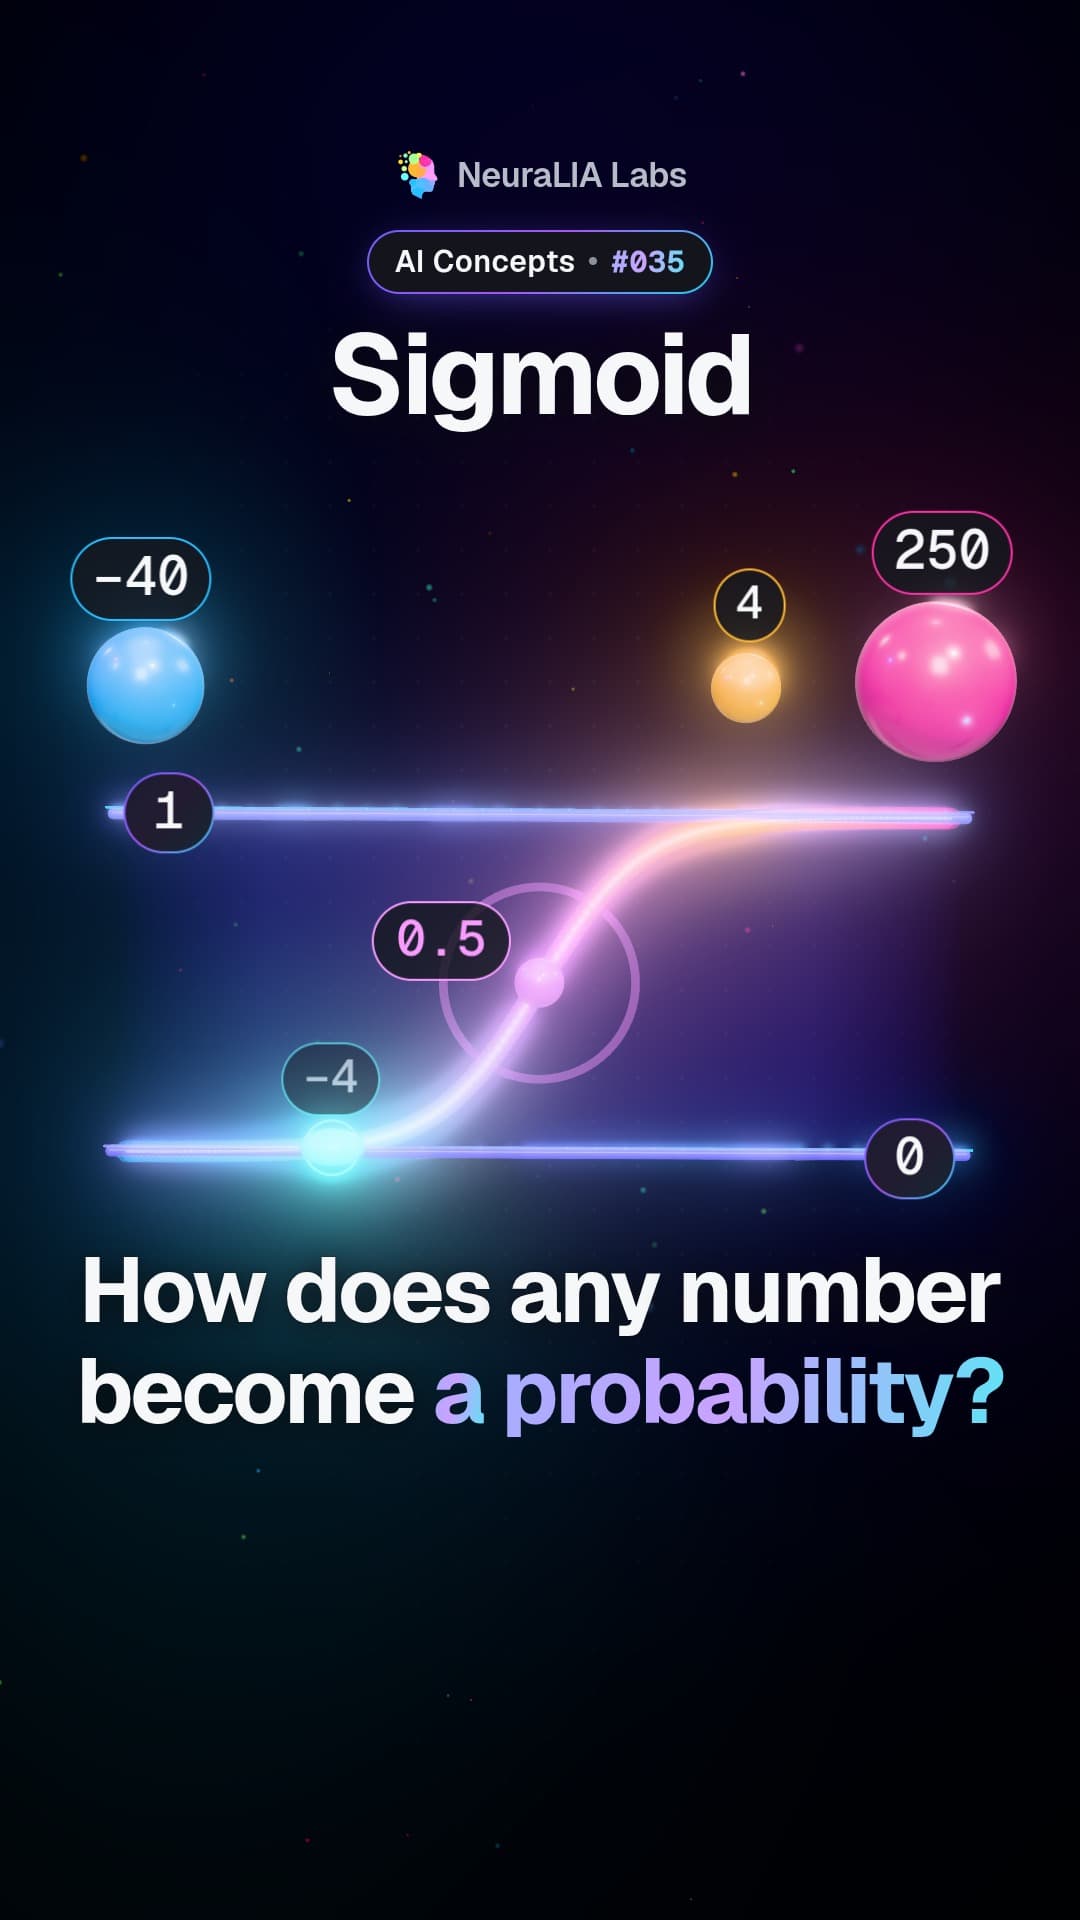
まだ足りないのは、 がどこから来るかです。modelはweighted sum を計算します。これは実数であり、数直線全体を取り得ます。一方、確率は に収まらなければなりません。その間を移動する関数が logistic sigmoid です。
logit -4.0  ->  p = 0.0180        loss when y=1 and p=0.9  : 0.1054
logit -1.0  ->  p = 0.2689        loss when y=1 and p=0.5  : 0.6931
logit  0.0  ->  p = 0.5000        loss when y=1 and p=0.01 : 4.6052
logit  4.0  ->  p = 0.9820
右側の列を価格表として読んでください。90 %のconfidenceで正しいことのコストは0.105です。判断を避けることのコストは0.693――つまり 、肩をすくめる価格です。自信満々に間違えることのコストは4.6で、44倍以上です。そしてmodelが間違いにより確信を深めるほど、その価格は無限に上がります。cross-entropyは単にerrorを数えるのではありません。傲慢さに課金します。
gradientはprediction minus truth
セクション「gradientはprediction minus truth」へのリンク第3章では、何かをtrainするには、各parameterに対するlossのderivativeを得るのだと言いました。1つのexampleでやってみます。 と のもとで、
詳細を表示
ごちゃごちゃを打ち消す2行。 sigmoidには非常に都合のよいderivative、 があります。そしてlossを微分すると、
chain ruleで2つを掛けると、 が上にも下にも1回ずつ現れます。これはぴったり打ち消し合い、 だけが残ります。この相殺は偶然ではありません。lossがある分布のnegative log-likelihoodであり、output functionがその分布が自然に使うものになっているとき、常に起きることです。この組み合わせには名前があります――generalised linear model――そしてこの整ったgradientはその指紋です。1
したがってupdateは prediction minus truth, times the input です。それだけです。trainer全体を示します。これは第3章のdescentで、1行だけ変わっています。
def sigmoid(z):
    return np.where(z >= 0, 1.0 / (1.0 + np.exp(-z)),
                    np.exp(np.minimum(z, 0)) / (1.0 + np.exp(np.minimum(z, 0))))


def fit_logistic(X, y, lr=0.5, epochs=4000):
    w, b = np.zeros(X.shape[1]), 0.0
    for _ in range(epochs):
        p = sigmoid(X @ w + b)
        g = p - y
        w -= lr * (X.T @ g) / len(y)
        b -= lr * g.sum() / len(y)
    return w, b
sigmoid の中の np.where は見た目の問題ではありません。 を大きな負の に対して直接計算するとoverflowします。このbranchは、代数的には同一で、かつexponentを負に保つ形式を選びます。これは第2章のfloating-pointの箱が最初の負債を取り立てる場面であり、2節後にはさらに大きな負債を取り立てます。
なぜsquared errorではないのか、そしてなぜ答えはgradientにあるのか
セクション「なぜsquared errorではないのか、そしてなぜ答えはgradientにあるのか」へのリンクcross-entropyをsquared errorより好む標準的な説明は、上のlikelihoodの議論です。squared errorはGaussian noiseを仮定したときに得られるもので、labelはGaussianではない。したがって使うな、というものです。これは正しいですが、誰も納得させません。sigmoidの上に を書けば、それでもtrainできるからです。
効く議論はgradientに関するものです。sigmoidの上にsquared errorを置くと、chain ruleにより
この余分な が、先ほど打ち消された項です。今度は打ち消されません。そしてmodelが自信を持つたびに0へ向かいます――modelが自信満々に 間違っている ときも含めて。true labelが1のexampleについて、いくつかのscoreで両者を評価してみます。
| score | cross-entropy | squared error | ratio | |
|---|---|---|---|---|
| 0.000335 | 1,491 | |||
| 0.017986 | 28.3 | |||
| 0.119203 | 4.8 | |||
| 0.500000 | 2.0 | |||
| 0.880797 | 4.8 |
では、modelは可能な限り間違っています。そしてsquared errorは、cross-entropyの1,491分の1のgradientで応答します。間違いがひどいほど、modelがそこから学ぶ量は少なくなるのです。一方、cross-entropyのgradientは でsaturateします。最大限に間違うと最大限に大きいsignalが出て、それ以上にはなりません。
競争させてみましょう。balancedな2,000点、同一のinitial weightsは自信満々に間違うように選び()、learning rateも同一、違うのはlossだけです。どちらのrunもcross-entropyでscoreし、列を比較可能にしています。
| epoch | cross-entropy loss | accuracy | squared-error loss | accuracy |
|---|---|---|---|---|
| 1 | 5.4865 | 0.2300 | 5.9499 | 0.2290 |
| 10 | 1.5525 | 0.2460 | 5.9042 | 0.2290 |
| 50 | 0.4642 | 0.7780 | 5.6913 | 0.2320 |
| 100 | 0.4639 | 0.7770 | 5.3955 | 0.2410 |
| 200 | 0.4639 | 0.7770 | 4.6311 | 0.2745 |
| 500 | 0.4639 | 0.7770 | 0.5291 | 0.7660 |
| 1,000 | 0.4639 | 0.7770 | 0.4640 | 0.7765 |
cross-entropyはepoch 50で終わっています。squared errorはepoch 100でもaccuracy 24 %にとどまっています――epoch 10の23 %からほとんど動いていません――推測より悪いのです。自信満々に間違った状態から始まり、それを救うはずのgradientが0.0007倍されていたからです。epoch 500あたりで脱出し、同じ場所に着地します。したがって正直な要約は、sigmoid上のsquared errorは 間違っている わけではない、しかし 速度が最も重要な場所で正確に遅い ということです。2-parameter modelなら450 epochを失います。100 layerのnetworkでは、どこかのunitが常に自信満々に間違っているので、training runを失います。
entropy、cross-entropy、KLを1ページで
セクション「entropy、cross-entropy、KLを1ページで」へのリンク3つの量です。第8章ではperplexityのために、第11章ではfine-tuningされたpolicyをreferenceの近くに保つpenaltyのために、正しく必要になります。評判ほど難しくありません。2
Entropy は、ある分布からのdrawを通信するために、最良のcodeを使った場合に平均して必要なbit数です。
Cross-entropy は、本当は から来るdataに対して、 用に作られたcodeを使うときに支払う量です。
KL divergence は余分です。真実が なのに を信じることで生じる、bit単位の無駄です。
ベルト上で3つすべてを確認します。
test defect rate                                = 0.0185
entropy of that coin                            = 0.1329 bits
cross-entropy of the constant predictor on test = 0.1330 bits
KL(test coin || fair coin)                      = 0.8671 bits
H + KL                                          = 1.0000 bits
cross-entropy of the p=0.5 predictor on test    = 1.0000 bits
ここでは2つのことが見えます。第一に、training base rateである1.69 %を単に報告するmodelは、0.1330 bitsのcross-entropyを達成します。これはtest labelsのentropyとほぼ完全に同じです。そうでなければなりません。正しい分布を持っていて、個別情報は何もないからです。Entropyは、個体について無知であることが買ってくれるfloorです。第二に、肩をすくめて0.5と言うmodelはちょうど1 bitを支払い、その差0.8671 bitsがまさにKL divergenceです。 は暗記すべきidentityではありません。積み上がっていく請求書として見られるものです。
そしてtrainingへのつながりに戻ると、labelが単一の既知classであるとき、「true」distributionはone-hotで、そのentropyは0です。したがってcross-entropyはKL divergenceに 等しく なります。cross-entropyを最小化することと、modelのdistributionをtruthへ引き寄せることは、同じ行為です。
2つより多い答え:softmaxと、何のコストもないshift
セクション「2つより多い答え:softmaxと、何のコストもないshift」へのリンク不良は1種類ではありません。mouldingでは、部品は short shot(材料不足)、flash(多すぎてmouldからはみ出す)、あるいは burn として出てくることがあります。4つの結果なので4つのlogitsがあり、それらは合計1になる4つの確率にならなければなりません。それが softmax です。
softmaxには、偶然に見えて実は実装全体である性質があります。
任意の定数 について成り立ちます。なぜなら となり、 が分子と分母で打ち消されるからです。意味を持つのはlogits間の 差 だけです。絶対的なlevelは情報ではありません。
幸いにもそうです。なぜなら、その絶対的なlevelこそcomputerを壊すものだからです。
logits            = [800. 801. 799.]
naive softmax     = [nan nan nan]
shifted by -max   = [0.2447 0.6652 0.09  ]
same softmax after adding 1000 to every logit: True は64-bit floatでoverflowし、sumはinfinityになり、infinityをinfinityで割ると nan になります――errorでもcrashでもなく、3つの確率があった場所に静かな穴が空くだけです。最大logitを引いても数学的には何も変わらず、数値的にはすべてが変わります。最大のexponentがちょうど になるからです。これは第2章の logsumexp trickが作業着を着た姿であり、真面目な実装はすべてそうします。
def softmax(Z):
    Z = Z - Z.max(axis=1, keepdims=True)
    E = np.exp(Z)
    return E / E.sum(axis=1, keepdims=True)


def fit_softmax(X, Y, lr=1.0, epochs=6000):
    W, b = np.zeros((X.shape[1], Y.shape[1])), np.zeros(Y.shape[1])
    for _ in range(epochs):
        G = (softmax(X @ W + b) - Y) / len(X)
        W -= lr * (X.T @ G)
        b -= lr * G.sum(0)
    return W, b
gradientは再び prediction minus truth です。今度は がone-hotです。binary caseは最初からspecial caseだったのです。
3,000個の部品でtrainし、1,000個でtestします。各部品には3つのmeasurement(width、weight、melt temperature)があります。結果は 94.00 % accuracy です。この数字が隠しているものを示します。
| truth ↓ / predicted → | ok | short shot | flash | burn | recall |
|---|---|---|---|---|---|
| ok | 850 | 5 | 9 | 0 | 0.984 |
| short shot | 22 | 21 | 0 | 0 | 0.488 |
| flash | 20 | 0 | 30 | 1 | 0.588 |
| burn | 3 | 0 | 0 | 39 | 0.929 |
| precision | 0.950 | 0.808 | 0.769 | 0.975 |
modelはshort shotの半分未満しか見つけていません。accuracyにはこれが見えません。部品の86 %が問題なく、それらを正しく当てるだけで平均を支えられるからです。Macro F1――classごとのF1 scoreの平均で、rare classをcommon classと同じ重みで扱うもの――は0.7983 です。一方、micro F1は0.9400で、定義上accuracyと同一です。誰かがF1を1つだけ報告したら、どちらかを尋ねてください。
modelingはここまでです。章の残りは数字についてです。
3つのmodel、1つのaccuracy
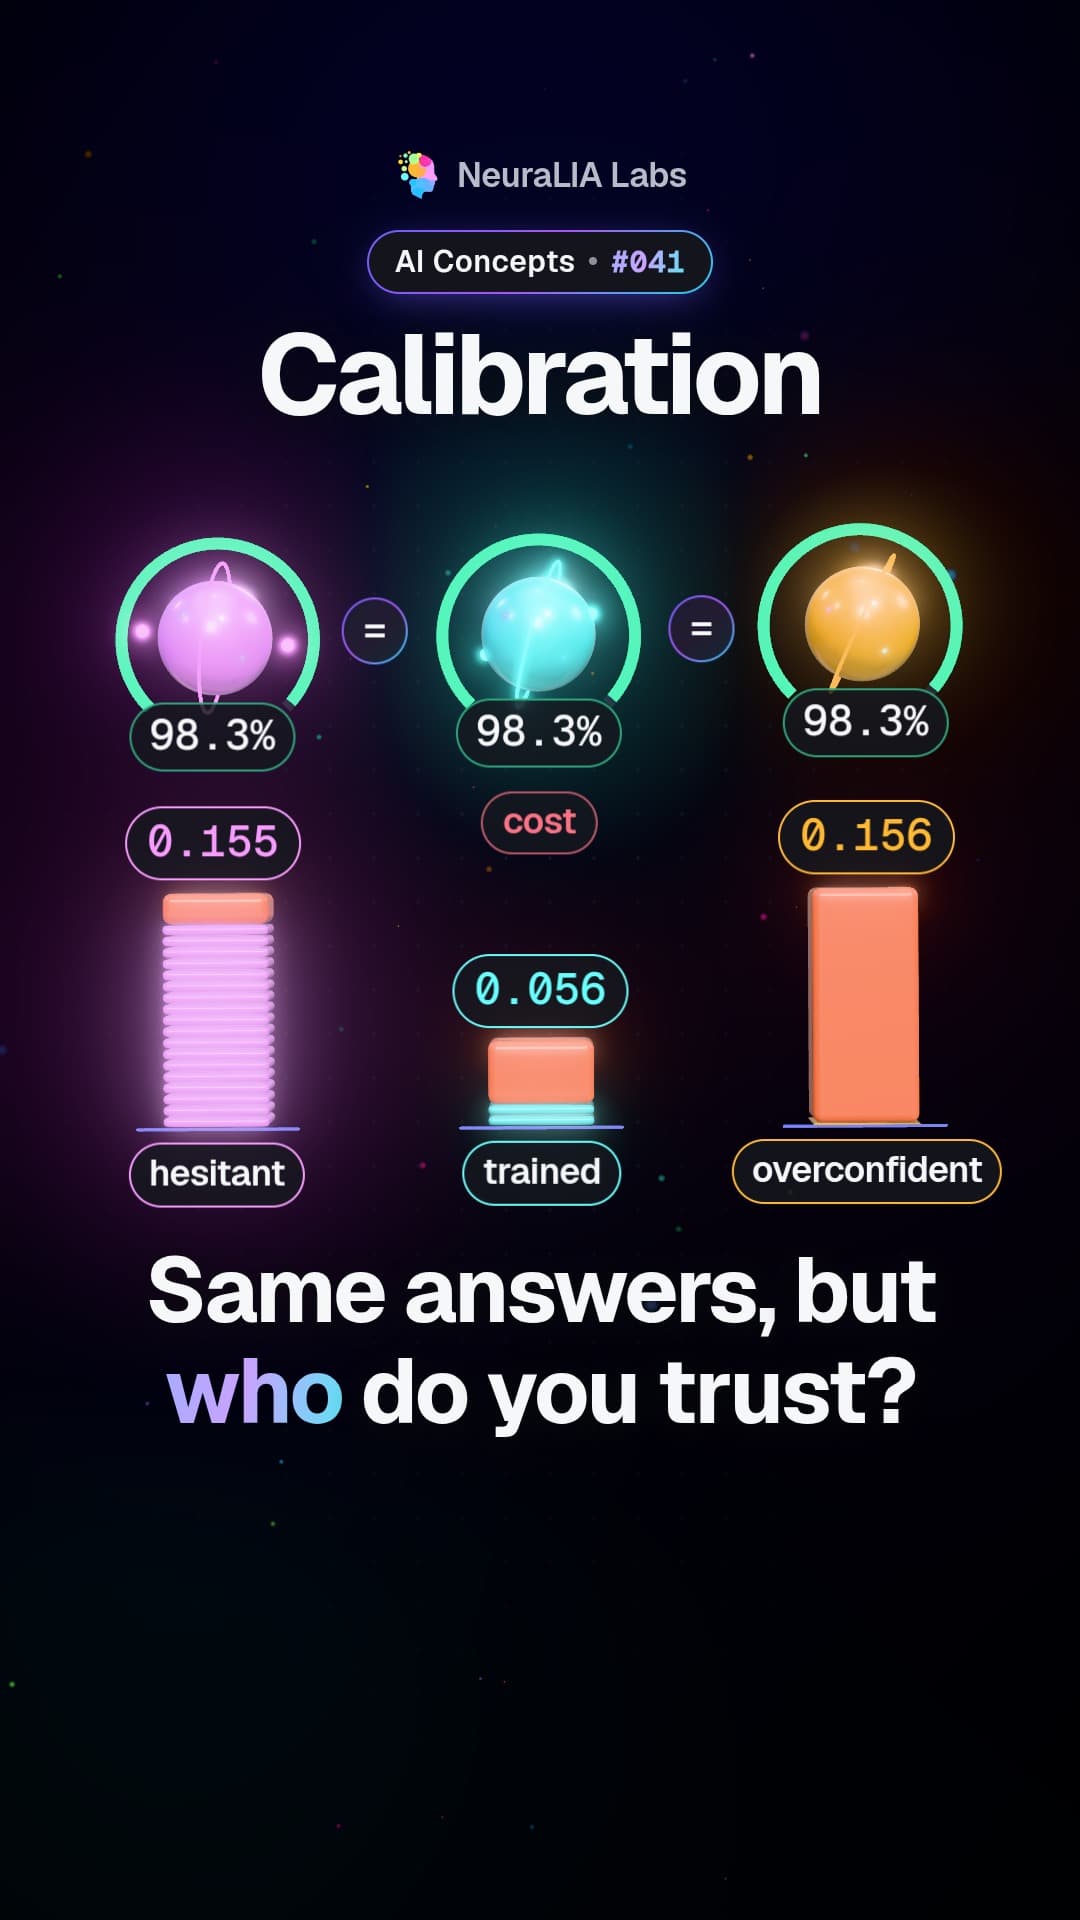
セクション「3つのmodel、1つのaccuracy」へのリンクtrain済みのbinary modelを取り、すべてのlogitに定数を掛けて2つのvariantを作ります。hesitantなversionには0.35、overconfidentなversionには4です。正の数を掛けても符号は変わらないので、3つのmodelは4,000個すべてのtest partsについて まったく同じlabel を予測します。accuracyでは区別できません。cross-entropyならまったく問題ありません。
| model | accuracy | cross-entropy | mean loss when right | mean loss when wrong | worst single loss |
|---|---|---|---|---|---|
| hesitant (logits × 0.35) | 0.9830 | 0.1549 | 0.1369 | 1.1990 | 2.80 |
| as trained | 0.9830 | 0.0564 | 0.0147 | 2.4689 | 7.82 |
| overconfident (logits × 4) | 0.9830 | 0.1563 | 0.0009 | 9.1427 | 27.63 |
hesitantなmodelは、正しく当てた何千個も含め、すべての部品に小さな税金を払います。overconfidentなmodelは正しいときほぼ無料で、間違ったとき壊滅的です。このtest setのある1部品だけで27.63 natsのコストがかかります。2つは正反対の道を通ってほぼ同じtotalに着地し、dataにcalibrateされた確率を持つtrained modelは、その両方の3分の1の位置にいます。
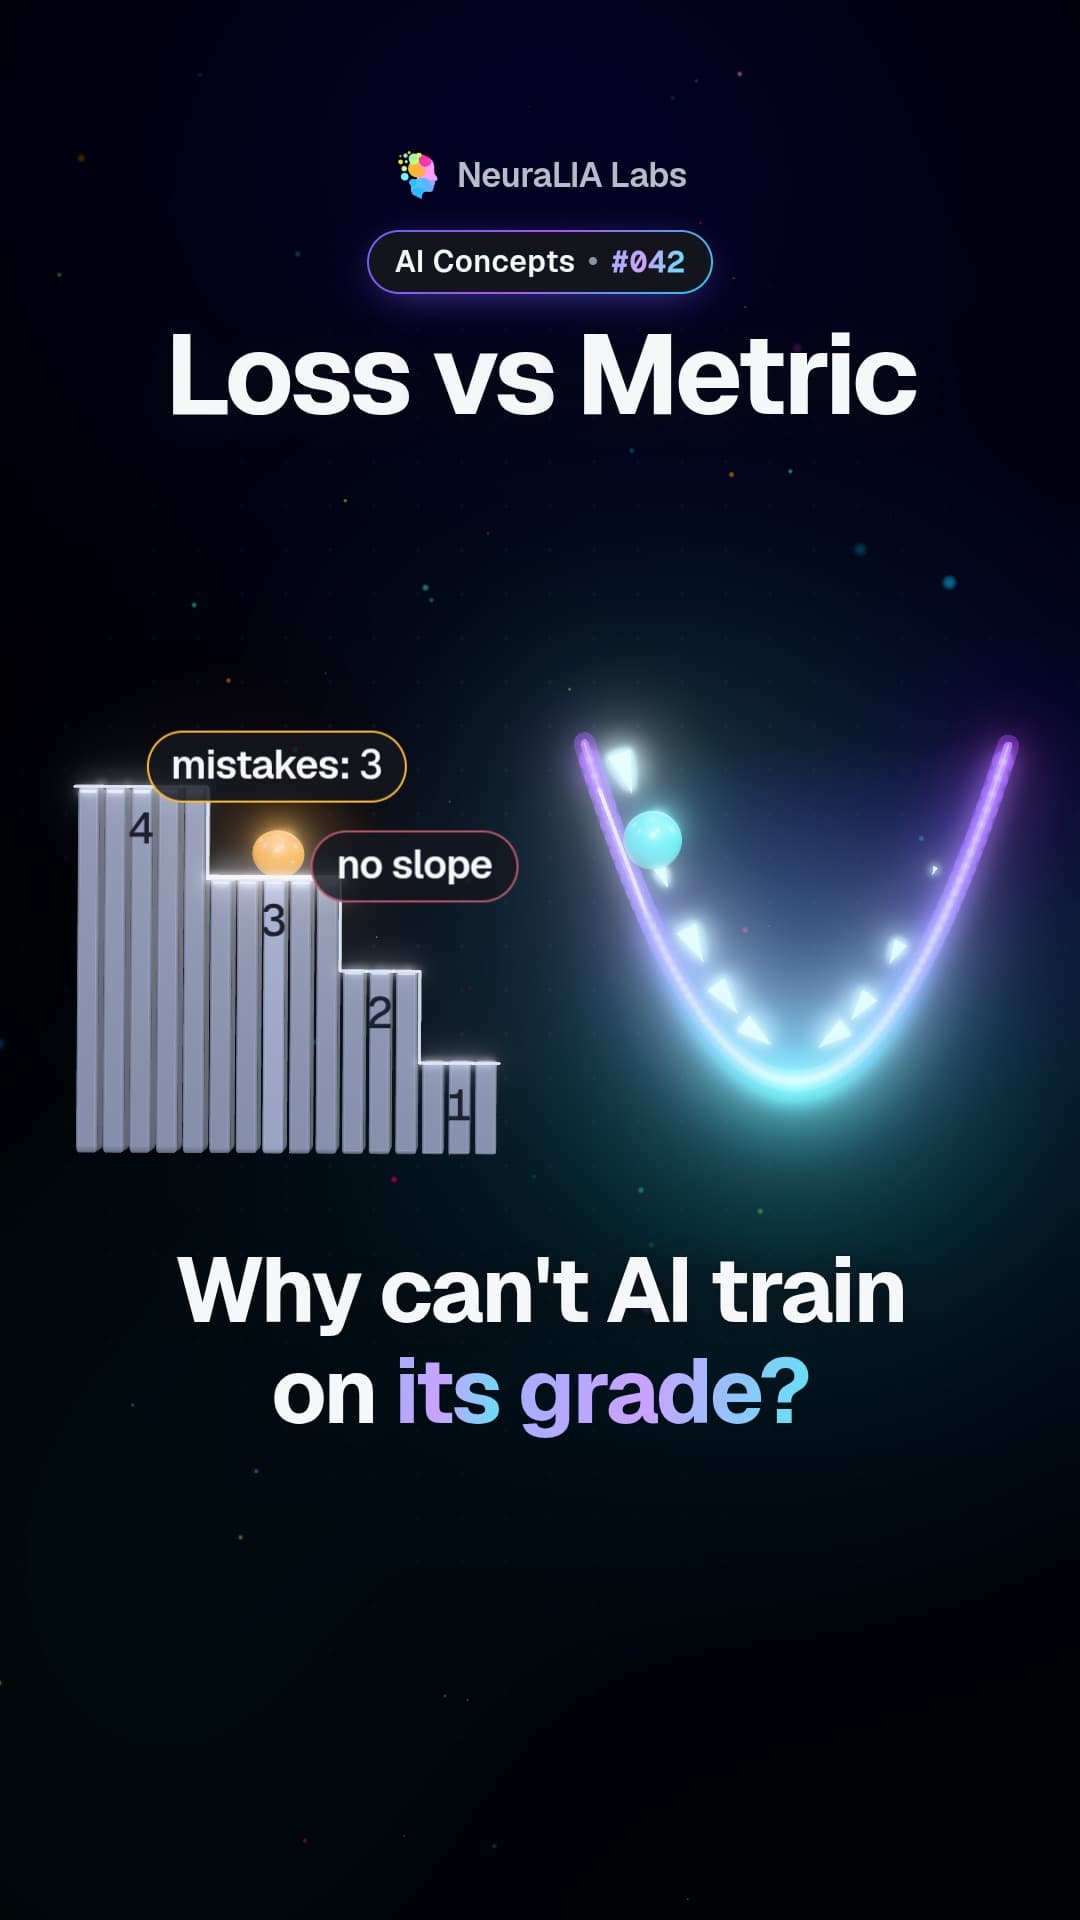
これが loss と metric の違いを最も鋭く述べる方法です。lossはoptimiseするものです。differentiableでなければならず、modelが言ったすべてを見ます。どれだけ確信していたかも含みます。metricは評価されるものです。step functionでも、business ruleでも、見逃した不良のcountでも構いません。これらは同じobjectではなく、常に一致するわけでもありません。だから始める前に両方を定義し、画面に表示されているからという理由でlossをmetricの代わりにしてはいけないのです。
愚かなbaselineが先に来る
セクション「愚かなbaselineが先に来る」へのリンクmodelの前に必要なのは、最も怠けた答えは何点を取るのか? です。このベルトでは、常に問題なしと言う です。
always-say-fine baseline: accuracy = 0.9815
confusion (tn, fp, fn, tp) = (3926, 0, 74, 0)
98.15 %。次に、default threshold 0.5でのtrained logistic modelです。
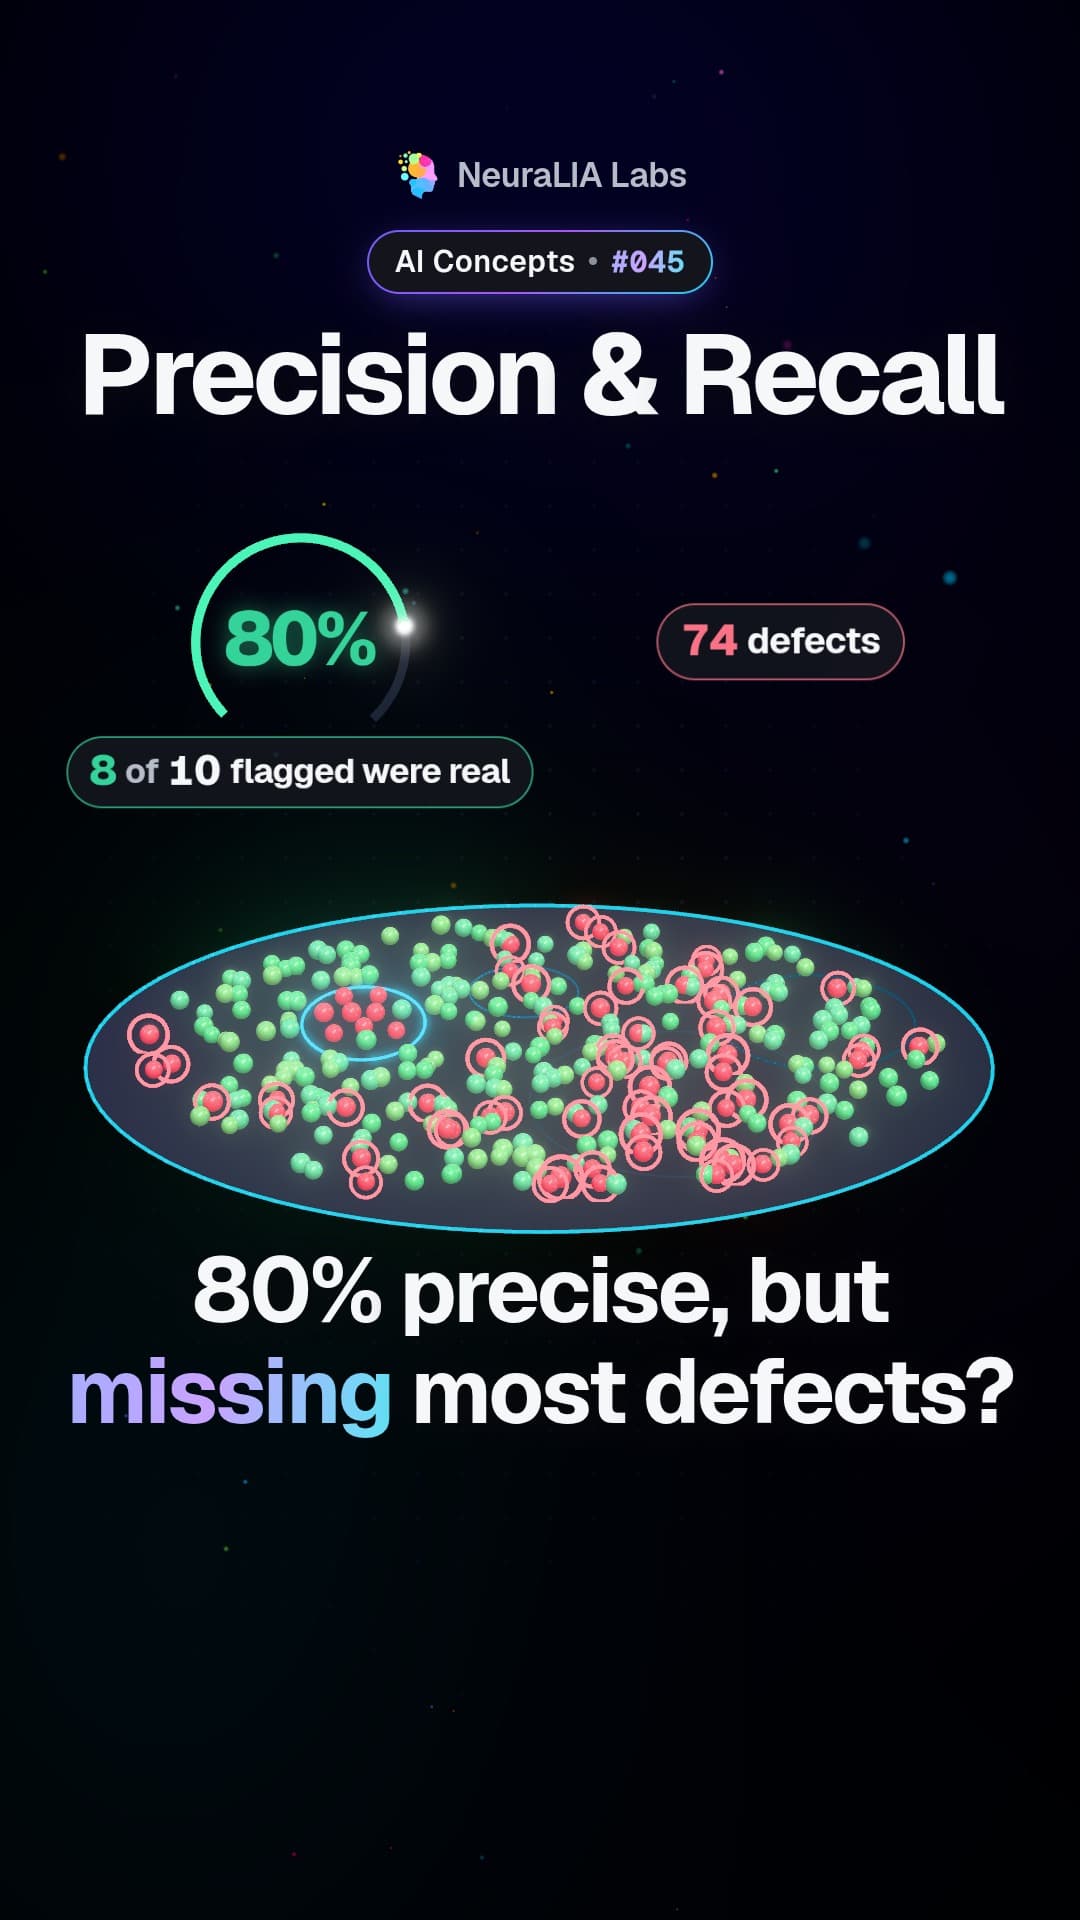
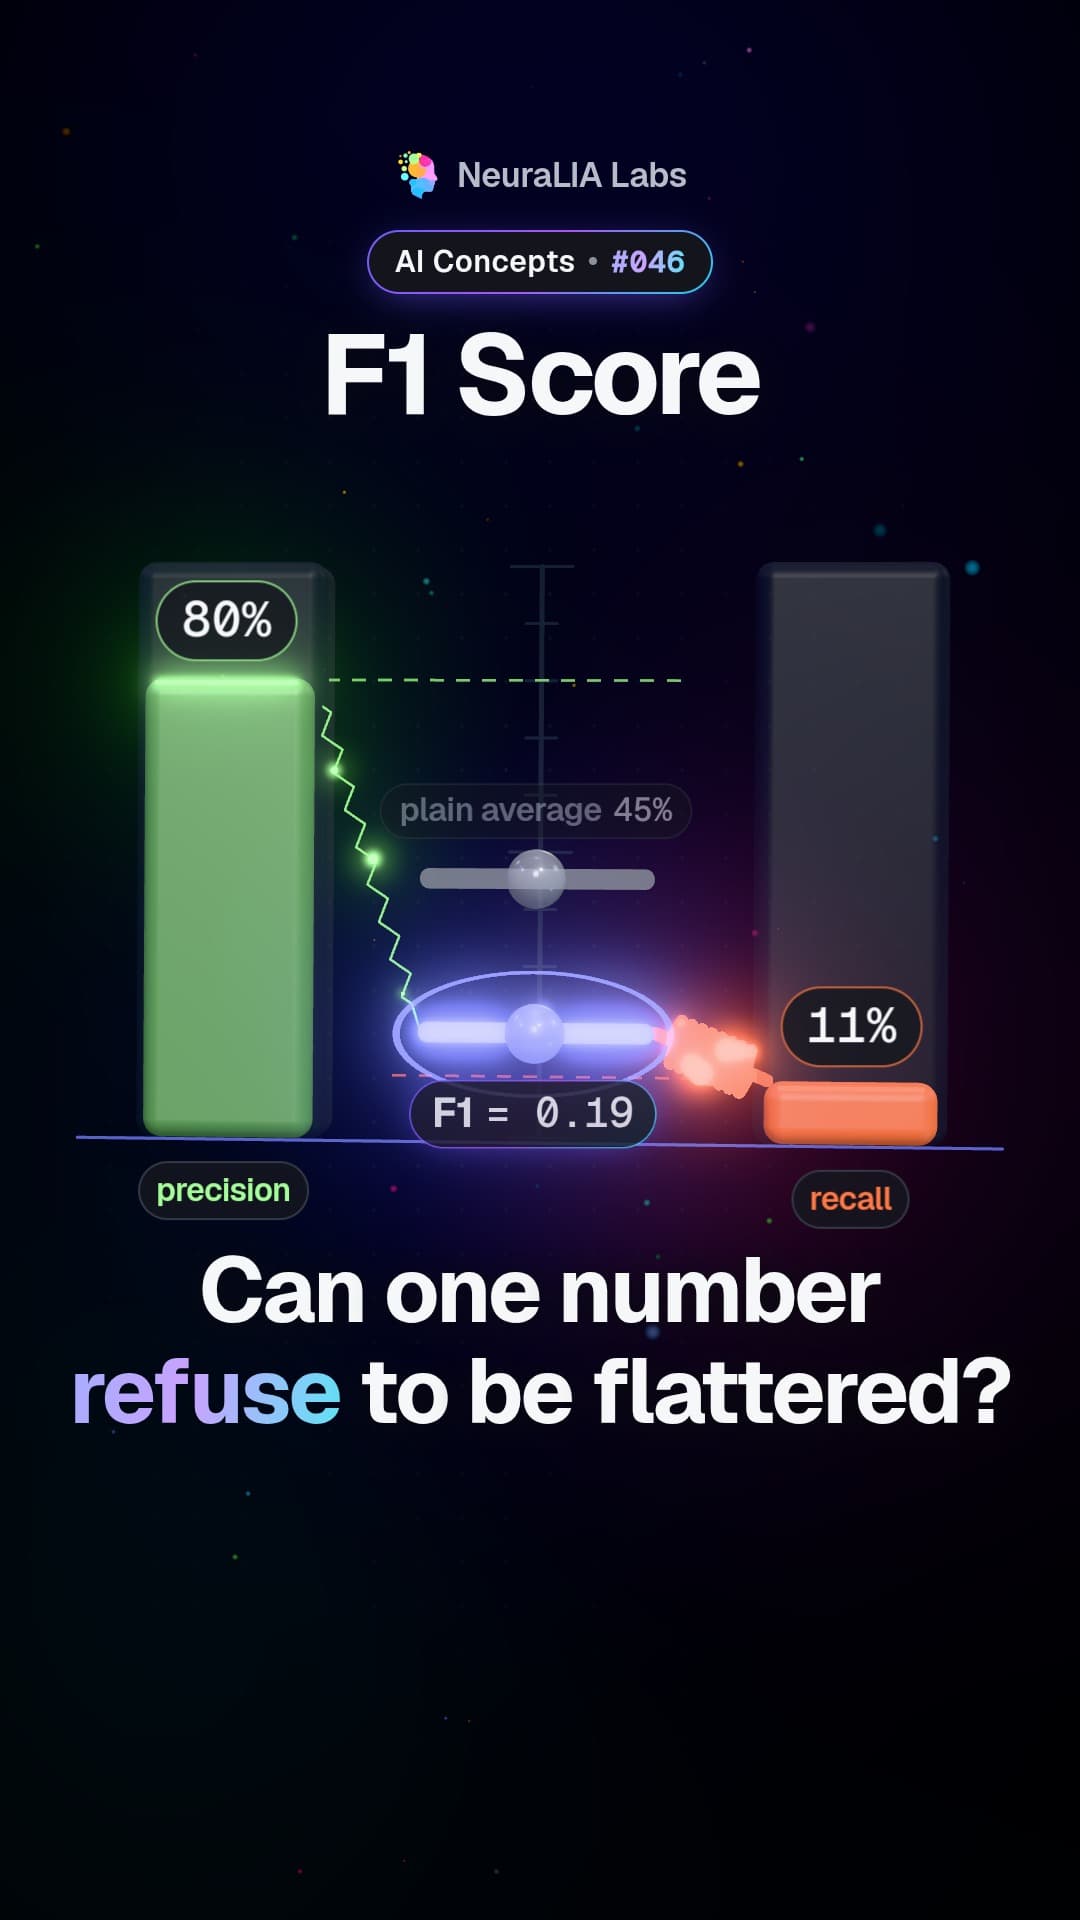
logistic @0.5: accuracy=0.9830 precision=0.8000 recall=0.1081 F1=0.1905
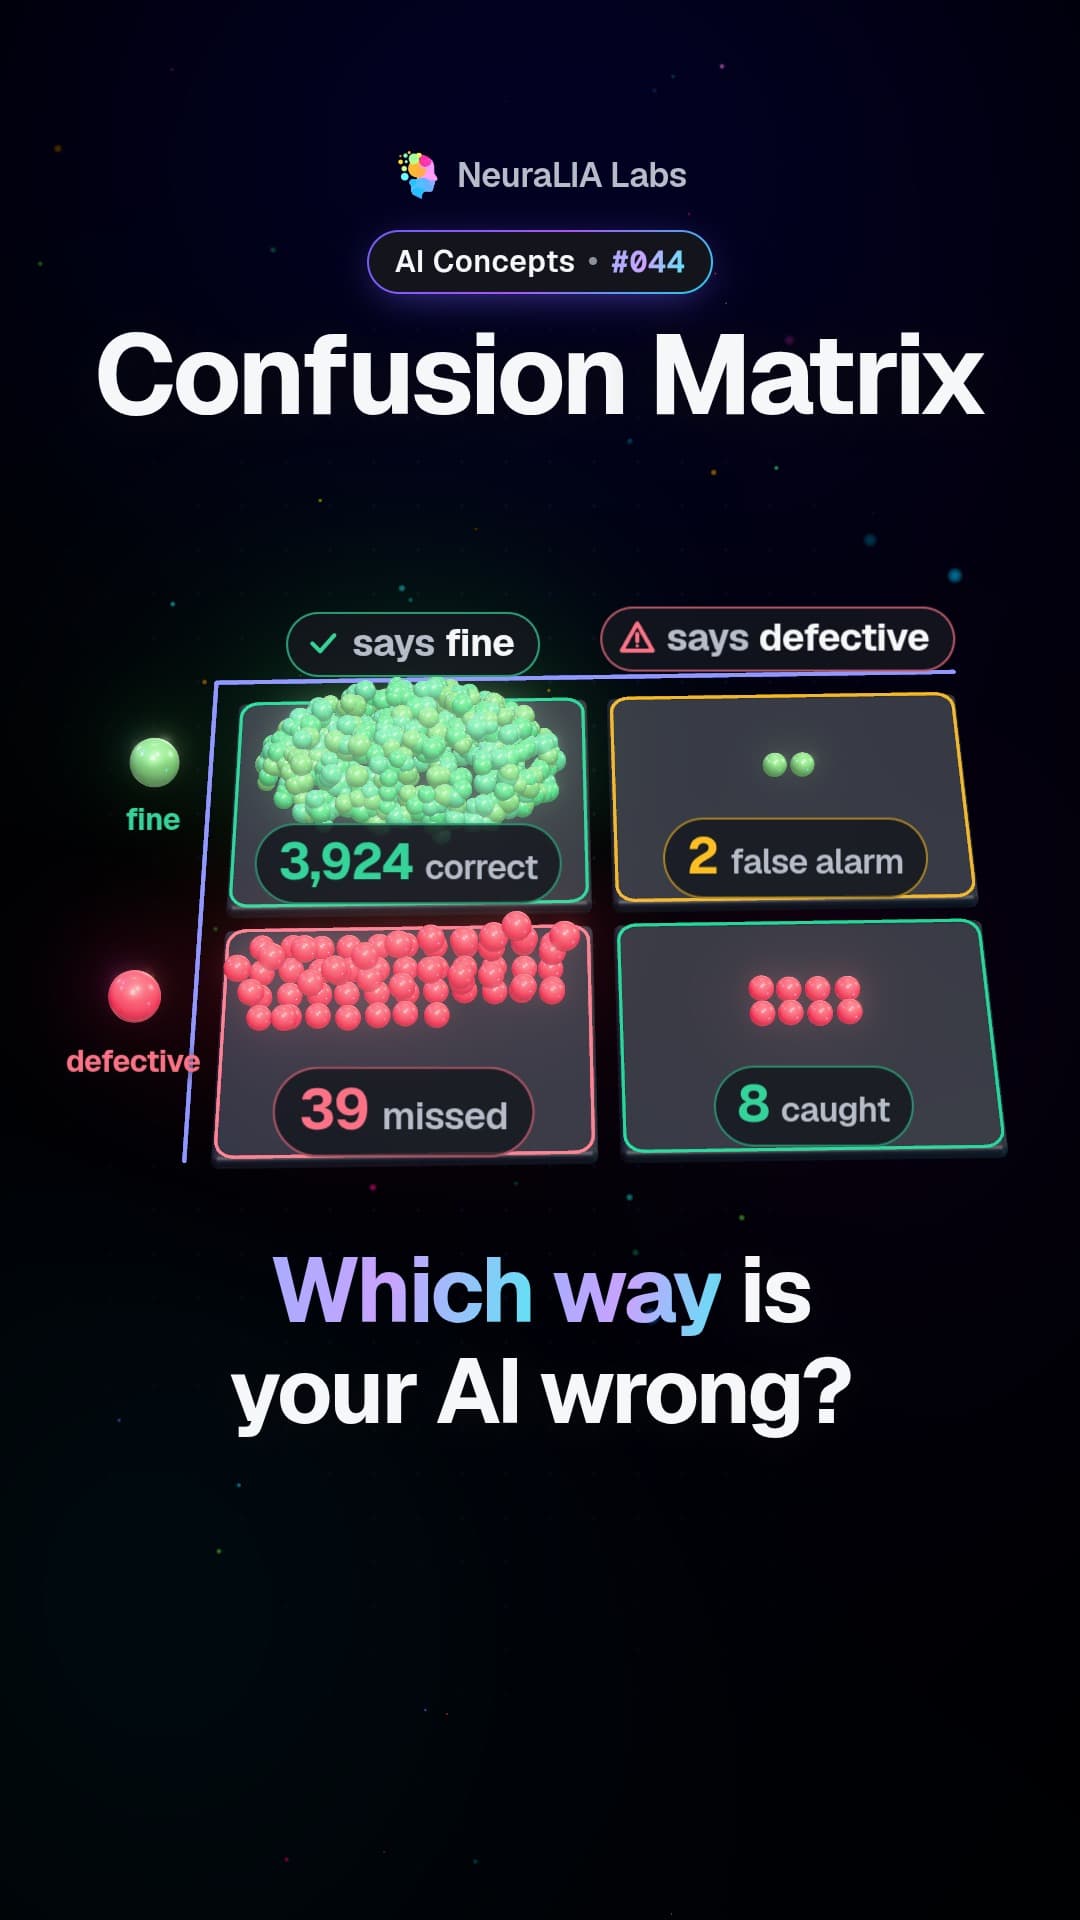
confusion (tn, fp, fn, tp) = (3924, 2, 66, 8)
98.30 %。baselineを 0.15 percentage point 上回りました。そしてaccuracyで止まるreportはこれを勝利と呼ぶでしょう。confusion matrixは実際に何が起きたかを示します。
| predicted fine | predicted defective | |
|---|---|---|
| actually fine | 3,924 | 2 |
| actually defective | 66 | 8 |
74個の不良部品のうち8個を見つけ、66個を通してしまいました。この表の3通りの読み方に名前を付けるのが、3つの数字です。
- Precision 。flagした部品のうち、実際に不良だったものはいくつか。これは無駄な検査のcostです。
- Recall 。不良部品のうち、捕まえたものはいくつか。これは不良品をcustomerへ出荷するcostです。
- F1 。両者のharmonic meanで、小さいほうに近く留まるため、片方だけにおだてられることを拒みます。
何が重要かは工場次第であって、数学次第ではありません。検査には数秒かかり、出荷された不良にはrecall noticeのcostがかかります。したがってここではrecallが支配的であり、0.108は失敗です。
しかしmodelが問題なのではありません。thresholdが問題 です。そしてthresholdはmodelの一部ではありません。確率に対して後から適用されるbusiness decisionです。sweepしてみます。
| threshold | TP | FP | FN | accuracy | precision | recall | F1 |
|---|---|---|---|---|---|---|---|
| 0.500 | 8 | 2 | 66 | 0.9830 | 0.800 | 0.108 | 0.190 |
| 0.200 | 27 | 28 | 47 | 0.9812 | 0.491 | 0.365 | 0.419 |
| 0.100 | 42 | 118 | 32 | 0.9625 | 0.263 | 0.568 | 0.359 |
| 0.050 | 54 | 236 | 20 | 0.9360 | 0.186 | 0.730 | 0.297 |
| 0.020 | 67 | 570 | 7 | 0.8558 | 0.105 | 0.905 | 0.188 |
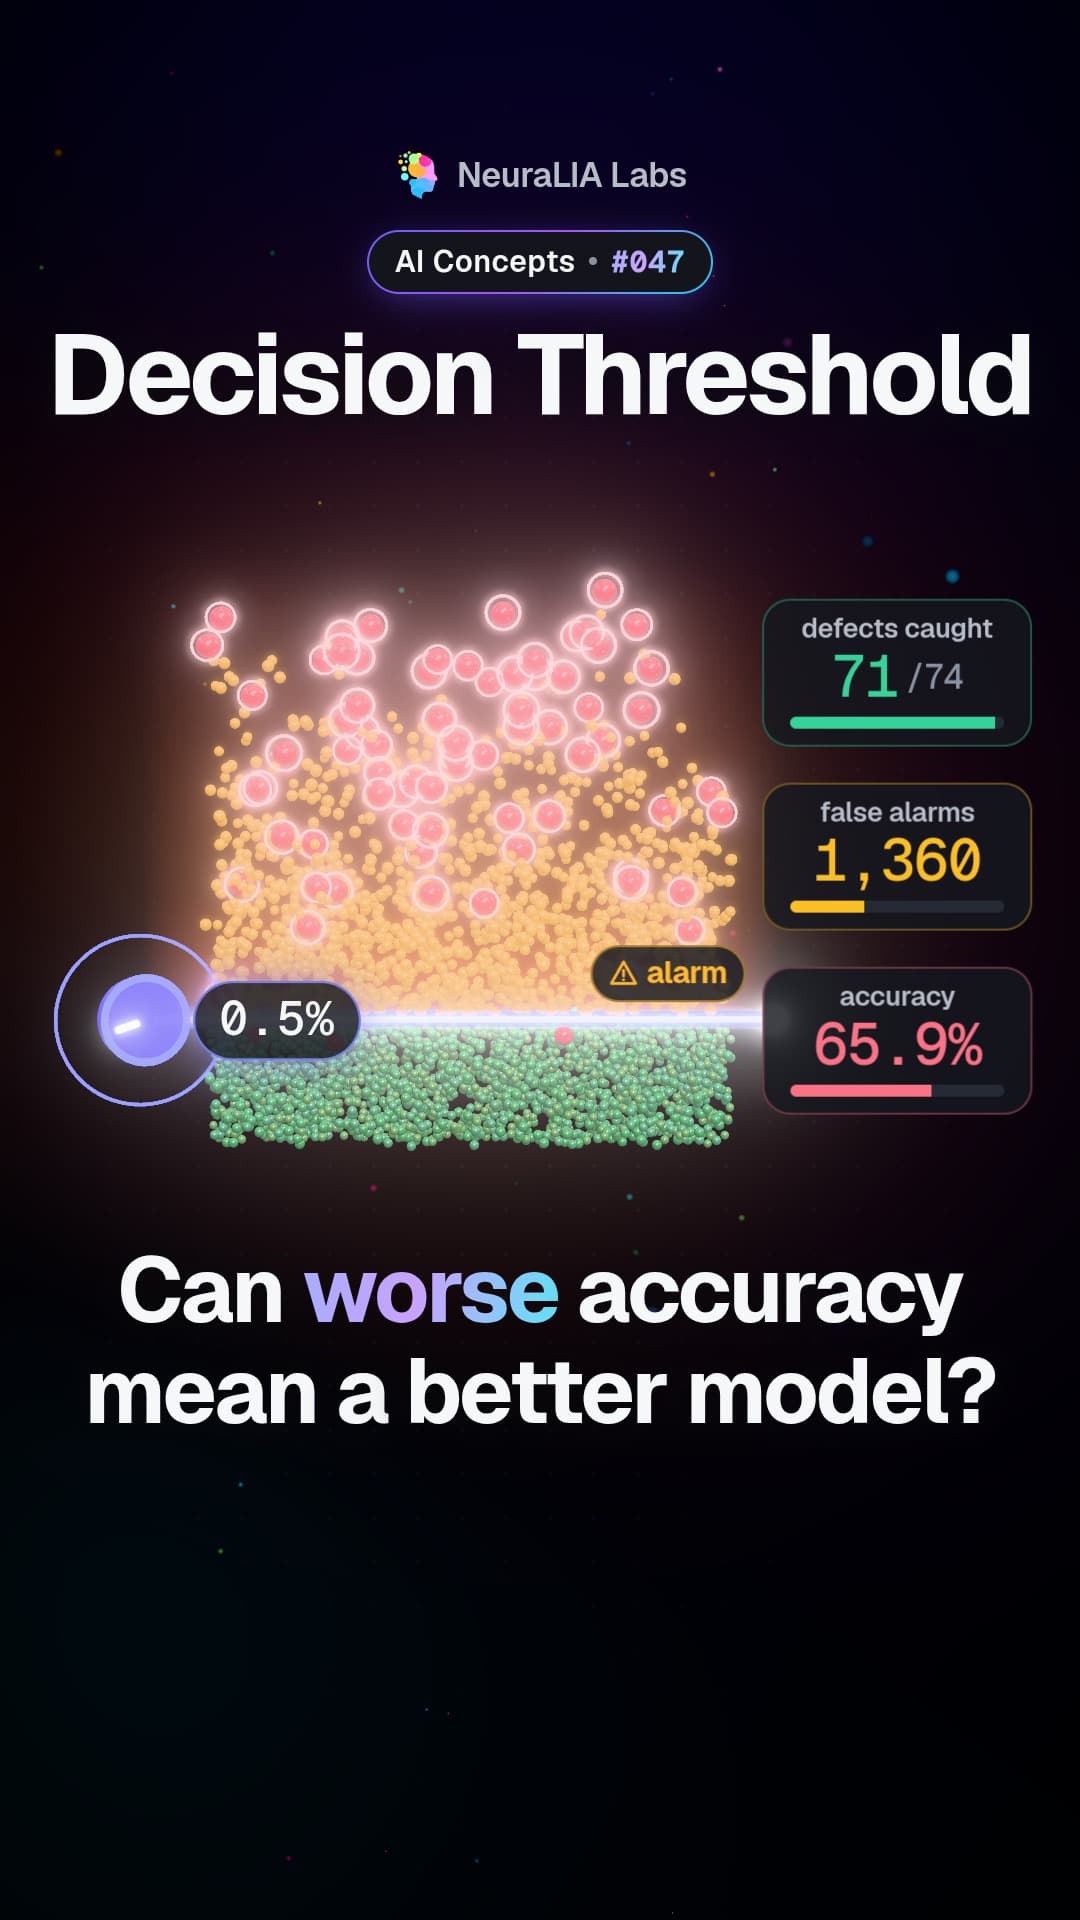
| 0.005 | 71 | 1,360 | 3 | 0.6593 | 0.050 | 0.959 | 0.094 |
accuracy列を下へ読んでください。98.30 %から65.93 %までずっと下がっていきます。その間にmodelは、不良を8個見つける状態から74個中71個を見つける状態へ進みます。このmodelができる有用なことはすべて、accuracyを悪化させます。 見出しの数字をoptimiseするteamは、何も見つけないversionを出荷するでしょう。
詳細を表示
Class weightingはsignalを作らない。operating pointを動かすだけ。 imbalanced classesへの通常の最初の反応は、lossでrare classにweightを付けることです。positivesに1、10、60のweightを付けると、
| weight on positives | accuracy | precision | recall | F1 | AUC |
|---|---|---|---|---|---|
| 1 | 0.9830 | 0.800 | 0.108 | 0.190 | 0.9363 |
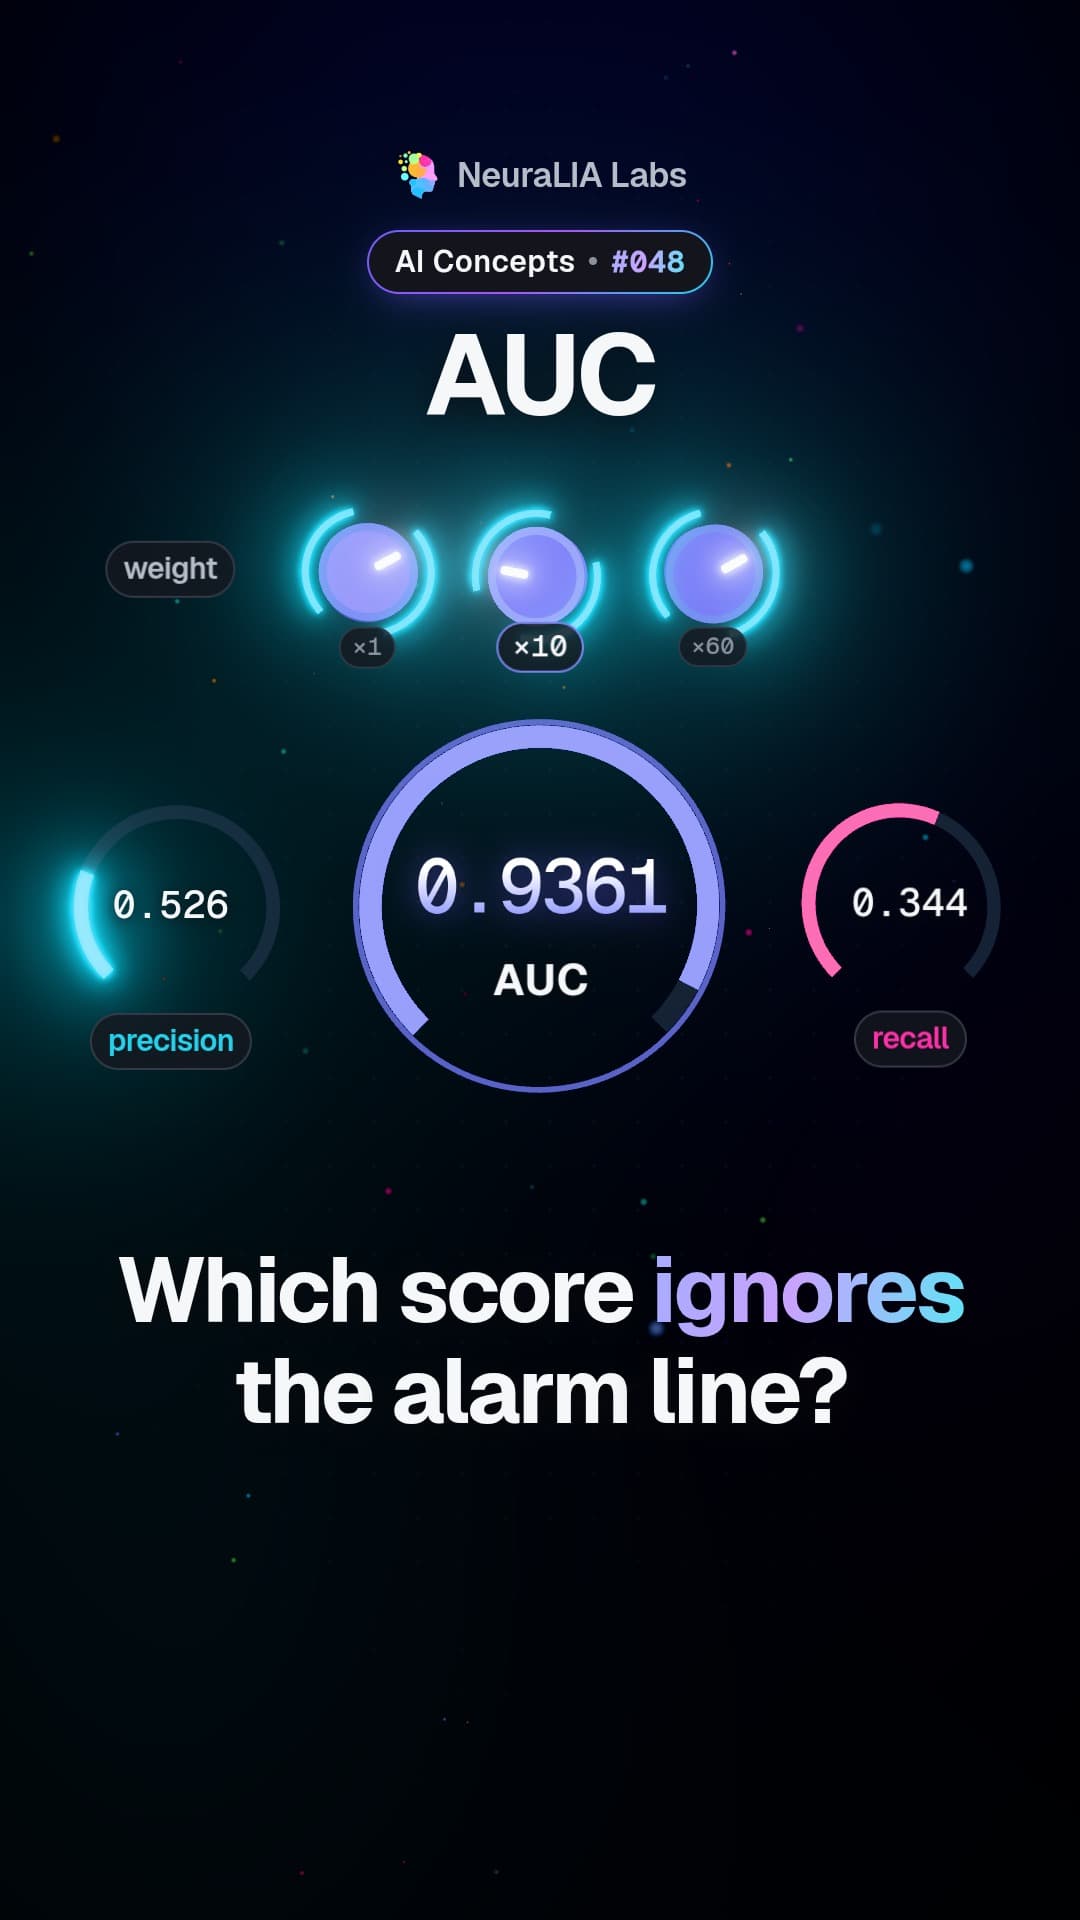
| 10 | 0.9605 | 0.253 | 0.581 | 0.352 | 0.9361 |
| 60 | 0.8290 | 0.091 | 0.919 | 0.166 | 0.9361 |
precisionとrecallは大きく動きます。AUC――modelがrandomな不良部品をrandomな良品より上にrankする確率で、thresholdを完全に無視するもの――は0.0002しか動きません。これは何もないのと同じです。reweightingは、同じmodelを同じtrade-off curveに沿って滑らせただけです。それはしばしば望むことであり、決して新しい情報ではありません。rankingが悪いなら、どんなweighting schemeも救えません。
3つのsplitと、あなたが見つけることになるleak
セクション「3つのsplitと、あなたが見つけることになるleak」へのリンクなぜ2つではなく3つのsplitなのでしょうか。exampleのsetを使って何かを 選ぶ その瞬間――threshold、learning rate、6つのmodelのうちどれをshipするか――そのsetはfittingに使われたことになり、そのscoreはunbiasedではなくなるからです。3 このベルトで測定すると、validation set上でthresholdをsweepすると0.196が選ばれ、そのmodelは未接触のtest setで F1 = 0.4122 を出します。もしtest set上で直接sweepしていたら、そこでのbest achievableは 0.4186 でした――誰も報告する権利のない数字です。
ここでのgapは0.006と小さいです。これは4,000個のvalidation examplesに対して、1つのhyperparameterを1回sweepしただけだからです。追加のdecisionが増えるたび、validation setが小さくなるたびに、gapは大きくなります。また、1回のrunで方向が保証されるわけではないことにも注意してください。選ばれたthresholdはvalidationで0.3902、testで0.4122だったので、今回はvalidationが 過小評価 しました。biasは多くのdecisionにわたってsystematicに現れるもので、1回では見えません。4
ここで演習です。ベルトlogに3つ目の列 station_seconds が届きます。各部品がinspection stationにいた時間です。これを加えるのはpreprocessingへの1行の変更です。結果はこうなります。
| model | accuracy | precision | recall | F1 | cross-entropy | AUC |
|---|---|---|---|---|---|---|
| width + weight | 0.9830 | 0.800 | 0.108 | 0.190 | 0.0564 | 0.9363 |
| + station_seconds | 0.9920 | 0.792 | 0.770 | 0.781 | 0.0236 | 0.9970 |
recallは10.8 %から77.0 %へ上がります。F1は4倍以上になります。そしてaccuracyがどうなったかに注目してください。98.30 % → 99.20 %、0.9 pointのgainです。summary slideでは「どちらにせよ約99 %」と丸められがちな種類の数字です。accuracyは先ほどfailureを見抜けず、今度はfraudを見抜けません。
読み進める前に、このmodelはcheatingしています。どうやってかを見つけてください。
leakを狩る方法、最速で見つける順番。
-
trainとtestを比較する。 overfittingは大きなgapとして現れます。ここでは、honest modelが0.9838 train / 0.9830 test、leaky modelが0.9936 train / 0.9920 testです。どちらのgapも0.2 point未満です。leakはoverfittingのようには見えません――leaky featureはtest timeでも同じようにavailableなので、modelは存在しない世界へ美しくgeneraliseします。
-
featureごとに単独でmodelをtrainする。 答えを運ぶものは、自分から名乗り出ます。
feature alone accuracy recall F1 AUC width 0.9815 0.014 0.026 0.8691 weight 0.9815 0.000 0.000 0.7914 station_seconds0.9850 0.405 0.500 0.9960 ある1列だけで、単独で、AUC 0.9960でdefectsをrankします。caliperとscaleで取った2つのmeasurementは0.87と0.79です。この非対称性がalarmです。
-
各数字がいつ書き留められたかを尋ねる。 平均dwell timeは、passedした部品で 2.23秒、failedした部品で 15.56秒 です。もちろんそうです。部品がstationに留まるのは、inspectorがそれをベルトから外したから です。それは誰かが不良だと判断した後に、そしてその判断があったからこそ起こります。この列は部品のmeasurementではありません。verdictのmeasurementです。
station = 1.8 + rng.exponential(0.35, N)                     # a part just passing through
audited = rng.random(N) < 0.006                              # random spot checks
station[audited] += rng.uniform(6.0, 26.0, audited.sum())
station[y == 1] = 9.0 + rng.exponential(7.0, (y == 1).sum())
highlightされた行がleakです。不良部品のdwell timeは別の分布からdrawされています。人間がそれをベルトから外したからです。これはapplied machine learningで最も一般的な深刻なbugであり、名前があります。target leakage――predictionを行わなければならない瞬間にはavailableでない情報がtraining featuresに入っていることです。5 exceptionは投げません。より良い数字を生みます。project内のあらゆるincentiveは、それを残す方向に働きます。
防御策は、すべての列に対して1つの質問をすることです。このpredictionが必要なその瞬間に、この値はすでに存在しているか? live beltでは、station_seconds は部品が検査された後まで不明です。そして検査こそ、modelが置き換えるはずだったものです。
test exampleはいくつ必要か?
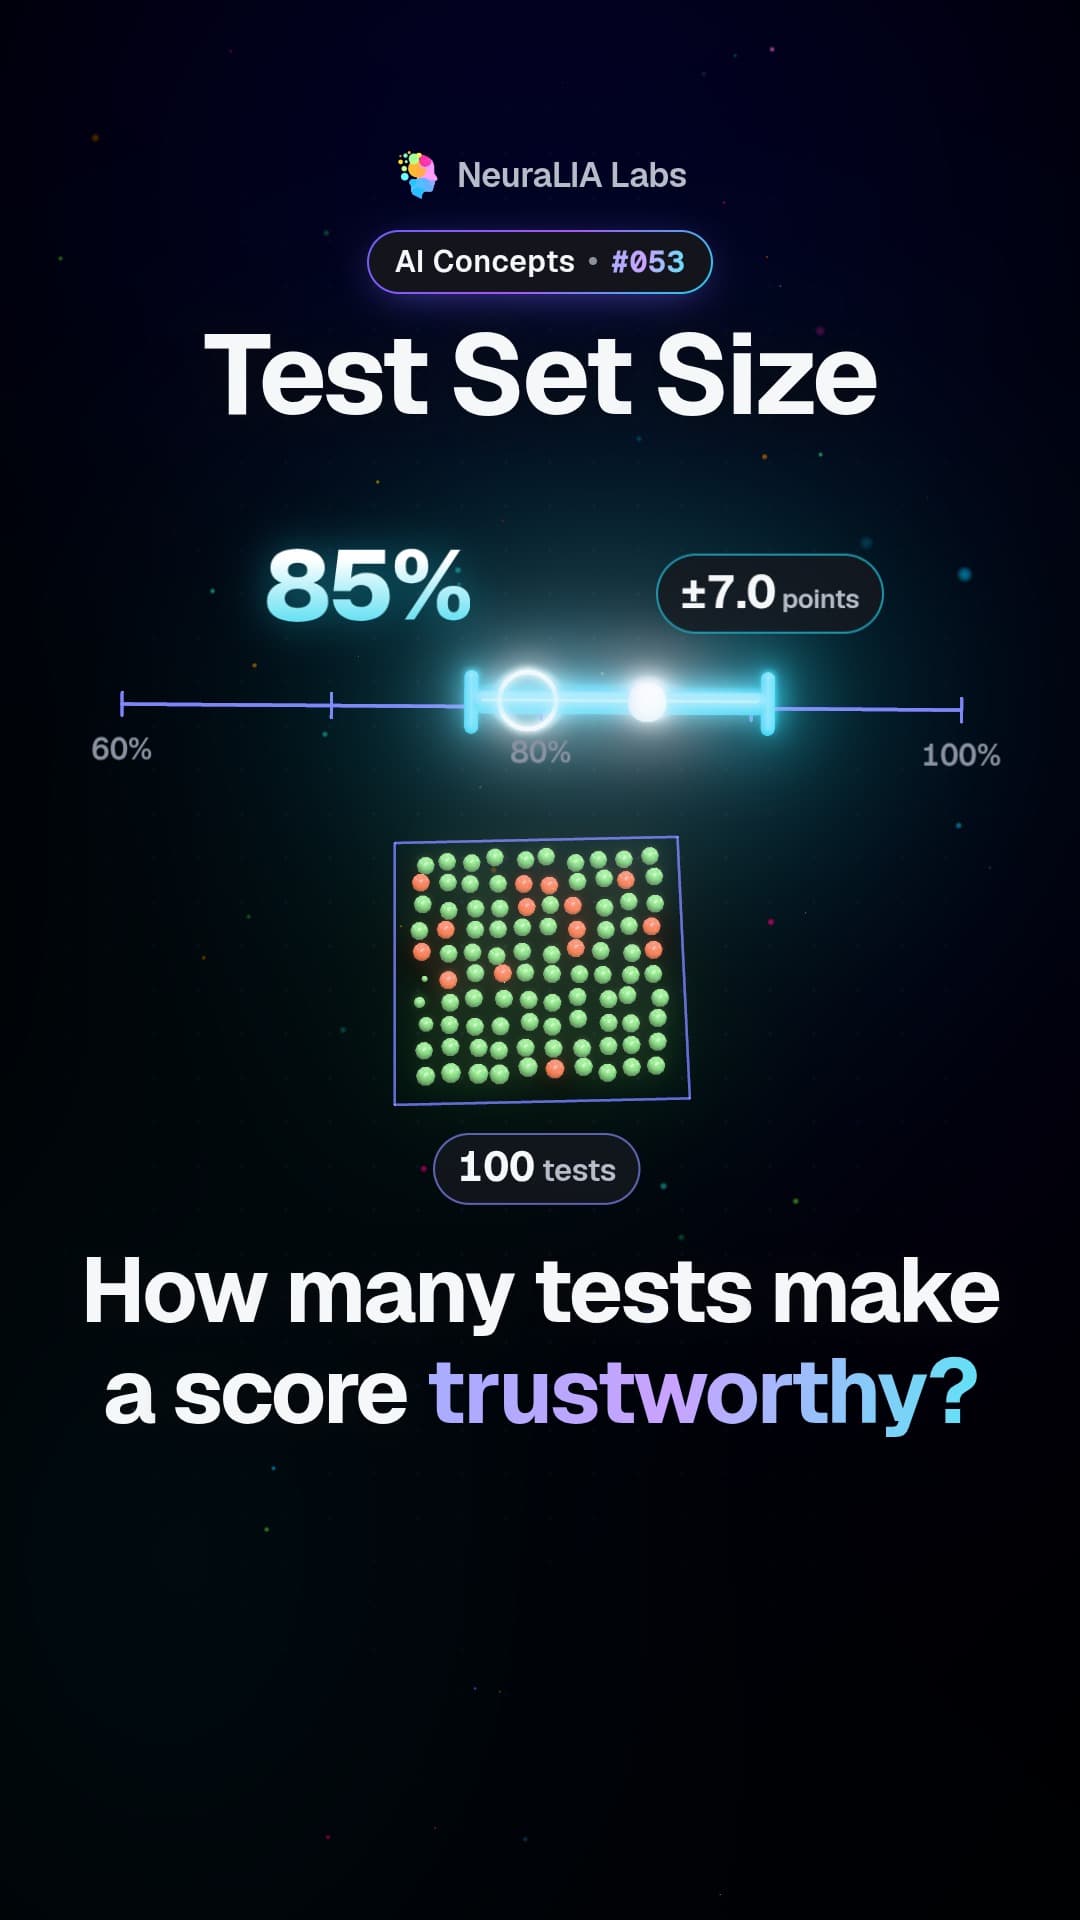
セクション「test exampleはいくつ必要か?」へのリンク20個のexampleでmodelをscoreし、17個正解したとします。85 %と報告します。
17 correct out of 20 -> accuracy 0.8500
  Wilson    95% CI : [0.6396, 0.9476]
  bootstrap 95% CI : [0.7000, 1.0000]
  P(a 65% model scores 17 or more out of 20) = 0.0444
P(an 85% model scores 17 or more out of 20) = 0.647717/20の正直な読み方は、64 %から95 %のどこか です。本当に65 %のmodelでも、この結果を4.4 %の確率で出します――23回に1回です。そしてもしあなたが一握りのpromptsを試し、bestを報告したなら、そのrunを自分で製造したことになります。20個中17個では、85 %のmodelと65 %のmodelを区別できません。
rateにintervalを付ける方法は2つあり、どちらもtoolkitに入れるべきです。
def wilson(k, n, z=1.959963985):
    """95% interval for k successes in n trials. Correct at small n; no simulation."""
    ph, d = k / n, 1 + z * z / n
    centre = (ph + z * z / (2 * n)) / d
    half = z * (ph * (1 - ph) / n + z * z / (4 * n * n)) ** 0.5 / d
    return centre - half, centre + half


def bootstrap_ci(correct, n_resamples=10_000, alpha=0.05, seed=0):
    """95% interval for the mean of any per-example score array. Works on F1 too."""
    rng = np.random.default_rng(seed)
    correct = np.asarray(correct, dtype=float)
    draws = correct[rng.integers(0, len(correct), size=(n_resamples, len(correct)))]
    lo, hi = np.quantile(draws.mean(axis=1), [alpha / 2, 1 - alpha / 2])
    return float(correct.mean()), float(lo), float(hi)
通常のsuccess rateには Wilson6 を使ってください。任意の でwell behavedであり、randomnessを必要としません。上で のときbootstrapのupper endが1.0000であることに注意してください。20点をresampleすると20個正解を簡単にdrawできるため、自身のgranularityより狭いintervalを表現できません。bootstrap7 はformulaが存在しない場合に使います。それが興味深いcaseの大半です。F1、macro-averages、BLEU、pass@1、rubric-based judgeのscoreなどです。このベルトでは、tuned modelのF1 0.4122には [0.3009, 0.5156] のbootstrap intervalが付きます。reportに載せるべき数字はこちらです。point estimateだけでは、それが支えられない比較を誘ってしまうからです。
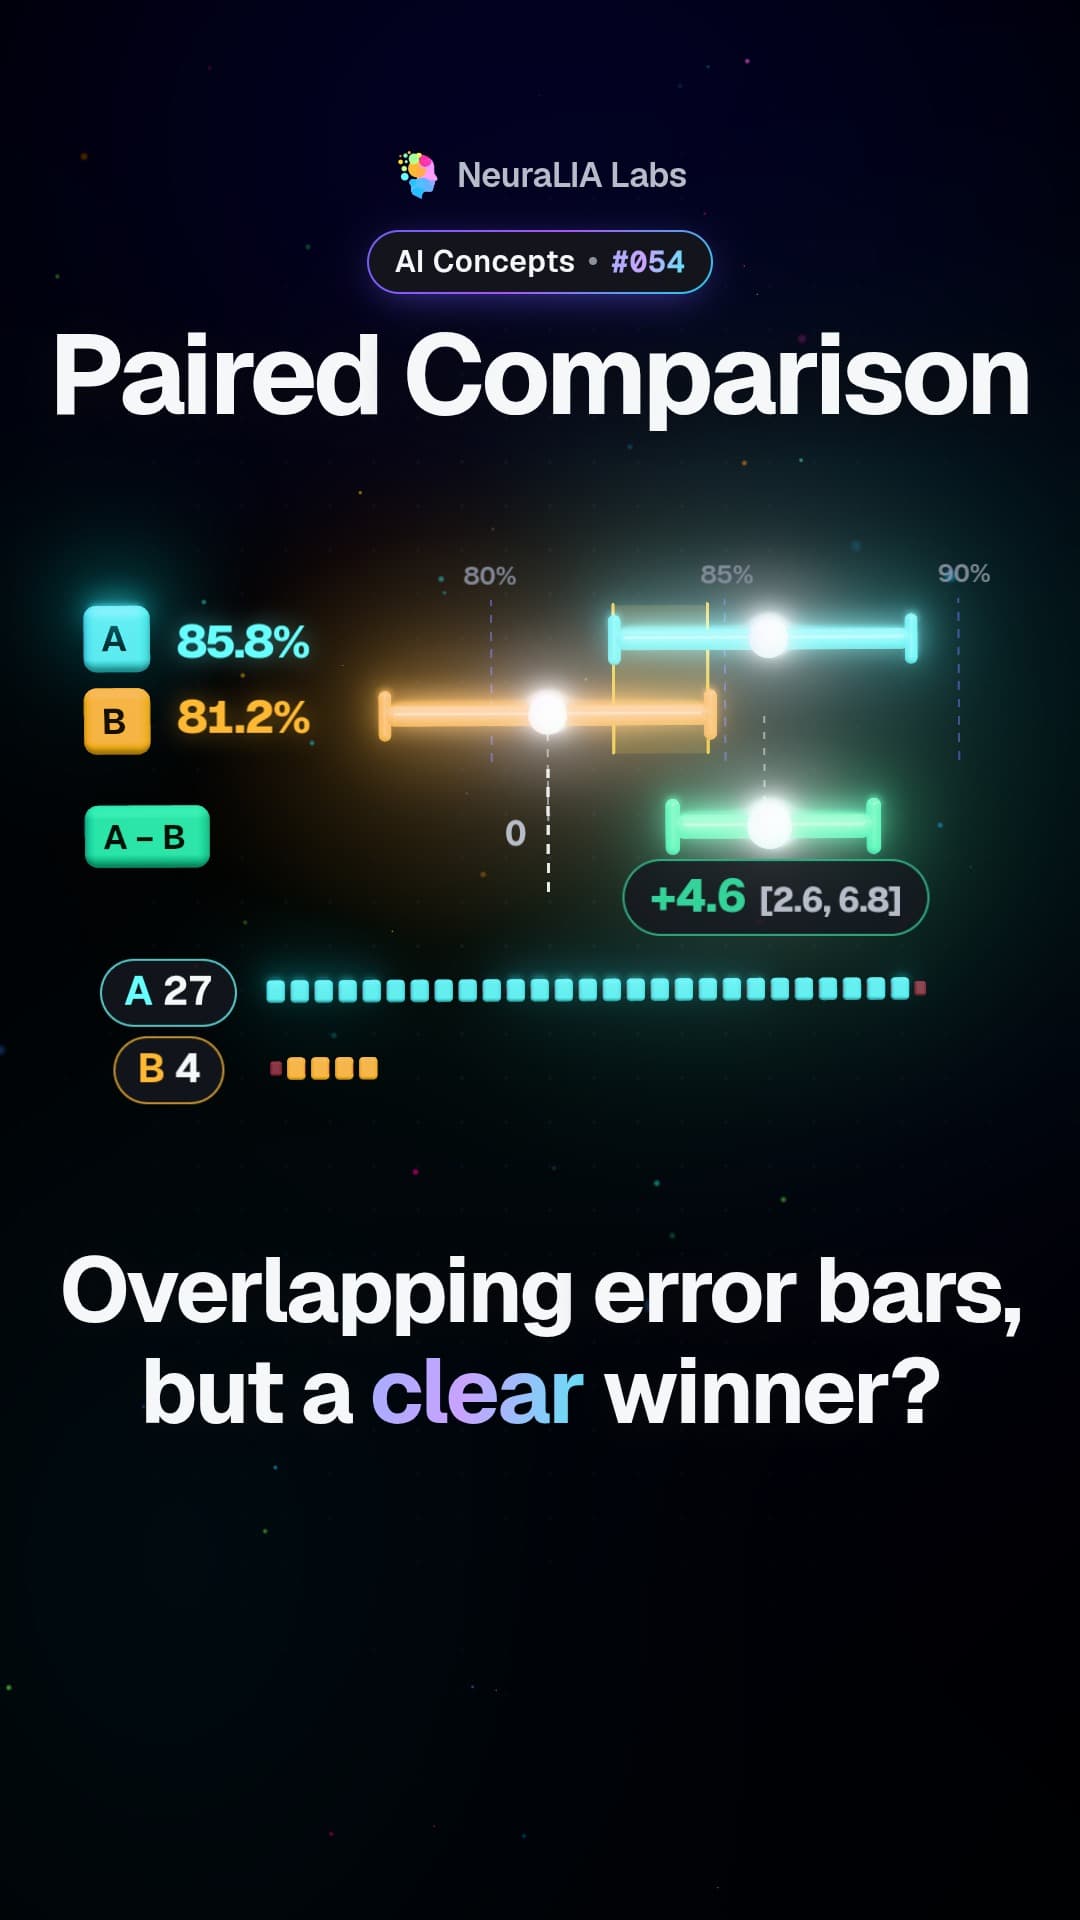
もう1つmeasurementします。2つのmodelを比較する方法が変わるからです。同じ500 examplesでscoreされた2つのmodelです。
model A: 0.8580  95% CI [0.8260, 0.8880]
model B: 0.8120  95% CI [0.7780, 0.8460]
the two intervals overlap: True
paired difference A-B: 0.0460  95% CI [0.0260, 0.0680]
they disagree on 31 of 500 examples (A right 27, B right 4)intervalは重なっています。そして民間rule――error barsが重なっているなら有意差はない――なら、この比較をinconclusiveと呼ぶでしょう。しかしそうではありません。2つのmodelは 同じexamples 上で走っているので、正しい量はexampleごとの差です。そのintervalは [0.0260, 0.0680] で、十分に0を上回っています。両者がdisagreeするのは500 items中31個だけで、Aはそのdisagreementのうち27個で勝っています。easyもhardも含む共有examplesは、noiseを追加するのではなく相殺します。modelはpairedで比較してください。そうすれば、dataのごく一部で同じ結論に到達できます。
次にどこへ進むか
セクション「次にどこへ進むか」へのリンクこれで、calibrateされた確率を出力するmodel、便利さで選んだのではなくdataについての主張から導かれたloss、文字通り prediction minus truth であるgradient、そして――さらに重要なことに――それが機能しているかどうかを見つけるための仕組みが手に入りました。上の10行のWilson intervalは、そのまま再利用されます。第15章のprompt variants、第19章のretrieval tables、第29章のgolden setを支えます。formulaが存在しないときに手を伸ばすのがbootstrapです。
しかしmodelはまだ1 layerです。線を引くだけであり、第1章はXORの4行で、線では足りないことを証明しました。修正はstackすることです。第一のlayerがspaceを曲げ、第二のlayerがその曲がったspaceで線を引きます。
ここで、この章の整ったgradientは限界を迎えます。上のすべてが機能したのは、inputとlossの間に1 layerしかないmodelについて、 を一度だけ手で書き下せたからです。中央に第二のlayerを置くと、問いの形が変わります。outputにまったく触れていないweight――その影響が別のlayerを通じて、場合によっては複数のpathを同時に通って届くweight――に対するlossのderivativeとは何か。
そのderivativeは存在します。toyより大きなものについて手で計算するのは絶望的であり、parameterを1つずつ計算するのも別のscaleで絶望的です。必要なのは、forward passがたどった同じgraphを1回backward passするだけで、network内のすべてのderivativeを得るprocedureです。
それが第5章であり、このコースの残りを動かすengineです。
Sources and method
セクション「Sources and method」へのリンクこの章と併せて読む価値があるものとして、Bishop, Pattern Recognition and Machine Learning §1.2, §1.5, §1.6 and §4.3 があります。この章がたどる順序で、probability、decision theory、information theory、linear classificationを扱っています。また、Murphy, Probabilistic Machine Learning: An Introduction, chapters 6 and 10、Prince, Understanding Deep Learning §5.4–5.7、そして Saito and Rehmsmeier, The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets (PLOS ONE, 2015) も参照してください。上で引用したAUCが、部品の1.7 %しか不良でないときに見るべき唯一のthreshold-freeな数字であってはならない理由が分かります。
参考文献
セクション「参考文献」へのリンク-
Ma, T. and Ng, A. CS229 Lecture Notes, Stanford University, chapters 2 and 3. を生む相殺がluckに見えなくなる場所です。outputに合うexponential-family distributionを選び、そのcanonical linkを使えば、gradientは常にprediction minus truthになります。 ↩
-
Olah, C. Visual Information Theory (2015),
colah.github.io/posts/2015-09-Visual-Information。entropy、cross-entropy、KL divergenceをformulaとしてではなく、bits単位のcostとして説明した、入手可能な中で最も明快な解説です。 ↩ -
Abu-Mostafa, Y. S., Magdon-Ismail, M. and Lin, H.-T. Learning From Data (AMLBook, 2012), lectures 13 and 17 of the Caltech course. Lecture 13はvalidation、3つのlearning principlesを扱うlecture 17は data snooping が名付けられる場所です。この2つが、この章の規律のsourceです。data setを見るたび、それはfitting decisionです。optimiserを走らせたかどうかは関係ありません。 ↩
-
James, G., Witten, D., Hastie, T. and Tibshirani, R. An Introduction to Statistical Learning, 2nd edition (Springer, 2021), chapters 2 and 5。bias–variance decompositionとresamplingについて。companion volumeではselection trapが明示的に述べられています。Hastie, Tibshirani and Friedman, The Elements of Statistical Learning, 2nd edition, §7.10.2, The Wrong and Right Way to Do Cross-validation。 ↩
-
Kaufman, S., Rosset, S., Perlich, C. and Stitelman, O. Leakage in Data Mining: Formulation, Detection, and Avoidance. ACM Transactions on Knowledge Discovery from Data 6(4), 2012. 上で示したfailureのformal treatmentであり、dataの組み立て方のartefactをmodelがlearnしたことで勝利したcompetitionのcase studiesを含みます。 ↩
-
Wilson, E. B. Probable Inference, the Law of Succession, and Statistical Inference. Journal of the American Statistical Association 22(158), pp. 209–212 (1927). 上の
wilson()で使ったscore intervalで、proportionに対する今でも正しいdefaultです。避けるべきなのは教科書的なinterval です。0や1の近くでnonsenseを出し、小さな ではcoverageがひどく不足します。 ↩ -
Efron, B. Bootstrap Methods: Another Look at the Jackknife. The Annals of Statistics 7(1), pp. 1–26 (1979). sampling theoryがないものも含め、計算できる任意のstatisticにintervalを付けられるようにする考え方です。 ↩
この章を動画で見る
この章のアイデアをわかりやすく解説する短い動画です。
 #033
Logistic regression: from a yes-or-no verdict to a probability
 #034
Cross-entropy: the score that makes AI pay for confident mistakes
 #035
Sigmoid: the S-shaped curve that turns any score into a probability
 #036
Logits: the raw bet a model places before it gives you a percentage
 #037
Cross-entropy vs MSE: why squared error stalls on its worst mistakes
 #038
Entropy: measuring surprise, and the floor no blind guess can beat
 #039
KL divergence: the price of believing the wrong odds
 #040
Softmax: how raw AI scores become chances that add up to 100%
 #041
Calibration: when an AI's confidence matches how often it is right
 #042
Loss vs metric: what an AI trains on is not what it's graded on
 #043
The accuracy paradox: 98% accurate and it catches nothing
 #044
Confusion matrix: the four boxes that show how a model fails
 #045
Precision and recall: is the alarm right, and does it catch enough?
 #046
F1 score: the one number that won't let a model hide its weak spot
 #047
Decision threshold: why a less accurate model can be far more useful
 #048
AUC: how well a model ranks, before you set any alarm line
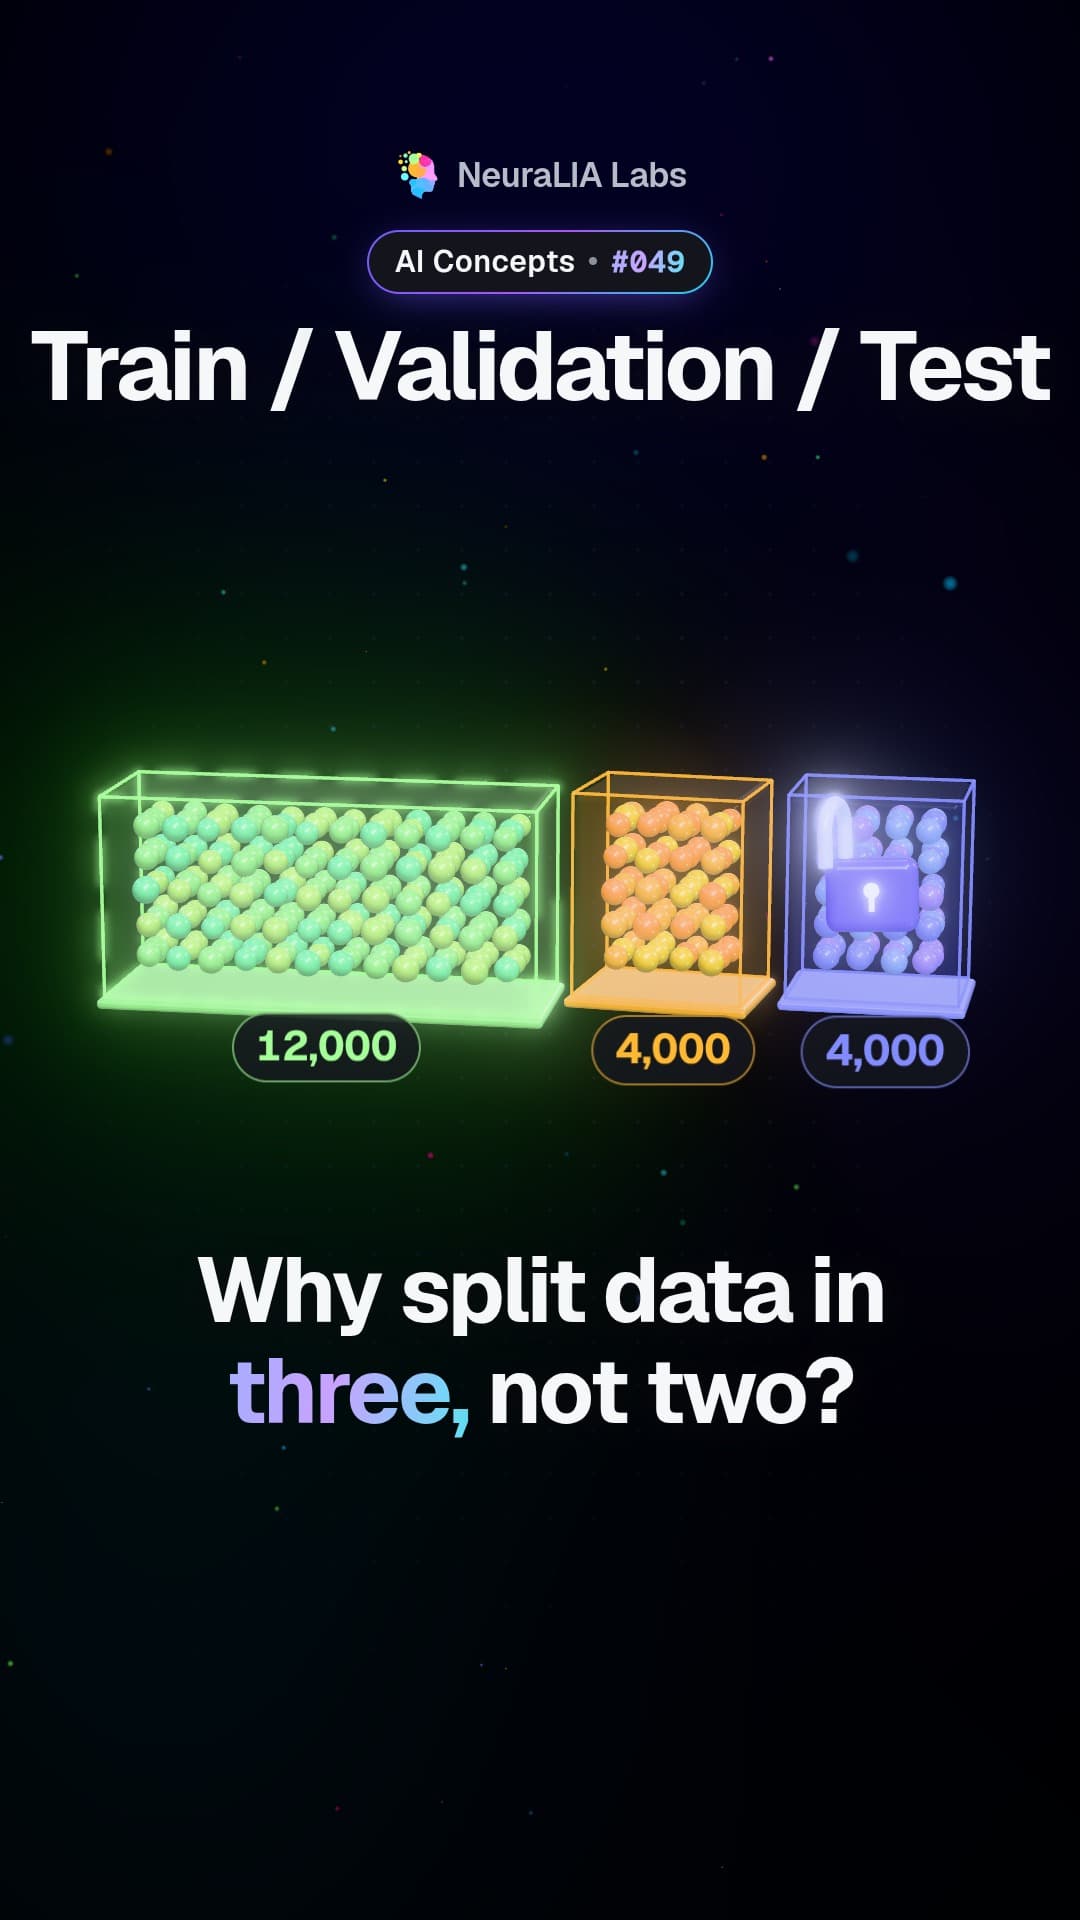 #049
Train, validation and test: why the final exam stays sealed
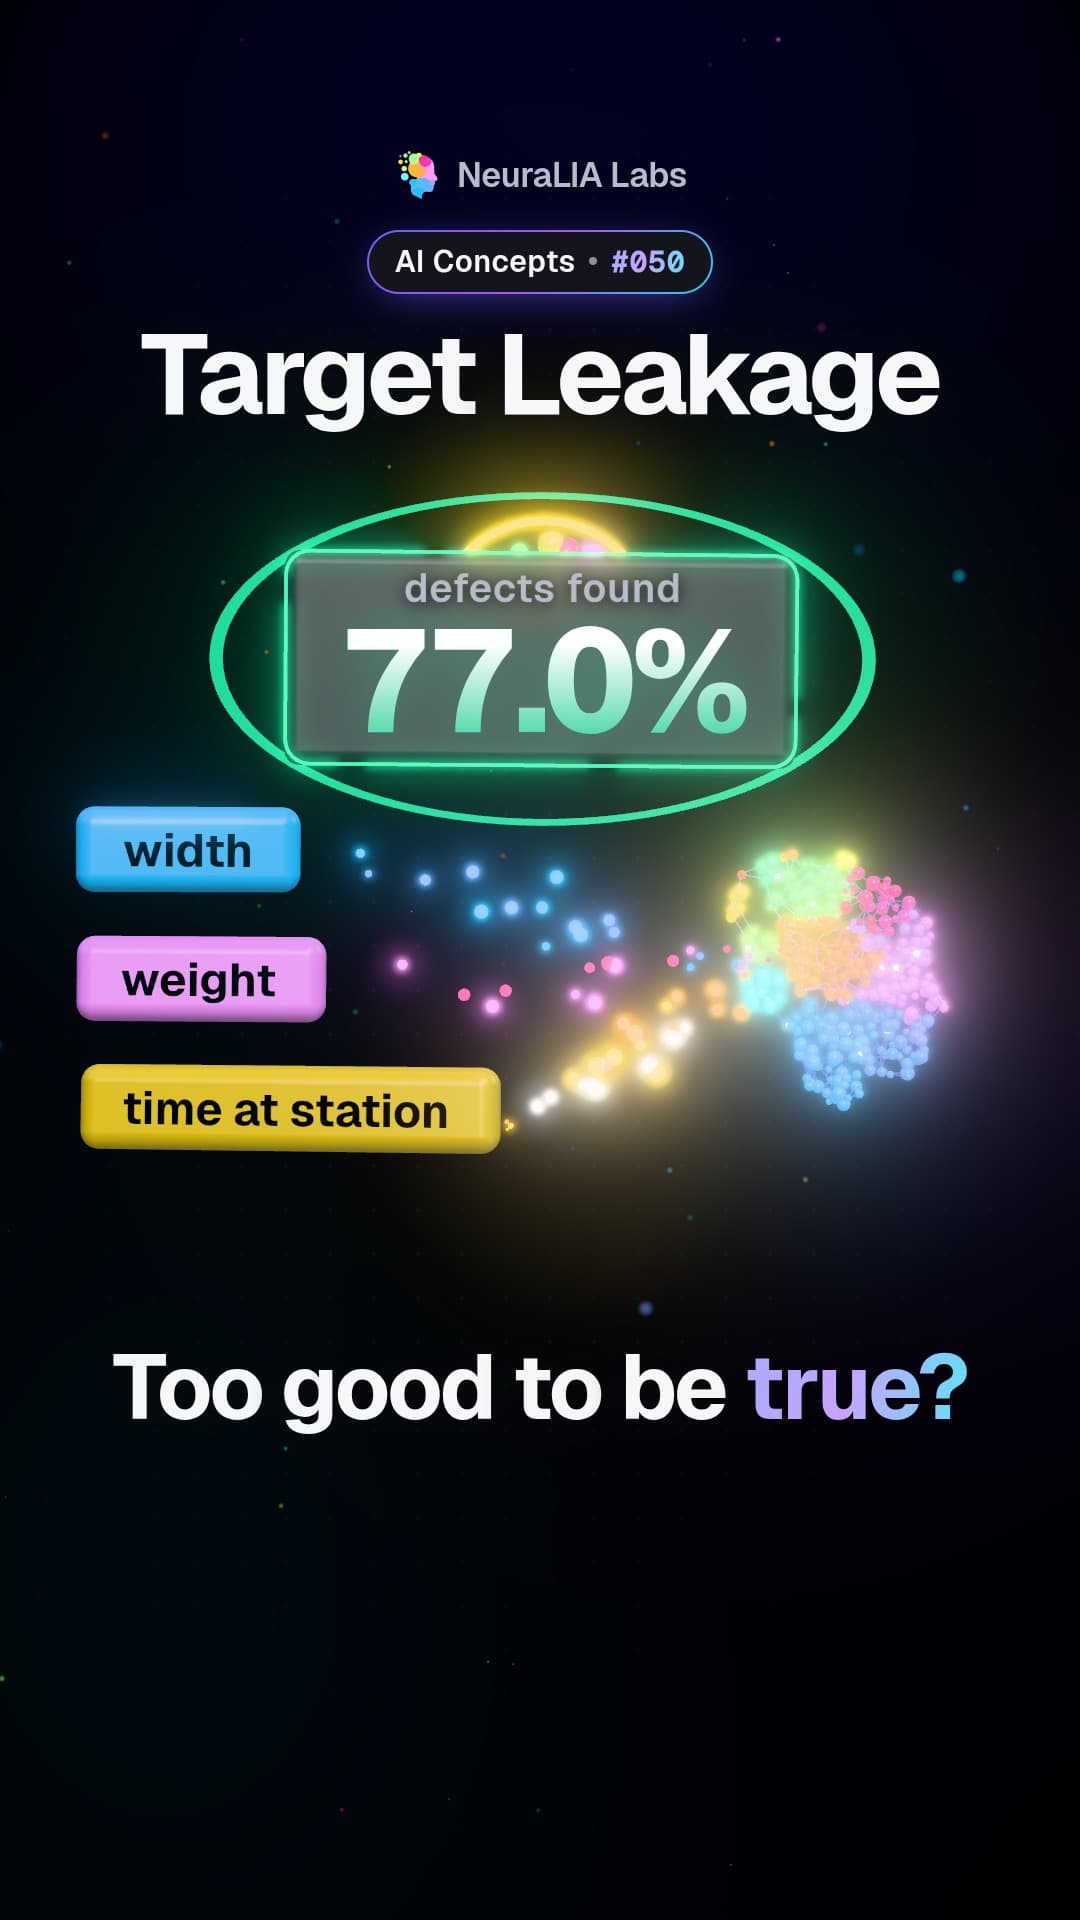 #050
Target leakage: when an AI model secretly sees the answer
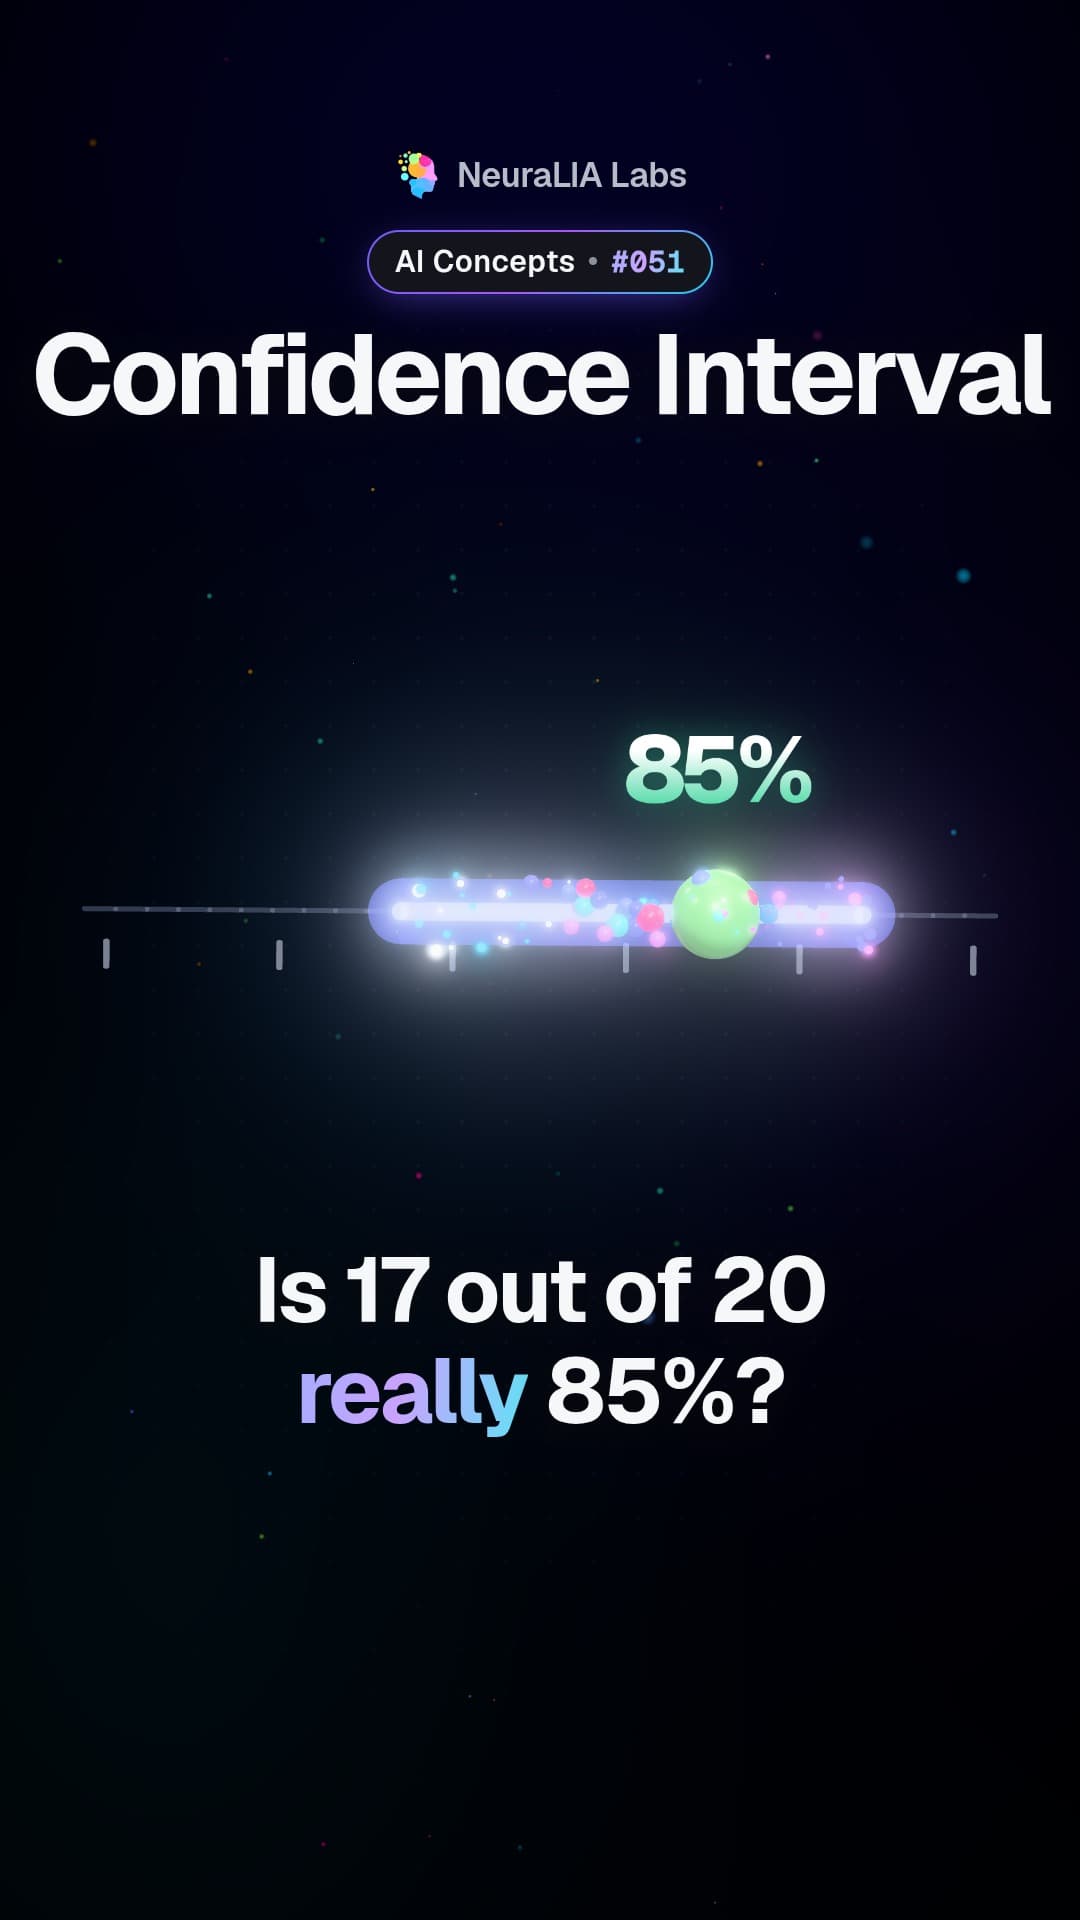 #051
Confidence intervals: why 17 out of 20 proves less than you think
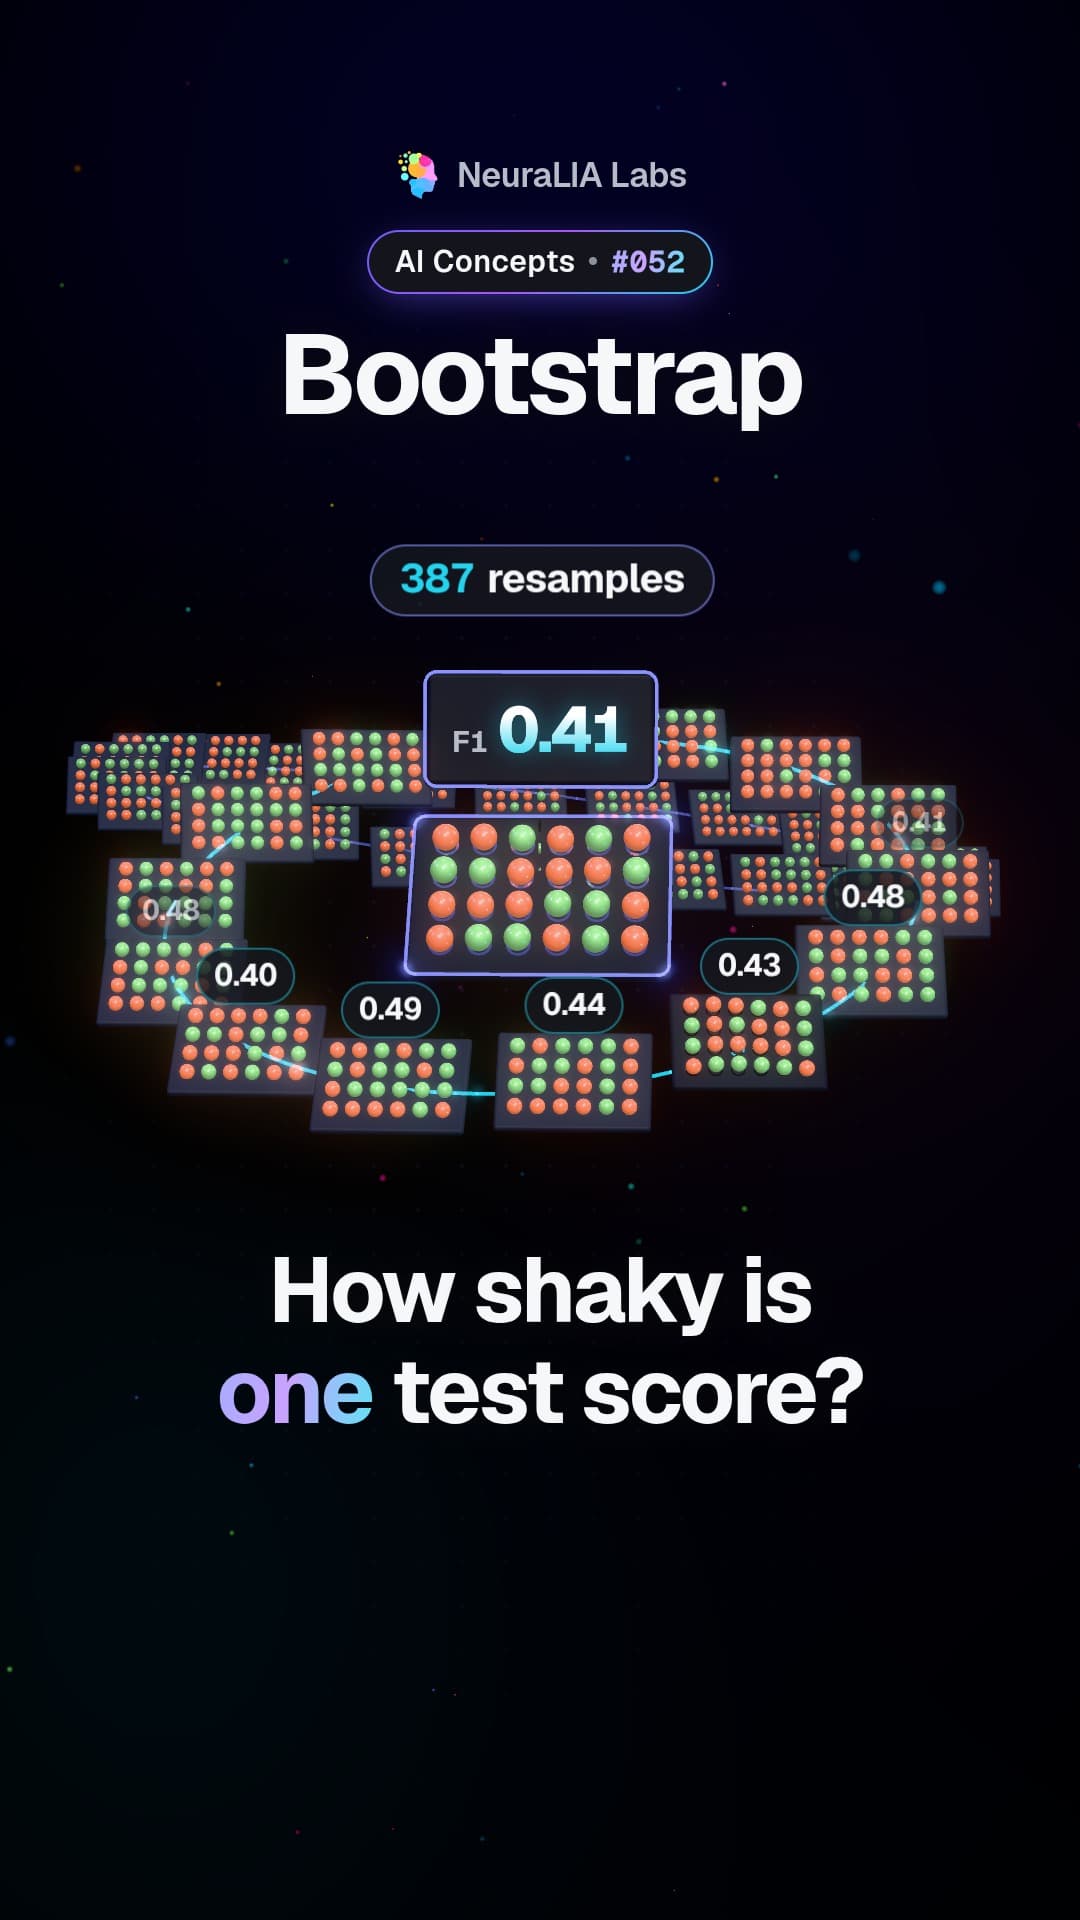 #052
Bootstrap: how to put error bars on any AI score
 #053
Test set size: how many examples an honest AI score needs
 #054
Paired comparison: the fair way to tell two AI models apart