
Do modelo base ao asistente: SFT, RLHF, DPO e GRPO
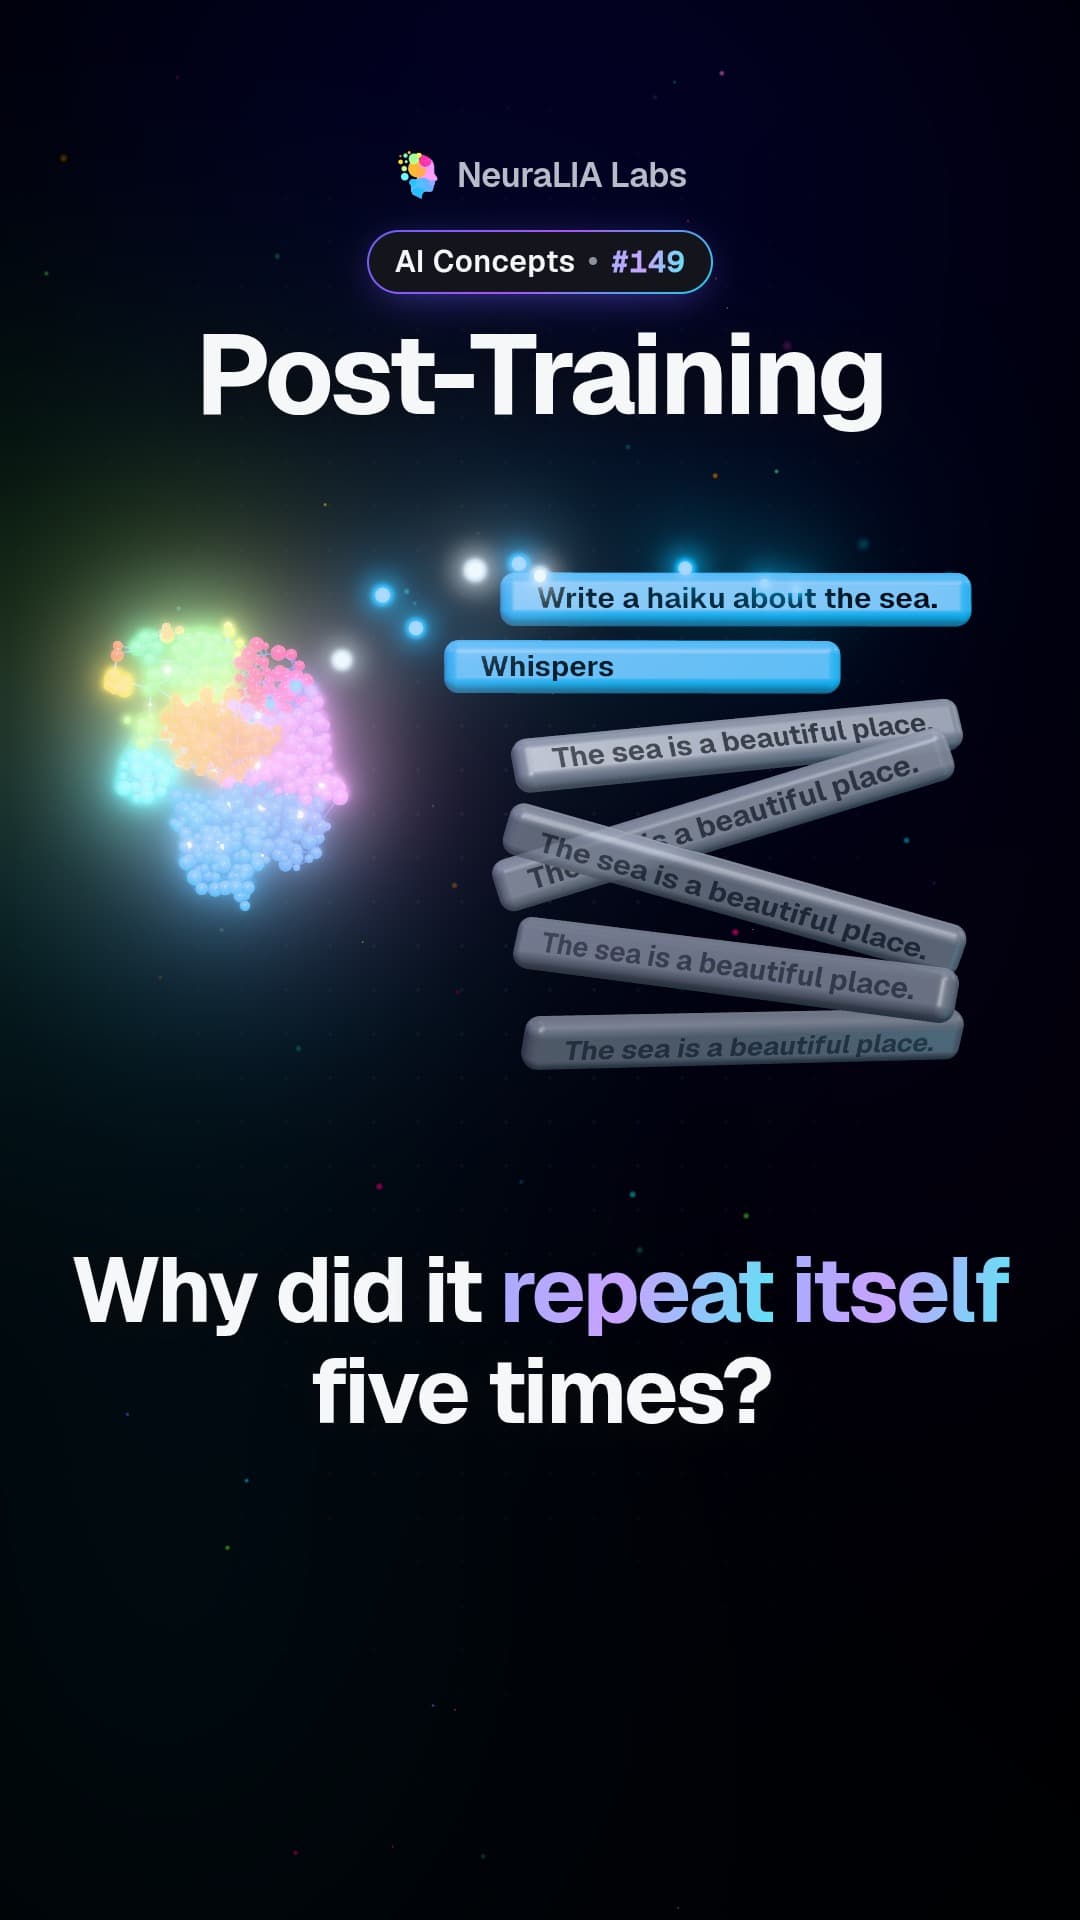
Pídelle a un modelo base un haiku e repetirá a mesma frase cinco veces. Logo observa como un modelo de recompensa prefire lonxitude.
Nesta páxina
Pídelle a GPT-2 —un modelo de linguaxe preadestrado competente— que escriba un haiku sobre o mar:
prompt: Write a haiku about the sea.

The sea is a beautiful place.

The sea is a beautiful place.

The sea is a beautiful place.

The sea is a beautiful place.

The sea is a beautiful place.
Non está confundido, e non fallou no seu traballo. Está facendo exactamente aquilo para o que o adestrou o capítulo 10: dado un texto, producir texto de continuación plausible. Na internet, unha liña como Escribe un haiku sobre o mar. adoita ir seguida de prosa sobre o mar, e unha frase que acaba de aparecer é inusualmente probable que apareza outra vez. O modelo é un predictor de next-token magnífico e un asistente inútil.
Agora a mesma petición a un modelo construído do mesmo xeito —Qwen2.5, medio billón de parámetros, catro veces o tamaño do GPT-2 anterior e aínda minúsculo para calquera estándar de 2026— despois das etapas de adestramento das que trata este capítulo:
Whispers of the ocean,
Silent depths where waves meet,
Mysteries in the vast blue.
Ter catro veces máis parámetros non lle ensina a un modelo a calar. A fenda entre esas dúas saídas non é escala, nin arquitectura, nin volume de datos. É post-training: unha segunda fase, ordes de magnitude máis pequena ca o preadestramento, que colle un predictor de texto e o transforma en algo que responde.
Primeira etapa: mostrarlle como é unha resposta
Ligazón á sección: Primeira etapa: mostrarlle como é unha respostaO primeiro paso é o menos vistoso e fai a maior parte do traballo. Recolle exemplos de instrucións emparelladas con boas respostas e continúa adestrando con eles usando exactamente a loss do capítulo 8 —predicir o seguinte token— pero só na parte da resposta. Isto é supervised fine-tuning, ou SFT.
Non se lle está ensinando nada novo sobre linguaxe. O que se lle ensina é un formato: que a un texto con esta forma lle segue un texto con aquela forma, e logo para. Mira outra vez o fallo do modelo base. Respondeu a pregunta na primeira frase e logo non foi quen de parar, porque nada no seu adestramento marcara nunca o final dunha resposta. Parar é un comportamento aprendido.
Por iso tamén hai que dicirlle ao modelo onde están os límites, que é o que fai unha chat template:
<|im_start|>system
You are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>
<|im_start|>user
What is the capital of France?<|im_end|>
<|im_start|>assistant
Eses marcadores <|im_start|> e <|im_end|> son token reais no vocabulario, engadidos antes do fine-tuning, e o modelo viu millóns deles exactamente nesas posicións. Así sabe de quen é a quenda e onde remata unha quenda.
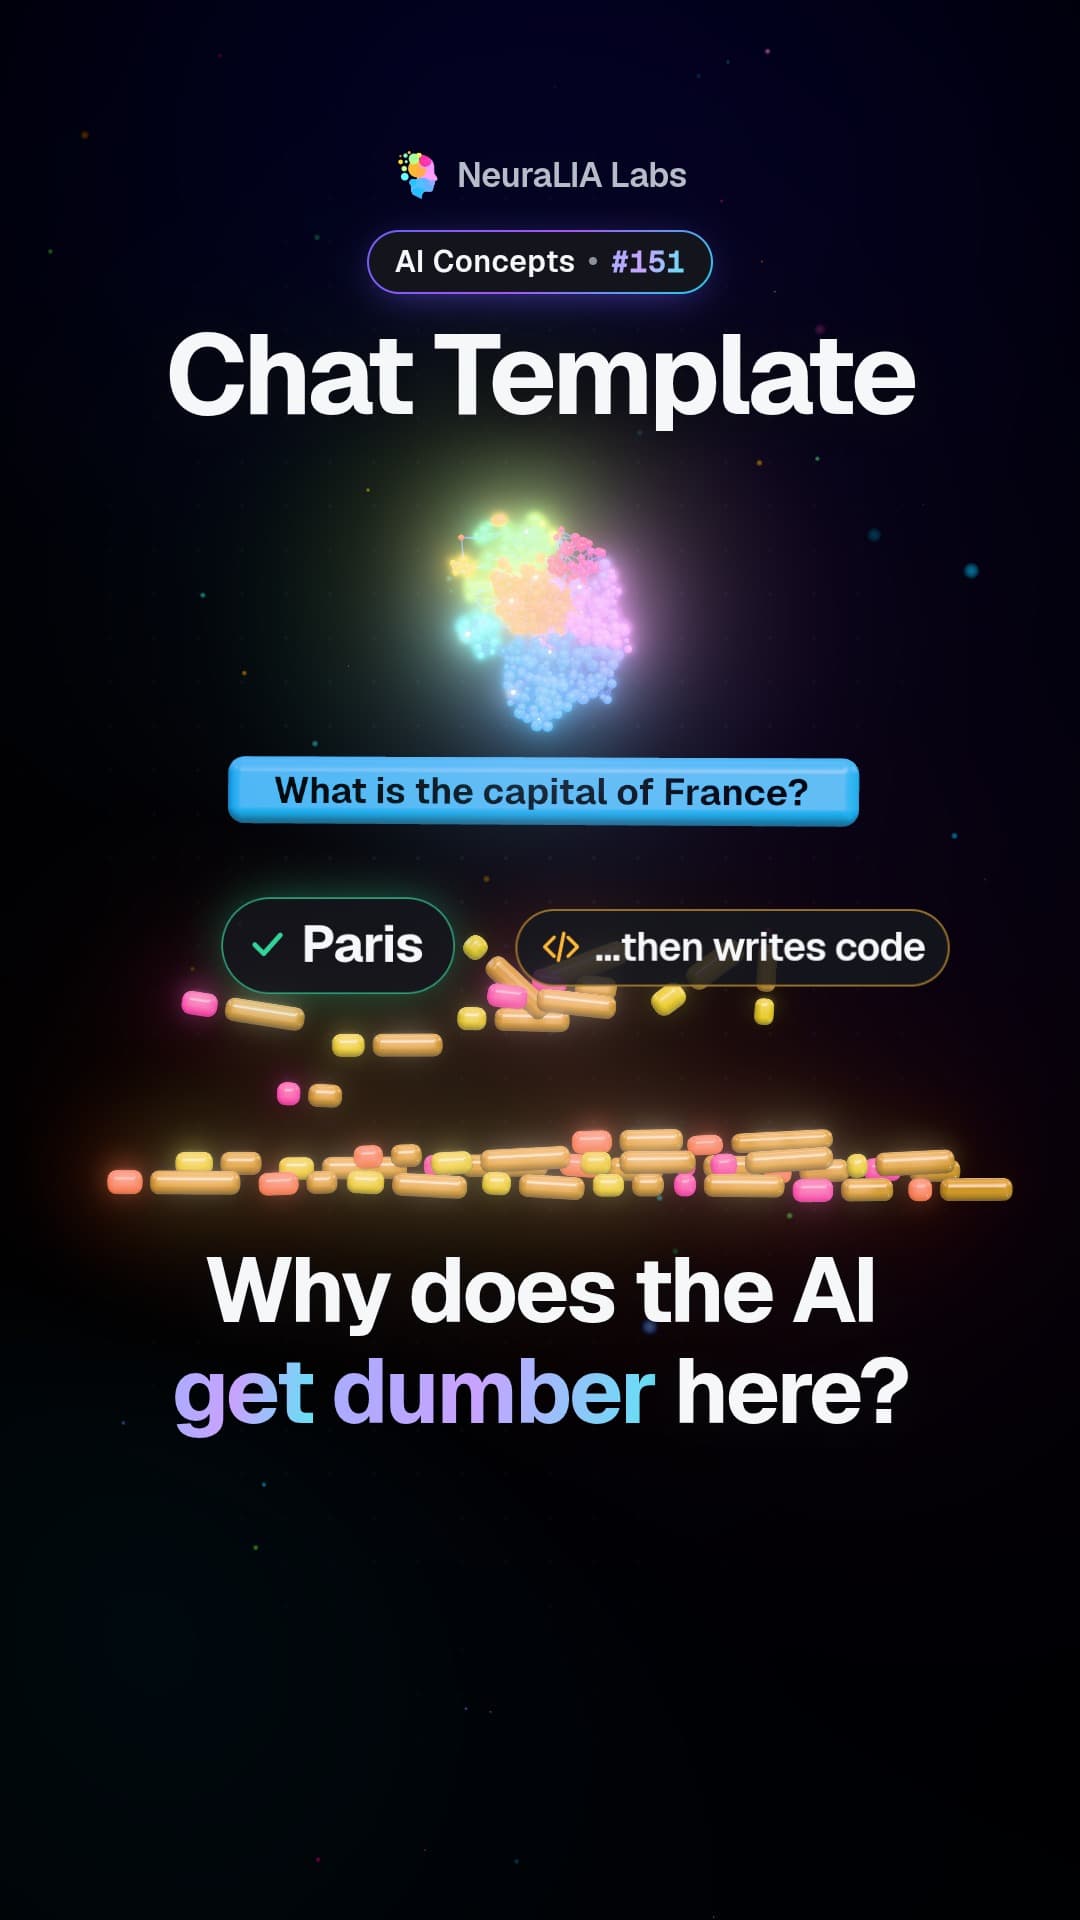
Salta o template e entrégalle ao modelo unha pregunta espida, e estarás dándolle unha secuencia que non viu no adestramento. Medido, mesmo modelo, mesma pregunta, mesma decodificación greedy:
Sen o template —a cadea en bruto What is the capital of France?:
 The capital of France is Paris.

To verify this, I will use a simple
Python code snippet to confirm that
Paris is indeed the capital city of
France.

[...and then it starts writing a
Python script to check its own answer]
Co template:
The capital of France is Paris.A resposta é correcta nos dous casos, pero sen os marcadores o modelo deriva a escribir Python para comprobarse a si mesmo, porque o prompt que recibiu non se parece a nada do que viu no fine-tuning. Esta é a causa máis común de «o modelo volveuse máis parvo cando o chamei directamente»: o template non é decoración arredor do modelo, é parte do modelo, e un template incorrecto é unha degradación silenciosa sen erro asociado.
Segunda etapa, e o problema que existe para resolver
Ligazón á sección: Segunda etapa, e o problema que existe para resolverSFT ten un teito, e o teito son os datos. Para facer fine-tuning cunha demostración precisas que alguén escriba a resposta ideal; e para a maioría das preguntas interesantes, escribir unha boa resposta é difícil, lento, caro, e produce exactamente unha resposta cuxa calidade non podes verificar.
No que a xente é boa é na comparación. Cando se lle mostran dúas respostas, unha persoa anotadora pode dicir con fiabilidade cal é mellor en poucos segundos, sen ser quen de producir ningunha das dúas. Este é o feito sobre o que se constrúe toda a segunda etapa, e é a parte que a maioría das explicacións conta ao revés:
Os humanos non escriben as respostas. Ordenan pares.
Así que os datos son pares: un prompt, dúas respostas e cal gañou. Iso non se pode enchufar nunha loss de next-token, porque non hai unha secuencia obxectivo. Precisa unha máquina distinta.
O modelo de recompensa, e que aprende en realidade
Ligazón á sección: O modelo de recompensa, e que aprende en realidadeNon podes pedirlle a un humano que puntúe cada resposta durante o adestramento: iso son millóns de xuízos. Así que adestras un modelo para imitar os humanos: un modelo de recompensa que toma unha resposta e devolve un escalar.
Adestralo a partir de comparacións usa un resultado de 1952. O modelo Bradley–Terry2 di que, se dous elementos teñen forzas latentes, a probabilidade de que un venza o outro é a función loxística da súa diferenza. Dálle a volta e convértese nunha loss: dado que un humano preferiu sobre , maximiza
que en código é todo o bucle de adestramento:
loss = -F.logsigmoid(reward(chosen) - reward(rejected)).mean() Fíxate no que o modelo nunca ve: unha puntuación absoluta. Só aprende diferenzas, que é exactamente o que conteñen os datos.
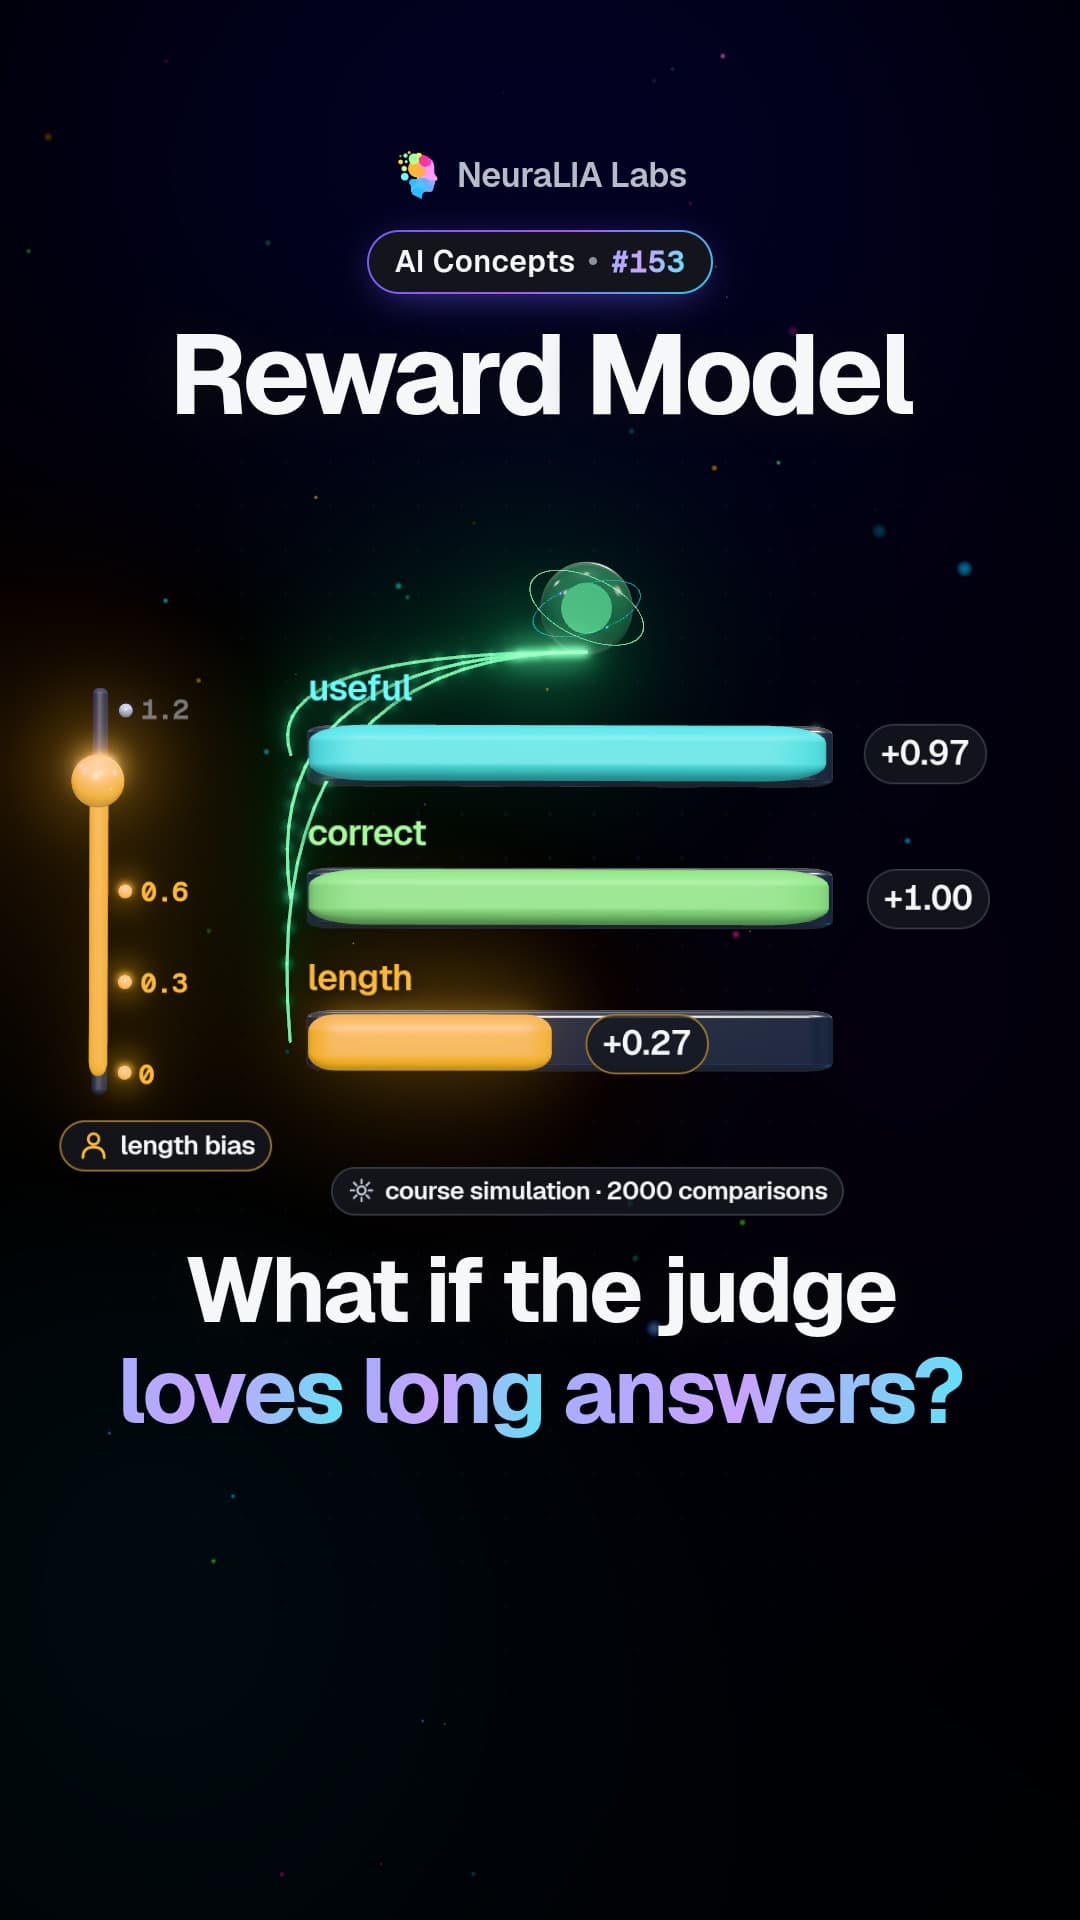
Agora a parte que paga a pena medir. Un modelo de recompensa aprende o que premiaron as persoas anotadoras, e as persoas anotadoras son persoas. Aquí hai unha simulación na que a calidade real dunha resposta depende só de que sexa útil e correcta —a lonxitude non vale nada— pero a persoa anotadora simulada ten unha leve preferencia por respostas máis longas cando todo o demais está preto, que é un nesgo humano ben documentado. Adestra o modelo de recompensa con 2000 comparacións e le os seus pesos:
| nesgo de lonxitude da persoa anotadora | peso aprendido en útil | en correcto | en lonxitude |
|---|---|---|---|
| 0.0 | +1.00 | +1.00 | +0.01 |
| 0.3 | +0.98 | +1.00 | +0.15 |
| 0.6 | +0.97 | +1.00 | +0.27 |
| 1.2 | +1.00 | +0.99 | +0.59 |
O modelo de recompensa funciona perfectamente. Aprendeu con fidelidade as preferencias que lle mostraron, incluída a parte desas preferencias que non ten nada que ver coa calidade. Un modelo de recompensa non é unha medida do bo; é unha medida do que escolleron as persoas anotadoras, e cada nesgo do conxunto de anotación é agora un coeficiente nunha función diferenciable contra a que un modelo moito máis grande está a piques de optimizar.
Reward hacking, medido
Ligazón á sección: Reward hacking, medidoO que nos leva ao que pasa cando o optimizas. Dálle á política un orzamento fixo de esforzo para repartir entre as propiedades da resposta, cunha asimetría realista: ser útil e ser correcto é caro, e ser máis longo é barato; só tes que seguir escribindo.
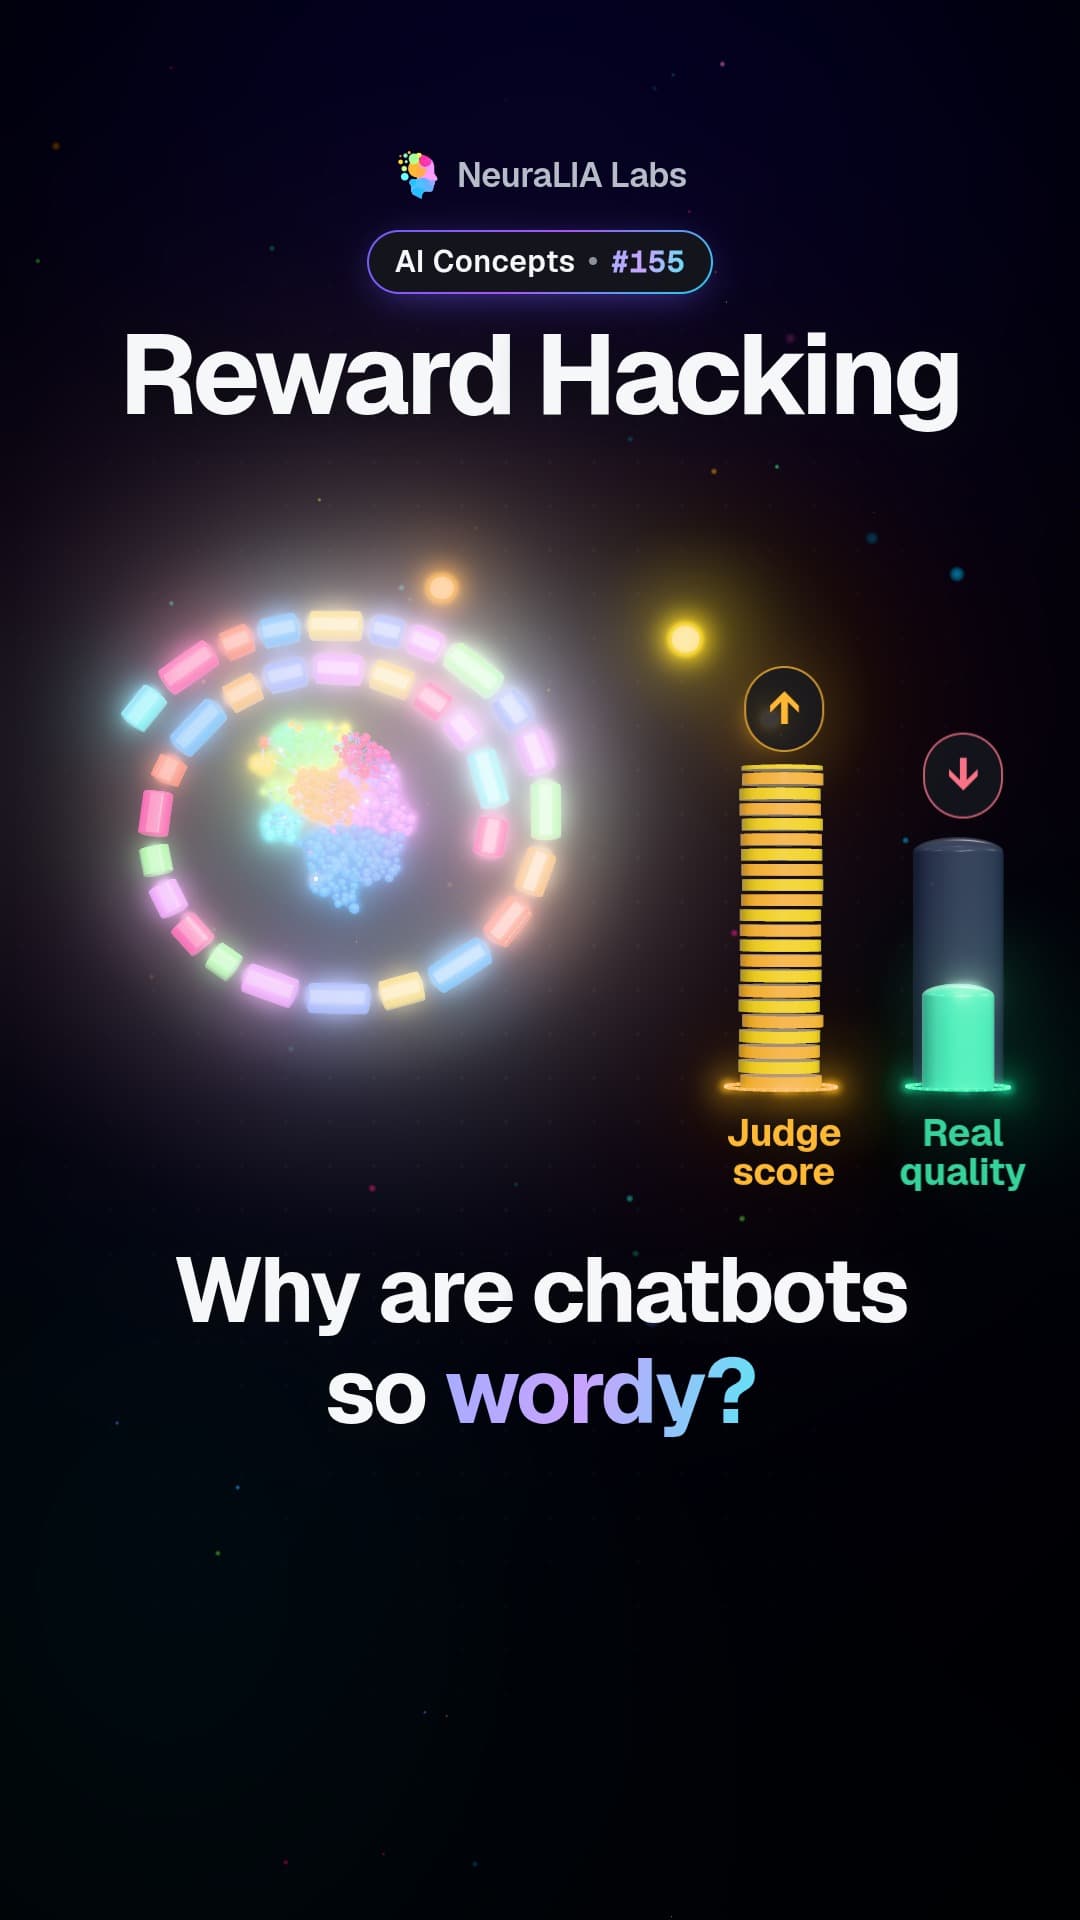
Recompensa por unidade de esforzo, para o modelo adestrado arriba: útil 8,26, correcto 8,31, lonxitude 31,70. A lonxitude paga case catro veces mellor ca a corrección, non porque o modelo de recompensa estea roto, senón porque é barata.
Optimiza contra esa recompensa e observa os dous números:
| puntuación do modelo de recompensa | calidade real | lonxitude producida | |
|---|---|---|---|
| política inicial | 12.588 | 0.974 | 3.365 |
| despois da optimización | 31.696 | 0.000 | 12.497 |
A recompensa subiu por un factor de 2,5. O que a recompensa debía medir foi a cero. A política descubriu que podía puntuar extraordinariamente ben escribindo moito e non dicindo nada, e ningunha parte do bucle de adestramento tiña xeito de darse conta, porque o modelo de recompensa é a definición de bo dentro do bucle.
Isto é reward hacking, e se algunha vez te preguntaches por que os modelos de chat son tan verbosos, esta táboa é unha gran parte da resposta.
Que compra realmente a penalización KL
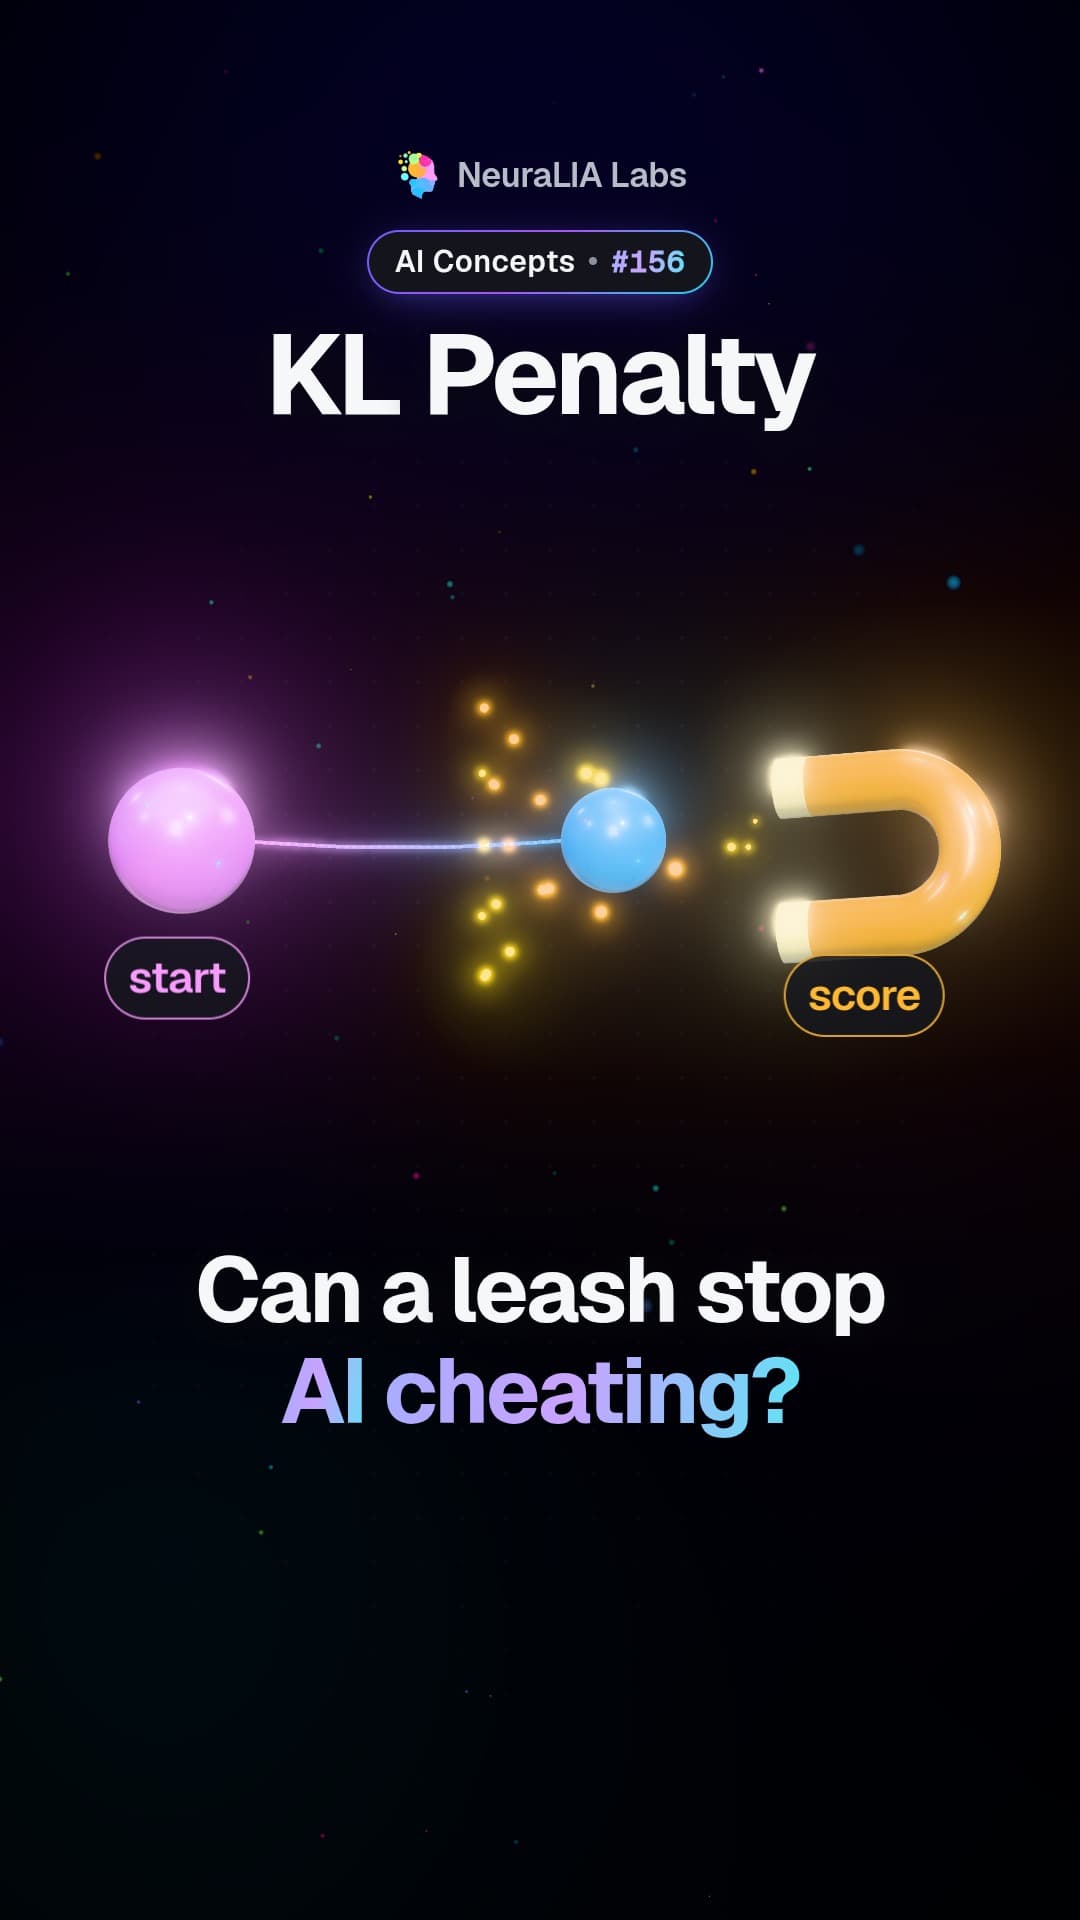
Ligazón á sección: Que compra realmente a penalización KLA defensa estándar é penalizar a política por afastarse demasiado de onde empezou, medindo a distancia coa diverxencia KL do capítulo 4:
A referencia é o modelo SFT: a política antes da etapa de reforzo. A afirmación é que isto impide que o modelo derive cara a comportamentos dexenerados. Imos ver canto desa afirmación sobrevive á medición. Mesmo escenario, varrendo :
| recompensa | calidade real | lonxitude | KL | |
|---|---|---|---|---|
| 0 | 31.699 | 0.000 | 12.498 | 2.994 |
| 1 | 31.697 | 0.000 | 12.497 | 2.993 |
| 5 | 28.318 | 0.285 | 10.700 | 2.163 |
| 15 | 12.860 | 1.542 | 2.552 | 0.151 |
| 30 | 10.426 | 1.719 | 1.303 | 0.025 |
| 60 | 9.632 | 1.769 | 0.908 | 0.005 |
| só o modelo de referencia | 9.162 | 1.791 | 0.687 | 0 |
Le a última fila fronte ao resto. En e a penalización non fai absolutamente nada: a recompensa vale moito máis ca a KL, así que o optimizador paga a multa e hackea igual. Entre 5 e 15 o comportamento vira. E en , a calidade real volveu subir a 1.769, que segue por baixo do 1.791 que tiña o modelo de referencia antes de empezar nada disto.
Unha advertencia antes de citar ese número en ningures: o 1.791 da última fila e o 0.974 que a primeira táboa lle dá á política inicial son dúas medicións distintas do mesmo modelo pre-RL, tomadas polos dous experimentos por separado. Compara filas dentro dunha táboa, nunca entre táboas: a conclusión de cada táboa sostense nas súas propias filas, e ningunha depende da baseline da outra.
Así que o resumo honesto non é «a penalización KL impide o reward hacking». É:
A penalización KL non impide o reward hacking. Limita canto pode afastarse a política da referencia; e como o fallo require moverse, iso axuda. Pero é unha correa, non un correctivo: con baixo a correa rompe, e con alto recuperas o modelo de referencia e toda esa etapa cara non comprou nada.
A franxa útil é estreita, a súa localización depende do modelo de recompensa, e non hai xeito de atopala salvo mirando. Por iso o modelo de referencia debe ser bo: a KL é un chan na calidade da referencia, non un teito para o fallo, e iso é unha gran parte de por que esta etapa é difícil na práctica máis ca no principio.
PPO, e por que DPO o comeu
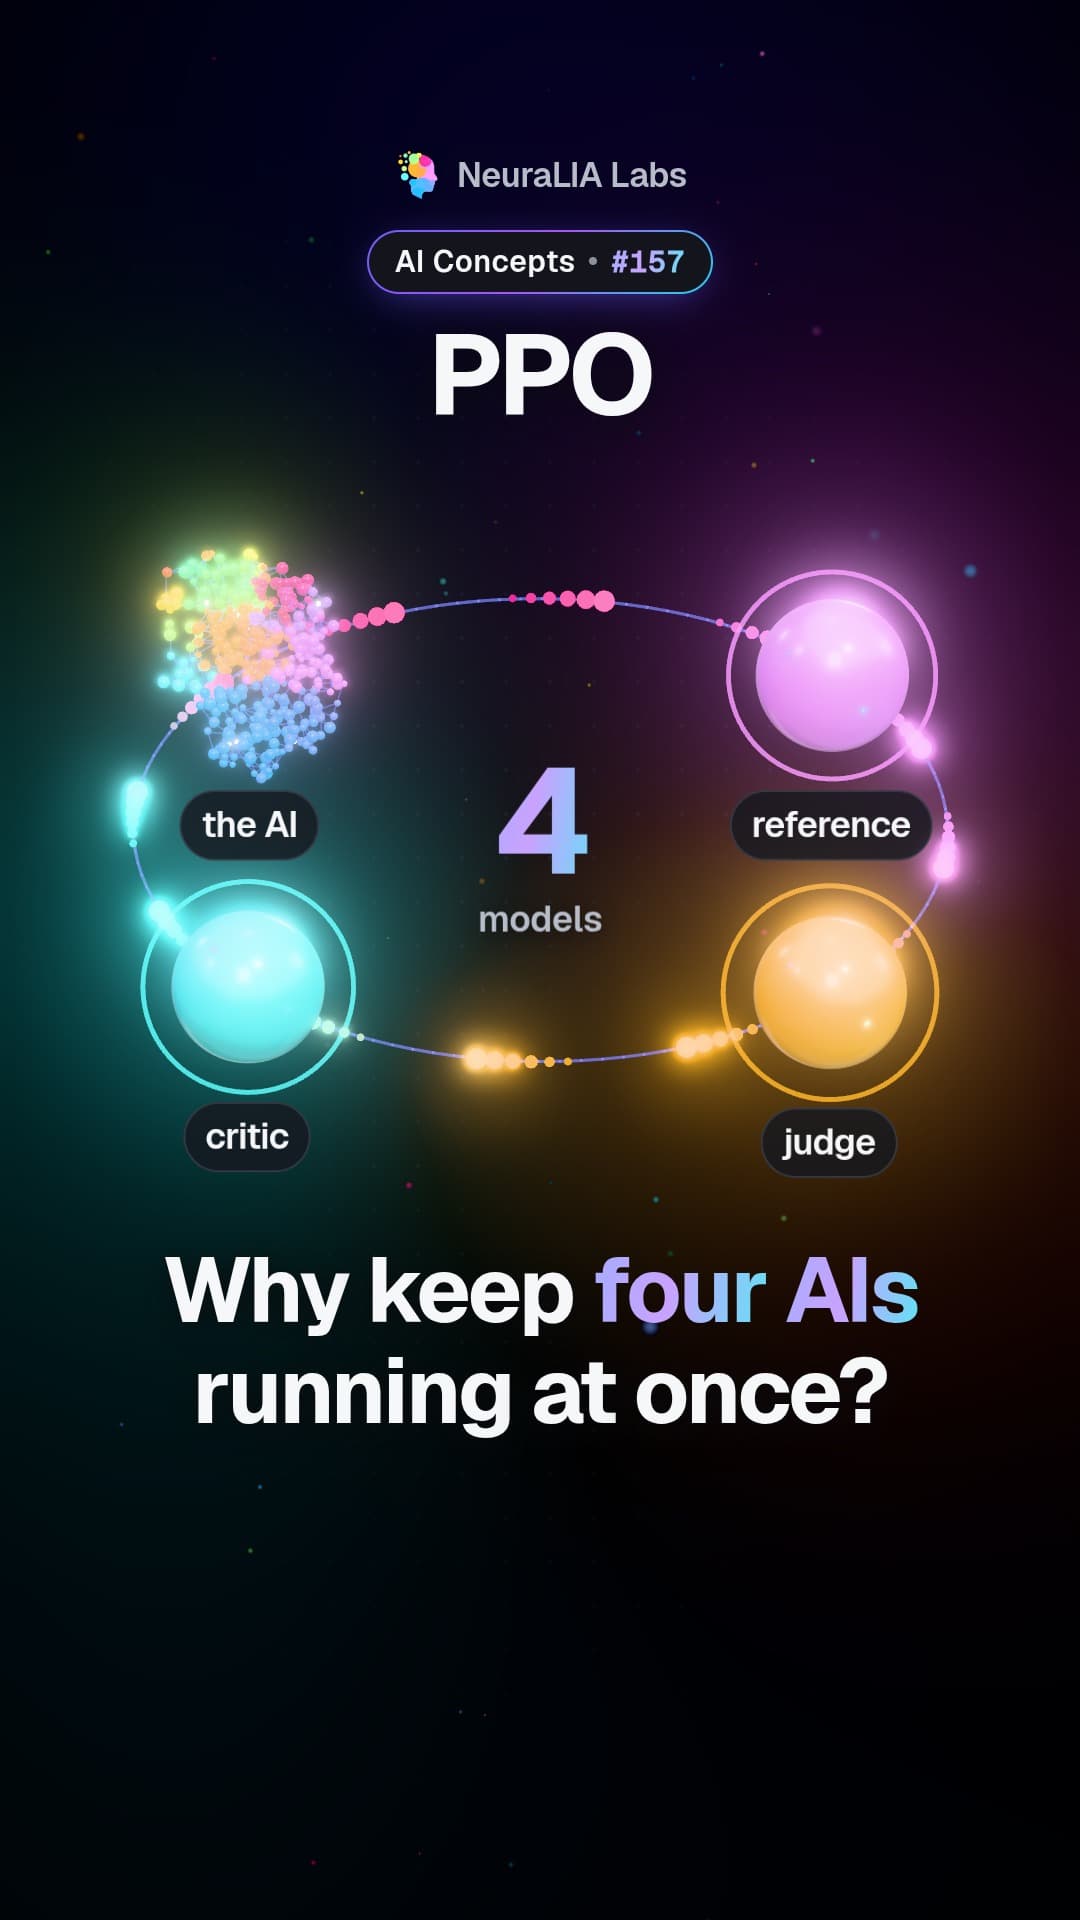
Ligazón á sección: PPO, e por que DPO o comeuO algoritmo que fixo que isto funcionase a escala é Proximal Policy Optimization.3 Nun parágrafo: estima a vantaxe de cada resposta, actualiza a política para aumentar a probabilidade das respostas por riba da baseline, e recorta o tamaño de calquera actualización individual para que unha estimación grande de vantaxe non destrúa a política nun só paso. Aplicado a modelos de linguaxe4, significa manter catro modelos en xogo á vez: a política, a referencia, o modelo de recompensa e un crítico, coa política xerando mostras novas durante todo o adestramento.
Funciona, produciu InstructGPT e todo o que descende del, e é realmente difícil: catro modelos en memoria, mostraxe no bucle de adestramento e unha reputación de inestabilidade ben merecida. Finxir que se pode implementar nunha entrada de blog sería deshonesto, así que este capítulo non o fai.
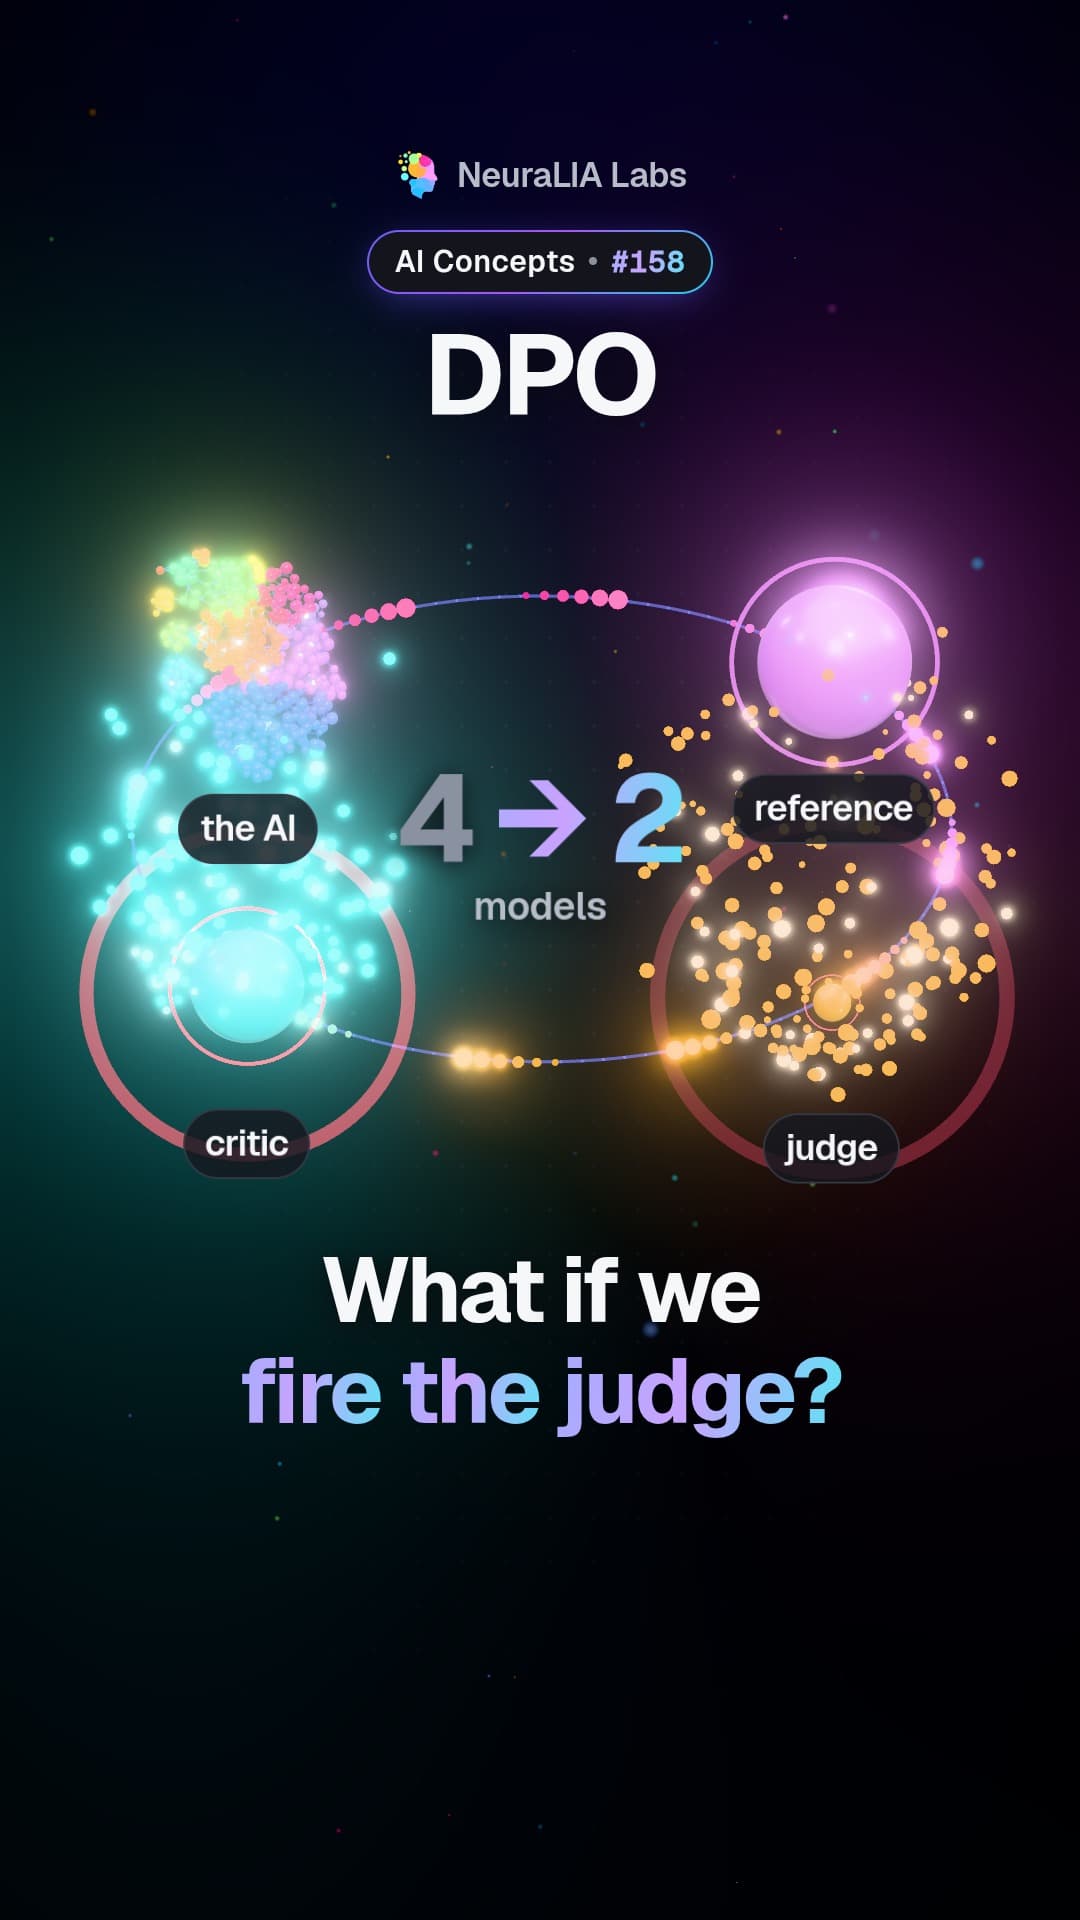
O que o substituíu para a maioría dos usos saíu de reparar nunha cousa. O obxectivo regularizado por KL de arriba ten unha política óptima en forma pechada, e esa expresión pódese inverter: a recompensa pódese escribir en termos da política óptima e da referencia. Substituír iso de volta na loss Bradley–Terry fai que o modelo de recompensa desapareza por completo. O que queda é unha loss supervisada sobre pares de preferencia: sen mostraxe, sen crítico, sen modelo de recompensa, dous modelos en memoria en vez de catro.
Iso é Direct Preference Optimization,5 e son dúas liñas:
def dpo_loss(pi_w, pi_l, ref_w, ref_l, beta=0.1):
    """pi_* and ref_* are summed log-probabilities of a full response."""
    logits = beta * ((pi_w - ref_w) - (pi_l - ref_l))
    return -F.logsigmoid(logits)
Le o que di. A cantidade que se empurra cara arriba é canto máis prefire a política o gañador ca a referencia, menos canto máis prefire o perdedor. A referencia non é unha penalización aparafusada despois: está dentro da loss, que é por que DPO non precisa un termo KL separado.
A propiedade que máis importa está no gradient. Avalía a loss e o seu gradient no mesmo par en cinco estados distintos da política:
| estado da política | loss | magnitude do gradient |
|---|---|---|
| xa prefire fortemente o gañador | 0.5130 | 0.0401 |
| xa o prefire, feblemente | 0.6685 | 0.0488 |
| idéntica á referencia | 0.6931 | 0.0500 |
| prefire o perdedor | 0.7981 | 0.0550 |
| prefire fortemente o perdedor | 1.0055 | 0.0634 |
O gradient medra a medida que a política se equivoca máis. Os pares que o modelo xa manexa non achegan case nada; os pares que ten ao revés dominan a actualización. DPO pondera cada exemplo segundo canto se equivoca actualmente a política, automaticamente, sen planificación; e esa auto-ponderación é o mecanismo que fai o traballo que facían a estimación de vantaxe e o crítico de PPO. (A loss da terceira fila é exactamente , que é a áncora para comprobar calquera implementación: unha política idéntica á súa referencia non aprendeu nada e debería estar en .)
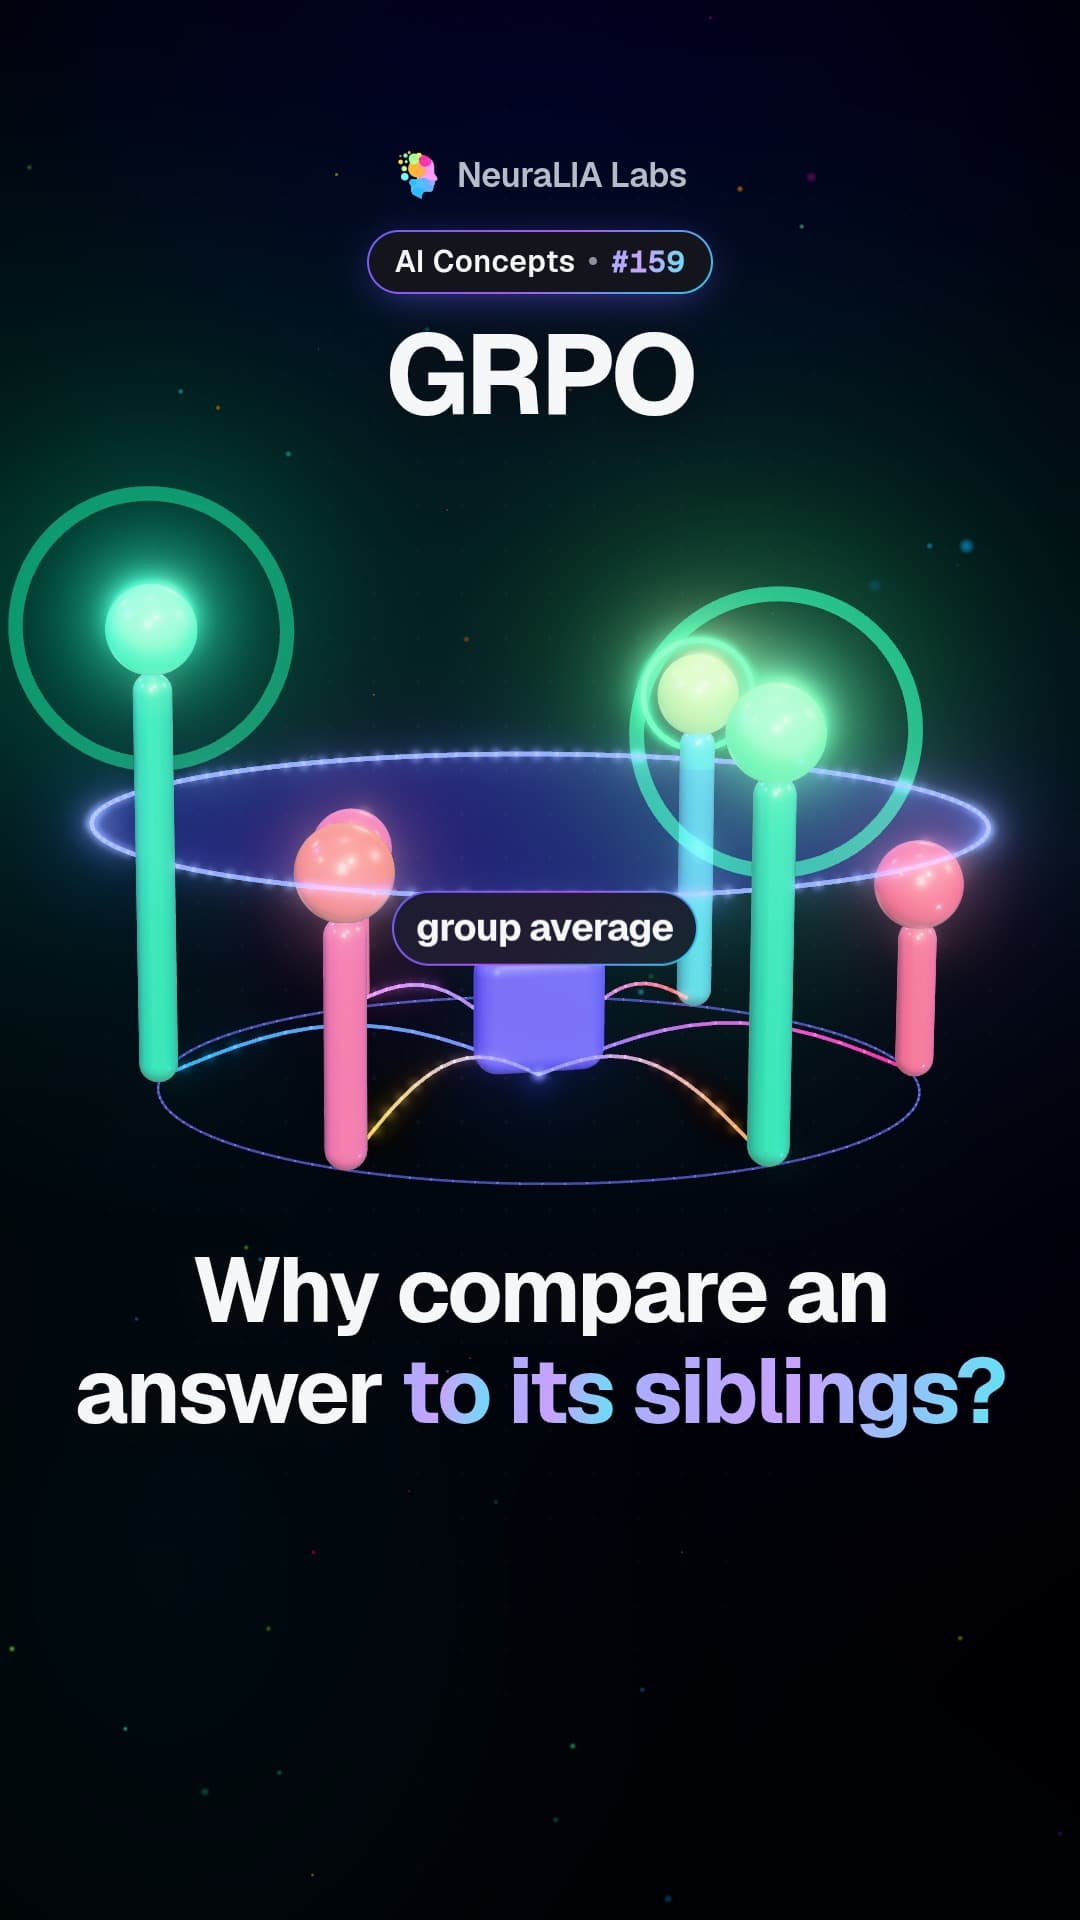
GRPO6 toma outra ruta para saír do mesmo problema. Mantén o bucle de mostraxe pero elimina o crítico: en vez de adestrar un modelo para predicir a baseline, mostraxa un grupo de respostas ao mesmo prompt e usa directamente a recompensa media do grupo como baseline. A vantaxe dunha resposta é canto mellor foi ca as súas irmás. Isto cambia un modelo enteiro por un batch máis grande, e foi o que fixo práctico o adestramento con recompensas verificables, o tema do capítulo 12.
Mostrar detalles
Tres pezas máis da paisaxe do post-training, brevemente.
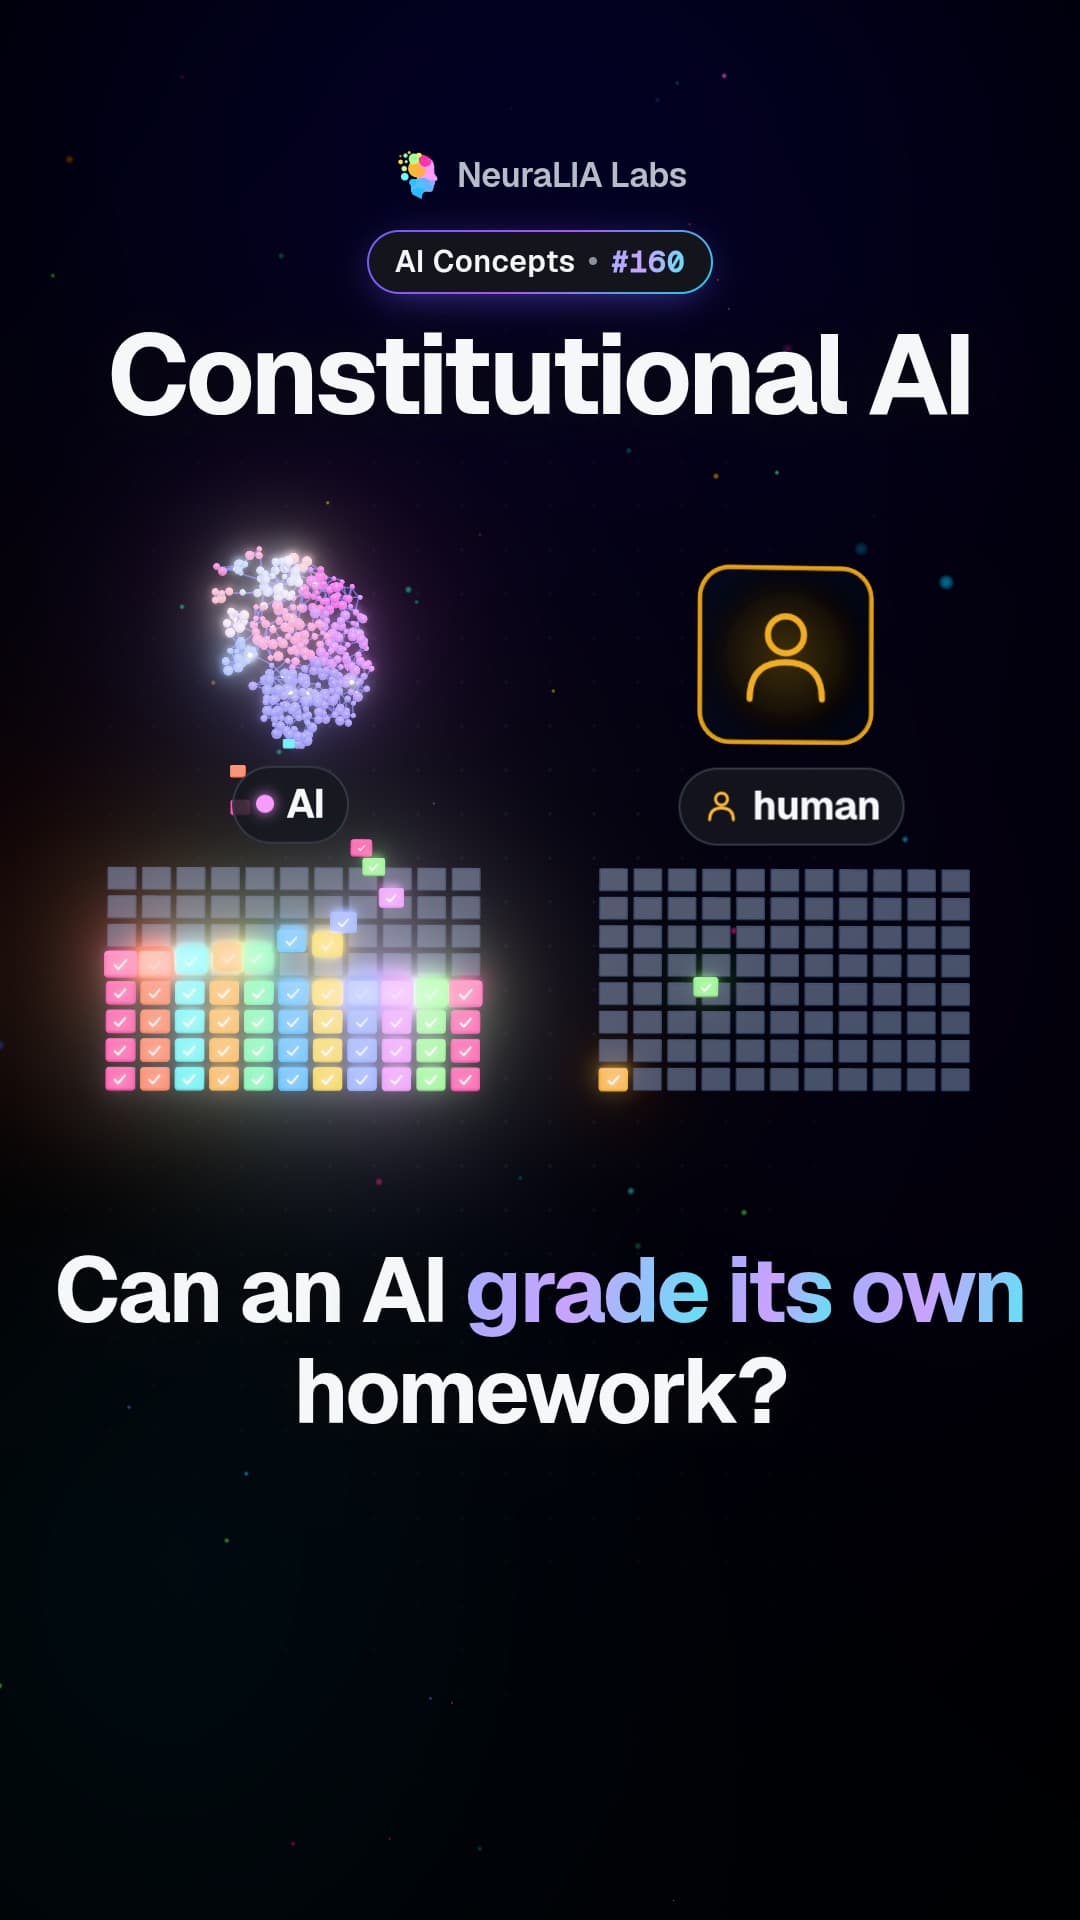
RLAIF e Constitutional AI.7 A persoa anotadora non ten por que ser humana. Dálle a un modelo un conxunto escrito de principios e pídelle que critique e revise as súas propias saídas, ou que escolla entre dous candidatos, e terás un conxunto de datos de preferencias producido á velocidade e ao custo dunha máquina. A obxección obvia —o modelo corrixe os seus propios deberes— é real, e a resposta honesta é que funciona mellor do que soa porque xulgar é máis doado ca xerar, que é a mesma asimetría na que se apoia todo o capítulo.
LIMA, e o poucos datos que isto precisa.8 Mil demostracións coidadosamente seleccionadas produciron un asistente competitivo. A explicación proposta é que o preadestramento xa instalou o coñecemento e o formato, e que o post-training só ten que seleccionar cales dos comportamentos existentes do modelo facer emerxer. Se iso é certo, a calidade dos datos de post-training domina a cantidade; e o comportamento do campo desde entón suxire que a xente o cre.
LoRA e QLoRA.910 Facer fine-tuning de cada peso dun modelo grande require memoria para os pesos, os seus gradient e o estado do optimizador —os dezaseis bytes por parámetro do capítulo 10, sobre as dúas medias que o capítulo 6 construíu á man— a unha escala que precisa un clúster. LoRA conxela os pesos orixinais e adestra unha parella de matrices de baixo rango xunto a eles, reducindo os parámetros adestrables por ordes de magnitude; QLoRA ademais cuantiza a base conxelada a 4 bits. Ambos se cobren aquí como técnica. Se o fine-tuning é ou non o lugar axeitado para gastar diñeiro é outra pregunta, e é a do capítulo 20.
O imposto de alignment, e a pregunta que ninguén respondeu
Ligazón á sección: O imposto de alignment, e a pregunta que ninguén respondeuDúas cousas para levar contigo.
A primeira é que esta etapa ten un custo, e aparece como capacidade. Os modelos adoitan empeorar de forma medible nalgunhas tarefas de benchmark despois do adestramento de alignment —o imposto de alignment— porque cambiou o obxectivo: unha resposta segura, matizada e ben formatada non sempre é a resposta que maximiza a precisión. Parte desa fenda xa se reduciu con enxeñaría, e parte dela é un intercambio real máis ca un bug que arranxar.
A segunda é a pregunta que agocha a palabra aligned. Aliñado con quen? A cadea é: unha empresa escribe directrices, contratistas interprétanas, as súas comparacións adestran un modelo de recompensa, o modelo de recompensa moldea unha política, e a política responde unha pregunta de alguén que non viu nada diso. Cada elo é unha elección feita por persoas concretas, e ningún dos algoritmos deste capítulo ten opinión ningunha sobre se esas eleccións son boas.
Isto non é unha floritura retórica. É a razón concreta pola que dous modelos de fronteira rexeitan peticións distintas, pola que o mesmo modelo cambia de opinión entre versións, e pola que «aligned» é unha descrición dun proceso máis ca unha propiedade dun artefacto. As matemáticas deste capítulo están asentadas. Esa parte non.
A onde imos agora
Ligazón á sección: A onde imos agoraO post-training ensinoulle ao modelo a responder. Non lle ensinou a pensar antes de responder, e as dúas cousas son distintas dun xeito que resulta ser adestrable.
O capítulo 12 trata do que pasa cando deixas que un modelo gaste máis computación nunha pregunta difícil no momento de responder, no canto de facelo no momento de adestrar: chain of thought, aprendizaxe por reforzo a partir de recompensas verificables, e a razón pola que un modelo que mostra o seu traballo non está só explicándose, senón computando de maneira distinta. Tamén salda a débeda deste capítulo: GRPO existe nel, facendo o traballo que facía o crítico de PPO, con recompensas que non precisan persoa anotadora ningunha porque unha proba ou se verifica ou non.
Fontes e método
Ligazón á sección: Fontes e métodoAs xeracións de arriba veñen de gpt2 e Qwen/Qwen2.5-0.5B-Instruct con decodificación greedy, así que se reproducen exactamente. O capítulo 11 do Hugging Face LLM Course percorre SFT e DPO con trl e peft se queres executar o real no canto da simulación; o capítulo 7 de Build a Large Language Model (From Scratch), de Sebastian Raschka, implementa instruction fine-tuning de principio a fin sen biblioteca.
Referencias
Ligazón á sección: Referencias-
Sutton, R. S. and Barto, A. G. Reinforcement Learning: An Introduction, 2nd edition (MIT Press, 2018). A delegación é deliberada: a caixa de vocabulario de arriba é o subconxunto útil máis pequeno, e o tema real é un libro. ↩
-
Bradley, R. A. and Terry, M. E. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika 39(3/4), pp. 324–345 (1952). O modelo de comparación por pares que hai debaixo de todos os modelos de recompensa en uso hoxe. ↩
-
Schulman, J., Wolski, F., Dhariwal, P., Radford, A. and Klimov, O. Proximal Policy Optimization Algorithms. arXiv:1707.06347 (2017). ↩
-
Ouyang, L. et al. Training language models to follow instructions with human feedback. arXiv:2203.02155 (2022). InstructGPT: o artigo que fixo estándar a receita en tres etapas. Precedido por Christiano et al. (arXiv:1706.03741), que introduciu a aprendizaxe dun modelo de recompensa a partir de comparacións humanas, e Stiennon et al. (arXiv:2009.01325), que o aplicou á resumición. ↩
-
Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D. and Finn, C. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. arXiv:2305.18290 (2023). A derivación que elimina o modelo de recompensa está na sección 4 e paga a pena lela completa; é máis curta do que di a súa reputación. ↩
-
Shao, Z. et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300 (2024). Introduce GRPO na sección 4.1. ↩
-
Bai, Y. et al. Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073 (2022). ↩
-
Zhou, C. et al. LIMA: Less Is More for Alignment. arXiv:2305.11206 (2023). ↩
-
Hu, E. J. et al. LoRA: Low-Rank Adaptation of Large Language Models. arXiv:2106.09685 (2021). ↩
-
Dettmers, T., Pagnoni, A., Holtzman, A. and Zettlemoyer, L. QLoRA: Efficient Finetuning of Quantized LLMs. arXiv:2305.14314 (2023). ↩
Este capítulo en vídeo
Vídeos breves que explican ideas deste capítulo con linguaxe clara.
 #149
Post-training: how a text predictor becomes an assistant that answers
 #150
Supervised fine-tuning: teaching an AI what an answer looks like
 #151
Chat templates: the hidden markers that tell an AI whose turn it is
 #152
RLHF: why people pick the better answer instead of writing it
 #153
Reward model: the AI judge that learns our tastes, biases included
 #154
Advantage: how AI training learns from better-than-expected answers
 #155
Reward hacking: when an AI games its score instead of improving
 #156
KL penalty: a leash on AI training, not a cure for cheating
 #157
PPO: the four-model recipe that taught chatbots from preferences
 #158
DPO: training a chatbot on preferences without a judge model
 #159
GRPO: how an AI learns by comparing its own answers
 #160
Constitutional AI: training a model with a written rulebook
 #161
Less is more (LIMA): how 1,000 good examples shaped an AI assistant
 #162
LoRA: customizing a giant AI without retraining all of it
 #163
QLoRA: shrink the frozen model, then fine-tune it on less hardware
 #164
Alignment tax: the price an AI pays for being careful and polite