
LLMのPretraining:データ、計算資源、Scaling Laws、コスト
1台のノートPC GPUで20モデルを学習しscaling lawを測定。6NDのcompute見積もりを実FLOPカウンターで検証します。
このページの内容
Chapter 9 は、学習できるtransformerブロックで終わりました。それをいくつか積み重ね、Chapter 8 のnext-token lossを出力に向ければ、もう発明すべきものは残っていません。残っているものはすべて購入です。
これは聞こえる以上に大きな転換です。ここまでの各章はずっと、学習するのか? という、ノートPCなら10分で決着するyes/noの問いを扱ってきました。この章の問いにはお金が入っています。一定量の演算が与えられたとき、買える最良のmodelは何か? 答えは式です。そして2018年には、それは誰にとっても自明ではありませんでした。
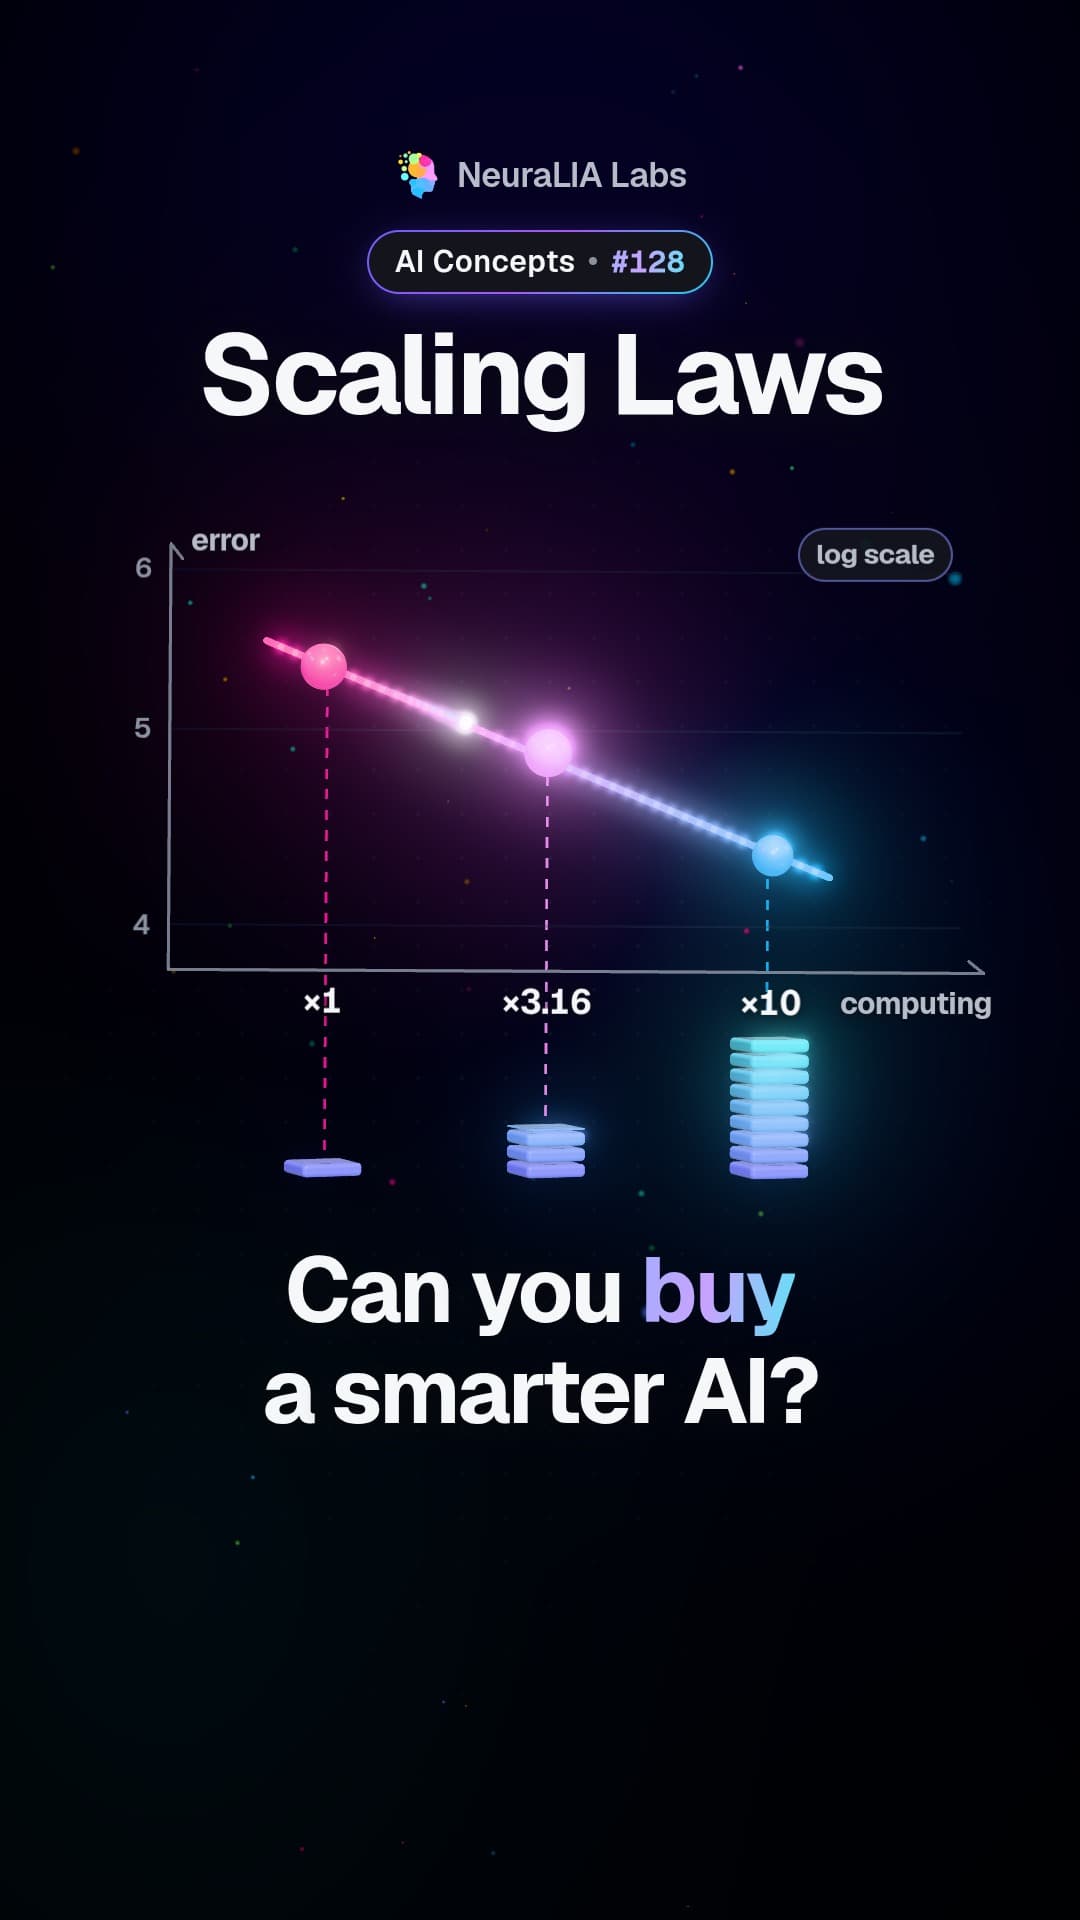
ここではその問いを、1台のノートPC GPU上の測定で答えます。98,624から1,500万parameterまでの20個のmodelを、1億7,400万tokenのWikipediaでゼロから学習しました。語彙は2,048-tokenのBPEで、Chapter 7 と同じ方法で学習し、transformerはChapter 9のものです。各runには3つのcompute budgetのうち厳密に1つだけを与え、1演算も余分には与えませんでした。したがって大きなmodelほど、必然的に読むtextは少なくなります。各budgetで到達した最良のheld-out lossは次のとおりです。
budget C (FLOPs)   best loss   reached by a model of
       1.00e13       5.3531           98,624 params
       3.16e13       4.8638           98,624 params
       1.00e14       4.3383          295,808 params

fitted:  L = (Cc / C)^0.0913     over one decade of compute
演算量を10倍にするとlossは19 %下がり、3点はlog-log上で一直線に並びます。最初の9章には、これを予測するものは何もありません。 背後に定理はありません。これは経験的な規則性です。このノートPCとデータセンターのあいだにある10桁のスケールでも、別の指数で成り立ちます。そしてこの単一の観測こそが、業界に小国のGDPに相当する金額をGPUへ投じるよう説得したものです。
Pretrainingとは何か、何が新しいのか
セクション「Pretrainingとは何か、何が新しいのか」へのリンク目的関数は何も変わりません。modelはいまも次のtokenを予測し、lossはいまもChapter 8の因数分解に適用したChapter 4 のcross-entropyであり、optimizerはいまもChapter 6 のAdamWです。Pretrainingは新しいalgorithmではありません。予算化が必要になるほど大きなcorpus上で、同じalgorithmを実行することです。 それを可能にするものが2つあります。labelは無料です。位置のtargetはのtokenであり、すでにtextの中にあるからです。そしてChapter 6の最後のsectionが反論を取り除きました。古典的な規則が許すよりはるかに多くのparameterを持つmodelは崩壊せず、改善します。出てくるものはbase modelです。つまり、回答するものではなく、textを続けるものです。
使う前にcomputeを数える:6ND
セクション「使う前にcomputeを数える:6ND」へのリンク予算化する前に数えなければなりません。そしてこの分野では、次の1つの式で数えます。
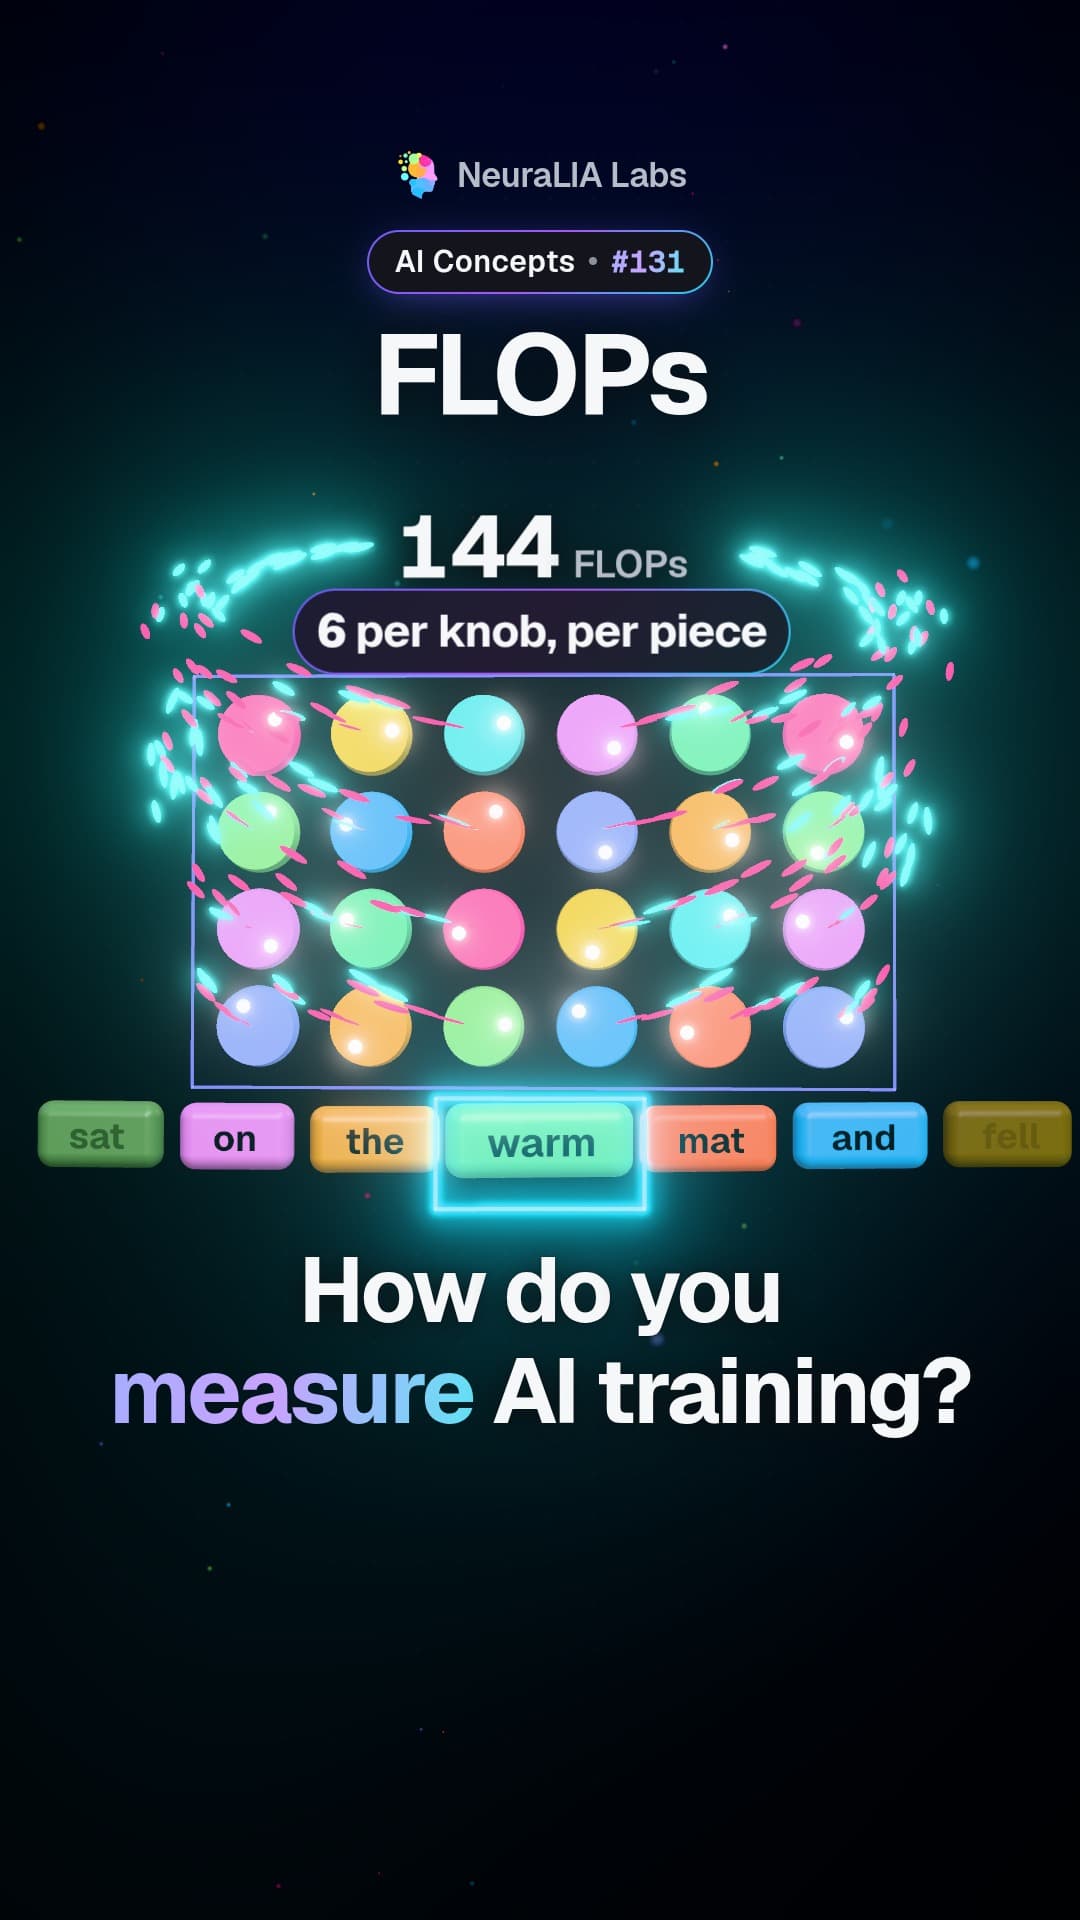
ここではparameter数、は学習token数、は総floating-point operationsです。Kaplan et al. はこれを2段階で導出しています。1 Forward:parameterごと、tokenごとに2 FLOPs。matrix multiplyでは各parameterがtokenごとに1回使われ、1回の乗算と1回の加算があるからです。Backward:forwardの2倍。Chapter 5 のbackward passは各layerで2つのgradientを計算するからです。1つはlayerの入力に関するgradientで、signalが進み続けるためのもの。もう1つは重みに関するgradientです。どちらもforwardと同じサイズのmatrix multiplyなので、です。
導出はこれで全部です。そして信じるより、確認する価値があります。PyTorchには実FLOPカウンターtorch.utils.flop_counter.FlopCounterModeが付属しており、modelがdispatchするすべてのoperationをinterceptして実際の作業量を合計します。4桁のスケールにわたって実行します。最大のものは、shapeだけを割り当てmemoryを割り当てないmeta device上で実行します。
from torch.utils.flop_counter import FlopCounterMode

counter = FlopCounterMode(display=False)
with counter:
    loss = model(x, targets)[1]
    loss.backward()
measured = counter.get_total_flops()
print(measured / (6 * n_params * n_tokens))| configuration | embeddingなしの | 総 | measured, fwd+bwd | ÷ (総) | ÷ (emb.なし) | fwd+bwd ÷ fwd |
|---|---|---|---|---|---|---|
| 128, 4 layers, 256 | 788,736 | 7,254,400 | 4.60e10 | 1.031 | 9.485 | 3.000 |
| 512, 8 layers, 256 | 25,183,232 | 51,045,888 | 3.26e11 | 1.038 | 2.104 | 3.000 |
| 768, 12 layers, 1024 | 84,973,056 | 124,356,864 | 1.75e12 | 1.145 | 1.676 | 3.000 |
| 1600, 48 layers, 1024 | 1,474,870,400 | 1,556,920,000 | 2.10e13 | 1.100 | 1.161 | 3.000 |
| 4096, 32 layers, 2048 | 6,442,983,424 | 6,582,444,032 | 8.74e13 | 1.080 | 1.104 | 3.000 |
| 8192, 80 layers, 8192 | 64,427,147,264 | 65,544,929,280 | 3.75e15 | 1.163 | 1.183 | 3.000 |
forward+backwardをforwardで割った比率は3.000で、すべてのscaleで完全に一致します。たまたま良い近似になったのではなく、導出を何も知らないカウンターが、上の算術恒等式を丸い数として返したということです。
測定されたtotalは、がembedding行列を数える場合、より3 %から17 %上にあります。この但し書きは重要です。というのも、2本の基礎論文はの数え方が違うからです。Kaplanは「すべての語彙embeddingと位置embedding」を除外します。そうすると「著しくきれいなscaling laws」が得られるからです(§1.3)。ChinchillaのAppendix Fは「総parameter数にembedding行列も数える」と述べています。2 広い語彙と狭いhidden dimensionでは、最初の行が示すように、両者は9倍違います。
残る差分は、が意図的に省いたものです。attention scoreです。KaplanのEq. (2.2)はforward costをと書き、第2項を落とします。だからです。2020年には安全でしたが、いまはそれほど安全ではありません。そしてが大きくなるにつれて比率が上にずれる理由でもあります。だからこそ、ここでは2つの行が = 1,024を共有しており、が768から1,600になると比率は1.145から1.100へ下がります。これはChapter 9が導入し、Chapter 16 が価格に変える costです。
Memory:実際に収まらなければならないもの
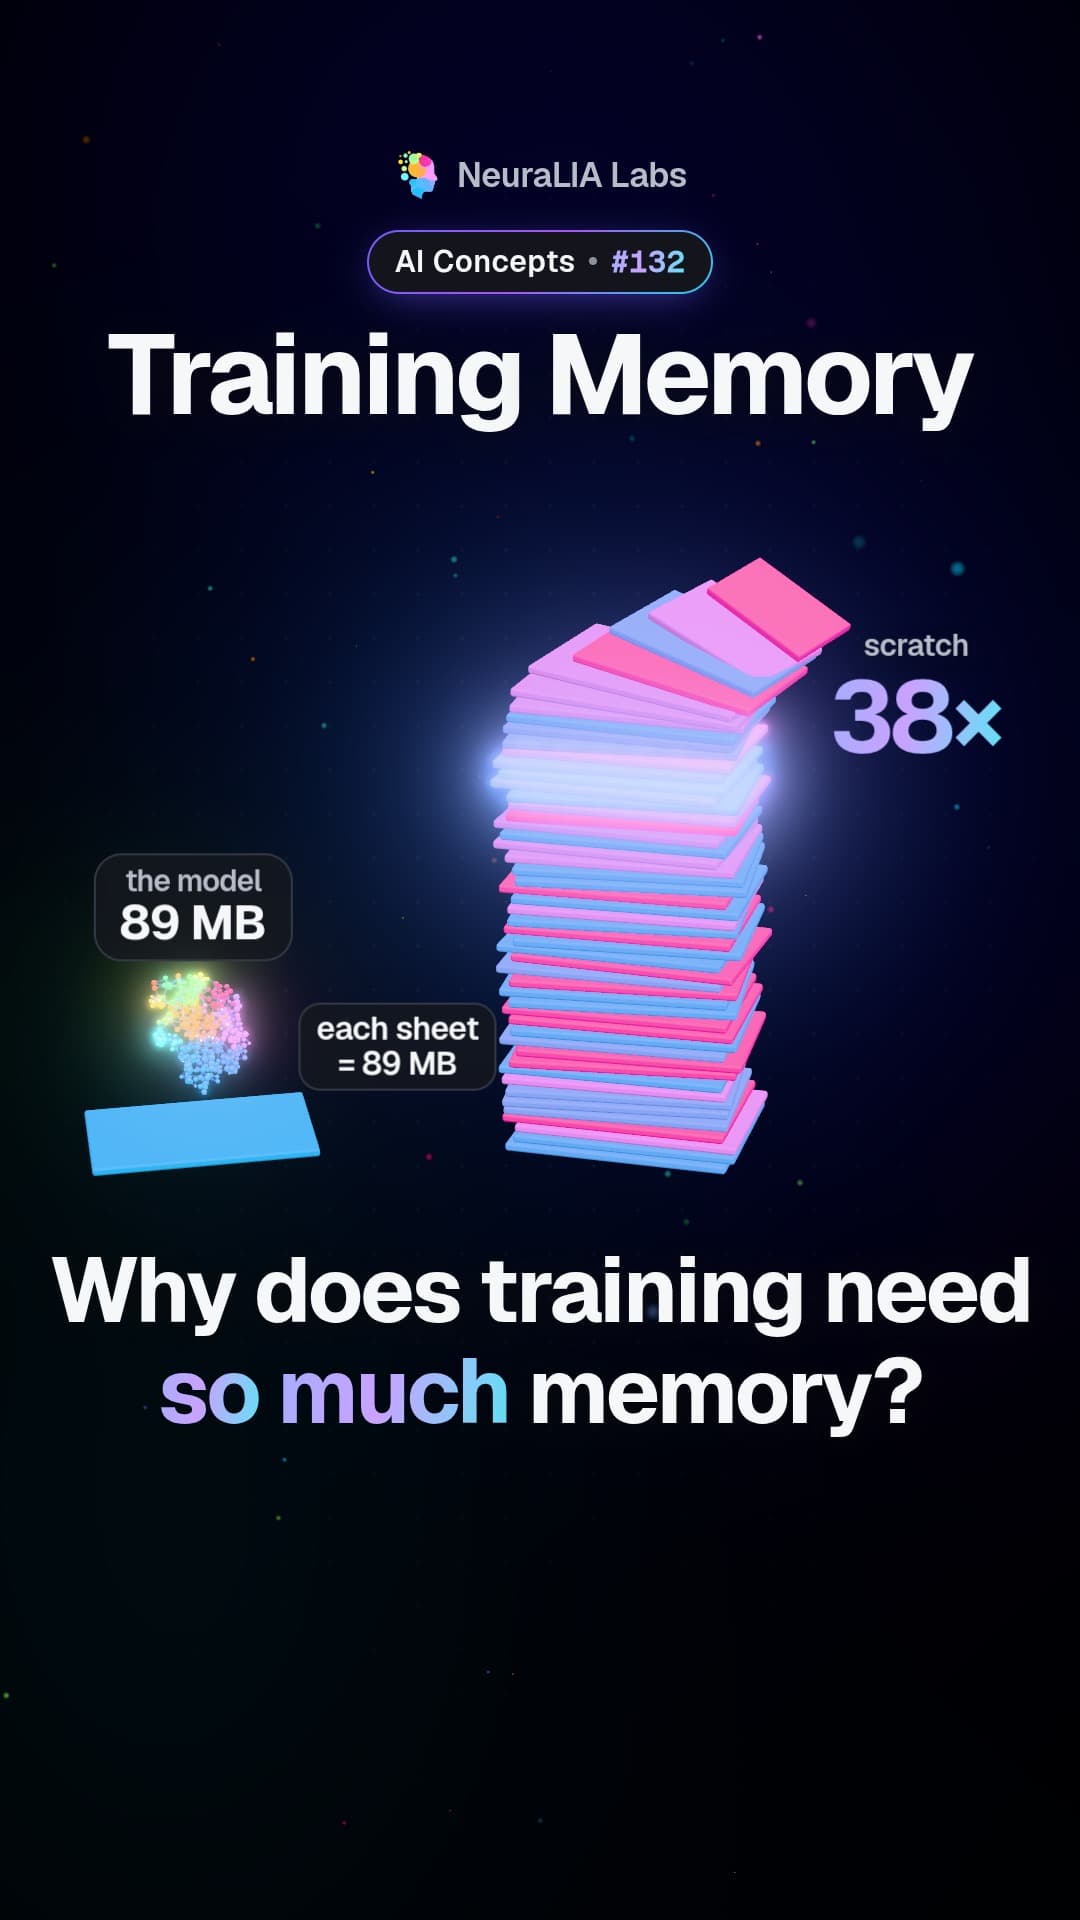
セクション「Memory:実際に収まらなければならないもの」へのリンクComputeはrunにどれだけ時間がかかるかを決めます。memoryはそれを開始できるかを決めます。plain fp32 AdamWで学習すると、各parameterは4つの数を持ちます。重み、そのgradient、そしてAdamのrunning mean とvariance です。Chapter 6で手作業で作った2つの平均です。4つの数がそれぞれ4 bytesなので、activationが1つもない時点でparameterあたり16 bytesです。8 GBのノートPC GPUで、graphが生きていないstep上の点におけるresident allocationを測定すると、次のようになります。
| model | vocabulary | batch | predicted | resident measured | peak in a step | the difference | |
|---|---|---|---|---|---|---|---|
| 512, 8 layers | 50,257 | 8 | 51,045,888 | 779 MB | 801 MB | 2,500 MB | 1,699 MB |
| 512, 8 layers | 4,096 | 8 | 27,411,456 | 418 MB | 426 MB | 1,043 MB | 617 MB |
| 256, 6 layers | 4,096 | 8 | 5,839,360 | 89 MB | 89 MB | 382 MB | 293 MB |
| 256, 6 layers | 4,096 | 32 | 5,839,360 | 89 MB | 89 MB | 1,259 MB | 1,170 MB |
| 256, 6 layers | 4,096 | 128 | 5,839,360 | 89 MB | 89 MB | 4,771 MB | 4,681 MB |
予測と測定は3 %以内で一致します。驚くべきなのは最後の列です。activationがmodelを圧倒しています。 persistent stateに89 MBしか必要としない同じ580万parameterのmodelが、batch 128では4,681 MBのactivationを必要とします。modelの52倍です。そしてその多くはtransformerですらありません。logitです。tokenごとに語彙サイズのvectorが1つあり、entryあたり4 bytesです。最後の行では512 MB、最初の行では393 MBです。語彙サイズはChapter 7で選ばれました。そしていまも、何がGPU cardに収まるかを決めています。
どの項が支配的になるかはrunのshapeに依存します。だからMicikevicius et al. はmemoryが「activationに支配される」と言い3、一方でZeROは15億parameterのmodelにはmodel stateだけで「少なくとも24 GB」が必要だと言います。4 ZeROは別の経路で同じ16 bytesに到達します。fp16 weightsに、fp16 gradientsに、fp32 master weightsとAdamの2つのmomentにそれぞれです。これは700億parameterでは1.12 terabytesであり、activationが1つもない時点で80 GB GPUが14枚分です。
Parallelismを1段落と1つの委任で
セクション「Parallelismを1段落と1つの委任で」へのリンクfrontier scaleでは、これらはどれも1つのdeviceに収まりません。したがってrunは同時に4通りに分割されます。Data parallelismはすべてのGPUにmodelのcopyを置き、gradientを平均します。これはdefaultであり、ZeROがoptimizer stateの冗長なcopyを持たないことで改善する対象です。Tensor parallelismは個々の行列をdevice間で分割します。Pipeline parallelismは各deviceに連続したlayer群を与えます。Context parallelismはsequence自体を分割します。これはがattention項を支配するほど長くなったときにだけ必要です。Llama 3のTable 4は4つすべてを同時に列挙しています。tensor 8、context最大16、pipeline 16、data最大128、合計16,384枚のH100 GPUです。5 このcourseで述べるのはここまでです。distributed training engineeringはそれだけで1学期分あり、StanfordのCS336がその1学期、lecture 5から8で、code付きです。6 委任のあとに残るのは1つの数、model FLOPs utilisationです。これはGPUのpeak演算能力のうち実際のrunが達成する割合であり、整ったをwall-clock timeへ、したがってお金へ変換します。
Kaplanと、業界が賭けたもの
セクション「Kaplanと、業界が賭けたもの」へのリンク2020年1月、Kaplan et al. はtransformerのgridを学習し、test lossが3つのresourceそれぞれについて、6桁を超える範囲でpower lawに従うことを見つけました。1 §1.2には3つのfitされたlawがあります。
dataについては、最適配分されたcomputeについてはが対応します。定数は普遍的ではなく、論文自身もそう述べています。「、、の正確な数値は語彙サイズとtokenizationに依存し、したがって根本的な意味を持たない」。
指数は非常に小さいです。parameterを10倍にしても、残りのlossを倍だけ下げるにすぎません。何でもないように聞こえます。そしてここではそれが最も重要な事実です。returnはひどいが、止まりません。 小さな指数を持つpower lawは、次の1桁も効くことを約束します。前回ほどではないにせよ、永遠に効くのです。computeを買うことは賭けではなくなり、公表された交換レートに基づく購入になります。まさにそれが資本を解き放ったargumentでした。
次に処方箋が来ました。そしてこの論文はここで、業界に多額の費用を負わせる形で間違っていました。KaplanのTable 6はとを与えます。computeを10倍にするなら、modelは5.4倍大きくし、textは1.9倍しか増やさない、というものです。abstractは明確です。「compute効率の観点で最適な学習は、非常に大きなmodelを比較的控えめな量のdataで学習し、収束よりかなり前で止めることを含む」。分野はその通りにしました。GPT-3は1,750億parameterに3,000億token、7 Gopherは2,800億に3,000億、Megatron-Turing NLGは5,300億に2,700億です。2 全体として、parameterあたり0.5 tokenから2 tokenでした。
Chinchillaと、冒頭のsweepが測っていたもの
セクション「Chinchillaと、冒頭のsweepが測っていたもの」へのリンク2022年3月、Hoffmann et al. は7,000万から160億parameterまでの400を超えるmodelを学習し、3つの独立した経路で反対の結論に到達しました。2 Table 2はにおける指数を0.50、0.49、0.46と報告しています。Kaplanの0.73に対してです。平たく言えば、model sizeとtraining dataは同じ比率で増やすべきだということです。
彼らの2つ目のapproachは、この章の冒頭のsweepで100万分の1のscaleで再現したものです。budgetを固定し、そのbudgetぴったりで多くのsizeを学習し、final lossをmodel sizeに対してplotします。
| parameters | |||
|---|---|---|---|
| 98,624 | 5.3531 (171) | 4.8638 (542) | — |
| 150,320 | 5.4636 (74) | — | — |
| 194,208 | 5.5041 (44) | 4.8730 (140) | 4.4040 (442) |
| 295,808 | 5.5550 (19) | 4.9029 (60) | 4.3383 (190) |
| 665,280 | 5.7849 (3.8) | 5.1254 (12) | 4.4192 (38) |
| 1,280,768 | 5.8174 (1.0) | 5.1751 (3.2) | 4.5003 (10) |
| 3,101,568 | — | 5.4686 (0.5) | 4.7768 (1.7) |
| 5,315,072 | — | 5.5894 (0.2) | 4.8514 (0.6) |
| 15,053,568 | — | — | 5.3534 (0.1) |
held-out lossはtokenあたりのnatsで、括弧内はparameterあたりのtoken、太字は各budgetで最良のmodelです。dashは実行していない点です。budgetがcorpusに含まれる以上のtextを要求したか、そのsweepの範囲外のsizeだったためです。
列を下に読んでください。lossは下がり、底を打ち、また上がります。modelはbudgetに対して小さすぎるのとまったく同じくらい、大きすぎることがあります。では、295,808ではなく665,280 parameterを選ぶpenaltyは0.08 natsです。上でfitしたenvelopeでは、正しいsizeのmodelが18 %少ないcomputeで到達するlossに相当します。shapeを間違えるとbudgetの5分の1を捨てることになります。これは400個のmodelではなく、1枚のGPUで午後のうちに得られるChinchillaのFigure 3です。
次に横に読んでください。では最良のmodelはsweepした中で最小のものです。では295,808 parameterで、両側に挟まれています。budgetが大きくなるとoptimumは右へ移動します。それが修正の全内容です。論文の3つ目のapproach、すべてのrunに対するsurface をfitし、の制約下で最小化します。
L(N, D) = 24.7 / N^0.195 + 46.8 / D^0.169       (E fits to ~0; see below)
implied   N_opt ∝ C^0.464
compare Chinchilla 0.46-0.50 · Besiroglu 0.513 · Kaplan 0.73Kaplanの0.73に対して、ノートPCから0.46です。3つのbudgetだけでfitして3桁一致したのは幸運です。1桁目が一致したのは幸運ではありません。指数は移動します。定数は移動しません。というのも、ここでのoptimumにおけるtoken-to-parameter比は20ではなく170から540だからです。理由は3つあり、どれも示唆的です。はゼロにfitされます。lossが4 natsを超えているrunでは、Chinchillaのfitを支配するentropy floorにまったく近づいていないからです。Batch sizeとlearning rateは各点ごとにtuneせず固定しました。これはstep数が最も少ないrunに不利です。そしてそれは大きなmodelです。 FLOPsでは、128万parameterのmodelはoptimizer stepを合計159回しか得られません。Kaplanの項がどんなmodelにも必要だと言う数千stepを大きく下回ります。scaling lawはあるregimeの内部でfitされるものであり、これはChinchillaより6桁下にあります。
したがって論文のabstractは「現在のlarge language modelsは著しくundertrainedである」と述べます。Chinchillaがその実証です。700億parameterを1.4兆tokenで学習し、Gopherの2,800億parameter・3,000億tokenと同じ総computeで、57個のMMLU taskのうち51個で上回り、67.5 %対60 %でした。2 4分の1のsize、4.5倍のtext、同じお金、より良いmodelです。
この有名な比率には2つの注意点があります。「parameterあたり20 token」という文は論文にはありません。論文が述べているのは「model sizeが2倍になるたびにtraining tokenの数も2倍にすべき」ということだけです。20という値はTable 3と、Chinchilla自身の70 B on 1.4 Tからの推論です。そしてその精度は公表値より悪いです。Besiroglu et al. はFigure 4をdigitiseして再fitし、元のparametersは「再構成dataにうまくfitしない」、intervalは「data point数を考えると信じがたいほど狭い」とし、正直なrangeをparameterあたり「4から40」tokenとしました。8
Chinchillaのmethodの1つの詳細は、Chapter 1 がlearning-rate scheduleについてした約束を回収します。cosine scheduleはtoken budgetに合わせなければなりません。 1,000万tokenを見るmodelは、1,000万tokenでlearning rateをゼロへdecayさせる必要があります。1億token用のscheduleを与えて早く止めると、まだ高すぎるrateで下降途中のlossを読んでいることになります。Chinchillaはまさにこれをcontrolするため、各modelを4つのcycle lengthで学習しています。上のsweepも同じ理由でscheduleをbudgetから設定しています。
Scaling lawsが約束しないもの
セクション「Scaling lawsが約束しないもの」へのリンクそれらはこの分野で最も有用な経験的結果であり、日常的に過大に売り込まれています。限界は4つあります。
それらが予測するのはlossであって、capabilityではありません。 左辺はheld-out text上のcross-entropyです。これらの論文には、modelが正しいSQLを書くか、有害なrequestを拒否するか、toolを使うかについての主張を認めるものは何もありません。これはChapter 5のlessonの繰り返しです。lossの予測は、あなたが支払っているbehaviourの予測ではありません。
それらはfitされたものであり、導出されたものではありません。 を生み出す理論はありません。定数はtokenizerとともに動きます。Chapter 8で説明したように、2つのtokenizer間でperplexityを比較することが無意味なのはそのためです。またdata mixture、architecture、optimizerともに動きます。公開されたlawはすべて、それを生み出したsetupのlawです。だからMetaはLlama 3の前に自分たちのlawをfitし直しました。5
それらは各stepに新しいtokenがあることを仮定します。これは静かに無限corpusを仮定しているということです。Muennighoff et al. はそれが尽きたとき何が起きるかを測定しました。repeated dataの最大4 epochまではほとんどcostがありません。440億unique tokenを4回見た87億parameterのmodelは、1,780億unique token上の同じmodelより「validation lossがわずか0.5 %高い」だけで終わりました。一方で、約16 epochを超えると追加computeは何も買いません。9
そして、もう誰もcompute-optimalには学習していません。 Chinchillaが最小化するのは学習のcostです。deploymentされたmodelはその後、生成tokenごとにおよそ FLOPsを永遠に支払います。LLaMA 1はそれを明確に言いました。「目標とするperformance levelが与えられたとき、好ましいmodelは学習が最速のものではなく、inferenceが最速のものである」。10 Sardana et al. は代わりにを最小化することで形式化し、10億requestを見込むなら「Chinchilla-optimalより小さく長く」学習すべきだと見つけました。11 Llama 3の§9.1も同意しています。小さなmodelは「compute optimal trainingの点をはるかに超えて」学習され、「training computeをinference efficiencyと交換している」のです。5 その比率は時代遅れではありません。ただし、もはや問われていない問いに答えているのです。
Emergent abilitiesと、それが本物かをめぐる議論
セクション「Emergent abilitiesと、それが本物かをめぐる議論」へのリンクlossは滑らかに下がります。benchmark scoreは時々そうではありません。Wei et al. は、あるtaskがtraining computeの桁をまたいでもchanceに留まり、その後jumpする事例を集めました。GPT-3でおよそ FLOPsのところに3桁算術が現れ、MMLUはからのあいだで当てずっぽうを上回る、というものです。そしてそのpatternに名前を付けました。「ある能力は、小さいmodelには存在せず、大きいmodelには存在するならemergentである」。12 もしそれが実在する性質なら、安い実験から外挿するのは危険です。あなたが買おうとしているcapabilityは、手の届くどのscaleにも存在しないかもしれないからです。
Schaeffer、Miranda、Koyejoは、その大半は測定のartefactであり、mechanismは算術だと論じました。13 tokenごとのlossは滑らかに下がるので、1 tokenが正しい確率は徐々に改善します。modelを-token answer全体のexact string matchで採点すると、その確率を乗することになります。滑らかなcurveを大きなpowerに上げると崖のように見えます。同じoutputに対して、すべてを要求するのではなくtokenを数えるmetricに替えると、「familyのperformanceはscaleの増加に伴って滑らかに、連続的に、予測可能に改善する」のです。
彼らのauditで覚えるべき数はこれです。「BIG-Benchの39個のpreferred metricsのうち、emergenceを示すものは最大5個」であり、2つの不連続metricが主張されたcaseの92 %超を占めます。同時に彼らの注意書きも覚えるべきです。「本論文のいかなる内容も、large language modelsがemergent abilitiesを示し得ないと主張するものと解釈されるべきではない」。chart上のjumpは、別途示されるまではmetricについての証拠です。Chapter 29 では、それがあなた自身の問題になります。hard-cutoff metricを選ぶことは、気づかないままあなたが行うdecisionだからです。
Dataはどこから来るのか
セクション「Dataはどこから来るのか」へのリンクcorpusはpretraining runのうち、式が付いていない部分であり、最も重大なdecisionの多くが置かれている場所です。raw materialはweb crawlです。Common Crawlの2026年8月archiveには「21.4億web pages、または360 TiBのuncompressed content」があります。1か月分で、無料でdownloadできます。14 そのまま使えるものはほとんどありません。T5 paperはcrawlが「主としてgibberishや、menu、error message、duplicate textのようなboiler-plate textから成る」と述べ、そこで導入されたC4 pipelineは粗いheuristicのlistです。terminal punctuationで終わる行だけを残す、3文未満のpageを捨てる、curly braceや公的な卑語listのwordを含むpageを捨てる。月間20 terabytesのtextを約750 GBにします。15
粗い、というのが正しい言葉です。Dodge et al. はそれらのfilterが何を除去するかをauditし、卑語blocklistが**African-American Englishのdocumentの42 %、Hispanic-aligned Englishの32 %を削除する一方で、White-aligned Englishでは6.2 %**であることを見つけました。結果としてcorpusの97.8 %は最後のcategoryになりました。16 dialectについて意見を持たないruleが、意見を持っていたのです。
次にdeduplicationです。これはhousekeepingではありません。Lee et al. はC4内で61-word sentenceが61,036回繰り返されていることを見つけ、deduplicationによってmodelが「記憶したtextをemitする」rateが、生成tokenの1.9 %から0.19 %へ10分の1に下がることを示しました。17 ただし、多ければ良いわけではありません。FineWebのteamは96個のcrawl全体でglobalにdeduplicateし、4兆tokenを得ましたが測定可能なgainはありませんでした。その後、crawlごとに別々にdeduplicateし、20兆tokenを得て、既存のbest corpusに匹敵しました。18
次にcontaminationです。Llama 3は自分自身のcontaminationを測定し公開しました。AGIEvalの98 %、BIG-Bench Hardの95 %、HellaSwagの85 %がtraining setと8-gramでoverlapしており、MMLUについてはoverlapが高すぎて「良いperformance gain estimateを得ることは不可能」です。5 GPT-3の§4は、benchmarkをdata内に残したfiltering bugを報告し、戻る方法はありませんでした。「cost considerationsのため、modelを再学習することは不可能だった」のです。7
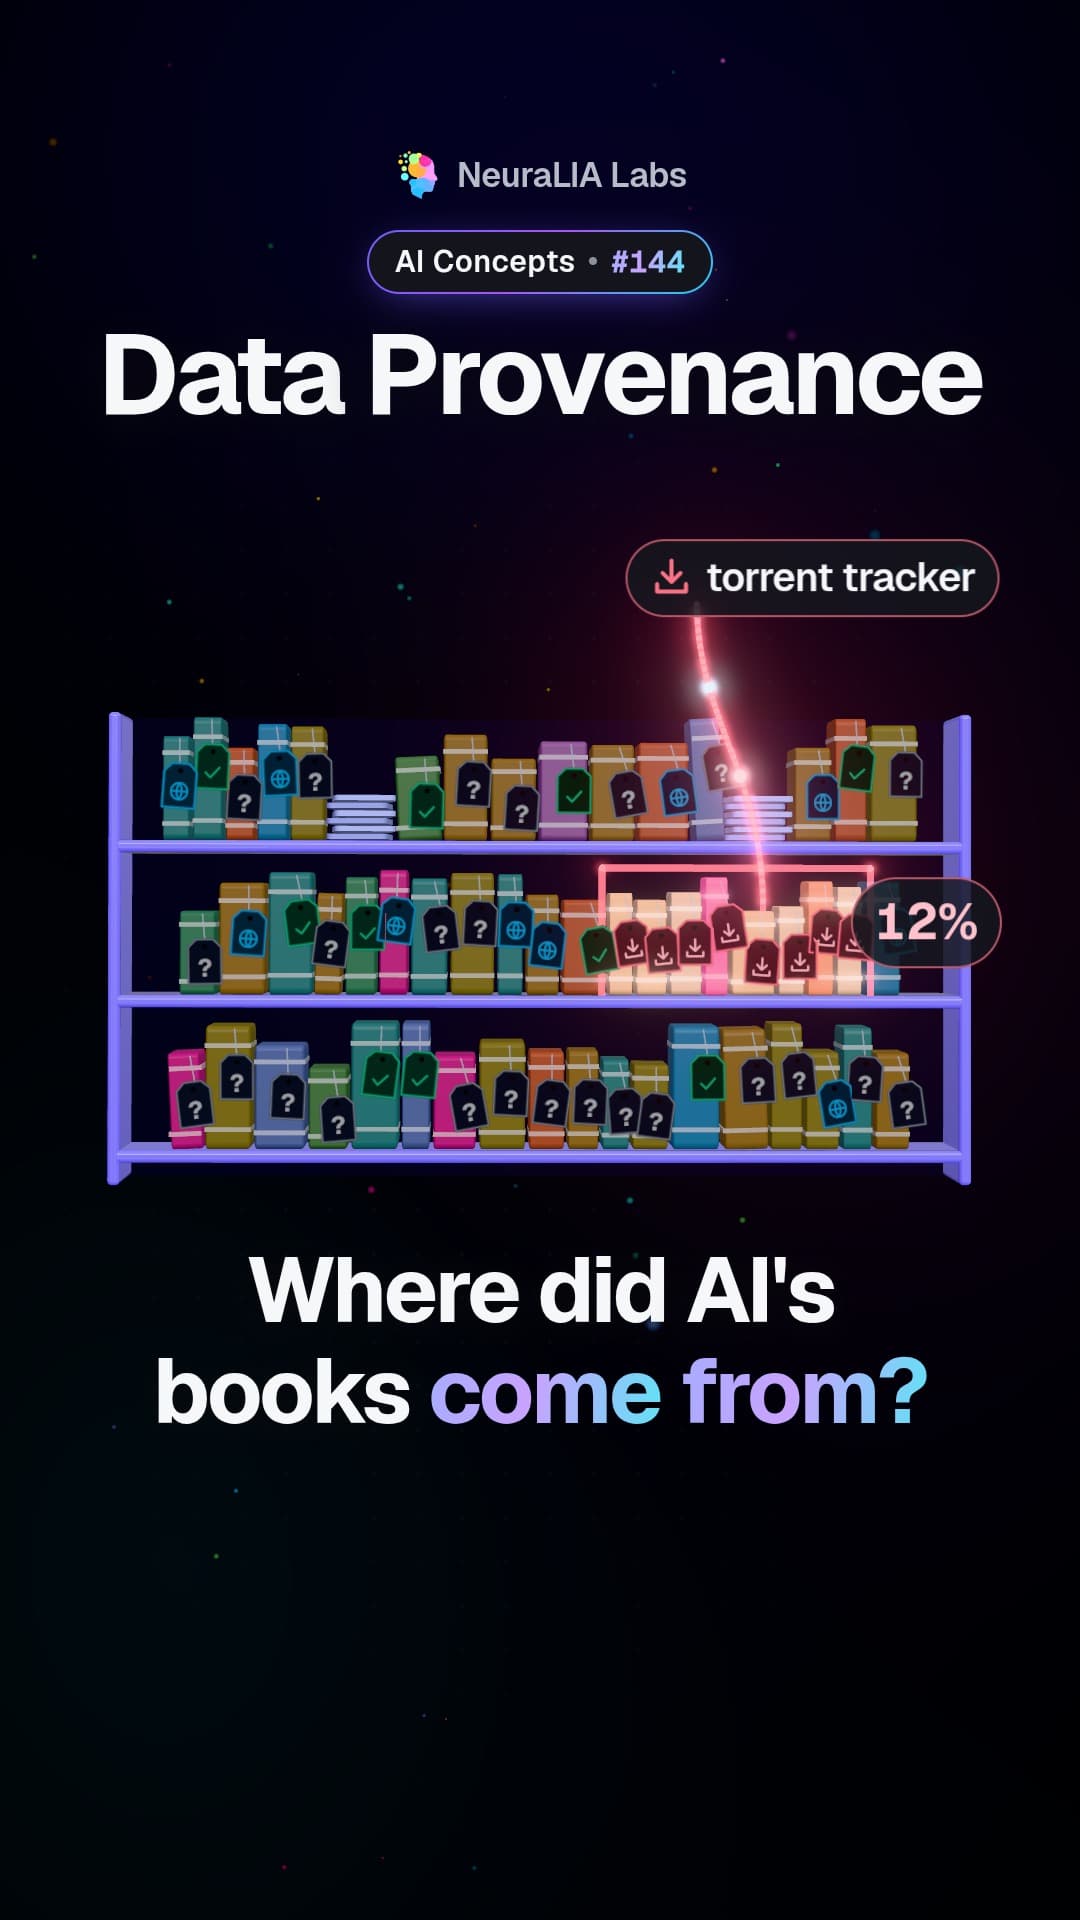
Provenanceは未解決の部分です。 The PileにはBooks3という100.96 GiBのcomponentが含まれていました。corpusの12 %であり、paper自身のconsent tableによれば、private torrent tracker由来の本です。19 著作権claimの後、2023年8月にofflineになりました。2026年9月時点の法的立場は未確定で、trendとして引用される3つの米国判決は互いに一致していません。Alsupは、合法的に取得された本での学習を「きわめてtransformative」と認定する一方で、pirated copiesから作られたlibraryはそうではないとし、Anthropicはその半分について**$1.5 billion**で和解しました。対象は482,460 works、1つあたりおよそ$3,000で、2026年7月20日に承認されました。20 ChhabriaはMetaにsummary judgmentを認めつつ、自身のrulingは「Metaが著作権materialsをlanguage modelsの学習に使うことが合法であるという命題を支持するものではない」、ただ「これらのplaintiffsが誤ったargumentをした」だけだと書きました。21 BibasはRoss Intelligenceに不利な判断を下す際、「今日私の前にあるのはnon-generative AIだけである」と述べました。22 この問いについて判断した米国appellate courtはありません。
lossでは扱えない部分を人間が担います。 TIMEは2023年1月、OpenAIのためにSama社を通じてtoxic textをlabelしていたworkerが、児童性的虐待、拷問、自傷を描写するpassageを読みながら「時給およそ$1.32から$2」を手取りとして得ていた一方、OpenAIはその作業にSamaへ時給$12.50を支払っていたと報じました。Samaはpay rangeとquotaの双方に異議を唱えています。23 これはpretrainingそのものではなく、pretraining周辺のfilteringです。しかし同じ請求書に載っており、人間が座る場所です。
電力は現実であり、たいてい誤引用されます。 最も慎重に公開された数字はBLOOMのものです。1,082,990 GPU-hours、433 MWh、runについて24.7 tonnes of CO₂ equivalent、製造とidle nodeを含めると50.5です。24 Patterson et al. はGPT-3を1,287 MWh、552 tonnesとしています。25 注意点が2つあります。BLOOMの優位はefficiencyではなく、57 g CO₂ per kWhのフランス原子力gridによるものです。OPT-175Bより多くのenergyを使っています。そして分野で最も引用されるemissions figure、Strubell et al. のneural architecture searchに対する626,155 lbは、後に88倍高すぎることが示されました。searchがproxy上で実行されたのに、full model sizeで走ったと仮定していたからです。26 LBNLのframingが擁護可能なものです。米国data centresは2024年に192 TWhを使用し、国内電力の4.7 %でした。これは1つのrunではなく、industryに付く数字です。27
貫く線は、Bender et al. がdocumentation debtと名付けたものです。「datasetが文書化されておらず、かつ事後に文書化するには大きすぎる状況に自分たちを置くこと」。28 上の事実はすべて、誰かが調べたから存在します。大半の人が使うmodelの背後にあるcorporaについては、誰も調べられません。
実際いくらかかるのか
セクション「実際いくらかかるのか」へのリンクここからは誰もが欲しがる算術です。4つの引用済みinputから作るので、古くなったときにどれを置き換えるべきかが明らかです。
Peak throughput
セクション「Peak throughput」へのリンクNVIDIAのH100 pageは、BF16 tensor-core throughputを1,979 teraFLOPSと記載していますが、脚注に「with sparsity」とあります。29 structured sparsityを使うpretraining runはないため、dense figureはその半分、989.5 TFLOP/sです。
Utilisation
セクション「Utilisation」へのリンクLlama 3のTable 4は38–43 %のBF16 model FLOPs utilisationを報告しています。ここでは**40 %**を取ります。GPUあたり395.8 TFLOP/sの有用な演算です。5
Price
セクション「Price」へのリンクLambdaの8×H100 SXM nodeのon-demand priceは、2026-09-06時点でGPU-hourあたり$3.99です。したがってnodeは1時間あたり$31.92です。30
Shape
セクション「Shape」へのリンクChinchillaの比率から、、したがってが得られます。
| budget | H100-hours | FLOPs | compute-optimal params | tokens | on one 8×H100 node | GPUs to finish in 90 days |
|---|---|---|---|---|---|---|
| $100 | 25 | 3.6e19 | 546 M | 10.9 B | 3.1 h | 1 |
| $1,000 | 251 | 3.6e20 | 1.73 B | 34.5 B | 31.3 h | 1 |
| $10,000 | 2,506 | 3.6e21 | 5.46 B | 109 B | 13 days | 2 |
| $100,000 | 25,063 | 3.6e22 | 17.3 B | 345 B | 131 days | 12 |
| $1,000,000 | 250,627 | 3.6e23 | 54.6 B | 1.09 T | 4 years | 116 |
| $10,000,000 | 2,506,266 | 3.6e24 | 173 B | 3.45 T | 36 years | 1,160 |
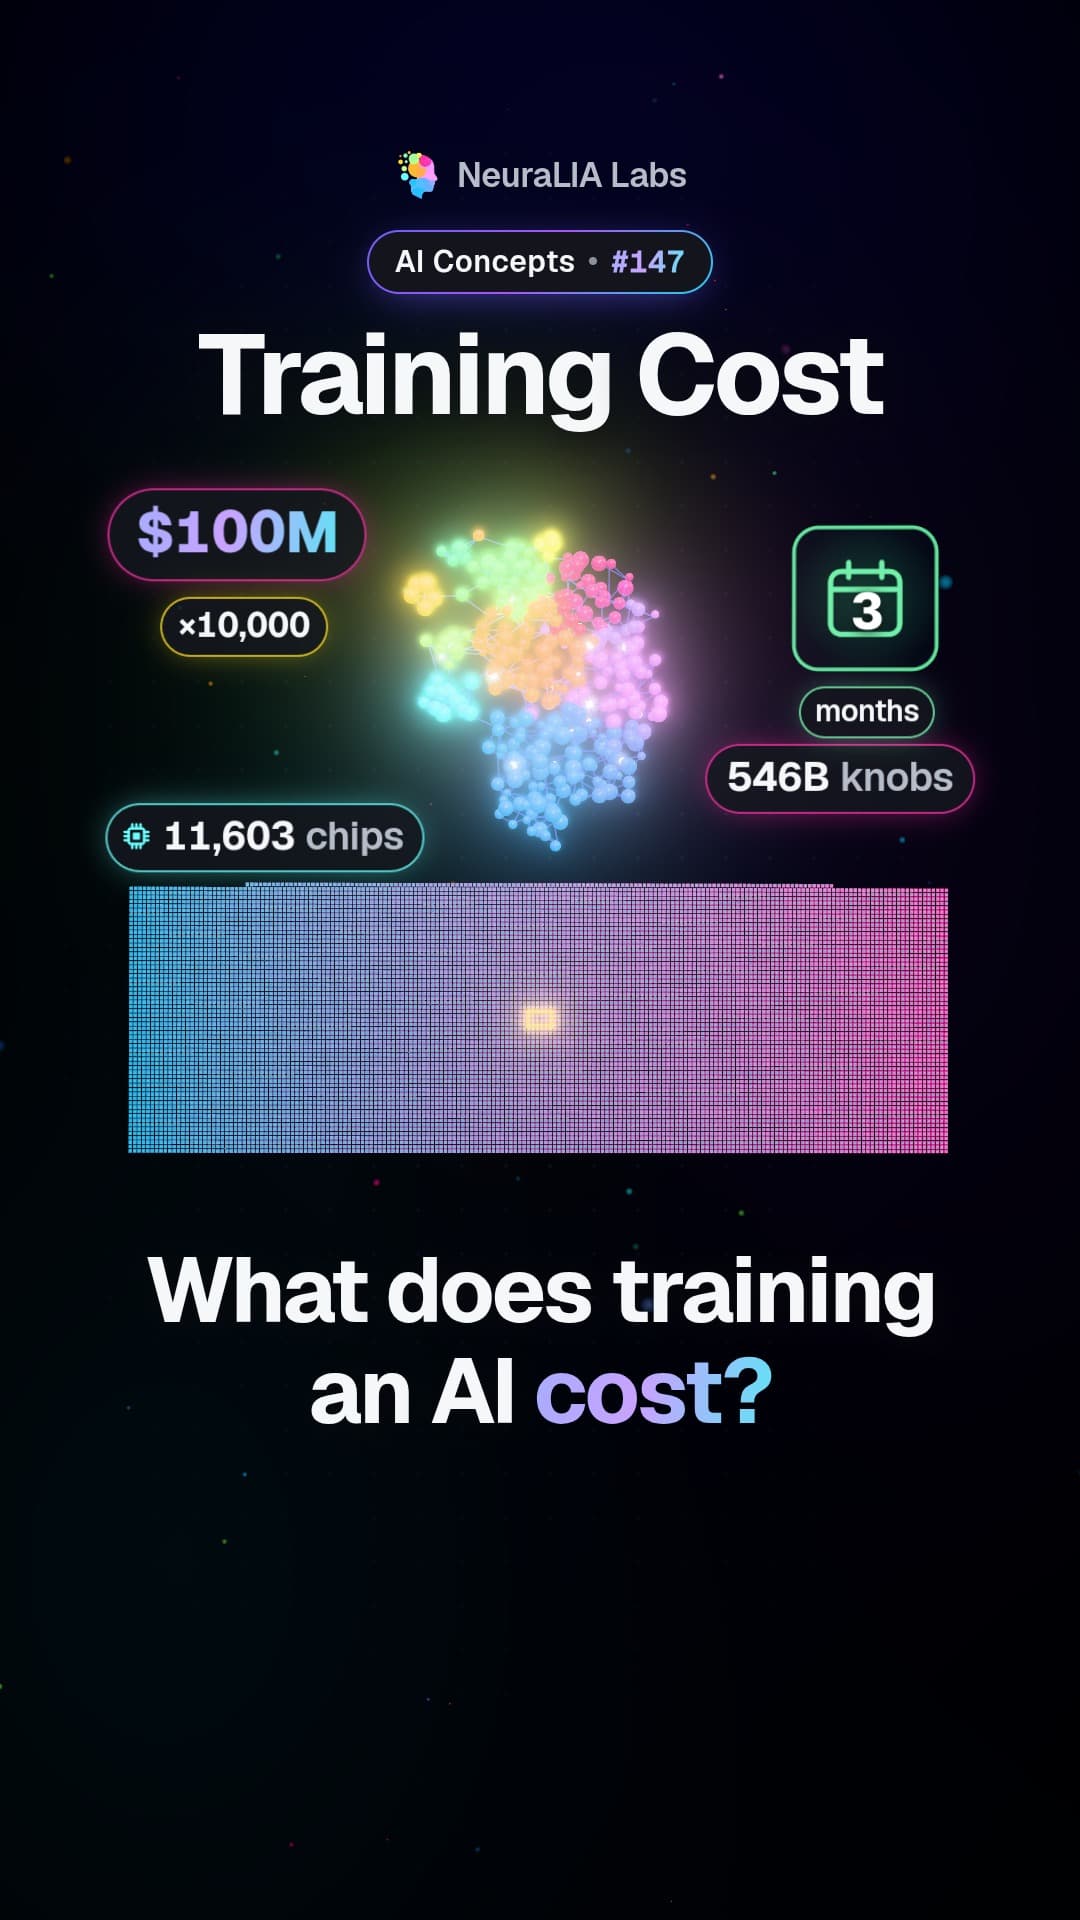
| $100,000,000 | 25,062,657 | 3.6e25 | 546 B | 10.9 T | 358 years | 11,603 |
最後の2列を一緒に読んでください。$10,000なら、借りたnode 1台で2週間以内に50億parameterのmodelが得られます。$100,000,000では、算術は5,460億parameterを示します。そして12,000台のH100を3か月間つなぐ必要があります。これはcredit cardで借りるものではありません。およそ$100,000を過ぎると、binding constraintはお金ではなくclusterになります。
このようなtableを信じる前に、実際のcostが公開されているrunと照合してください。llm.cは、GPT-2 124Mを8×A100 nodeで「約90分」、「約$20」で再現し、GPT-2 1.6Bを8×H100 nodeで24時間、$672で再現しています。31
$672, against what $672 actually bought (llm.c GPT-2 1.6B, one 8xH100 node, 24 h)
  this table predicts:      168 H100-hours   N = 1.41 B params   D = 28.3 B tokens
  what was actually run:    192 H100-hours   N = 1.558 B params  D = 33.6 B tokens

Llama 3 405B, against Meta's own published GPU-hours
  from the paper's 3.8e25 FLOPs at 40 % MFU:   26.67 M H100-hours
  published in Meta's Llama 3.1 model card:    30.84 M H100-hours    ratio 0.86
どちらも約15 %以内です。この種のestimateに値する精度はおよそその程度であり、通常引用される精度よりはかなり良いものです。
Headline比較:2つの定義を両方tableに載せて
セクション「Headline比較:2つの定義を両方tableに載せて」へのリンクこのsubjectで最も繰り返される数字は、2019年に約$43,000かかったGPT-2-class modelを、今日では数十ドルで再現できるというものです。現代側はよくdocumentedされています。歴史側はそうではありません。
Today. Karpathyのnanochat READMEにはこうあります。「you can train your own GPT-2 capability LLM ... for only $48 (~2 hours of 8XH100 GPU node) ... On a spot instance, the total cost can be closer to ~$15」。32 ここでの「GPT-2 capability」は正確で公開されています。GPT-2のCORE score 0.256525を上回ることです。leaderboardのbest entryは2026年3月14日時点で1.65 hoursです。$48はGPU-hourあたり$3を仮定しており、Lambdaのlist price $3.99より低いです。listでは約$64に近くなります。
In 2019. primary sourceはありません。OpenAIはdurationもcostも公開していません。chainは2019年2月のThe Registerから始まります。「256 Google TPU3 cores」と報じましたが、priceもdurationもありません。次に2019年6月のSyncedが、hardware costはGoogle Cloudで1時間$256だと指摘し、明示的に「OpenAI didn't specify the training duration」と述べました。$43,008は、1時間$256に、誰もsourceを示したことのない168時間という仮定を掛けたものです。
したがって正直なheadlineはこうです。GPT-2の公開benchmark scoreに一致するmodelは、今日ではrented hardware上で$100を大きく下回る額で学習できます。一方、2019年のcostは公開されておらず、有名なestimateはdurationについてsourceのない推測に依存しています。 collapseは本物で、現代側はcredit cardを持つ誰にでも再現できます。しかしratioは、存在しない数字に対する算術です。公開されたtraining cost全般の状態がこれです。GPT-3 paperにはdollar amountはまったくなく、Table D.1の FLOPsだけです。7 Llama 3 paperにもありません。5 あなたが読んだtraining costはすべて、FLOP count、hardware assumption、price assumptionからのestimateです。常に、誰のassumptionかを問う価値があります。
Base modelは何を知っているのか、そしていつ知るのを止めたのか
セクション「Base modelは何を知っているのか、そしていつ知るのを止めたのか」へのリンク出てくるものは、固定された時点で組み立てられた固定corpusを見ています。そこから2つの性質が従います。
1つ目はknowledge cutoffです。収集日以降のことをmodelは何も知りません。「不確か」なのではなく、何も知りません。そしてそう言うようには学習されていないため、そう言う代わりに流暢に作話します。Llama 3.1のmodel cardは2023年12月としています。33 すべてのmodelにそれがあり、deploymentではなくtraining dataの性質です。回避策はretrieval problemであり、それがChapter 19 です。
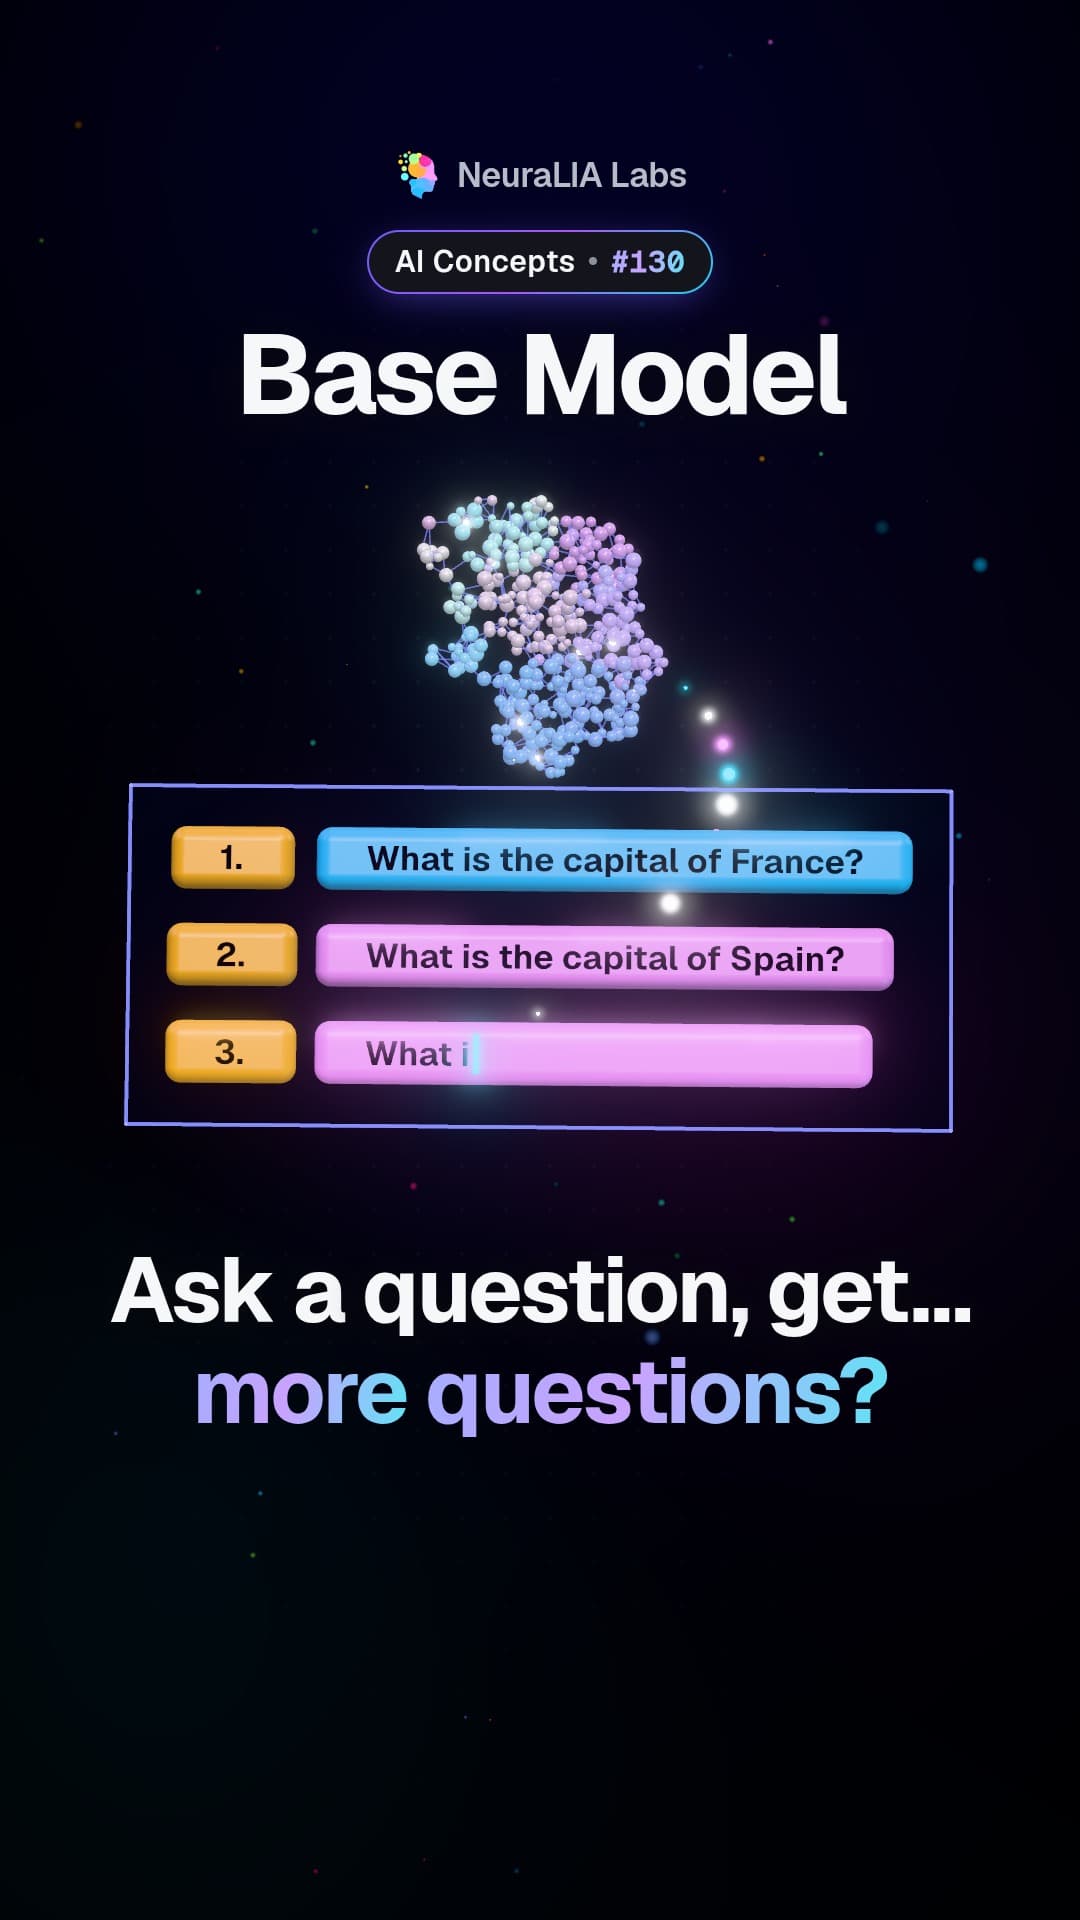
2つ目は、base modelは回答するのではなく補完するということです。「What is the capital of France?」を与えると、もっともらしいcontinuationは別のquestionかもしれません。corpusではそのstringがexercise listに最もよく現れるからです。
次に進む場所
セクション「次に進む場所」へのリンクtext completerはassistantではありません。instructionに従いません。corpusの中には、requestが続けられるべきではなく従われるべきだと示すものが何もなかったからです。2人の参加者によるconversationという概念もありません。有害なpromptの最もprobableなcontinuationを喜んで生成します。probableだけが、それが最適化された唯一のものだからです。
それを回答するものに変えるには、第2段階が必要です。そのcostは第1段階の1 %にも満たず、内容はほとんどすべて、望むbehaviourのexampleを見せ、その後model自身のoutputのpairを比較することです。その段階から、instruction following、chat templates、refusals、そして――多くの人が驚くことに――toolを呼び出す能力が生まれます。Chapter 11 がその段階です。supervised fine-tuning、RLHF、DPO、GRPO、そして「aligned」とは何を意味し、誰が決めるのかという問いです。
Sources and method
セクション「Sources and method」へのリンクこの章と併せて読む価値があるものとして、Karpathyのbuild-nanogptと付随するvideoがあります。GPT-2の完全な再現を、この章ではできないpaceでend to endに歩きます。またStanford CS324, Large Language Models もあります。dataとenvironmental impactに関するlecturesは、このcourseが一度だけ扱って委任するmaterialを、上のsectionより深く掘り下げています。
参考文献
セクション「参考文献」へのリンク-
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J. and Amodei, D. Scaling Laws for Neural Language Models. arXiv:2001.08361 (2020). 3つのpower lawsは§1.2のEqs. (1.1)–(1.3)で、完全な定数はAppendix A, Table 5にあります。の導出は§2.1、compute-allocation exponentsはTable 6です。compute lawは2つあることに注意してください。fixed batch sizeのとoptimal batch sizeのです。paperは後者を「predictionに使うべき」と述べています。 ↩ ↩2
-
Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E. et al. Training Compute-Optimal Large Language Models. arXiv:2203.15556 (2022). Table 2にexponents、Table 3にprojected budgets、§4にGopher comparison、Appendix Fにparameter-counting conventionがあります。Table 3下のproseは175 Bと280 Bの行についてTable 3自体と一致しません。引用すべきversionはtableです。 ↩ ↩2 ↩3 ↩4
-
Micikevicius, P., Narang, S., Alben, J., Diamos, G., Elsen, E., Garcia, D. et al. Mixed Precision Training. arXiv:1710.03740 (2017), ICLR 2018. FP32 master weightsは§3.1、loss scalingは§3.2です。 ↩ ↩2
-
Rajbhandari, S., Rajbhandari, S., Ruwase, O. and He, Y. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. arXiv:1910.02054 (2019), SC20. accountingは§3.1、activationに関するresidual-state figuresは§3.2です。 ↩
-
Grattafiori, A. et al. (Llama Team, AI @ Meta). The Llama 3 Herd of Models. arXiv:2407.21783 (2024). §1にcompute budgetとtoken count、§3.2.1にrefitted scaling law、Table 4にparallelism configurationとMFU、§5.1.4にcontamination analysis、§9.1にover-training statementがあります。paperにはdollar figuresもemissions tableもありません。 ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
Stanford CS336, Language Modeling from Scratch. Lecture 2はresource accounting、lectures 5–8はGPUs、kernels、parallelism、lectures 9 and 11はscaling、lectures 13–14はdataを扱います。この章がengineeringを委任しているcourseであり、公開されています。 ↩
-
Brown, T. B. et al. Language Models are Few-Shot Learners. arXiv:2005.14165 (2020). computeはAppendix D, Table D.1にあります。そこには文字どおり「flops per param per token」というheadingのcolumnがあり、すべてのGPT-3 rowの値は6です。Contamination analysisは§4です。 ↩ ↩2 ↩3
-
Besiroglu, T., Erdil, E., Barnett, M. and You, J. Chinchilla Scaling: A replication attempt. arXiv:2404.10102 (2024). ChinchillaのFigure 4をdigitisingしてdataを再構成し、再fitして、修正後のexponentsとかなり広いintervalsを報告しています。 ↩
-
Muennighoff, N., Rush, A. M., Barak, B., Le Scao, T., Piktus, A., Tazi, N., Pyysalo, S., Wolf, T. and Raffel, C. Scaling Data-Constrained Language Models. arXiv:2305.16264 (2023), NeurIPS 2023. 4-epoch resultは§6、16-epoch half-lifeはfitされたです。 ↩
-
Touvron, H., Lavril, T., Izacard, G., Martinet, X., Lachaux, M.-A., Lacroix, T. et al. LLaMA: Open and Efficient Foundation Language Models. arXiv:2302.13971 (2023). §1はChinchilla-optimal trainingに反対するinference-cost argumentを述べています。 ↩
-
Sardana, N., Portes, J., Doubov, S. and Frankle, J. Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws. arXiv:2401.00448 (2023), ICML 2024. §5にはcounterweightもあります。extreme token ratiosで学習されたmodelは改善し続けるが、「scaling lawsが予測するより遅い」というものです。 ↩
-
Wei, J., Tay, Y., Bommasani, R., Raffel, C., Zoph, B., Borgeaud, S. et al. Emergent Abilities of Large Language Models. arXiv:2206.07682 (2022), TMLR. 定義は§2、exampleとcompute thresholdsは§3–4およびTable 1です。 ↩
-
Schaeffer, R., Miranda, B. and Koyejo, S. Are Emergent Abilities of Large Language Models a Mirage? arXiv:2304.15004 (2023), NeurIPS 2023 outstanding paper. metric argumentは§2、BIG-Bench meta-analysisは§4、構成されたvision exampleは§5です。 ↩
-
Common Crawl, August 2026 Crawl Archive Now Available (CC-MAIN-2026-34), published 24 August 2026, accessed 2026-09-06. front page自身は「15年にわたる3,000億超のpages」、「合計10 petabytes超」と主張しています。これはここで価格を付けたmonthly crawlではなく、archive全体のfigureです。 ↩
-
Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W. and Liu, P. J. Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. arXiv:1910.10683 (2019), JMLR 21(140). C4 filtersは§2.2です。paperはsizeをbytesで示しており、tokensではありません。広くpaperに帰される156-billion-token figureは下のDodge et al. に由来します。 ↩
-
Dodge, J., Sap, M., Marasović, A., Agnew, W., Ilharco, G., Groeneveld, D., Mitchell, M. and Gardner, M. Documenting Large Webtext Corpora: A Case Study on the Colossal Clean Crawled Corpus. arXiv:2104.08758 (2021), EMNLP 2021. dialect removal ratesは§5.3、C4におけるbenchmark contaminationは§4.2です。 ↩
-
Lee, K., Ippolito, D., Nystrom, A., Zhang, C., Eck, D., Callison-Burch, C. and Carlini, N. Deduplicating Training Data Makes Language Models Better. arXiv:2107.06499 (2021), ACL 2022. 61,036 repeatsはfootnote 1、memorisation figuresは§6.2、Table 4で、50-token exact-match criterion下のgenerated tokensのpercentageです。 ↩
-
Penedo, G., Kydlíček, H., Ben Allal, L., Lozhkov, A., Mitchell, M., Raffel, C., Von Werra, L. and Wolf, T. The FineWeb Datasets: Decanting the Web for the Finest Text Data at Scale. arXiv:2406.17557 (2024), NeurIPS 2024 Datasets and Benchmarks. deduplication resultは§3.4です。released datasetはその後、paperの15 trillion tokensを超えて成長しています。 ↩
-
Gao, L., Biderman, S., Black, S. et al. The Pile: An 800GB Dataset of Diverse Text for Language Modeling. arXiv:2101.00027 (2020). Books3は§2.3とTable 1、consent tableはTable 5です。corpusは825.18 GiBなので、titleですら切り下げです。 ↩
-
Bartz v. Anthropic, No. 4:24-cv-05417 (N.D. Cal.). Fair-use order 23 June 2025 (Dkt. 231); class certification 17 July 2025; final approval and judgment 20 July 2026 (Dkt. 680). settlementはpast inputsだけをreleaseし、outputsもfuture conductもreleaseしません。 ↩
-
Kadrey v. Meta, No. 3:23-cv-03417-VC (N.D. Cal.), summary judgment 25 June 2025 (Dkt. 598). torrentingをめぐるdistribution claimは判断されておらず、なお係属中であることに注意してください。 ↩
-
Thomson Reuters v. ROSS Intelligence, No. 1:20-cv-00613-SB (D. Del.), revised opinion 11 February 2025 (Dkt. 770), Bibas J. Third Circuitへのinterlocutory appeal中(No. 25-2153)で、2026年6月11日にargument、執筆時点で未判断です。 ↩
-
Perrigo, B. Exclusive: OpenAI Used Kenyan Workers on Less Than $2 Per Hour to Make ChatGPT Less Toxic. TIME, 18 January 2023. $2はすべてのtargetを満たしたsenior reviewersのceilingです。多数派であるjunior labellersの手取りは$1.32でした。同じarticleで引用されたSamaの反論は$1.46–$3.74と、より低いquotaを示しています。 ↩
-
Luccioni, A. S., Viguier, S. and Ligozat, A.-L. Estimating the Carbon Footprint of BLOOM, a 176B Parameter Language Model. arXiv:2211.02001 (2022), JMLR 24(253). Tables 1 and 3. ↩
-
Patterson, D., Gonzalez, J., Le, Q., Liang, C., Munguia, L.-M., Rothchild, D., So, D., Texier, M. and Dean, J. Carbon Emissions and Large Neural Network Training. arXiv:2104.10350 (2021). GPT-3 figuresはTable 4、NAS estimateのcorrectionは§4.1です。 ↩
-
Strubell, E., Ganesh, A. and McCallum, A. Energy and Policy Considerations for Deep Learning in NLP. arXiv:1906.02243 (2019), ACL 2019. 最も引用された数字に何が起きたかという点で、正確に読む価値があります。paperは慎重で、外挿であることを明記していましたが、それでも誰もが繰り返した1行について2桁間違っていました。 ↩
-
Smith, S. J., Hubbard, A., Newkirk, A., Ganeshalingam, M., Holecek, B., Sartor, D., Mills, M. and Shehabi, A. United States Data Center Energy Usage Report: 2025 Update. LBNL-2001758 (18 June 2026). これは広く引用された2024 reportをhistorical seriesについてdownwardに改訂しています。2023年の176 TWh figureを引用しているなら、superseded editionを引用しています。 ↩
-
Bender, E. M., Gebru, T., McMillan-Major, A. and Shmitchell, S. On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? FAccT '21, pp. 610–623. DOI 10.1145/3442188.3445922. 「Documentation debt」は§4.4です。paper自身のcarbon figuresはStrubell et al. から引用されており、上のcorrectionを継承していることに注意してください。これはそのargumentへの反証ではなく、むしろ例示です。 ↩
-
NVIDIA. NVIDIA H100 Tensor Core GPU product page,
nvidia.com/en-us/data-center/h100/(accessed 2026-09-06). そのpageのtensor-core rowはFP64を除きすべて「with sparsity」という脚注を持ちます。ここで使ったdense BF16 figureは、公開された1,979 TFLOPSの半分です。 ↩ -
Lambda. GPU Cloud pricing,
lambda.ai/pricing(accessed 2026-09-06). on-demand、GPUごと、時間ごと、税抜きです。このsectionのpriceはこのcourseのどこよりも早く古くなりますが、その周りの算術は古くなりません。 ↩ -
Karpathy, A.
karpathy/llm.c, discussion #481, Reproducing GPT-2 (124M) in llm.c in 90 minutes for $20 (28 May 2024), and discussion #677, Let's reproduce GPT-2 (1.6B): one 8XH100 node, 24 hours, $672, in llm.c (11 July 2024). ↩ -
Karpathy, A.
karpathy/nanochat, README and 「time to GPT-2」leaderboard (accessed 2026-09-06). $48 figureと「GPT-2 capability」のCORE-score definitionはいずれもREADMEにあります。repository自身のspeedrun.shは「approximately 1.5 hours」と述べているので、2-hour figureは丸めと見なしてください。 ↩ -
Meta. Llama 3.1 model card,
models/llama3_1/MODEL_CARD.mdinmeta-llama/llama-models(accessed 2026-09-06). 405 B modelの30.84 M H100-hours、39.3 M total、location-basedの11,390 tCO2eq figure、December 2023 data cutoffのsourceです。 ↩
この章を動画で見る
この章のアイデアをわかりやすく解説する短い動画です。
 #128
Scaling laws: why ten times more compute buys a predictable gain
 #129
Pretraining: the guess-the-next-word game played on a whole library
 #130
Base model: the AI that continues your text instead of answering
 #131
FLOPs: the six-operation rule for sizing an AI training run
 #132
Training memory: 16 bytes per setting, plus a mountain of scratch work
 #133
Mixed precision: faster AI training without losing the tiny updates
 #134
Loss scaling: how AI training saves corrections too small to count
 #135
Data parallelism: copy the AI to every chip, split the reading
 #136
Model parallelism: slicing an AI that is too big for one chip
 #137
Model FLOPs utilization: how much chip speed AI training really uses
 #138
Chinchilla scaling: why a smaller AI that reads more can win
 #139
Repeating training data: how often an AI can reread the same text
 #140
Inference-aware scaling: why labs train small AI models for longer
 #141
Emergent abilities: do AI skills really appear out of nowhere?
 #142
Data filtering: the blunt rules that decide what an AI reads
 #143
Deduplication: why removing repeated text makes AI copy less
 #144
Data provenance: tracing where an AI's training books came from
 #145
Training energy: how much power AI uses, and why figures mislead
 #146
Documentation debt: why nobody can check what trained today's AI
 #147
Training cost: what $100, $10,000 and $100 million buy in AI
 #148
Knowledge cutoff: why an AI can be confidently wrong about recent news