
下坡:Gradient Descent,以及所有人都跳过的两个步骤
计算学习率的精确上限,再看一次对 3,600 个方向的暴力搜索如何在无人告知的情况下重新发现梯度。
本页内容
上一章以一条山谷结束。
这不是比喻意义上的山谷:它是一条真实的曲线,把损失画在单个参数上,先下降再回升。而曲线下方的那个损失并不是因为整洁才被选中——它是从关于测量噪声的陈述中推导出来的,平方误差是作为结果而不是惯例出现的。
所以我们有了一片带底部的地形,也有理由相信底部就是正确的位置。但我们还没有到达那里的方法。
本章会构建一个方法,而它就是训练本课程其余所有模型的算法——每一个,无一例外,包括那些拥有数千亿参数的模型。它大约二十行就能写完。难点不在这二十行里,而在几乎所有解释都会跳过的两个问题里:
- 为什么是减号。 更新会减去梯度。每篇教程都会这么写;却很少有人说明为什么梯度是向上的方向,而这正是让减号不只是信仰行为的唯一事实。
- 步子能迈多大。 “太大会发散,太小会很慢”是真的,也没什么用。有一个精确的数字,它可以从损失中计算出来,本章会算两次——一次针对玩具抛物线,一次针对真实数据。
设置,以及为什么不能直接搜索
链接到此部分:设置,以及为什么不能直接搜索为了让本章自洽,先重述一下:数据仍是 Chapter 1 传送带上的八个零件,但我们换一个问题。不是接受或拒绝——那个问题稍后会回来——而是根据零件宽度预测重量。
import numpy as np

WIDTH  = np.array([18.0, 19.5, 20.2, 21.0, 24.0, 25.5, 23.0, 26.0])
WEIGHT = np.array([47.0, 52.0, 49.0, 55.0, 61.0, 66.0, 70.0, 58.0])

x = WIDTH  - WIDTH.mean()      # 22.15 mm
y = WEIGHT - WEIGHT.mean()     # 57.25 g
这些测量值已经居中,和 Chapter 1 完全一样,而且这个原因在本章结束前会连本带利地回来。模型是一条直线,,损失是上一章推导出的均方误差:
两个参数。为什么不直接试很多值?我们真的试一下——从 到 ,从 到 ,步长 :
grid 501 x 1001 = 501,501 evaluations in 3.67 s
  best found: a = 2.1000, b = -0.0000, L = 24.592450
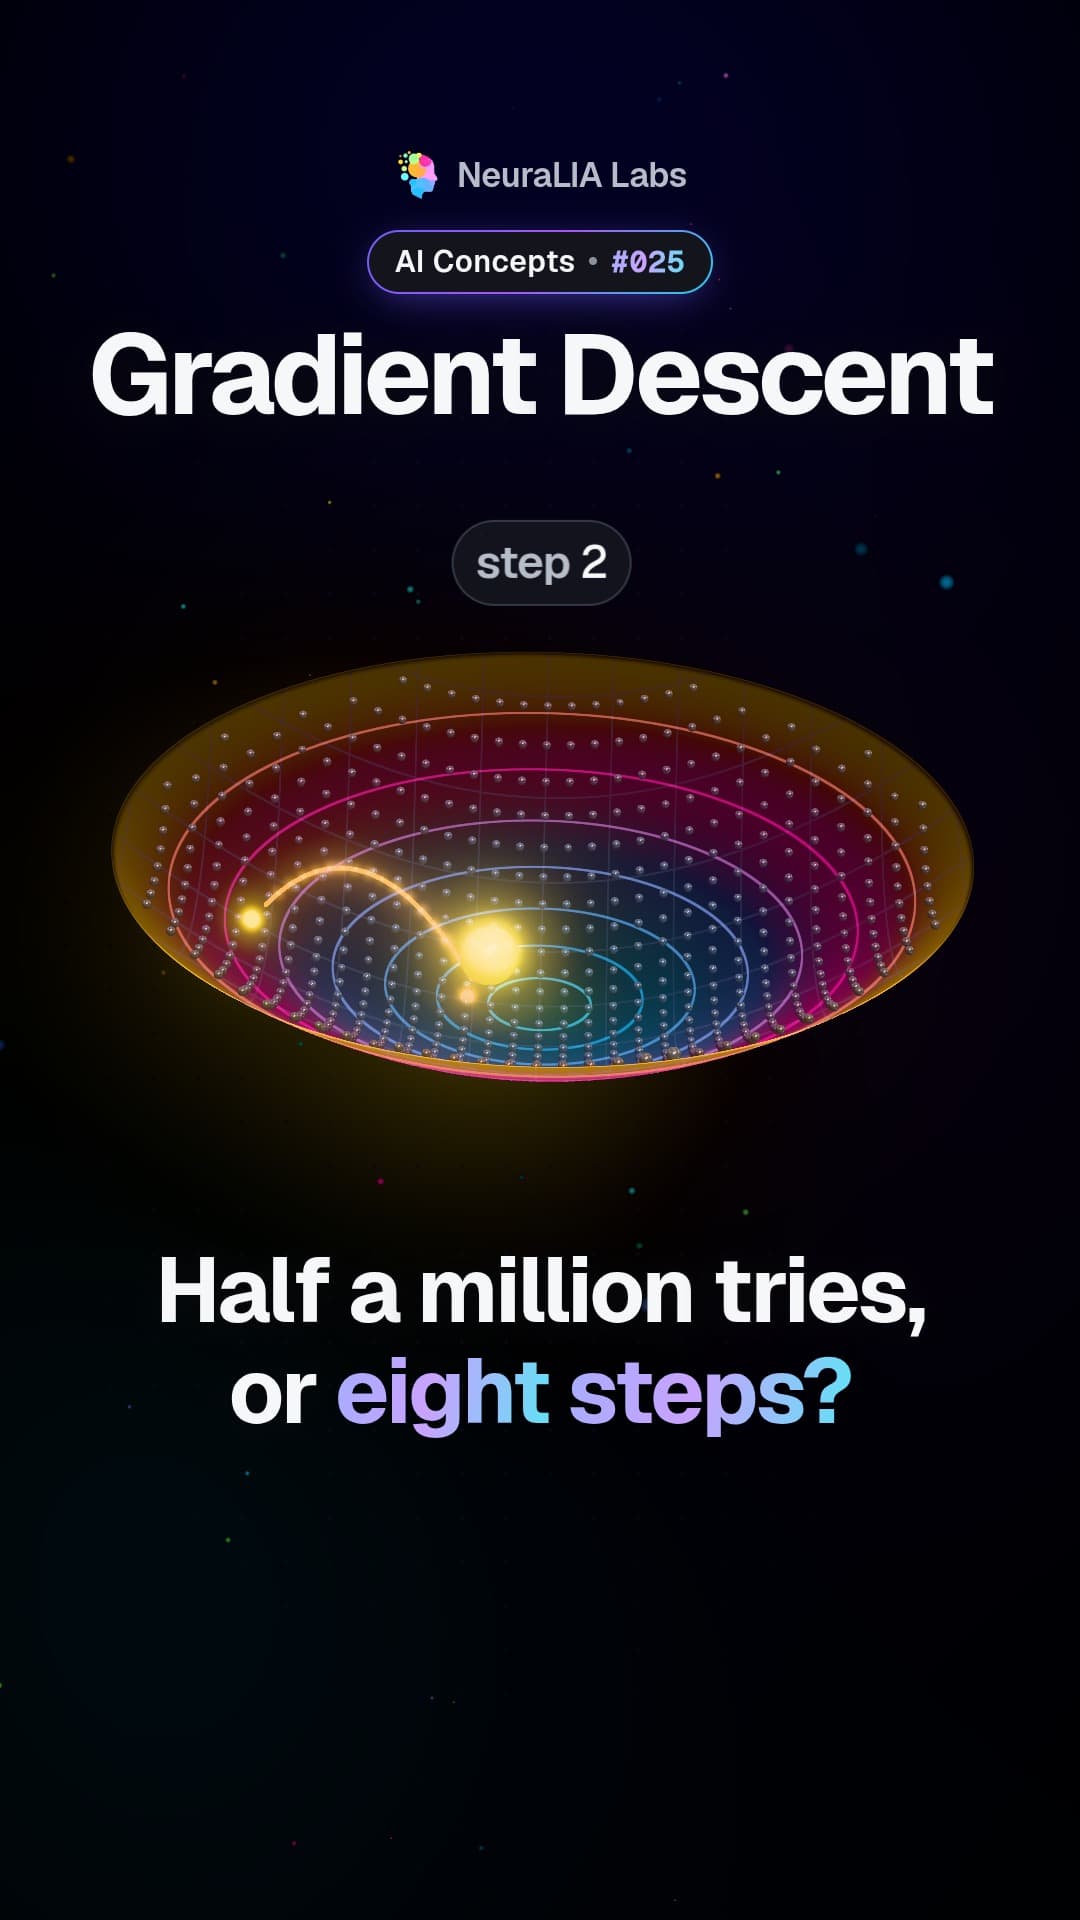
半百万次评估,只是把两个数字确定到小数点后两位——而且那一秒是某台机器上的挂钟时间,所以重跑可能在三到六秒之间;可复现的是评估次数和最小值。到本章末尾,Gradient Descent 会在八步内得到四位小数,在三十六步内得到完整 float64 答案。
但速度不是核心论点,接下来这一点决定了整门课程。Grid search 对 个参数、每个参数 个取值,需要 次评估。每个轴一千个取值时:
| 模型 | 参数 | grid 评估次数 |
|---|---|---|
| 这条直线 | 2 | |
| Chapter 5 的 XOR 网络 | 9 | |
| 一个小型多层网络 | 20,000 |
第三行不是一个很大的数字,而是一个失去意义的数字——可观测宇宙中的原子数量大约是 。随着模型变大,搜索不是变慢;它是停止存在。后面的一切,都是因为这张表而存在。
导数是一种你可以测量的量
链接到此部分:导数是一种你可以测量的量先把 固定住,这样就只剩一个参数和一条曲线,也就是上一章留给你的那张图。在曲线上取一点 ,然后问:如果我把 轻推一个小量 ,损失每单位轻推会移动多少?
这个比值就是上升量除以前进量——穿过曲线上两点的直线斜率。当 变小,两点滑向彼此,这条线就变成切线。它的斜率就是导数 :损失相对于 的单位变化而变化的速率。它不是对某个东西的近似,也不是一个无穷小的量。它是普通比值的极限。
值得跑一下,因为数字会说出定义本身没有说的东西:
def loss1(a):
    return np.mean((a * x - y) ** 2)

for h in [1.0, 1e-2, 1e-4, 1e-6, 1e-8, 1e-10, 1e-12, 1e-14]:
    q = (loss1(1.0 + h) - loss1(1.0)) / h
print(f"h = {h:<8.0e} slope estimate = {q:.10f} error = {abs(q + 16.385):.3e}")h = 1e+00 slope estimate = -8.9400000000 error = 7.445e+00
h = 1e-02 slope estimate = -16.3105500000 error = 7.445e-02
h = 1e-04 slope estimate = -16.3842555001 error = 7.445e-04
h = 1e-06 slope estimate = -16.3849925556 error = 7.444e-06
h = 1e-08 slope estimate = -16.3850003787 error = 3.787e-07
h = 1e-10 slope estimate = -16.3850444324 error = 4.443e-05
h = 1e-12 slope estimate = -16.3851154866 error = 1.155e-04
h = 1e-14 slope estimate = -17.0530256582 error = 6.680e-01这里发生了两件事,而且两件都承重。
误差不是含糊地正比于 ——它精确地是 。 把 除以一百,误差也除以一百,每次都精确到四位有效数字。这个常数不是装饰:它是损失的二阶导数的一半,也是两节之后一个想法的首次出现——曲线在某点附近看起来像一条直线,再加上一个与 成正比的修正项。
然后模式断裂了。 低于 时,估计反而变得更差,到了 ,第二位数字就错了。数学上什么都没发生;是上一章的浮点盒子在起作用。 和 的前十位数字相同,把它们相减会毁掉这些数字,再除以一个极小的数会放大剩下的残骸。存在一个最佳 ——这里大约是 ,差不多是机器 epsilon 的平方根——再小不是更谨慎,而是更不谨慎。记住这一点;本章末尾有个函数依赖它。
精确斜率来自微积分而不是测量,是 。所以我们可以停止测量,开始推导。
复合,以及链式法则
链接到此部分:复合,以及链式法则这是整门课程其余部分建立其上的想法,清楚地说一次。
复合两个函数,就是把一个函数喂给另一个函数:。仅此而已。
深度网络不是像一个复合。它就是一个复合。一层是一个函数;堆叠层就是复合它们;“深度”就是这条链中函数的数量。Chapter 5 构建网络时,它构建的是 ,除此之外没有别的。这意味着,对我们来说,微积分中最重要的一条规则,就是那条对复合求导的规则:
速率会相乘。 如果 的变化速度是 的三倍,而 的变化速度是 的两倍,那么 的变化速度就是 的六倍。这就是全部内容,也解释了为什么一个信号反向穿过十层时会乘上十个数字——这也是 Chapter 6 会花一节讨论当这些数字都略小于一时会发生什么的原因。
把它用到我们的损失上。写出残差 ,于是 。每个 都通过内部函数 依赖于 ,而该内部函数的导数是 。逐项应用链式法则:
这些花体 符号表示偏导数:对一个变量求导,并把其他所有变量都视为常数。这里没有发生新事情——它仍是前面的同一个极限,只是沿着一个轴取。把这些偏导收集成一个向量,你就得到了梯度:
在点 ,这个向量是 。两个数字。问题是它们意味着什么,而这就是所有人都会跳过的第一步。
为什么梯度指向上坡
链接到此部分:为什么梯度指向上坡梯度是一个由沿坐标轴的斜率组成的向量。我们只证明了这一点。把它们组装成一个向量后,会得到某个特定方向,这并不显然——也不应该显然。
所以先定义我们真正想要的东西。选一个单位向量 ,也就是一个方向。方向导数就是当你沿那个方向走时,损失变化的速率:
链式法则把它变成可计算的东西。沿 行走时, 以 的速率变化, 以 的速率变化,而这些贡献会相加:
任意方向上的变化速率,都是梯度与该方向的 dot product。现在是关键结论,一行几何就够了。用两个向量之间的角 写出 dot product,
因为 的长度是 1。你唯一能控制的是 ,它在 最大,在转半圈也就是 度时最小。所以:
- 最陡上升沿着 本身,且那里的斜率精确等于 。
- 最陡下降沿着 ,且那里的斜率是 。
- 垂直于梯度时,损失完全不变。这就是为什么等高线图中的线会与梯度成直角相交。
这就是减号。它不是惯例,不是某个人选择的符号翻转:最快下降的方向是负梯度,是因为 在转半圈时最小,除此之外没有别的原因。
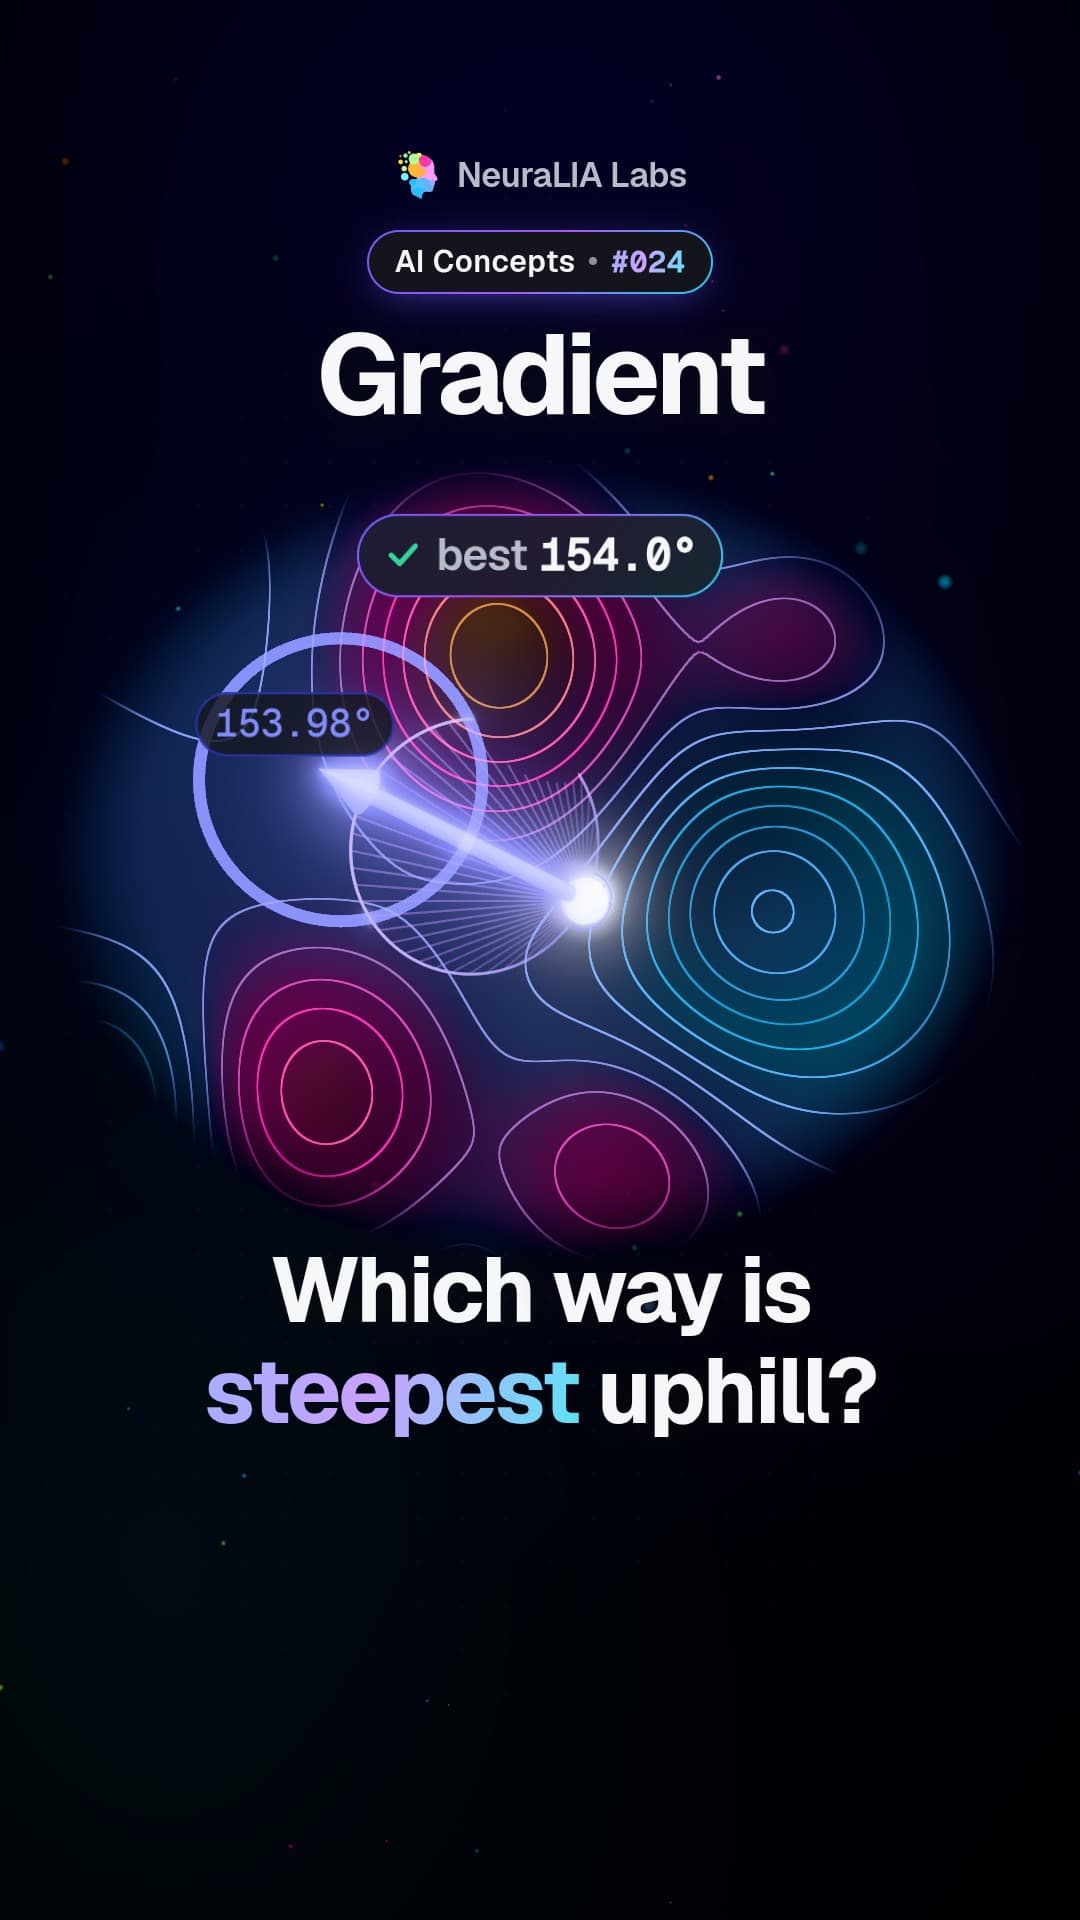
既然这是关于所有方向的主张,那就拿所有方向来测试。采样 3,600 个方向,每十分之一度一个,并通过轻推来测量每一个:
theta = np.array([1.0, 4.0])
g = grad(theta)
print("gradient      ", g)
print("its length    ", np.linalg.norm(g))
print("its angle     ", np.degrees(np.arctan2(g[1], g[0])) % 360, "degrees")

best = max(
    ((loss(theta + 1e-6 * u) - loss(theta - 1e-6 * u)) / 2e-6, np.degrees(ang))
    for ang, u in (
        (a, np.array([np.cos(a), np.sin(a)])) for a in np.arange(3600) * 2 * np.pi / 3600
    )
)
print("steepest slope", best[0], "at", best[1], "degrees")gradient [-16.385 8. ]
its length 18.23371122399386
its angle 153.97598928042032 degrees
steepest slope 18.233709624837502 at 154.0 degrees一个完全不知道梯度的搜索,在 3,600 个方向上找到了 154.0 度处的最陡上升——也就是梯度自己的方向,误差只在搜索的 0.1 度分辨率内。它在那里找到的斜率 18.2337,也与梯度长度在六位数字上相符。这个定理不是关于梯度含义的故事;它是一个可测量的事实,而这就是测量结果。
为什么向下走一小步真的有用
链接到此部分:为什么向下走一小步真的有用现在是第二个被跳过的步骤。我们知道哪个方向向下。但这并不意味着沿那个方向走会降低损失,因为“向下”说的是无穷小轻推,而一步并不是无穷小。
桥梁是线性化。在某点附近,一个光滑函数等于它的切线再加上一个修正项:
这是一阶 Taylor 展开。被丢弃的 是曲率——也就是让斜率表中的估计恰好错 的同一个项。放入我们打算迈出的步子,:
损失会下降 。这里的每一部分都是非负的,所以承诺是真实的——只要 足够小,因为被忽略的项会像 一样增长,并最终吃掉它。这就是全部理论。下面先是承诺被兑现,然后是承诺被打破:
eta = 0.2       promised    66.49364500   delivered   -16.01619240   ratio -0.240868
eta = 0.1       promised    33.24682250   delivered    12.61936315   ratio  0.379566
eta = 0.01      promised     3.32468225   delivered     3.11840766   ratio  0.937957
eta = 0.001     promised     0.33246822   delivered     0.33040548   ratio  0.993796
eta = 0.0001    promised     0.03324682   delivered     0.03322620   ratio  0.999380
eta = 1e-05     promised     0.00332468   delivered     0.00332448   ratio  0.999938
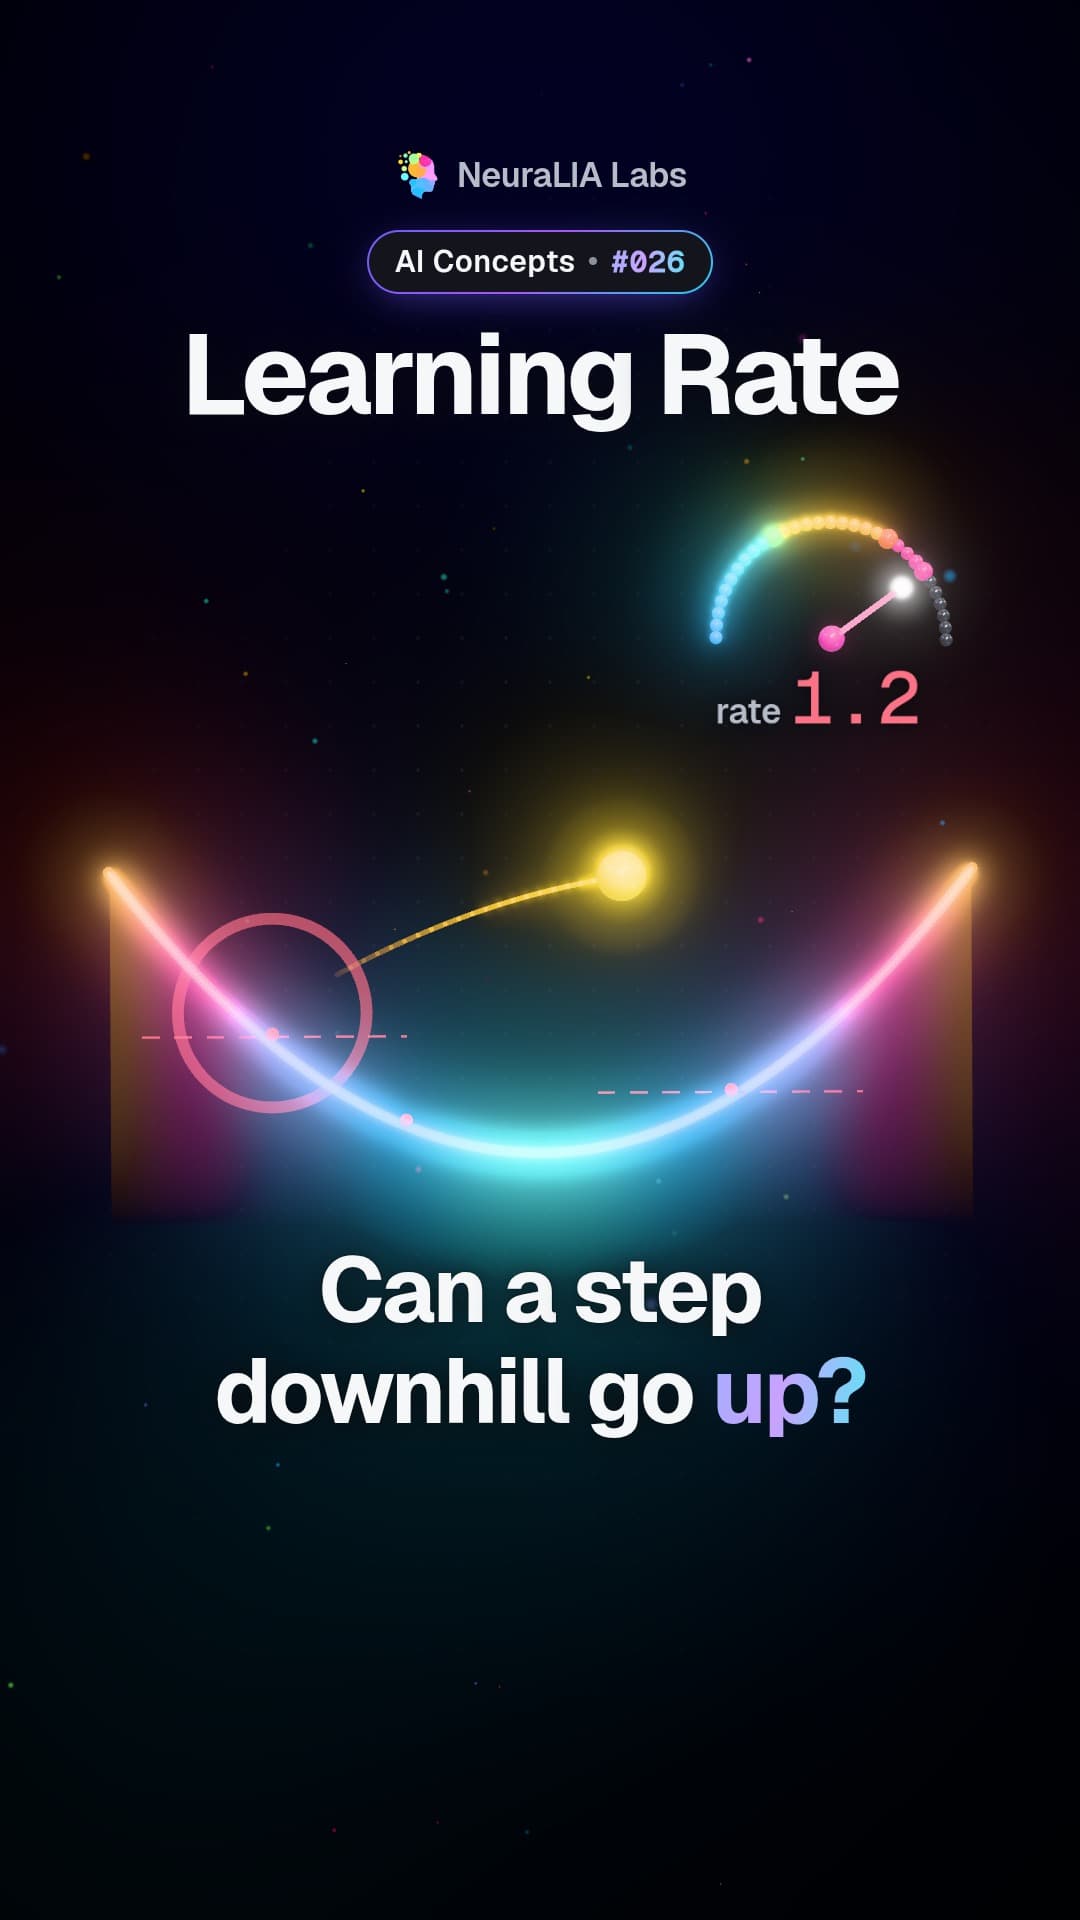
从底部往上读。随着 变小,实际下降量会收敛到承诺的下降量——比值 0.99938,然后 0.99994——这就是 Taylor 定理正确的样子。从顶部往下读,在 时,实际“下降量”是负十六。这一步沿着下坡走,损失却上升了。
所以更新规则是
而它带着一个没人说明的条件: 必须足够小。到底相对于什么足够小,就是下一节。
学习率有上限,而且可以计算
链接到此部分:学习率有上限,而且可以计算从最简单的山谷开始,,其中 。Gradient Descent 的一步是
位置在每一步都会乘以 。这是一个等比数列,而等比数列只有一条规则:当乘数的绝对值小于 1 时它会收缩,否则会增长。所以 ,也就是 。
边界精确地在 。 不是“大约 1”,也不是“1 通常太大”。在 时,乘数是 ,点会永远在 和 之间来回弹跳,既不接近也不逃离。低于它,收敛;高于它,发散。区间在 处再次分裂,那里乘数改变符号:低于它时接近是单调的,高于它时点会越过谷底并在两侧交替,而恰好等于 时乘数为 0,一步就落在最小值上。
四种状态,来自四行代数。自己去跨过这些边界:
然后是有趣的那个:
现在是一般规则,它也从同一个论证中掉出来。乘数 实际上是 ,而在最小值附近,多参数损失的每个方向都有一个这样的数——也就是二阶导数矩阵的特征值。每个方向都必须同时稳定,所以上限由最大的那个决定:
对于 ,,上限是 1,也就是我们刚刚推导出的结果。对于我们的传送带,二阶导数矩阵是 ,其中 是输入的两列矩阵,它的特征值是 2 和 14.89,所以上限是 。这是一个带有五位有效数字的预测。测试一下:
lr=0.1343    -> L =      24.5924
lr=0.13431   -> L =      24.5924
lr=0.13432   -> L =       4707.8       BLEW UP
lr=0.13433   -> L =  4.00452e+16       BLEW UP
lr=0.1344    -> L = 1.18229e+107       BLEW UP
一行线性代数和十万次 for 循环迭代,在五位小数上吻合。
这就是 Chapter 1 回来的地方。 上面的一切都使用了居中后的测量值。在原始毫米和克上运行完全相同的代码,特征值会从 2 和 14.89 变成 0.0298 和 998.1。上限从 0.134 崩塌到 0.002004——同样精确,在 lr=0.002003 收敛,在 lr=0.002004 爆炸。
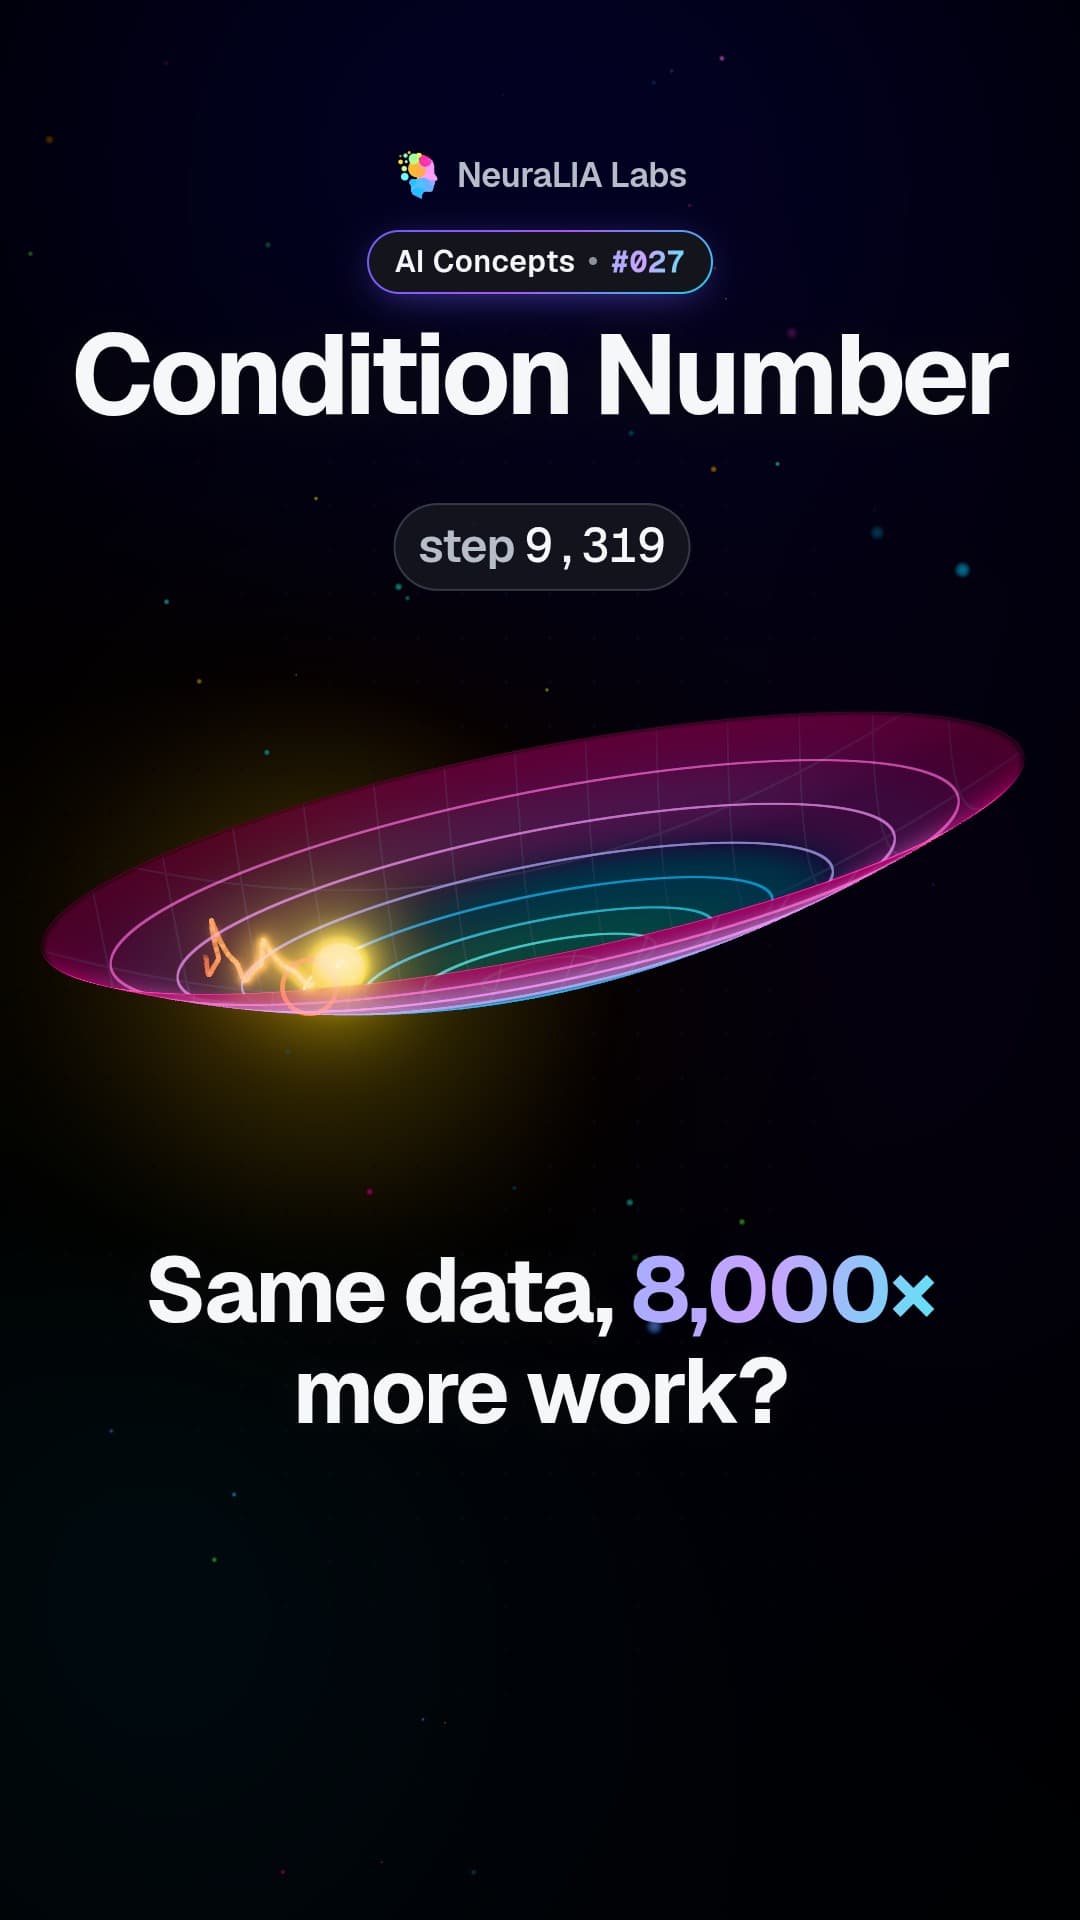
比上限更糟的是特征值之间的比值。条件数衡量山谷离圆形有多远:一条又长又窄的沟会迫使学习率小到能应付陡峭的墙壁,然后沟底也只能以同样的爬行速度前进。我们的条件数从居中后的 7.44 变成原始数据的 33,452。在每个版本能采用的最佳学习率下:
| 特征 | 条件数 | 最佳学习率 | 达到距离最优值 1% 以内所需步数 |
|---|---|---|---|
| 居中 | 7.44 | 0.1184 | 10 |
| 原始毫米和克 | 33,452 | 0.0020037 | 79,513 |
同样的数据,同样的代码,最后得到同样的答案——却要多做八千倍的工作,只因为没人减去均值。在 Chapter 1 中,同样的遗漏让感知机的 epoch 数多了六千倍,而那里的诊断是几何的:数据漂浮在离原点很远的位置。这里是同一种几何,只是披上了优化的外衣,也因此输入归一化不是卫生建议,而是算术。1
二十行
链接到此部分:二十行上面没有任何东西需要库。下面就是整个优化器。
def loss(theta):
    a, b = theta
    return np.mean((a * x + b - y) ** 2)


def grad(theta):
    a, b = theta
    residual = a * x + b - y
    return np.array([np.mean(2 * residual * x), np.mean(2 * residual)])


def descend(theta, lr, steps):
    theta = np.array(theta, dtype=float)
    for _ in range(steps):
        theta = theta - lr * grad(theta)
    return theta


theta = descend([0.0, 0.0], lr=0.05, steps=60)
print(theta, loss(theta))[ 2.10040296e+00 -2.76445533e-15] 24.592448791134984这八个点的闭式最小二乘答案是 ,,损失为 。这个循环在不知道闭式解存在的情况下找到了八位有效数字——这很重要,因为从 Chapter 5 开始就不会再有闭式解了。
轨迹如下,因为看它移动才是重点:
   0 a=0.000000 b=0.000000 L=57.437500
   1 a=1.563750 b=0.000000 L=26.736582
   2 a=1.963288 b=-0.000000 L=24.732418
   5 a=2.098116 b=-0.000000 L=24.592488
  10 a=2.100400 b=-0.000000 L=24.592449
  60 a=2.100403 b=-0.000000 L=24.592449
大部分距离在前两步就走完了,因为当你离谷底最远时梯度最大,靠近时梯度会变小。Gradient Descent 会在最小值附近自动减速。这是一个特性,而在 Chapter 6 中,它也会成为一个问题。
斜率还会在哪里为零
链接到此部分:斜率还会在哪里为零到目前为止的论证有一个漏洞。当 时,步骤会停止,而我们一直把那里叫作“最小值”。梯度为零的点是临界点,而成为最小值只是成为临界点的方式之一:
- 局部最小值:每个方向都是上坡,但它可能不是所有这类点中最低的;
- 局部最大值:每个方向都是下坡;
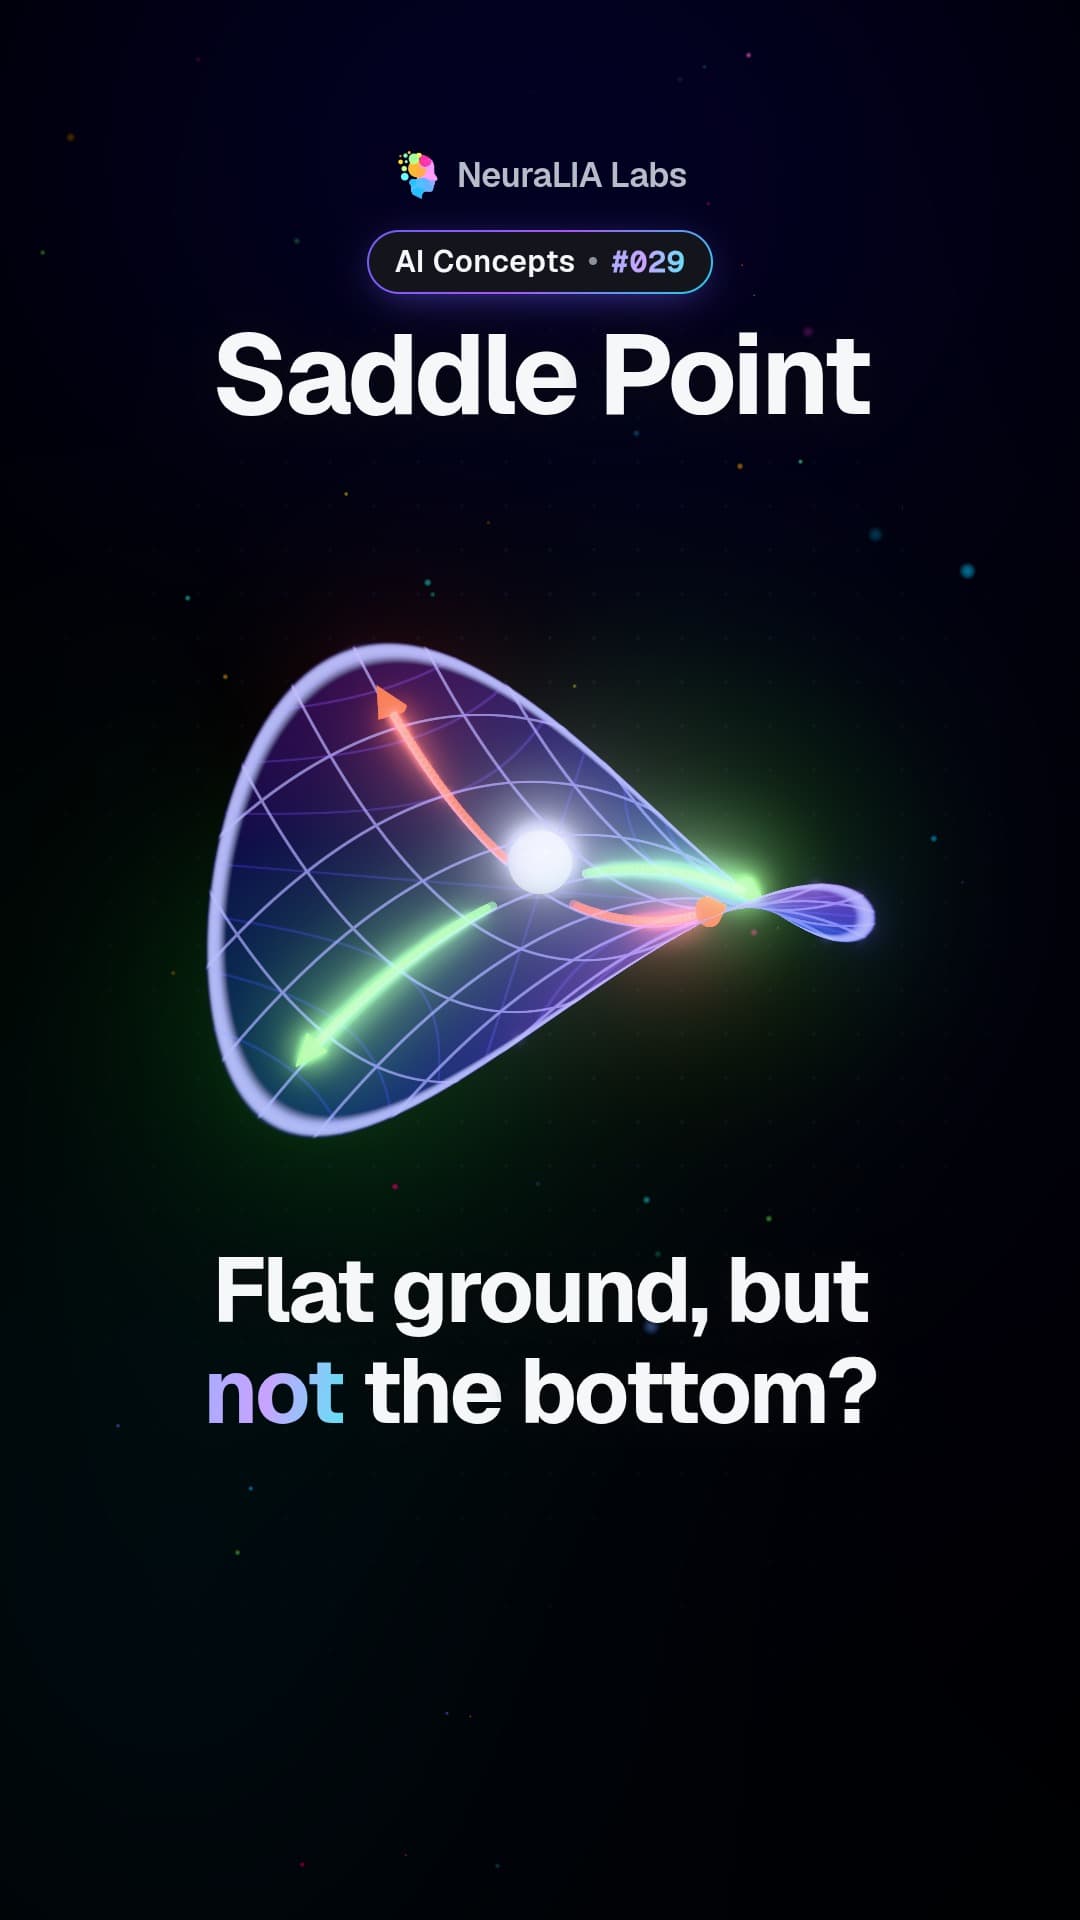
- 鞍点:某些方向上坡,另一些方向下坡。曲面 有 ,它在原点为零,而原点处函数沿 轴是最小值,同时沿 轴是最大值。
Gradient Descent 无法区分这些情况,因为它永远只看梯度,而三者的梯度都为零。
我们的直线只有一个临界点,而且它就是答案——线性模型上的平方误差损失是凸的,是一个单一的碗,在它上面做下降不可能找不到全局最小值。这个性质不会在本课程后面继续保留。神经网络的损失不是凸的,从 Chapter 5 开始,“那个最小值”不再是存在的东西:会有很多个,深浅不同,而你得到哪一个取决于从哪里开始。这句话到此为止,因为理论很大,而实践后果很小。
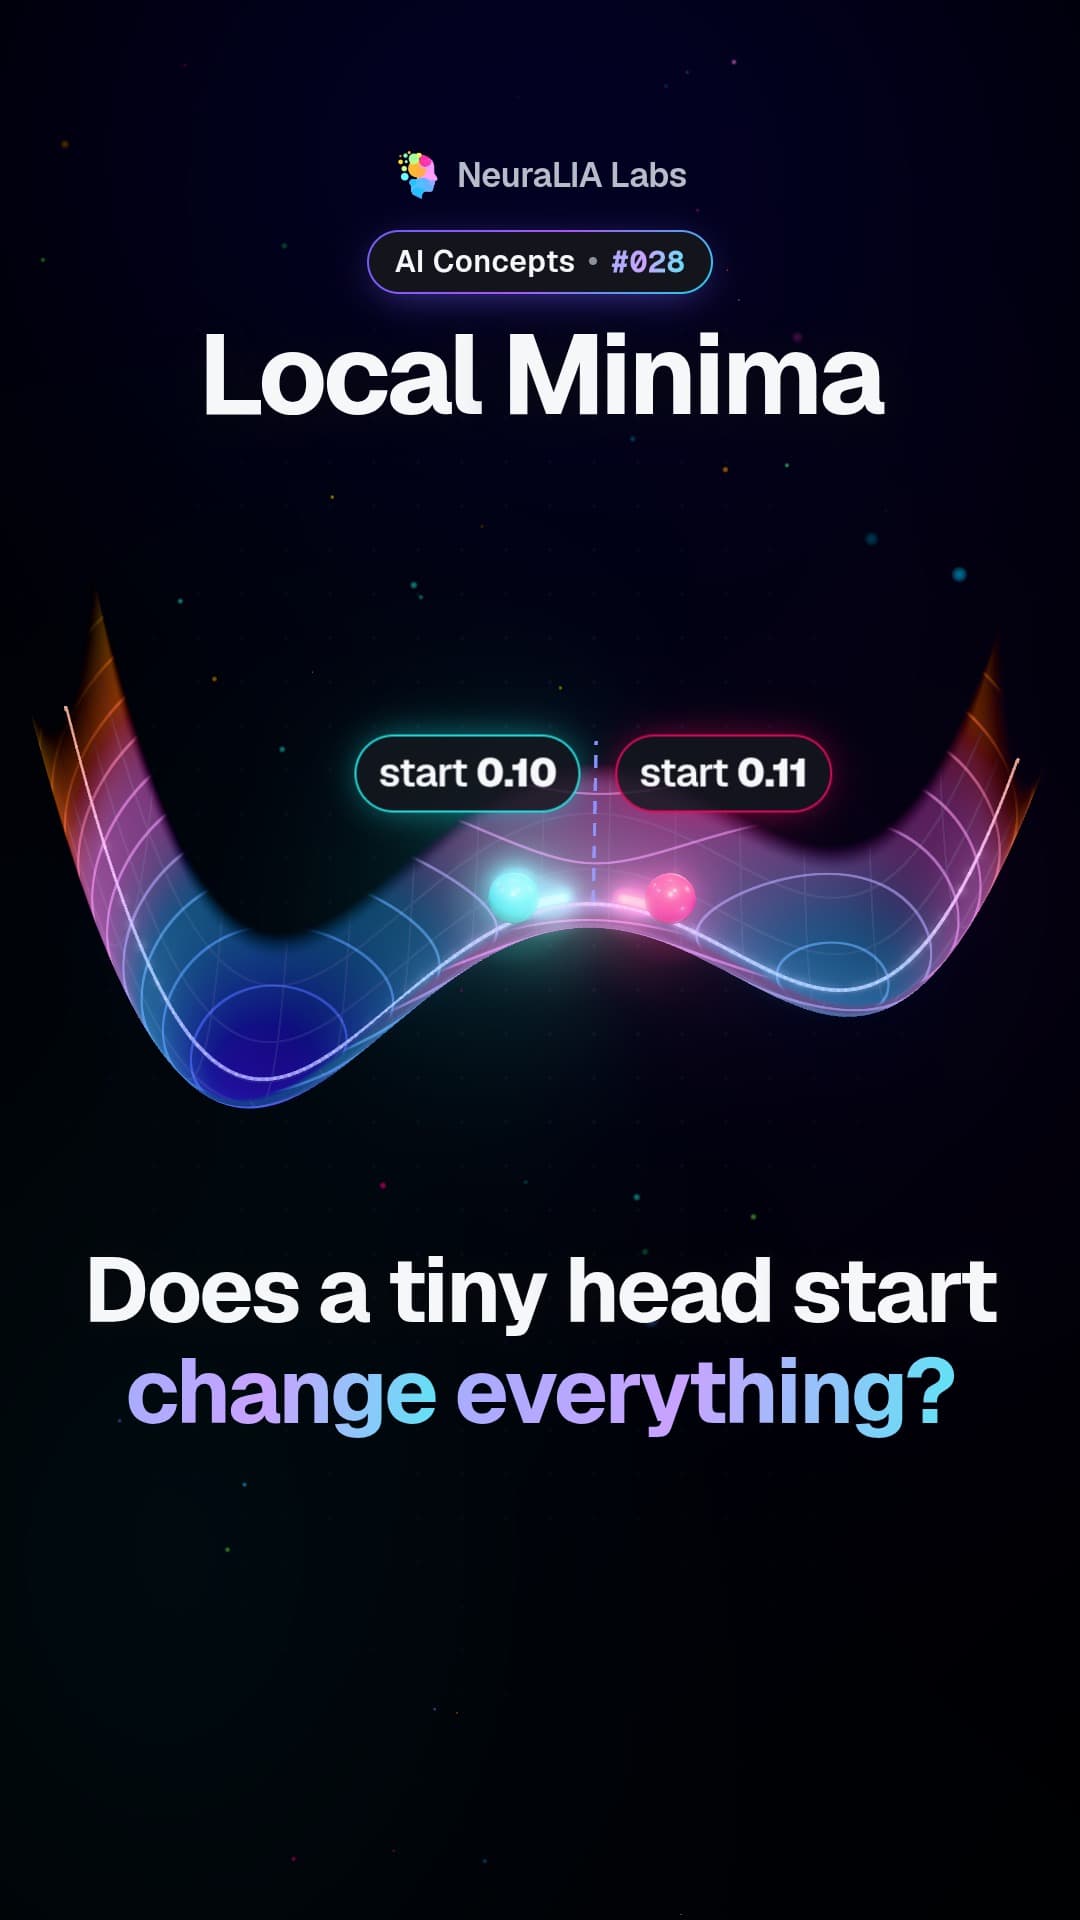
你可以在一条曲线上看到完整后果。取 ,它有两个深度不同的山谷:
   x =  -1.046681   f(x) =  -0.352386   minimum
   x =   0.101031   f(x) =   0.005026   maximum
x = 0.945649 f(x) = -0.152639 minimum落入浅谷会让损失差 56.7%,而算法无从得知,因为在山谷内部,每个方向都是上坡。Gradient Descent 没有对此的修复,也不会有。实践中存在的,是一个发现:它远没有这张图暗示的那么重要——在真实网络的极高维空间里,大多数临界点最终是鞍点而不是陷阱,2 Chapter 5 会测量一个小网络实际被卡住的频率。
更便宜的步子:随机、小批量、momentum
链接到此部分:更便宜的步子:随机、小批量、momentum上面的 grad 有一件事应该让你不舒服:它每一步都对整个数据集求和。八个零件不算什么。一百万个样本,就意味着要计算一百万个梯度,才能移动一次参数。
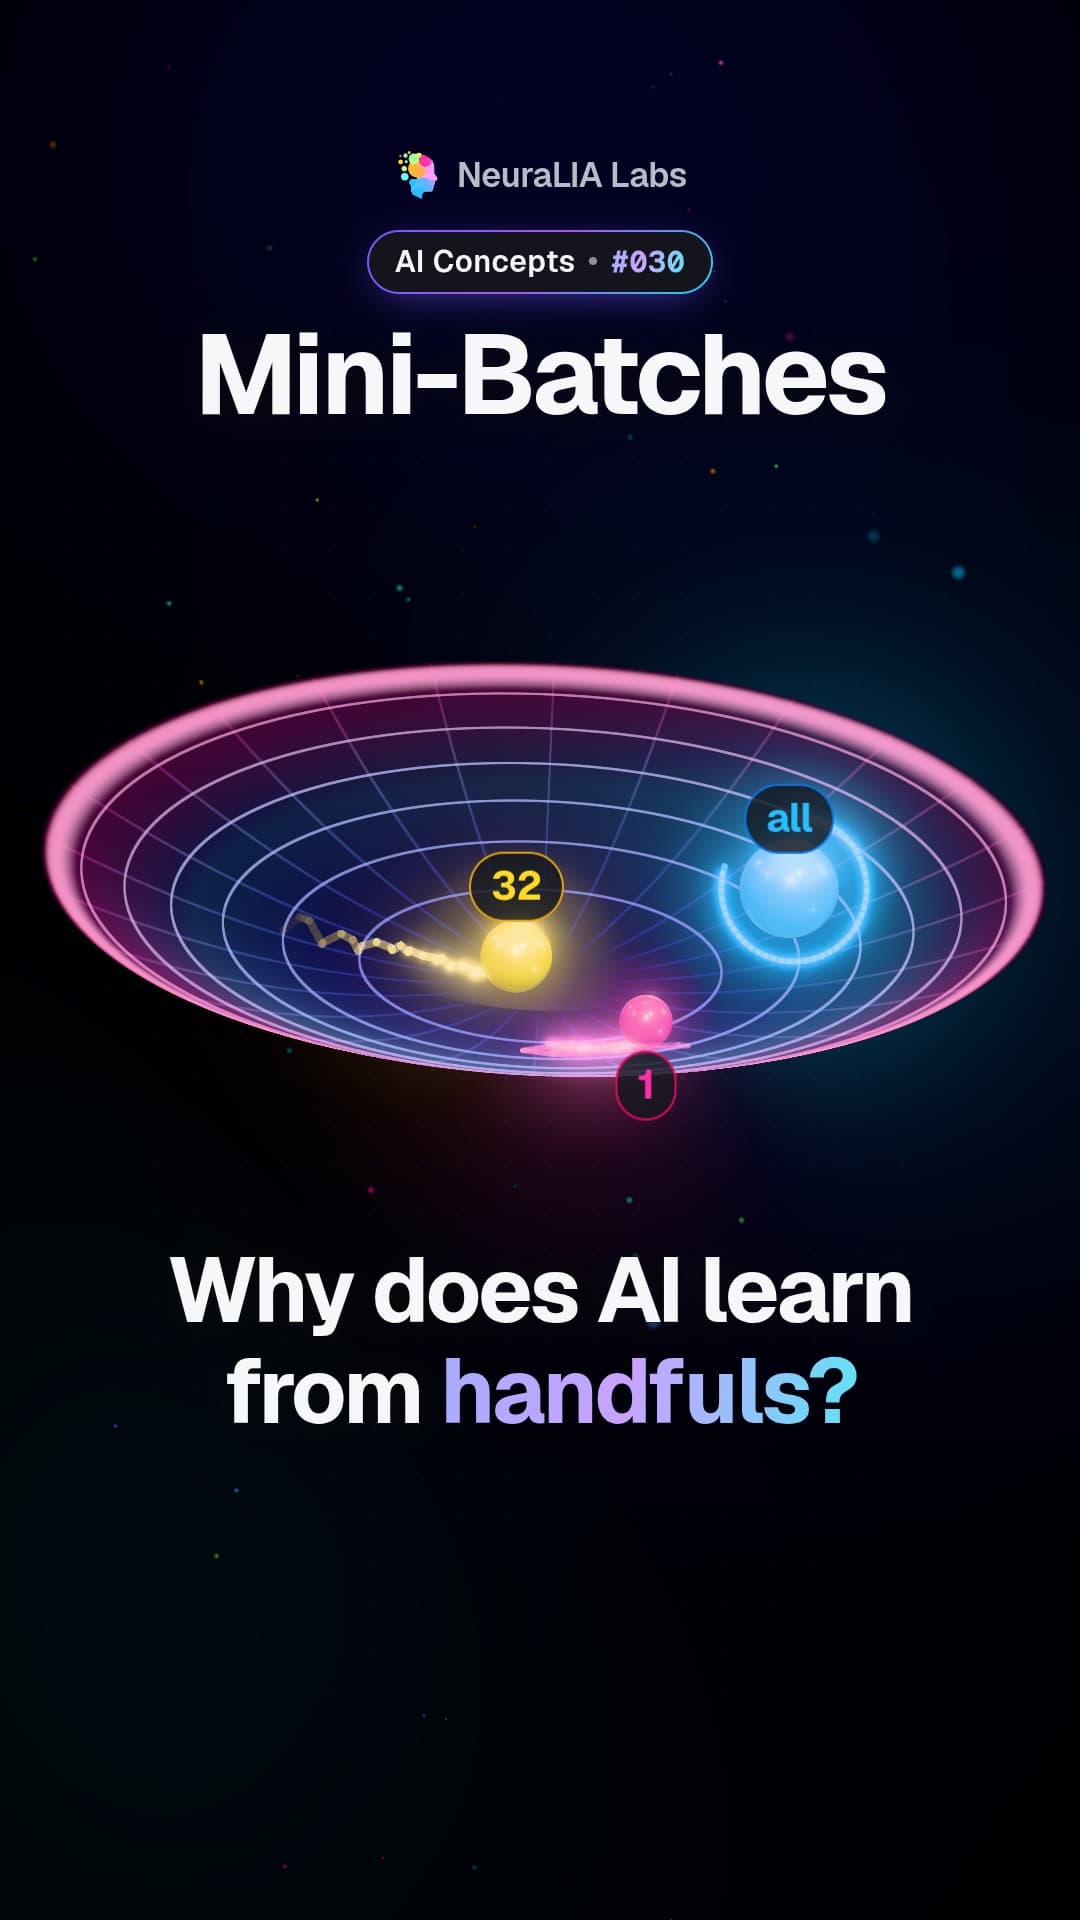
逃脱方式是:梯度是一个平均值,而平均值可以从样本中估计。在随机抽出的一小把样本——一个 minibatch——上计算它,然后据此迈步。估计是有噪声的;它也是无偏的,而数百个便宜的带噪步骤胜过一个昂贵的精确步骤。在十万个合成零件上,如果统计的是每个样本的梯度而不是步骤数:
| 方法 | 达到距离最优值 0.1% 以内所需步数 | 每样本梯度数 |
|---|---|---|
| full batch | 7 | 700,000 |
| minibatch of 32 | 100 | 3,200 |
| one example at a time | 17,580 | 17,580 |
到达同一位置所需算术少了二百一十九倍。而极端情况——一次一个样本,也就是 Robbins 和 Monro3 最初的随机近似——并不是赢家:它比 32 个样本的 batch 差五倍,因为在会做矩阵乘法的硬件上,32 个样本几乎不比 1 个样本更贵,而噪声会随 batch size 的平方根下降。这个取舍就是为什么你以后读到的每个训练脚本里都会有一个 batch_size。
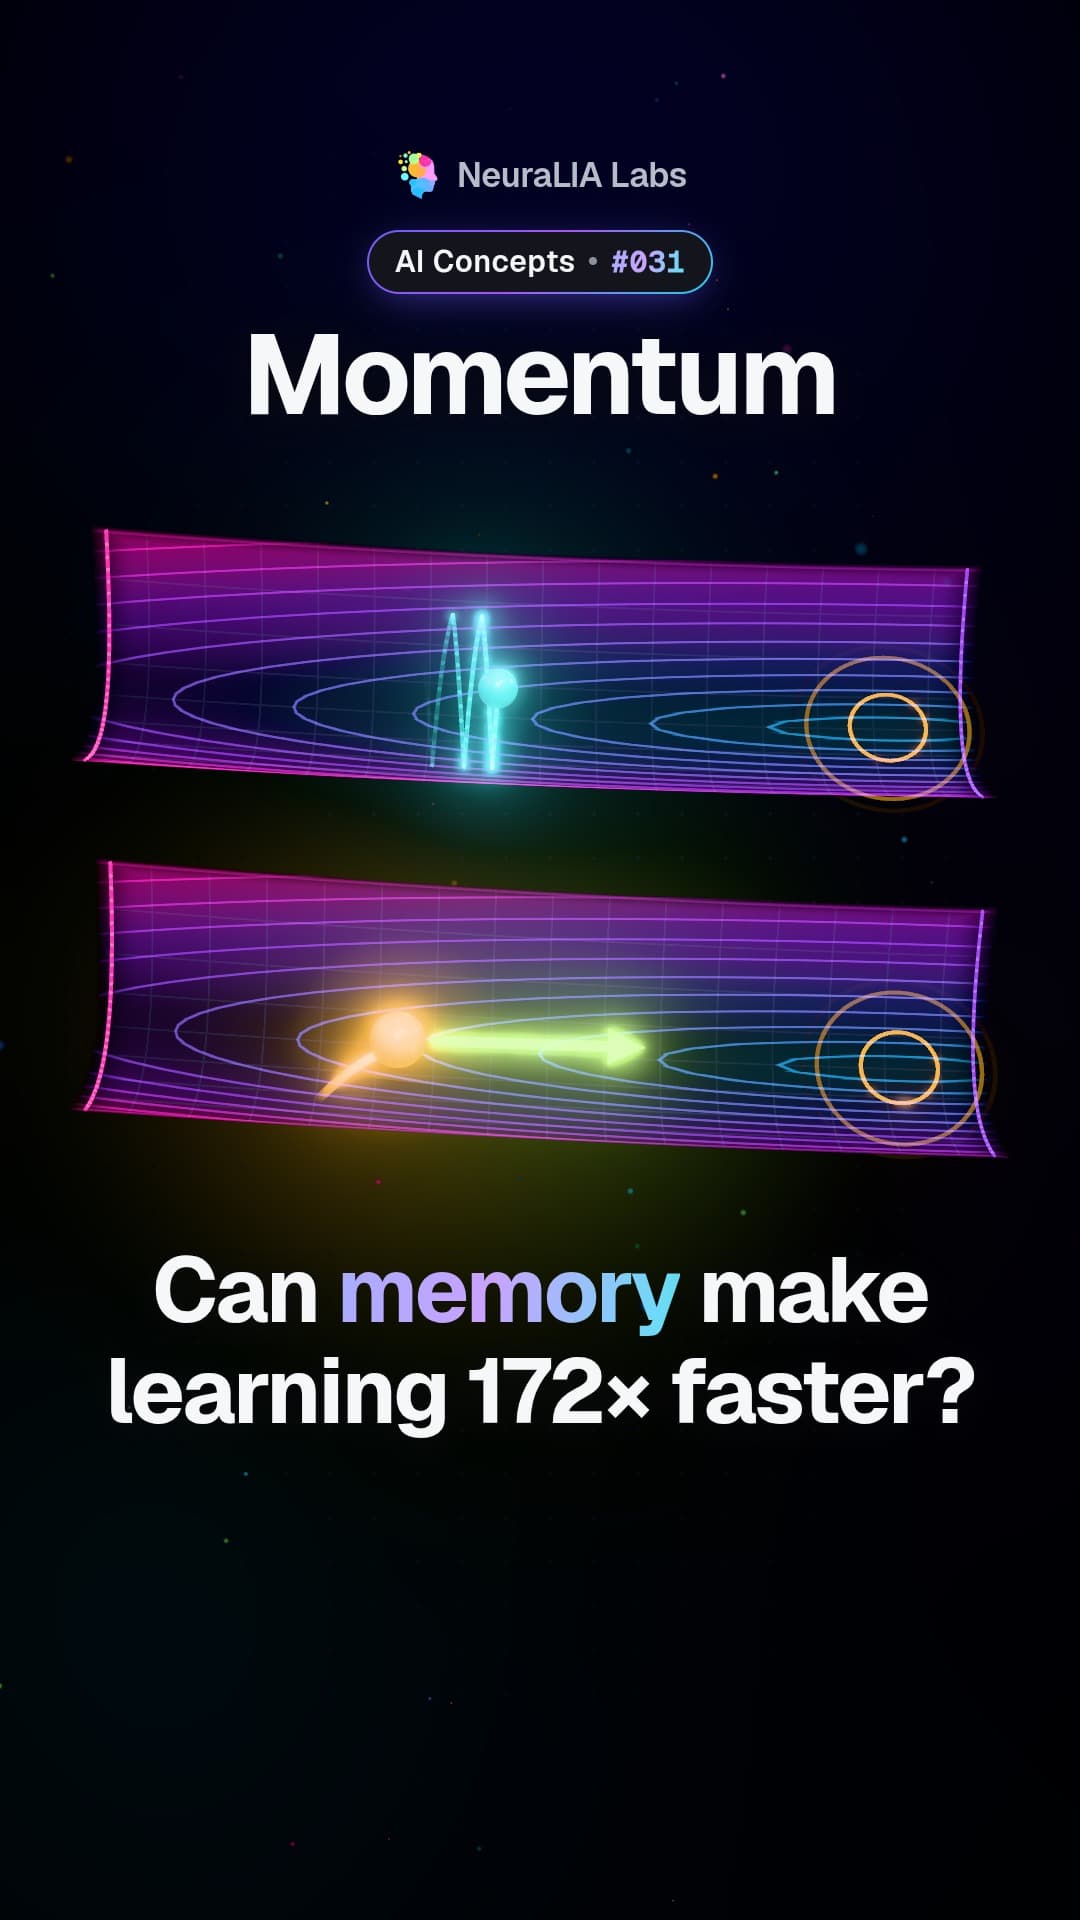
Momentum 是另一个便宜修复,它正对着那条沟。在条件很差的山谷里,步子会在狭窄方向上来回之字形振荡,同时沿长方向缓慢爬行。Momentum 会保留过去梯度的运行平均,让振荡分量相互抵消,而一致分量累积起来:4
多两行。在原始未居中的传送带上——条件数 33,452,是我们遇到的最坏情况——使用普通下降法能承受的最佳学习率:
momentum beta=0.0   ->    79,513 steps to 1%
momentum beta=0.9   ->     1,609 steps to 1%
momentum beta=0.99  ->       461 steps to 1%
两行代码带来 172 倍提升。Chapter 6 会把它变成 Adam;机制已经在这里了。
Chapter 5 里你会需要的检查
链接到此部分:Chapter 5 里你会需要的检查本章中的每个梯度都是手工推导的,因此都可能是错的。修复方法就是开头的斜率表:用数值方法测量导数并比较。使用中心差分,,它会抵消主要误差项,并且在相同 下准确得多。
def numeric_grad(f, theta, h=1e-5):
    theta = np.asarray(theta, dtype=float)
    out = np.zeros_like(theta)
    for i in range(theta.size):
        bump = np.zeros_like(theta)
        bump[i] = h
        out[i] = (f(theta + bump) - f(theta - bump)) / (2 * h)
    return out


def gradcheck(f, df, theta, h=1e-5):
    analytic = np.asarray(df(theta), dtype=float)
    numeric = numeric_grad(f, theta, h)
    return np.max(np.abs(analytic - numeric) / np.maximum(1e-8, np.abs(analytic) + np.abs(numeric)))
比较的相对形式很重要: 的绝对差,对大小为 的梯度是灾难,对大小为 的梯度却无关紧要。
relative error: 1.8929136036763527e-11
with 2 dropped: 0.33333333331650744
第一行是上面手工推导的梯度。第二行是同一个函数,但某个分量漏掉了因子 2——一个单字符 typo——检查会立刻抓住它。低于大约 就是一致;高于 就是 bug。保留这个函数:Chapter 5 会用它调试一个自动微分引擎,而它也是让错误梯度能被找到的唯一原因。
接下来去哪里
链接到此部分:接下来去哪里本章中的一切都建立在一个从未明说的假设上:你能把 写下来。
对于两个参数的一条直线,那只是一行代数。它几乎立刻就不再是一行。让符号代数系统求一个网络的损失对单个第一层权重、在单个样本上的导数,然后数一数答案里的算术量:
| 网络 | 一个偏导数中的运算数 |
|---|---|
| 四个 hidden units,一层 | 40 |
| 四个 hidden units,两层 | 301 |
| 四个 hidden units,三层 | 1,717 |
第三行是一个有 57 个参数的网络——小到在 Chapter 6 里只能算脚注——而手写它在一个训练样本上的梯度,大约意味着 97,869 次运算。没有任何记号能拯救这一点。真正拯救它的是一个观察:应用在复合上的链式法则有巨大的结构,相同的中间量会反复出现,而按正确顺序计算它们,就能以大约一次前向传播的代价得到所有导数。这就是 Chapter 5。
但在那之前还有一个更小的问题,而且它马上就在等着。
我们现在有了一台机器,可以在任何可微损失上向下滚。把它指向传送带最初的问题——接受还是拒绝,目标是 1 或 0——在输出上放一个 sigmoid,让它预测概率,并最小化平方误差。它会运行。但当它错得最厉害时,它几乎不会移动,而梯度说明了原因:
| 输出 | 预测 | 真值 | 平方误差下的梯度 | cross-entropy 下的梯度 |
|---|---|---|---|---|
| 0.5000 | 1 | |||
| 0.1192 | 1 | |||
| 0.0025 | 1 | |||
| 1 |
一个自信而灾难性地错误的模型——在答案为 1 时预测 0.0000454——产生的平方误差梯度是 。它完全不知道自己有麻烦。另一列来自一个我们还没有推导的损失,报告的是 1.0:最大紧迫性,且正好出现在应得的位置。
这就引出了下一章开头的问题。上一章说,损失是关于噪声的假设,而平方误差假设的是 Gaussian noise。一个是或否的答案拥有什么噪声模型——当你对它做同样的推导时,会得到什么损失?
来源与方法
链接到此部分:来源与方法这个方法比这些文献都更古老:Cauchy 在 1847 年给 Académie des Sciences 的一则笔记中描述了它,作为一种通过沿平方残差之和下坡行走来求解方程组的方法。也值得和本章一起阅读的有:Sebastian Ruder 的 An overview of gradient descent optimization algorithms(arXiv:1609.04747),它用十四页易读文字覆盖了从 momentum 到 Adam;Nocedal 和 Wright 的 Numerical Optimization(第 2 版,Springer, 2006)第 3 章,其中定理 3.3 用条件数给出了二次函数上最陡下降的收敛率——这就是为什么条件决定步数的理论背景,虽然它处理的是 line search,而不是上面测量的固定步长 上限;或者 Deisenroth, Faisal 和 Ong 的 Mathematics for Machine Learning §5.8 和 §7.1,用更少的工具讲同一片领域;Prince 的 Understanding Deep Learning §6.1 和 Goodfellow, Bengio 与 Courville 的 Deep Learning §4.3;Dive into Deep Learning §12.1–12.3,其中的 minibatch 分析有比这里篇幅允许更多的测量;以及 Géron 的 Hands-On Machine Learning(第 3 版)第 4 章,它最实用地把学习率当作需要调的东西,而不是要推导的东西。MIT 6.390 notes 把 Gradient Descent 放在分类之前,和本课程一样,理由也相同。
参考资料
链接到此部分:参考资料-
LeCun, Y., Bottou, L., Orr, G. B. and Müller, K.-R. Efficient BackProp, in Neural Networks: Tricks of the Trade (Springer, 1998), pp. 9–50. 第 4.3 节给出了建议,第 5.1 节给出了上面细节框所用的论证:对输入进行居中和缩放会改变二阶导数矩阵的特征值,因此改变步骤数,而不仅仅是数值上的舒适度。 ↩
-
Dauphin, Y. N., Pascanu, R., Gulcehre, C., Cho, K., Ganguli, S. and Bengio, Y. Identifying and attacking the saddle point problem in high-dimensional non-convex optimization, arXiv:1406.2572 (2014). 其论点是,在高维中,临界点压倒性地更可能是鞍点而不是局部最小值,因为一个最小值要求成千上万个方向中的每一个都同时向上弯曲。 ↩
-
Robbins, H. and Monro, S. A Stochastic Approximation Method. Annals of Mathematical Statistics 22(3), pp. 400–407 (1951). 这篇论文确立了这样一个事实:只要步长以正确方式缩小,一个带噪的梯度估计就足够。 ↩
-
Polyak, B. T. Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics 4(5), pp. 1–17 (1964). 重球法,也就是上面的 momentum 更新,比 backpropagation 进入这个领域早了二十二年。 ↩
本章视频
用通俗语言讲解本章概念的短视频。
 #04
How AI learns: guess, measure the error, nudge, repeat
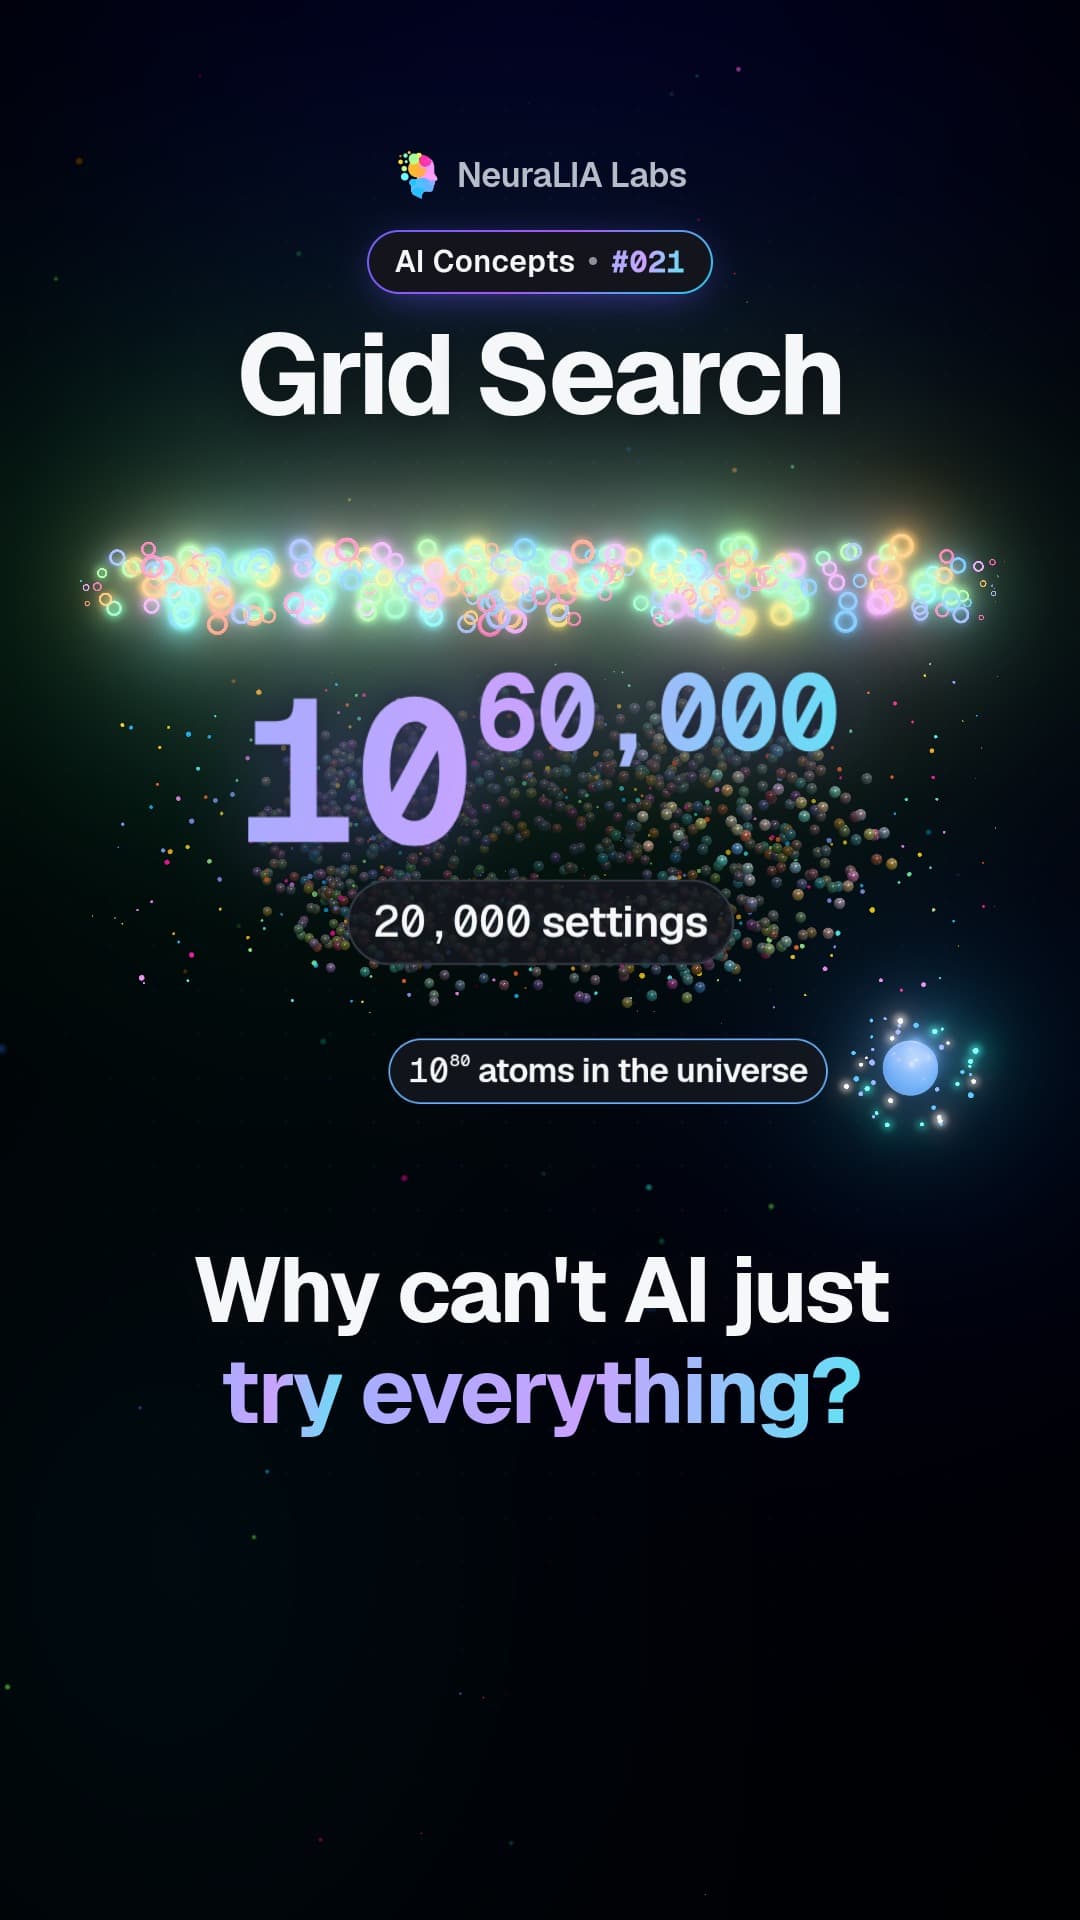 #021
Grid search: why you cannot train an AI by trying every setting
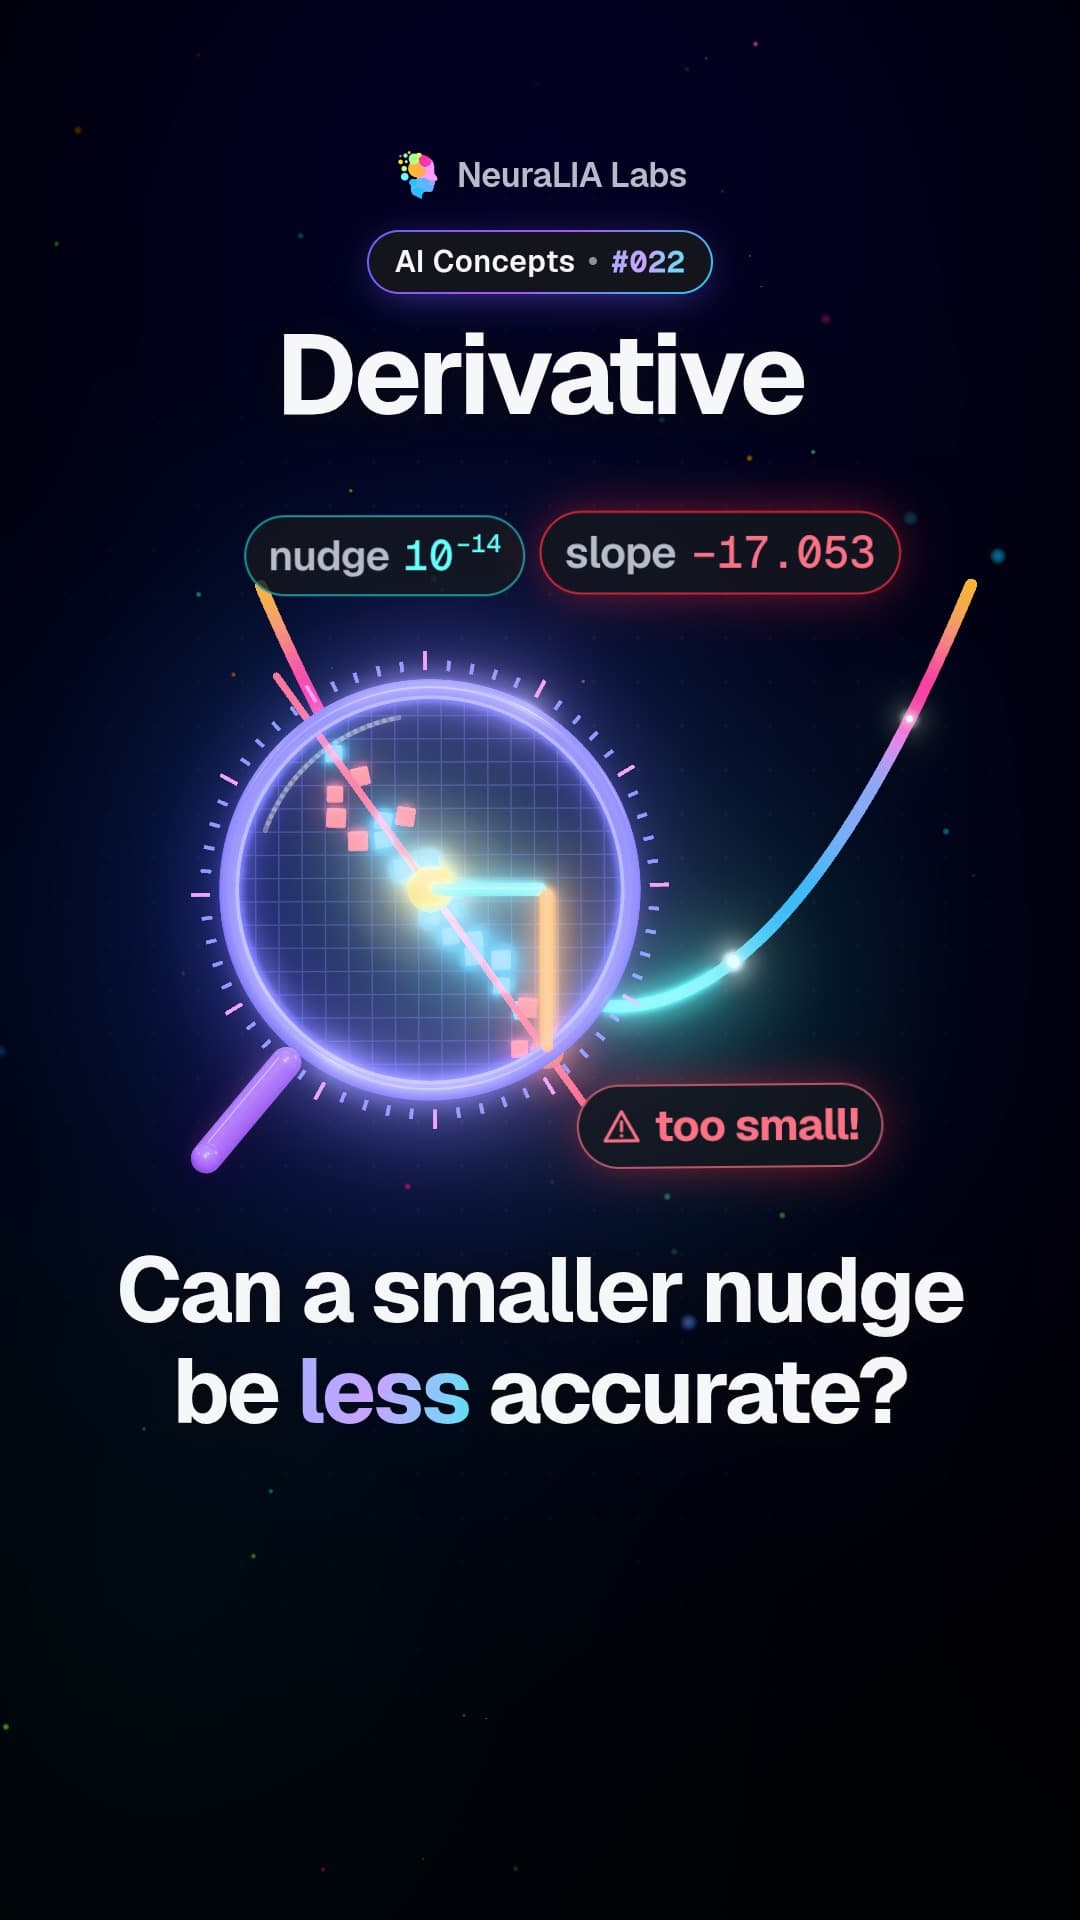 #022
Derivative: how much the result moves when you nudge one input
 #023
Chain rule: how AI traces the effect of every layer
 #024
Gradient: the arrow that points uphill, and why AI walks the other way
 #025
Gradient descent: how AI finds its way downhill in small steps
 #026
Learning rate: the step size with a ceiling you can calculate
 #027
Condition number: why a stretched valley makes AI training crawl
 #028
Local minima: why AI training can settle for second best
 #029
Saddle points: where AI training looks stuck but has a way down
 #030
Mini-batches: why AI learns faster from a random handful of data
 #031
Momentum: how remembering past steps stops AI training zigzagging
 #032
Gradient checking: catching the silent bug in AI training math