
Facer que adestre e facer que xeneralice
Unha rede de seis capas coa perda fixa en ln 2, arranxada medición a medición. Logo double descent: 5.000 parámetros en 40 puntos.
Nesta páxina
A rede do capítulo 5 funciona. Ten nove parámetros, aprende XOR e os seus gradientes coinciden cos de PyTorch ata dezaseis decimais.
Faina de seis capas de profundidade e deixa de aprender por completo. Non aos poucos: por completo. Aquí tes unha rede de seis capas nun problema de clasificación de dúas espirais, adestrada durante 5000 pasos:
step    1: loss 0.693147
step 5000: loss 0.693147
accuracy: 50.0 %
Ese número non é arbitrario. é a entropía cruzada binaria dun modelo que devolve probabilidade para todo, e 50 % é lanzar unha moeda nun conxunto de datos equilibrado. Despois de cinco mil pasos, a rede non moveu nin unha soa cifra. Nada fallou, nada avisou, e os gradientes seguen sendo exactamente correctos.
Este capítulo trata da fenda entre unha rede que se executa e unha rede que funciona. Ten dúas metades que parecen temas distintos e son o mesmo traballo: conseguir que a perda baixe, e conseguir que baixe en datos que o modelo nunca viu.
Por que a rede de seis capas está morta
Ligazón á sección: Por que a rede de seis capas está mortaComeza mirando, non adiviñando. Pasa un batch de entradas pola rede e imprime a desviación estándar das activacións en cada capa, e logo a desviación estándar dos gradientes dos pesos:
def profile(model, x):
    h = x
    for layer in model:
        h = layer(h)
        if isinstance(layer, (nn.Tanh, nn.ReLU)):
            print(f"activation std: {h.std().item():.4f}")
    model(x).sum().backward()
    for p in model.parameters():
        if p.dim() == 2:
            print(f"gradient std: {p.grad.std().item():.2e}")
Tres inicializacións, mesma arquitectura, seis capas de :
| inicialización | desviación estándar da activación, capas 1→6 |
|---|---|
| normal, std | 0.0145 · 0.0016 · 0.0002 · 0.0000 · 0.0000 · 0.0000 |
| normal, std | 0.6573 · 0.9296 · 0.9585 · 0.9634 · 0.9637 · 0.9625 |
| Xavier | 0.1579 · 0.1493 · 0.1353 · 0.1333 · 0.1325 · 0.1403 |
| inicialización | desviación estándar do gradiente, primeira capa → última |
|---|---|
| normal, std | 3.20e-06 · 4.97e-07 · … · 6.40e-06 |
| normal, std | 1.94e+03 · 2.28e+02 · 1.22e+02 · 4.43e+01 · 1.85e+01 · 7.30e+00 |
| Xavier | 2.31e+00 · 4.50e-01 · 4.26e-01 · 3.89e-01 · 4.39e-01 · 4.73e-01 |
A primeira fila é a rede de arriba, e non está aprendendo lentamente: xa non lle queda sinal. Na capa catro, a desviación estándar da activación xa subdesbordou ata cero con catro decimais. Cada entrada produce a mesma saída, a saída é unha constante, e o gradiente dunha constante non é nada. Os pesos inicializáronse pequenos «por seguridade», e pequeno foi fatal.
A segunda fila é o fallo contrario e paga a pena entendelo porque é contraintuitivo. As activacións parecen sas — arredor de 0.96 — pero iso é saturado, fixado preto do seu límite, exactamente o réxime que no capítulo 5 medimos como unha perda dun factor de case dez mil no gradiente. E, con todo, os gradientes son enormes: 1940 na primeira capa. Ambas cousas son certas á vez. Cada paso cara atrás multiplica por , e con 128 entradas con varianza unitaria ese factor ten unha ganancia duns , que asolaga a contracción do saturado. Os gradientes medran xeometricamente ao volver cara atrás. Este é o gradiente explosivo, e produce valores de perda de nan en poucos pasos en calquera adestramento real.
A terceira fila é o que queres: activacións aproximadamente constantes en escala a través da profundidade, gradientes aproximadamente constantes en escala a través da profundidade. Nada morre, nada explota.
Normalización, e cal sobreviviu
Ligazón á sección: Normalización, e cal sobreviviuInicializar ben arranxa a escala no paso cero. Non a mantén fixa: os pesos móvense, e no paso cinco mil o coidadoso argumento da varianza xa non se aplica.
As capas de normalización impoñen a escala de forma continua. Dado un vector de activacións, réstalle unha media, divídeo por unha desviación estándar e logo aplica unha escala aprendida e un desprazamento para que a capa poida desfacer a normalización se resulta que iso é o que quere:
A única pregunta real é sobre que fas a media. Batch normalisation3 toma e ao longo da dimensión do batch, unha estatística por feature. Layer normalisation4 tómaas ao longo das features, unha estatística por exemplo.
Esa escolla parece pequena e decide case todo o que vén despois:
BatchNorm fai que a saída de cada exemplo dependa dos outros exemplos que cadraron no seu batch. Durante o adestramento iso é un regularizador suave. En inferencia non hai batch, así que ten que manter unha media móbil das estatísticas recollidas durante o adestramento, o que significa que a capa se comporta de xeito distinto en modo de adestramento e en modo de avaliación, e esquecer cambiar de modo é un dos bugs máis comúns no campo. Tamén se degrada con batches pequenos, e é incómoda con secuencias de lonxitude variable, porque «a media do batch na posición 40» calcúlase a partir de cantas secuencias resulten ser tan longas.
LayerNorm normaliza cada exemplo por si mesmo. Sen dependencia do batch, sen estatísticas móbiles, comportamento idéntico en adestramento e inferencia, indiferente ao tamaño do batch, indiferente á lonxitude da secuencia. Cada unha desas propiedades é un requisito máis ca unha comodidade cando estás xerando un token de cada vez para unha persoa usuaria, que é onde acaba o capítulo 13.
Por iso LayerNorm é a que volverás atopar no capítulo 9 sen cambios: o bloque transformer úsaa, e úsaa polos motivos da columna dereita, non porque funcione mellor en abstracto.
Arranxar unha cousa de cada vez, que é a verdadeira skill
Ligazón á sección: Arranxar unha cousa de cada vez, que é a verdadeira skillCatro posibles arranxos para a rede morta: inicialización Xavier, LayerNorm, conexións residuais e Adam en vez de SGD. A tentación é aplicar os catro e seguir. Fai iso e nunca saberás cal importou, e a próxima vez que pase non terás método: só un ritual.
Así que aplícaos un a un. Mesma semente, mesmos datos, mesma arquitectura, 800 pasos:
| que se engadiu | perda final | precisión |
|---|---|---|
| nada | 0.6931 | 50.0 % |
| inicialización Xavier | 0.5692 | 60.4 % |
| LayerNorm | 0.6230 | 61.5 % |
| conexións residuais | 0.6651 | 56.6 % |
| Adam | 0.6787 | 58.7 % |
| os catro | 0.0000 | 100.0 % |
Le esa táboa como a lerías ás 2 da mañá e a conclusión é: nada funciona só, todo funciona xunto, polo tanto o deep learning é alquimia. Esa conclusión é incorrecta, e descubrir por que é o máis útil deste capítulo.
Dálle a cada execución seis veces máis orzamento — 5000 pasos en vez de 800 — e cambia por completo:
| que se engadiu | perda final @ 5000 | precisión |
|---|---|---|
| nada | 0.6931 | 50.0 % |
| inicialización Xavier | 0.0007 | 100.0 % |
| LayerNorm | 0.0002 | 100.0 % |
| conexións residuais | 0.6653 | 56.7 % |
| Adam | 0.6908 | 53.4 % |
| Xavier + Adam | 0.0000 | 100.0 % |
| Xavier + LayerNorm | 0.0001 | 100.0 % |
Agora a imaxe é nítida, e é un diagnóstico máis ca un ritual.
A inicialización soa arránxao. A normalización soa arránxao. Cada unha aborda a enfermidade real — o sinal cara adiante que colapsa a cero — e calquera das dúas é suficiente. Aos 800 pasos só parecían crédito parcial, porque xa resolveran o problema e aínda estaban saíndo do burato.
As conexións residuais e Adam non o arranxan, con ningún orzamento. Non porque sexan malas, senón porque tratan outra enfermidade. Unha conexión residual dálle ao gradiente un camiño arredor dunha capa bloqueante; iso vale moitísimo cando o problema é o gradiente, e non vale nada cando o sinal cara adiante xa é cero, porque un atallo arredor dunha capa morta segue transportando un valor morto. Adam reescala o paso de cada parámetro segundo o seu propio historial de gradientes; iso axuda cando os gradientes teñen magnitudes moi distintas, e non pode resucitar unha rede cuxa saída non depende da súa entrada.
E «nada» segue exactamente en 0.6931 despois de cinco mil pasos. Non 0.6929. Non é lenta; está morta, e esa distinción vese dun xeito que antes non se vía, porque tes a fila que di que un arranxo funciona para comparala.
Gañarse PyTorch
Ligazón á sección: Gañarse PyTorchA partir de aquí este curso usa PyTorch. Iso debería gañarse, non anunciarse, así que aquí tes exactamente o que fai que xa sabes facer.
Un optimizador é unha regra para converter gradientes en actualizacións de parámetros. O gradient descent simple usa o gradiente. Momentum usa unha media móbil del, que suaviza o ruído e colle velocidade nas direccións que se manteñen consistentes:
v = beta * v + p.grad
p -= lr * v Adam5 mantén dúas medias móbiles — do gradiente e do gradiente ao cadrado — e divide unha pola raíz cadrada da outra, de modo que cada parámetro recibe un paso escalado á súa propia magnitude recente de gradiente:
m = b1 * m + (1 - b1) * g          # mean of the gradient
v = b2 * v + (1 - b2) * g * g      # mean of the squared gradient
m_hat = m / (1 - b1 ** t)          # bias correction: both averages start at zero
v_hat = v / (1 - b2 ** t)
p -= lr * m_hat / (v_hat.sqrt() + eps)
Dez liñas. Executa ambos contra torch.optim no mesmo problema durante 50 pasos:
SGD+momentum   by hand [2.7781870365142822, -1.0304985046386719]
               torch   [2.7781870365142822, -1.0304983854293823]   max |diff| = 1.19e-07
Adam           by hand [0.4893140196800232, -0.46317872405052185]
               torch   [0.48931416869163513, -0.46317875385284424]   max |diff| = 1.49e-07
Idénticos ata a precisión de float32. torch.optim.Adam son esas cinco liñas, máis décadas de coidado cos casos límite e un kernel en C++. Ese é o intercambio que fas a partir de aquí: non maxia por comprensión, senón velocidade por liñas que xa escribiches.
Por que existe Adam: curvatura
Ligazón á sección: Por que existe Adam: curvaturaA explicación habitual de Adam é «learning rates adaptativos por parámetro», que é unha descrición máis ca unha razón. A razón é a xeometría, e pódese medir.
Toma unha perda cuxa curvatura difire entre direccións: empinada nunha, suave noutra. SGD ten un único learning rate global, así que debe escoller un valor o bastante pequeno para ser estable na dirección máis empinada, e ese valor é entón demasiado pequeno para a suave, onde o progreso vai a paso de caracol. Isto é o que causa a imaxe clásica do gradient descent facendo zigzag por un val estreito.
Dúas razóns de curvatura, tres optimizadores, 300 pasos, e a cada optimizador dáselle o mellor learning rate dun varrido para que ninguén teña desvantaxe:
| razón de curvatura | SGD | SGD + momentum | Adam |
|---|---|---|---|
| 10 : 1 | erro 0.000002 | erro 0.000000 | erro 0.000000 |
| 1000 : 1 | erro 1.925485 | erro 0.001432 | erro 0.000000 |
| diverxeu en (1000:1) | 4 de 8 taxas | 4 de 8 taxas | 0 de 6 taxas |
Cunha razón de dez, todo funciona e non hai nada que discutir. Con mil, SGD simple non pode chegar á resposta con ningún learning rate probado — o seu mellor resultado segue sendo un erro de 1.93 — e diverxe directamente coa metade das taxas. Adam aterra exactamente no obxectivo e non diverxe con ningunha.
Esa última columna é a razón práctica pola que Adam é o predeterminado. Non é que Adam atope solucións mellores; en problemas ben condicionados, SGD afinado adoita igualalo ou superalo. É que Adam é moito menos sensible ao learning rate que escolliches, e as redes reais teñen razóns de curvatura moito peores ca mil nos seus millóns de parámetros.
Aquí pertencen dúas pezas máis e ambas son dunha liña. Gradient clipping reescala o vector de gradiente sempre que a súa norma supera un limiar, o que converte a fila «a perda salta de súpeto a un valor enorme» da táboa de diagnóstico nun non-evento. E learning rate schedules: un warmup curto desde case cero durante os primeiros centos de pasos, porque as estimacións de varianza de Adam son lixo ata que viron algúns gradientes e un paso de tamaño completo tomado sobre lixo pode estragar unha inicialización; logo cosine decay cara a cero, porque rematar unha execución co mesmo tamaño de paso co que comezaches significa tremer arredor do mínimo en vez de asentarse nel.
A segunda metade: o modelo que encaixa perfectamente e non predí nada
Ligazón á sección: A segunda metade: o modelo que encaixa perfectamente e non predí nadaTodo ata agora trataba de facer que a perda baixase. Agora vén a metade máis difícil, porque que a perda baixe non é o obxectivo: é un proxy do obxectivo, e o proxy falla dun xeito concreto e famoso.
Doce puntos dunha función suave cun pouco de ruído. Axusta polinomios de grao crecente:
| grao | RMSE train | RMSE test |
|---|---|---|
| 1 | 0.764499 | 0.6985 |
| 3 | 0.252605 | 0.3031 |
| 5 | 0.164437 | 0.1568 |
| 9 | 0.088960 | 0.2347 |
| 11 | 0.000000 | 1.2094 |
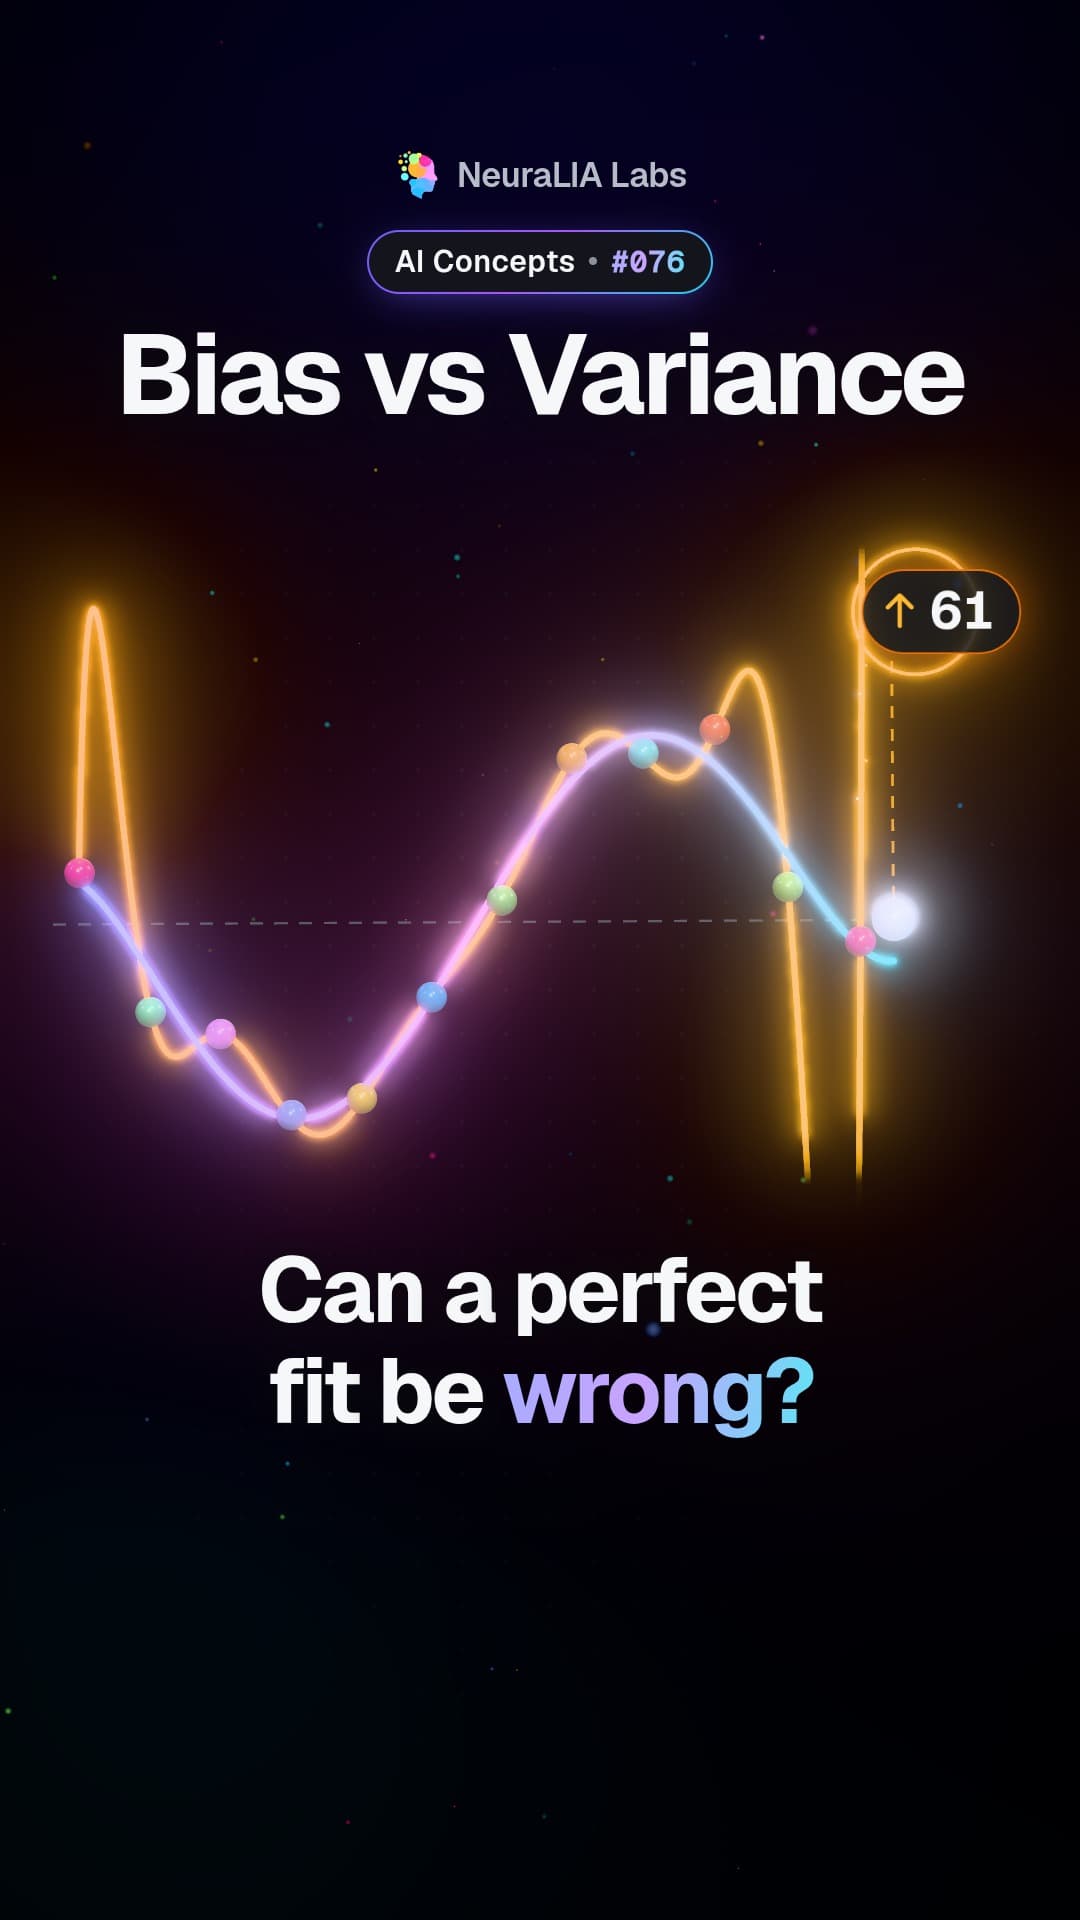
O grao 11 a través de 12 puntos pasa por cada un deles exactamente — erro de train cero ata seis decimais — e é oito veces peor ca o grao 5 en datos que non viu. Pídelles ao grao 3 e ao grao 11 que predigan en , xusto fóra do rango de adestramento:
degree  3: predicts   -1.053   (truth -0.012)
degree 11: predicts  +61.224   (truth -0.012)
Sesenta e un, cando a resposta é aproximadamente cero. O modelo non aprendeu a función; aprendeu os doce puntos, e entre eles fai o que a aritmética esixe.
Isto é overfitting, e o seu oposto — grao 1, que non pode representar a curva en absoluto e é malo en todas partes — é underfitting. A explicación clásica divide o erro esperado dun modelo en tres partes: bias, o erro de que o modelo sexa demasiado ríxido para representar a verdade; variance, o erro de que o modelo sexa tan flexible que persiga o ruído desta mostra concreta; e ruído irreducible, que nada arranxa. Os modelos simples teñen bias, os modelos flexibles teñen alta variance, e a prescrición clásica é atopar o punto doce no medio: grao 5 na táboa anterior.
As ferramentas estándar atacan todas o termo de variance:
- Regularización L2 (weight decay) engade á perda, tirando dos pesos cara a cero e facendo a función máis suave. Na táboa anterior, o coeficiente máis grande do grao 11 fai o dano; penalizar o tamaño desactívao.
- L1 engade no seu lugar. A diferenza non é cosmética: o gradiente de L2 é proporcional ao peso e por iso encolle a medida que o fai o peso, achegándose a cero sen chegar, mentres que o gradiente de L1 é unha constante que segue empurrando ata o final. Polo tanto, L1 produce pesos que son exactamente cero: selecciona features. L2 produce pesos pequenos. Usa L2 cando queiras suavidade, L1 cando queiras esparsidade.
- Dropout7 pon a cero un subconxunto aleatorio de activacións en cada paso de adestramento, así que ningunha unidade pode depender de que outra unidade concreta estea presente.
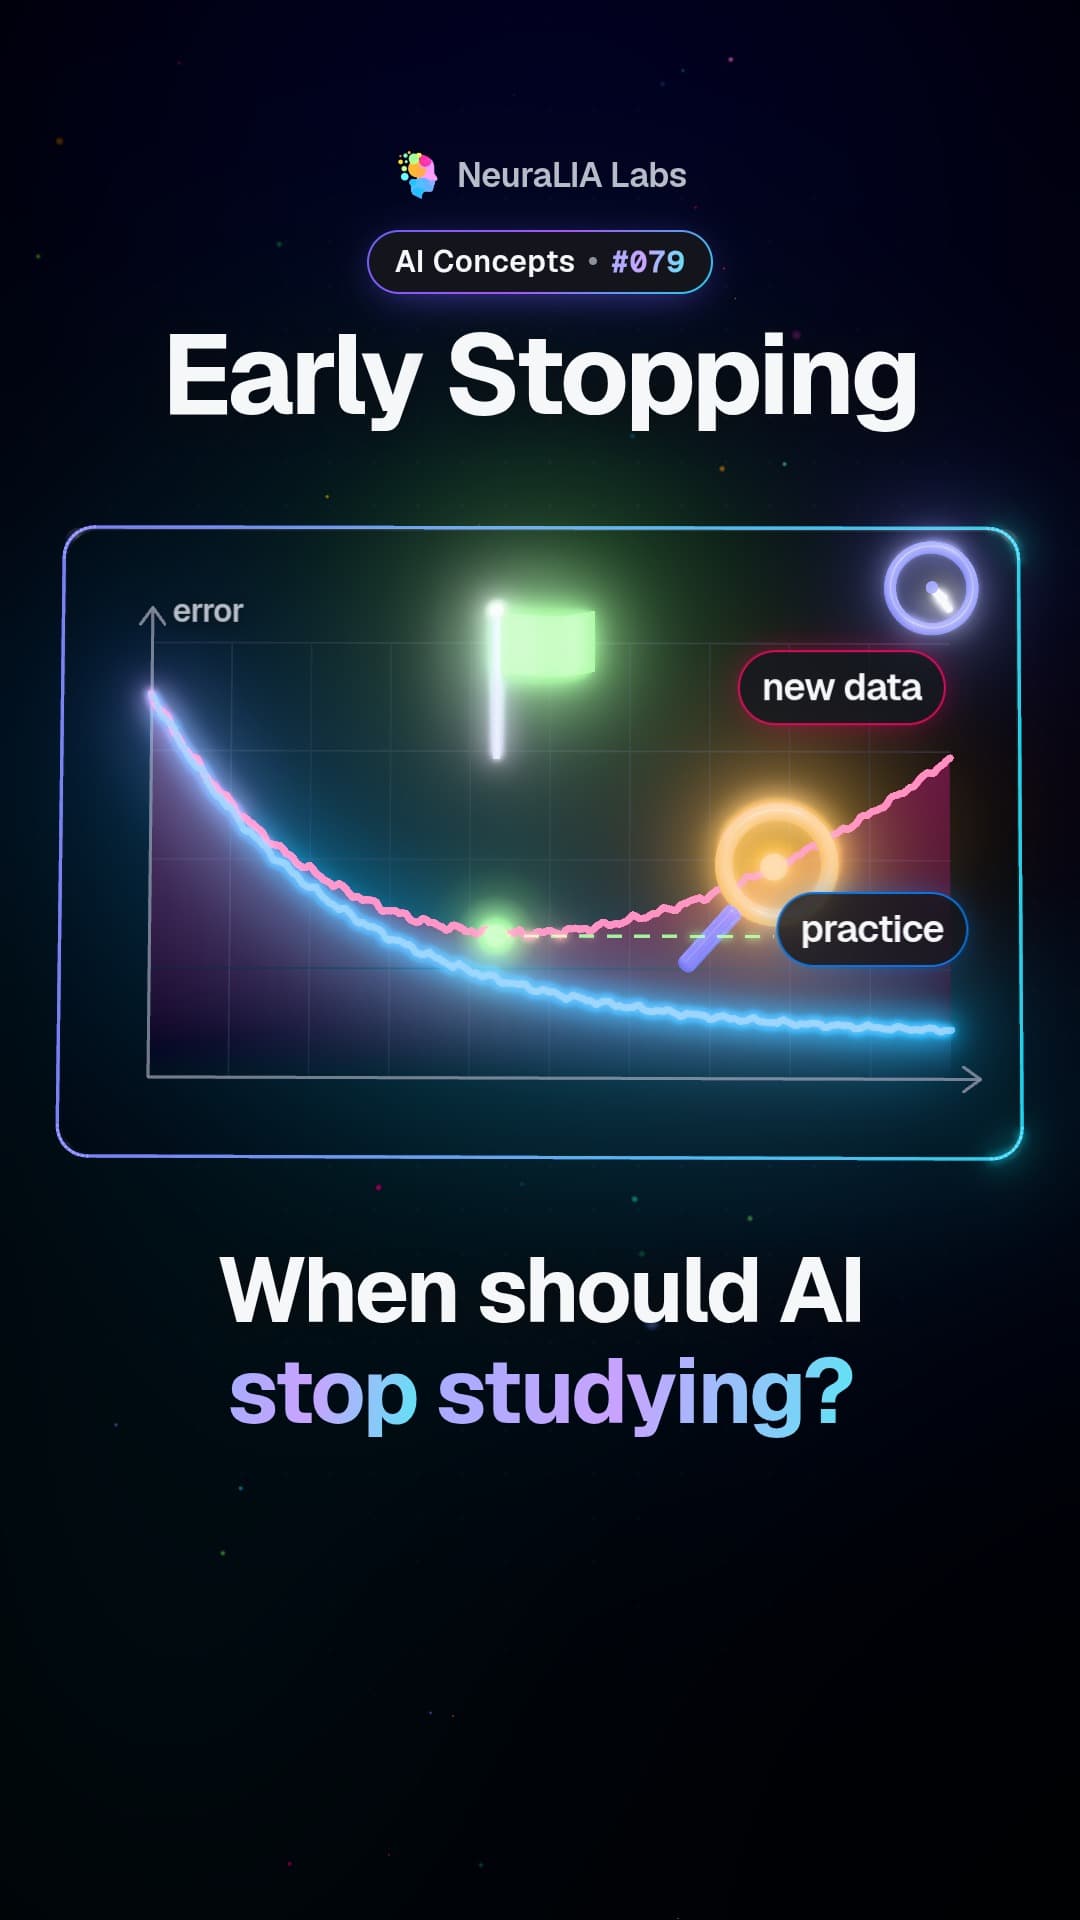
- Early stopping observa a perda de validación e para cando empeza a subir.
- Data augmentation fabrica máis exemplos de adestramento a partir dos que tes, o que ataca o problema na súa orixe: o overfitting é unha escaseza de datos tanto como un exceso de parámetros.
- Cross-validation divide os datos en partes e adestra veces, o que compra unha estimación fiable do erro de test cando tes poucos datos para reservar un conxunto separado.
Double descent, ou por que a sección anterior non é toda a historia
Ligazón á sección: Double descent, ou por que a sección anterior non é toda a historiaAgora o feito que rompe a imaxe.
A historia bias-variance di que, pasado o punto doce, máis parámetros significan peor xeneralización. Os modelos de linguaxe modernos teñen moitos máis parámetros dos que as regras clásicas permitirían para os datos que ven, e xeneralizan de marabilla. Ambas afirmacións son certas, e concilialas é o máis útil deste capítulo.
Corenta puntos de adestramento, entradas de vinte dimensións, features ReLU aleatorias, e o número de features varrido de 2 a 5000, coa solución de norma mínima escollida sempre que hai moitas que encaixan:
| RMSE train | RMSE test | |||
|---|---|---|---|---|
| 10 | 0.25 | 0.8822 | 1.2520 | 1.89 |
| 20 | 0.50 | 0.5962 | 1.1634 | 2.59 |
| 30 | 0.75 | 0.3896 | 1.5323 | 4.15 |
| 38 | 0.95 | 0.1769 | 3.7163 | 10.25 |
| 40 | 1.00 | 0.0000 | 5.8140 | 14.83 |
| 42 | 1.05 | 0.0000 | 3.1623 | 9.35 |
| 60 | 1.50 | 0.0000 | 1.1058 | 2.78 |
| 200 | 5.00 | 0.0000 | 0.6638 | 0.98 |
| 1500 | 37.50 | 0.0000 | 0.5859 | 0.33 |
| 5000 | 125.00 | 0.0000 | 0.5664 | 0.18 |
Léao en tres partes. Ata a historia clásica cúmprese exactamente: o erro cae, logo comeza a subir. En — o limiar de interpolación, onde o modelo ten exactamente parámetros dabondo para pasar por cada punto de adestramento — o erro de test acada o seu pico, en 5.81, cinco veces peor ca o modelo pequeno. Ese pico é a advertencia clásica, e é real.
Logo descende outra vez. E segue descendendo, pasado , pasado , ata , onde o erro de test de 0.5664 é mellor ca o mellor modelo infraparametrizado que se acadou nunca. Un modelo con 5000 parámetros axustado a 40 puntos é o mellor modelo da táboa.
Isto é double descent,89 e o mecanismo vese na última columna. Unha vez que hai infinitas configuracións de parámetros que encaixan exactamente cos datos de adestramento, e cal obteñas depende de como escollas. A solución de norma mínima escolle a máis pequena, e mostra o que iso significa: acada un pico de 14.83 xusto no limiar — onde hai exactamente unha solución interpolante e estás atrapado con ela, por extrema que sexa — e logo cae monotonamente a medida que medra, porque máis parámetros significan máis solucións interpolantes entre as que escoller, o que significa que a máis pequena dispoñible faise máis pequena. En a norma é 0.18, oitenta veces menor ca no limiar.
Así que os parámetros extra non engaden complexidade. Engaden escolla, e a regra de selección gasta esa escolla en simplicidade. A regularización non está na función de perda; está no algoritmo. Gradient descent desde unha inicialización pequena ten un sesgo documentado cara a solucións de norma pequena, que é por iso que este comportamento aparece en redes reais adestradas do xeito ordinario e non só na álxebra linear de arriba.
A consecuencia práctica, da que depende o capítulo 10: «o modelo ten máis parámetros ca datos, así que vai facer overfit» non é un argumento válido. Era unha boa regra cando os modelos vivían á esquerda do limiar. Agora todo o interesante vive moi á dereita del, onde a regra se inverte.
A onde vai isto despois
Ligazón á sección: A onde vai isto despoisAs ferramentas deste capítulo abondan para adestrar unha rede que funcione con datos que podes poñer nunha táboa: filas de números, unha columna de etiquetas.
A linguaxe non é iso. Antes de que un modelo poida predicir a seguinte palabra, algo ten que decidir que é sequera unha «palabra», e a resposta non son nin letras nin palabras, senón un vocabulario que o modelo aprende dos bytes crus dos datos de adestramento. Esa decisión, tomada unha vez antes de que comece o adestramento, determina cantas cousas pode dicir o modelo, canto custa unha solicitude, e por que modelos que poden aprobar un exame de dereito non poden contar de forma fiable as letras en strawberry.
O capítulo 7 constrúe un tokenizer.
Fontes e método
Ligazón á sección: Fontes e métodoPara as conexións residuais usadas arriba, He et al., Deep Residual Learning for Image Recognition (arXiv:1512.03385). Building makemore Part 3: Activations & Gradients, BatchNorm, de Andrej Karpathy, percorre o diagnóstico por histogramas de activación nun modelo real e é o mellor tratamento práctico da primeira metade deste capítulo. As leccións 8 e 11–13 de Learning From Data, de Yaser Abu-Mostafa, dan a teoría clásica da xeneralización como é debido, incluídas as partes que este capítulo comprimiu nun parágrafo.
Referencias
Ligazón á sección: Referencias-
Glorot, X. and Bengio, Y. Understanding the difficulty of training deep feedforward neural networks. AISTATS (2010). O argumento de preservación da varianza reproducido na caixa anterior. ↩
-
He, K., Zhang, X., Ren, S. and Sun, J. Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification. arXiv:1502.01852 (2015). ↩
-
Ioffe, S. and Szegedy, C. Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift. arXiv:1502.03167 (2015). Ten en conta que a explicación de «internal covariate shift» no título foi desde entón moi cuestionada; a capa funciona, pero a explicación orixinal de por que funciona está disputada. ↩
-
Ba, J. L., Kiros, J. R. and Hinton, G. E. Layer Normalization. arXiv:1607.06450 (2016). ↩
-
Kingma, D. P. and Ba, J. Adam: A Method for Stochastic Optimization. arXiv:1412.6980 (2014). ↩
-
Loshchilov, I. and Hutter, F. Decoupled Weight Decay Regularization. arXiv:1711.05101 (2017). ↩
-
Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I. and Salakhutdinov, R. Dropout: A Simple Way to Prevent Neural Networks from Overfitting. JMLR 15, pp. 1929–1958 (2014). ↩
-
Belkin, M., Hsu, D., Ma, S. and Mandal, S. Reconciling modern machine-learning practice and the classical bias–variance trade-off. PNAS 116(32), pp. 15849–15854 (2019). O artigo que lle deu nome ao fenómeno. ↩
-
Nakkiran, P., Kaplun, G., Bansal, Y., Yang, T., Barak, B. and Sutskever, I. Deep Double Descent: Where Bigger Models and More Data Hurt. arXiv:1912.02292 (2019). Mostra o efecto en redes profundas reais, e tamén ao longo do eixo do tempo de adestramento, ademais do eixo do tamaño do modelo. ↩
Este capítulo en vídeo
Vídeos breves que explican ideas deste capítulo con linguaxe clara.
 #065
Exploding gradients: why AI training can suddenly blow up
 #066
Weight initialization: the starting numbers that decide if AI learns
 #067
Batch normalization: the AI layer that grades on a curve
 #068
Layer normalization: why chatbots steady each input on its own
 #069
Ablation: change one thing at a time to find what really works
 #070
Loss curves: what the shape of a training line tells you
 #071
Adam: the optimizer that gives every direction its own stride
 #072
AdamW: the fix for a weight decay bug that lasted years
 #073
Gradient clipping: a leash for the one step that would wreck training
 #074
Learning rate warmup: why AI training starts with tiny steps
 #075
Cosine decay: how AI training slows down to land on the answer
 #076
Bias vs variance: why a model that fits every point can still fail
 #077
L1 vs L2 regularization: shrink every setting, or switch some off
 #078
Dropout: why switching off random parts of an AI helps with new data
 #079
Early stopping: knowing when an AI should stop training
 #080
Data augmentation: turning one example into many lessons for AI
 #081
Cross-validation: a fair test for an AI when data is scarce
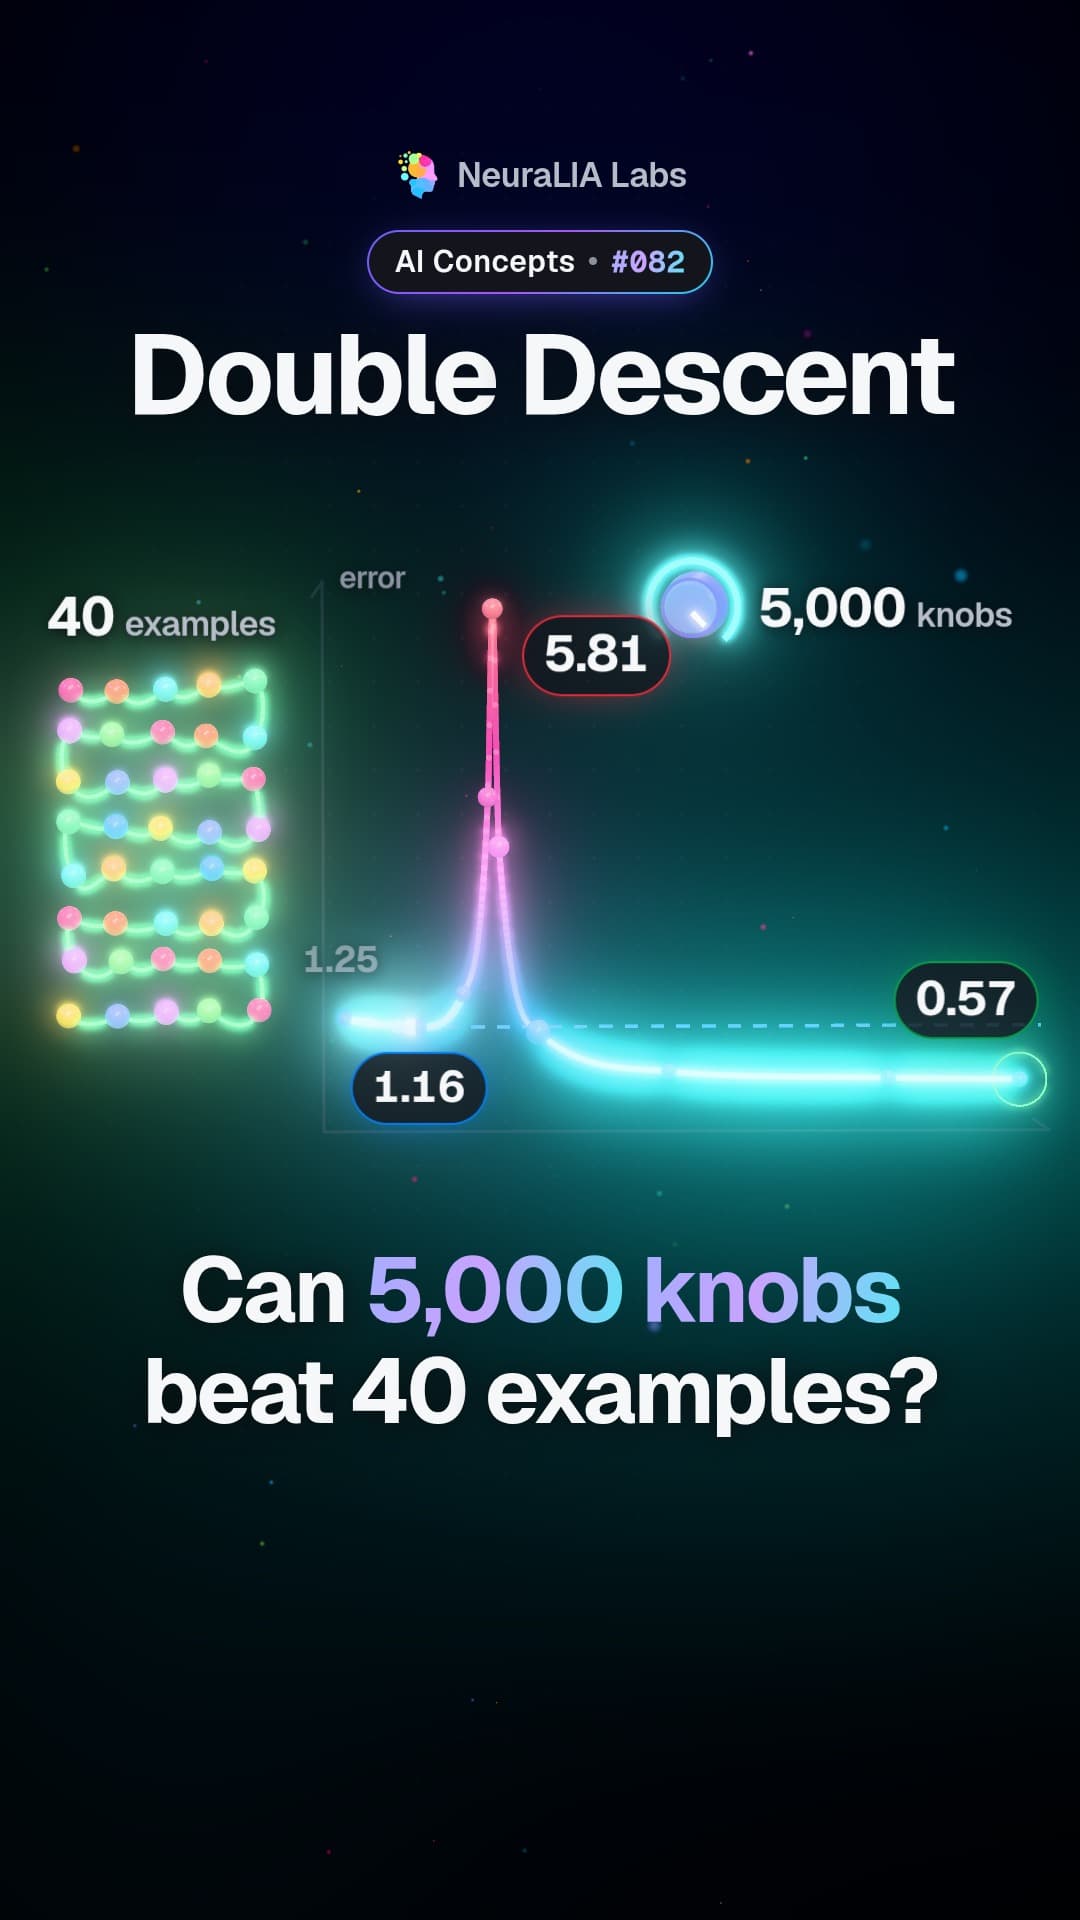 #082
Double descent: the error curve that falls, spikes, then falls again
 #083
Implicit regularization: the simplicity rule hidden inside AI training