
从零实现 Backpropagation:先造引擎,再搭网络
用纯 Python 写一个 120 行 autodiff 引擎,对照 PyTorch 精确到 16 位小数,并通过删除 zero_grad 理解它的作用。
本页内容
课程讲到第四章,中间还有一个空洞。
第 3 章给了我们 gradient descent:要改进一个参数,就找到 loss 对它的斜率,然后向下坡走一步。第 4 章给了我们一个值得下降的 loss。但在两章里,导数都是手算出来的——一个模型、一个参数、一行微积分,正好能放在一页纸上。
现在叠两层。第一层的输出送入第二层,所以第一层里的每个权重都会通过第二层里的每个神经元影响 loss。一个有两层隐藏层、每层一百个单元的网络大约有两万个参数,而每个参数都需要同一个 loss 对它的偏导。手算这件事不是繁琐;而是不可能,并且本课程后面每一种架构都会继续不可能。
出路不是更好的记号。出路是意识到:复合函数的导数可以由程序根据计算本身的结构机械地算出——而且如果方向选对,得到全部两万个导数的成本大约只相当于计算一次 loss。
这个机制叫 reverse-mode automatic differentiation。应用到神经网络上时,它叫 backpropagation。本章结束时,你会用大约 120 行无库 Python 写出一个这样的东西,用 PyTorch 检查它,并用它解决在第 1 章杀死 perceptron 的 XOR 问题。
首先:为什么非线性必不可少
链接到此部分:首先:为什么非线性必不可少在建造机器之前,必须先解决一个问题,因为如果答案是另一种,就没有什么可建造的了。
perceptron 在 XOR 上失败,是因为一条直线无法分开四个点。显然的修复办法是堆叠:让输入经过一个线性层,再经过另一个。这样有用吗?
没有,证明只要两行。线性层是 。把它喂给另一个线性层,,代入可得:
这个复合仍然是 ,其中 且 。一叠线性层等价于一个线性层。 十层也好,一千层也好:仍然是一条线,仍然做不了 XOR。
这件事值得亲眼看见,而不是只相信它:
import numpy as np
rng = np.random.default_rng(0)
W1, b1 = rng.normal(size=(3, 2)), rng.normal(size=3)
W2, b2 = rng.normal(size=(1, 3)), rng.normal(size=1)
x = rng.normal(size=2)

two_layers = W2 @ (W1 @ x + b1) + b2
one_layer  = (W2 @ W1) @ x + (W2 @ b1 + b2)
print(two_layers[0], one_layer[0], abs(two_layers[0] - one_layer[0]))-4.612963371048 -4.612963371048 0.00e+00不是近似相等。是逐 bit 完全相同,因为它只是同一组算术的重新排列。
所以深度本身买不到任何东西。真正买到东西的是在线性层之间放一个非线性函数——这就是 activation function 存在的全部原因。它们不是生物学上的装饰,也不是 normalisation 技巧。没有它,第二层只是摆设。
纸面上的 chain rule,以及共享节点
链接到此部分:纸面上的 chain rule,以及共享节点现在进入数学部分,而它只是你已经知道的一条规则,用在一个稍微陌生的地方。
单变量 chain rule 说,如果 依赖于 ,而 依赖于 ,那么 。导数沿着链相乘。
这里真正重要的是:当一个变量流向不止一条下游路径时会发生什么。如果 通过 影响 ,同时又通过 影响它,那么这些贡献会相加:
沿路径相乘,跨路径求和。这就是 backpropagation 的全部。本章后面的每个实现细节——包括代码里的 +=,以及让每个第一次写训练循环的人都踩坑的 zero_grad() 调用——都是第二个词的直接后果。
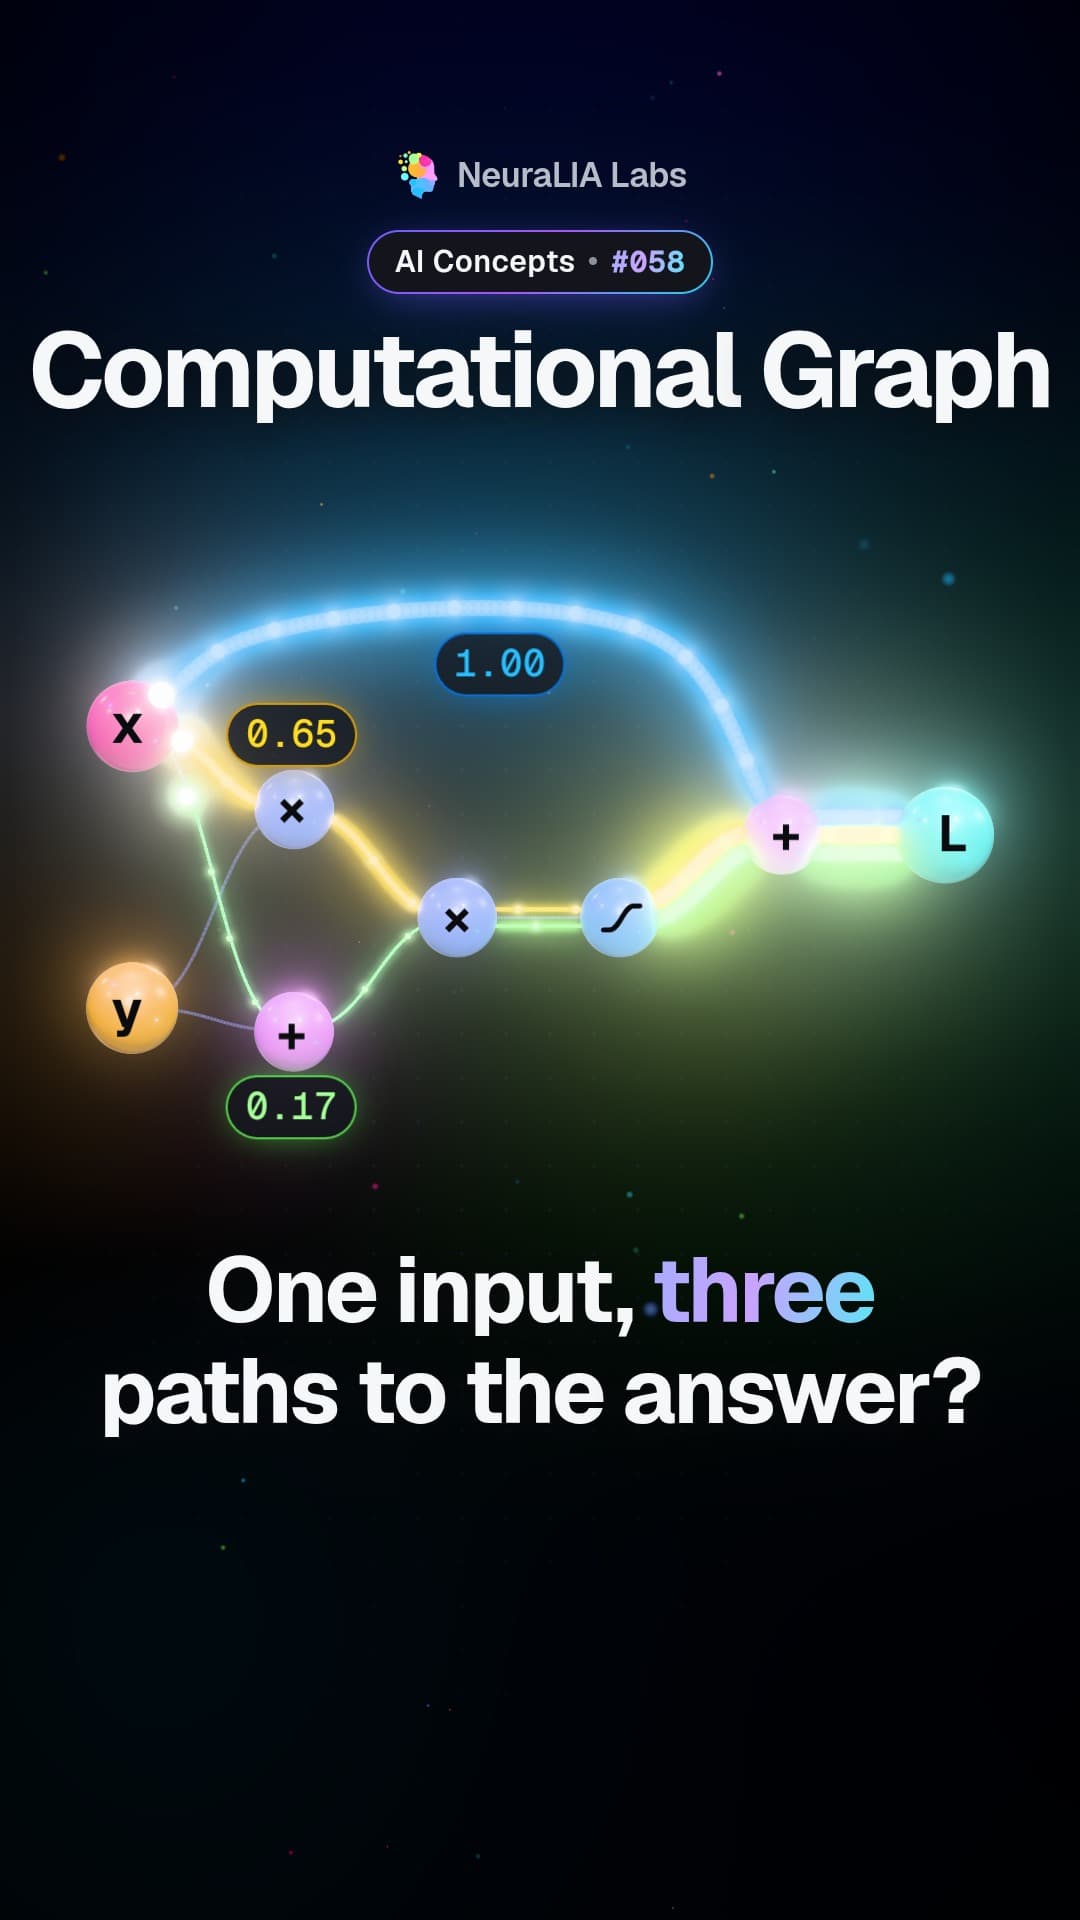
看一个由五个操作组成的具体电路,其中 且 :
注意 出现了三次:在 里,在 里,还直接出现在 里。在纸上从右到左做 backward pass,从 开始:
经过加法
链接到此部分:经过加法,所以 ,而直接路径贡献 。加法会分发传入的 gradient,原样给到两个输入。
经过 tanh
链接到此部分:经过 tanh且 ,所以 。
经过乘法
链接到此部分:经过乘法,所以 且 。乘法会交换:每个输入的 gradient 都由另一个输入的值缩放。
把三条路径收集到 x
链接到此部分:把三条路径收集到 x通过 :。通过 :。直接路径:。
记住这个数字。几页之后,一个程序会在没有被告知这些细节的情况下生成它。
构建引擎
链接到此部分:构建引擎让它可编程的洞见是:上面的每一步都是局部的。要把 gradient 推过乘法节点,你只需要传入的 gradient 和两个已存储的输入值——不需要知道电路其余部分。每个操作都知道如何对自己求导。
所以,做一个会记住自己从何而来的数字。
class Value:
    """A number that remembers where it came from."""

    def __init__(self, data, _children=(), _op=""):
        self.data = data
        self.grad = 0.0
        self._backward = lambda: None
        self._prev = set(_children)
self._op = _op四个字段。data 是数值。grad 累积 。_prev 是生成当前节点所依赖的 Value 集合——也就是图的边。_backward 是每个操作安装的闭包:它知道如何把这个节点的 gradient 向后推一步,推给输入。
每个运算符都有同样的形状:计算输出,记录父节点,安装局部规则。
    def __add__(self, other):
        other = other if isinstance(other, Value) else Value(other)
        out = Value(self.data + other.data, (self, other), "+")

        def _backward():
            self.grad += out.grad
            other.grad += out.grad

        out._backward = _backward
        return out

    def __mul__(self, other):
        other = other if isinstance(other, Value) else Value(other)
        out = Value(self.data * other.data, (self, other), "*")

        def _backward():
            self.grad += other.data * out.grad
            other.grad += self.data * out.grad

        out._backward = _backward
        return out

    def tanh(self):
        t = math.tanh(self.data)
        out = Value(t, (self,), "tanh")

        def _backward():
            self.grad += (1 - t * t) * out.grad

        out._backward = _backward
        return out

    def relu(self):
        out = Value(self.data if self.data > 0 else 0.0, (self,), "relu")

        def _backward():
            self.grad += (1.0 if out.data > 0 else 0.0) * out.grad

        out._backward = _backward
        return out
把四个 _backward 函数体当成一张表来读,纸面推导里的流动模式就在那里:
| 操作 | 它如何处理 gradient |
|---|---|
+ | 分发——同一个 gradient 给每个输入 |
* | 交换——每个输入都由另一个输入的值缩放 |
relu | 路由——让它通过,或完全阻断 |
tanh | 衰减——按 缩放,最大为 1,通常更小 |
每一个都使用 +=,从不使用 =。这就是「跨路径求和」规则的编码。一个节点如果流向两个消费者,就会被调用两次,而两个贡献会自己加起来。
然后是驱动器,这是唯一具有全局知识的部分:
    def backward(self):
        order, seen = [], set()

        def build(v):
            if v in seen:
                return
            seen.add(v)
            for child in v._prev:
                build(child)
            order.append(v)

        build(self)
        self.grad = 1.0
        for v in reversed(order):
            v._backward()
build 会生成图的拓扑顺序:每个节点都出现在它所有输入之后。反向遍历这个列表可以保证,当你调用某个节点的 _backward 时,它自己的 gradient 已经完整——它下游的每个消费者都已经贡献过了。顺序错了,你就会把一个半成品 gradient 往后推,结果答案错了,却没有任何错误信息。
它和纸面结果一致吗?
链接到此部分:它和纸面结果一致吗?x = Value(0.5)
y = Value(1.4)
a = x * y
b = x + y
c = a * b
d = c.tanh()
L = d + x
L.backward()
print(x.grad, y.grad)forward: a=0.7000 b=1.9000 c=1.3300 d=0.8692 L=1.3692
backward: dL/dd=1.0000 dL/dc=0.2444 dL/da=0.4644 dL/db=0.1711
dL/dx=1.8212 dL/dy=0.40331.8212。同一个数字,来自一个程序;这个程序只被告知了 + 的规则、* 的规则、tanh 的规则,而没有被告知这个电路的任何信息。
做两个独立检查,因为「它匹配我的推导」是一个很弱的测试,尤其当推导和实现都出自同一个人。
数值微分。 轻推输入,然后测量。中心差分 不用任何微积分就能估计导数:
dL/dx:  analytic=1.821202805  numeric=1.821202805  |diff|=1.80e-10
dL/dy:  analytic=0.403269235  numeric=0.403269235  |diff|=7.64e-12
对照 PyTorch,它有一个由专业人士编写的工业级 autodiff 引擎:
torch dL/dx=1.821202805316   ours=1.821202805316   |diff|=2.22e-16
torch dL/dy=0.403269234753   ours=0.403269234753   |diff|=1.11e-16
在 处一致,这是 64 位浮点数的机器 epsilon:两个引擎执行的是相同的算术。把数值检查收好——它是调试新层 backward pass 的工具,也是错误 gradient 能被找到的原因。
饱和,实测
链接到此部分:饱和,实测同一个电路,换一组输入。设 且 ,这会使 :
x=0.5, y=1.4:  dL/dc = 0.244400     three paths into x:  0.6501 + 0.1711 + 1.0000 = 1.8212
x=2.0, y=-3.0: dL/dc = 0.000025     three paths into x:  0.0001 + -0.0001 + 1.0000 = 0.9999
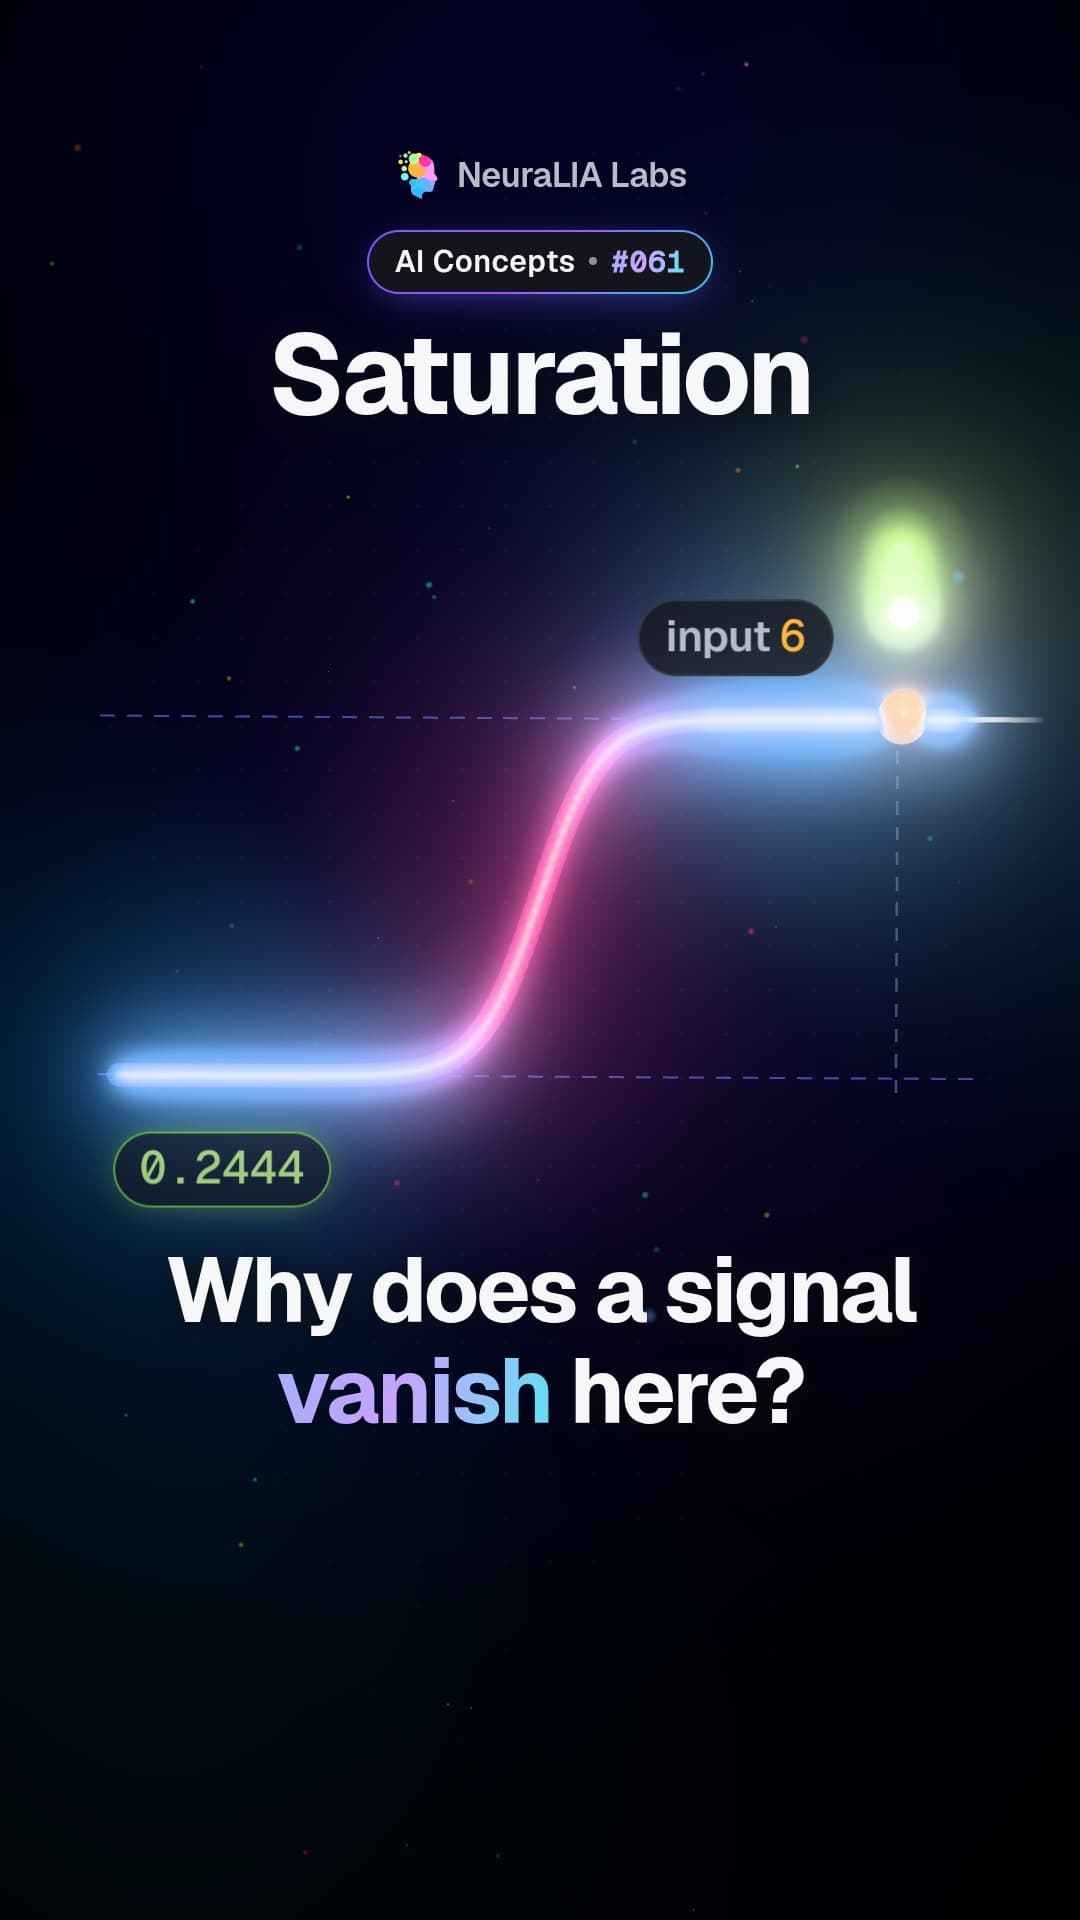
穿过 节点的 gradient 下降了 9,945 倍。它上游的一切——在真实网络里,就是它之前的每一层——几乎什么都收不到。电路中经过它的两条路径都沉默了;只有绕过 的直接连接还携带信号。
这就是 vanishing gradient 问题,压缩在一个节点里。叠四十层 ,再把四十个这样的因子相乘,早期层就会完全停止学习。顺便说,这也是一个关于 skip connection 的论据,而且你在这里能看到它的微缩版:绕过非线性的那条路径是唯一存活下来的路径。
zero_grad 实际做了什么,以及为什么这个 bug 会藏起来
链接到此部分:zero_grad 实际做了什么,以及为什么这个 bug 会藏起来每个 _backward 都使用 +=。这是正确的——路径就是这样求和的。但它有一个会抓住所有人的后果:gradients 也会在多次调用 backward() 之间累积。引擎不知道你的第二次调用是新的训练步,而不是同一张图里的另一条路径。
所以训练循环必须清空它们:
for step in range(steps):
    ys = [model(x) for x, _ in DATA]
    loss = sum((yp - yt) ** 2 for yp, (_, yt) in zip(ys, DATA))

    for p in model.parameters():
        p.grad = 0.0

    loss.backward()
    for p in model.parameters():
        p.data -= lr * p.grad
这在 PyTorch 里就是 optimizer.zero_grad(),通常的建议是:忘记它会破坏训练。那我们删掉这两行,看看它到底有多坏。同样的 seeds、同样的一切,XOR 训练 200 步:
| learning rate | seed | 重置后 | 不重置 |
|---|---|---|---|
| 0.05 | 1337 | loss 3.255088, 3/4 | loss 0.000000, 4/4 |
| 0.05 | 7 | loss 2.144820, 2/4 | loss 0.000000, 4/4 |
| 0.05 | 42 | loss 2.126074, 2/4 | loss 0.000000, 4/4 |
| 0.1 | 1337 | loss 0.038597, 4/4 | loss 0.000000, 4/4 |
| 0.1 | 7 | loss 2.055048, 2/4 | loss 0.000000, 4/4 |
| 0.1 | 42 | loss 2.049876, 2/4 | loss 0.000073, 4/4 |
| 0.3 | 1337 | loss 4.512310, 2/4 | loss 8.000000, 2/4 |
| 0.3 | 7 | loss 0.015247, 4/4 | loss 4.000000, 3/4 |
| 0.3 | 42 | loss 0.005478, 4/4 | loss 4.000000, 3/4 |
在小 learning rate 下,有 bug 的版本每一行都赢。正确版本停滞时,它反而收敛。
这不是偶然,而且值得理解,因为它解释了为什么这个 bug 如此难抓。如果你从不清空 gradient,那么在第 步,参数会被迄今为止计算出的所有 gradient 之和更新。在一个 loss 大致持续指向同一方向的情况下,这个和会稳定增长,效果就像 learning rate 自己变大。在 ,正确算法还在爬行时,这种失控的步长看起来完全像是一种修复。
再看底部三行。在 ,同一机制把模型炸开了——loss 8.0 是模型塌缩到常数 时的分数,是四个最大错误答案会产生的 16 的一半——而正确版本现在可以干净地收敛。
所以诚实的说法不是「一定要调用 zero_grad,否则模型不会训练」。而是:没有它,你运行的就不再是 gradient descent。 你运行的是某种步长以无人选择的速率向上漂移的东西;它会看似有效,有时甚至比真算法更好,直到它突然失效——那时你会去怪 learning rate、初始化或数据。这就是机器学习里最糟糕 bug 的形状:它们不会崩溃,而是把算法变成另一种算法,并且偶尔得分更高。
网络,终于轮到 XOR
链接到此部分:网络,终于轮到 XOR引擎完成之后,神经网络几乎没几行代码。一个神经元是 dot product、bias 和 activation;一层是一组神经元;一个网络是一组层。
class Neuron:
    def __init__(self, nin):
        self.w = [Value(random.uniform(-1, 1)) for _ in range(nin)]
        self.b = Value(0.0)

    def __call__(self, x):
        act = sum((wi * xi for wi, xi in zip(self.w, x)), self.b)
        return act.tanh()

    def parameters(self):
        return self.w + [self.b]


class Layer:
    def __init__(self, nin, nout):
        self.neurons = [Neuron(nin) for _ in range(nout)]

    def __call__(self, x):
        out = [n(x) for n in self.neurons]
        return out[0] if len(out) == 1 else out

    def parameters(self):
        return [p for n in self.neurons for p in n.parameters()]


class MLP:
    def __init__(self, nin, nouts):
        sizes = [nin] + nouts
        self.layers = [Layer(sizes[i], sizes[i + 1]) for i in range(len(nouts))]

    def __call__(self, x):
        for layer in self.layers:
            x = layer(x)
        return x

    def parameters(self):
        return [p for layer in self.layers for p in layer.parameters()]
这里面没有 backward pass。一行都没有。Value 类已经知道如何对这些类碰巧构建出的任何东西求导,这也是先写它的意义:autodiff 引擎不知道自己正在被用于神经网络。
现在回到第 1 章的问题。两个输入、两个隐藏单元、一个输出、九个参数:
step   1: loss 4.156690
step  10: loss 4.005572
step  50: loss 3.996708
step 100: loss 3.510700
step 200: loss 0.038597

[0, 0] -> -0.9081  (target -1)  ok
[0, 1] -> +0.8934  (target +1)  ok
[1, 0] -> +0.8906  (target +1)  ok
[1, 1] -> -0.9207  (target -1)  ok
四个全对。没有任何 perceptron 能计算的函数——第 1 章用四个不等式证明它要求 同时为正又为负——现在由自动找到的九个数字计算出来了。
隐藏层做了什么
链接到此部分:隐藏层做了什么令人满意的部分不是它能工作,而是你能看到它如何工作。因为只有两个隐藏单元,中间表示就是平面上的一个点,你可以直接打印出来。
训练到 loss 0.001241 后,每个输入经过隐藏层后落在这里,而输出神经元对它做了这些事:
| 输入 | 隐藏层输出 | 输出分数 | 标签 |
|---|---|---|---|
看第一行和第四行。输入 和 是正方形里对角相对的两个角——在这个问题中,两点之间不可能更远——而隐藏层把它们映射到 和 。几乎是同一个点。 这一层把平面折叠起来,让两个被拒绝的角落落到彼此上方;一旦它们在同一个地方,一条线就能把它们和另外两个点分开。
而输出神经元正是那条线。它学到的参数是 、,所以它的决策边界是
这是一条直线——一个 perceptron,和第 1 章里的对象相同,没有改变。它当时不能解决 XOR,现在也不能。改变的是它不再看原始输入;它看的是第一层为它构造出的空间,在这个空间里,问题是线性可分的。
这就是学到的表示。值得精确一点,因为这个短语在本课程余下部分、乃至整个领域里都会被宽泛使用。它不是压缩,不是摘要,也不是某种神秘意义上的 embedding。它是一种坐标变换,是学出来而不是设计出来的;它唯一的工作,就是让下一层的工作变简单。
universal approximation theorem,以及它没有说什么
链接到此部分:universal approximation theorem,以及它没有说什么这里有一个定理,而且它经常被糟糕地引用。
Cybenko 在 1989 年、Hornik 在 1991 年证明:一个带单隐藏层和合适 activation function 的 feedforward network,只要隐藏单元足够多,就可以在紧集上以任意精度逼近任意连续函数。34 这是一个真实且重要的结果:它说明架构本身不是限制。
现在读读它省略了什么。它没有说需要多少单元——这个界可能大到天文数字。它没有说权重可以被找到;它断言的是存在性,而从随机起点开始的 gradient descent 不是神谕。它也没有说明在你没见过的数据上的行为,而那正是第 6 章的后半部分。
「存在」和「可找到」之间的差距不是学术问题。这里是同一个 XOR 问题,每种设置 50 次随机初始化、1000 步,只改变隐藏层大小:
| 隐藏单元 | 达到 4/4 的初始化次数 |
|---|---|
| 2 | 38 / 50 (76 %) |
| 3 | 49 / 50 (98 %) |
| 4 | 50 / 50 (100 %) |
| 8 | 47 / 50 (94 %) |
在最低可用架构下,四次运行里有一次永远到不了——它会停在某种无法下降出去的配置中,正是第 3 章在一维曲面上展示过的 local minimum。加一个单元,失败几乎消失;不是因为网络表达能力变强了(两个单元已经足够——38 次成功证明了这一点),而是因为额外维度给了 descent 更多逃逸方向。
然后八个单元反而比四个略差。在固定 learning rate 和步数预算下,更多容量并不单调更好。任何告诉你「网络卡住的修复办法总是做大网络」的人,都是从这张表中间那段外推。
这和第 1 章的收敛定理是同一课;在第 10 章讨论 scaling laws 时,它也会以那一章给出的形式再次出现:对 loss 的预测,不等于对你付费购买的能力的预测;两者之间的距离,就是工程存在的地方。
查看详情
可选:矩阵形式,以及为什么上面的代码没有使用它。
这里的一切都是一次写一个标量,这是看清机制最清楚的方式,也是执行起来最慢的方式。实践中,一层是矩阵乘法,而 的 backward pass 是
转置不是需要死记的技巧;它们是「跨路径求和」规则在路径由矩阵条目索引时的样子。一般对象是 Jacobian,也就是所有输出对所有输入的全部偏导组成的矩阵;reverse mode 精确地说是在不真正构造 Jacobian 的情况下计算 vector-Jacobian product——这很重要,因为一个有 4096 个输入和 4096 个输出的层,其矩阵有一千六百万个条目,永远不值得构建。
你不需要这些也能跟上后面的章节;标量版本能完成矩阵版本做的一切,只是更慢。它会在第 9 章变得必要,因为那时 shape 不再显而易见。
接下来走向哪里
链接到此部分:接下来走向哪里你现在有了一个能训练的网络。这个成就比它看起来要小,因为你拥有的网络在四个样本上训练,并且也在同样四个样本上衡量。
把同样的代码跑在真实数据集上,一组新问题就会出现,而它们都不是关于 gradients 的。loss 下降一阵后停住。或者它在训练数据上下降,在其他所有东西上上升。或者从第一步起就完全不动,最后发现原因是初始随机权重的范围。或者某个单元的输入在第三个 epoch 对每个样本都漂到了负数,从那以后它就一直死着,悄无声息地带走了模型容量的一块。
这些不是罕见故障;它们是一个刚写出来的网络的正常状态,而且没有一个会主动宣告自己。gradient 是正确的——你已经用 PyTorch 检查到十六位小数——但模型仍然学不会。
第 6 章讲的就是这些:初始化、normalisation、overfitting 和 regularisation,以及在改任何东西之前先诊断到底是哪一种正在发生的习惯。这就是能运行的网络与能工作的网络之间的区别。
来源与方法
链接到此部分:来源与方法本章的 Value 类直接源自 Andrej Karpathy 的 micrograd,他的视频 The spelled-out intro to neural networks and backpropagation: building micrograd 是你能花在这份材料上的最佳三小时,如果你想听另一个人用另一种方式讲解的话。他 2016 年的文章 Yes you should understand backprop 论证了为什么你应该亲手写一个,并且是 Stanford CS224n 的指定阅读。CS231n 关于 backpropagation 的笔记(cs231n.github.io/optimization-2)是上面表格中那些流动模式的经典讲解。若想把数学理解为图上的微积分,而不是神经网络民间传说,Deisenroth、Faisal 和 Ong 的 Mathematics for Machine Learning 第 5.6 章异常清晰;Baydin、Pearlmutter、Radul 和 Siskind 的综述 Automatic Differentiation in Machine Learning: a Survey(arXiv:1502.05767)则是整个领域的参考资料,也包括上文讨论的 forward/reverse 取舍。
参考资料
链接到此部分:参考资料-
Linnainmaa, S. The representation of the cumulative rounding error of an algorithm as a Taylor expansion of the local rounding errors. 硕士论文,University of Helsinki(1970)。Reverse-mode accumulation,比它进入这个领域早十六年,而且动机完全不同。 ↩
-
Rumelhart, D. E., Hinton, G. E. and Williams, R. J. Learning representations by back-propagating errors. Nature 323, pp. 533–536(1986)。这篇论文让该方法为人所知,也提供了把隐藏单元解读为 learned representations 的来源;本章的 隐藏层做了什么 一节正是围绕这个解读做测量。 ↩
-
Cybenko, G. Approximation by superpositions of a sigmoidal function. Mathematics of Control, Signals and Systems 2, pp. 303–314(1989)。 ↩
-
Hornik, K. Approximation capabilities of multilayer feedforward networks. Neural Networks 4(2), pp. 251–257(1991)。推广了 Cybenko:结果依赖于 activation 是非多项式,而不是依赖于它是 sigmoidal。 ↩
本章视频
用通俗语言讲解本章概念的短视频。
 #03
Neural networks: layers of tiny calculators passing signals on
 #055
Activation functions: the small bend that makes deep networks work
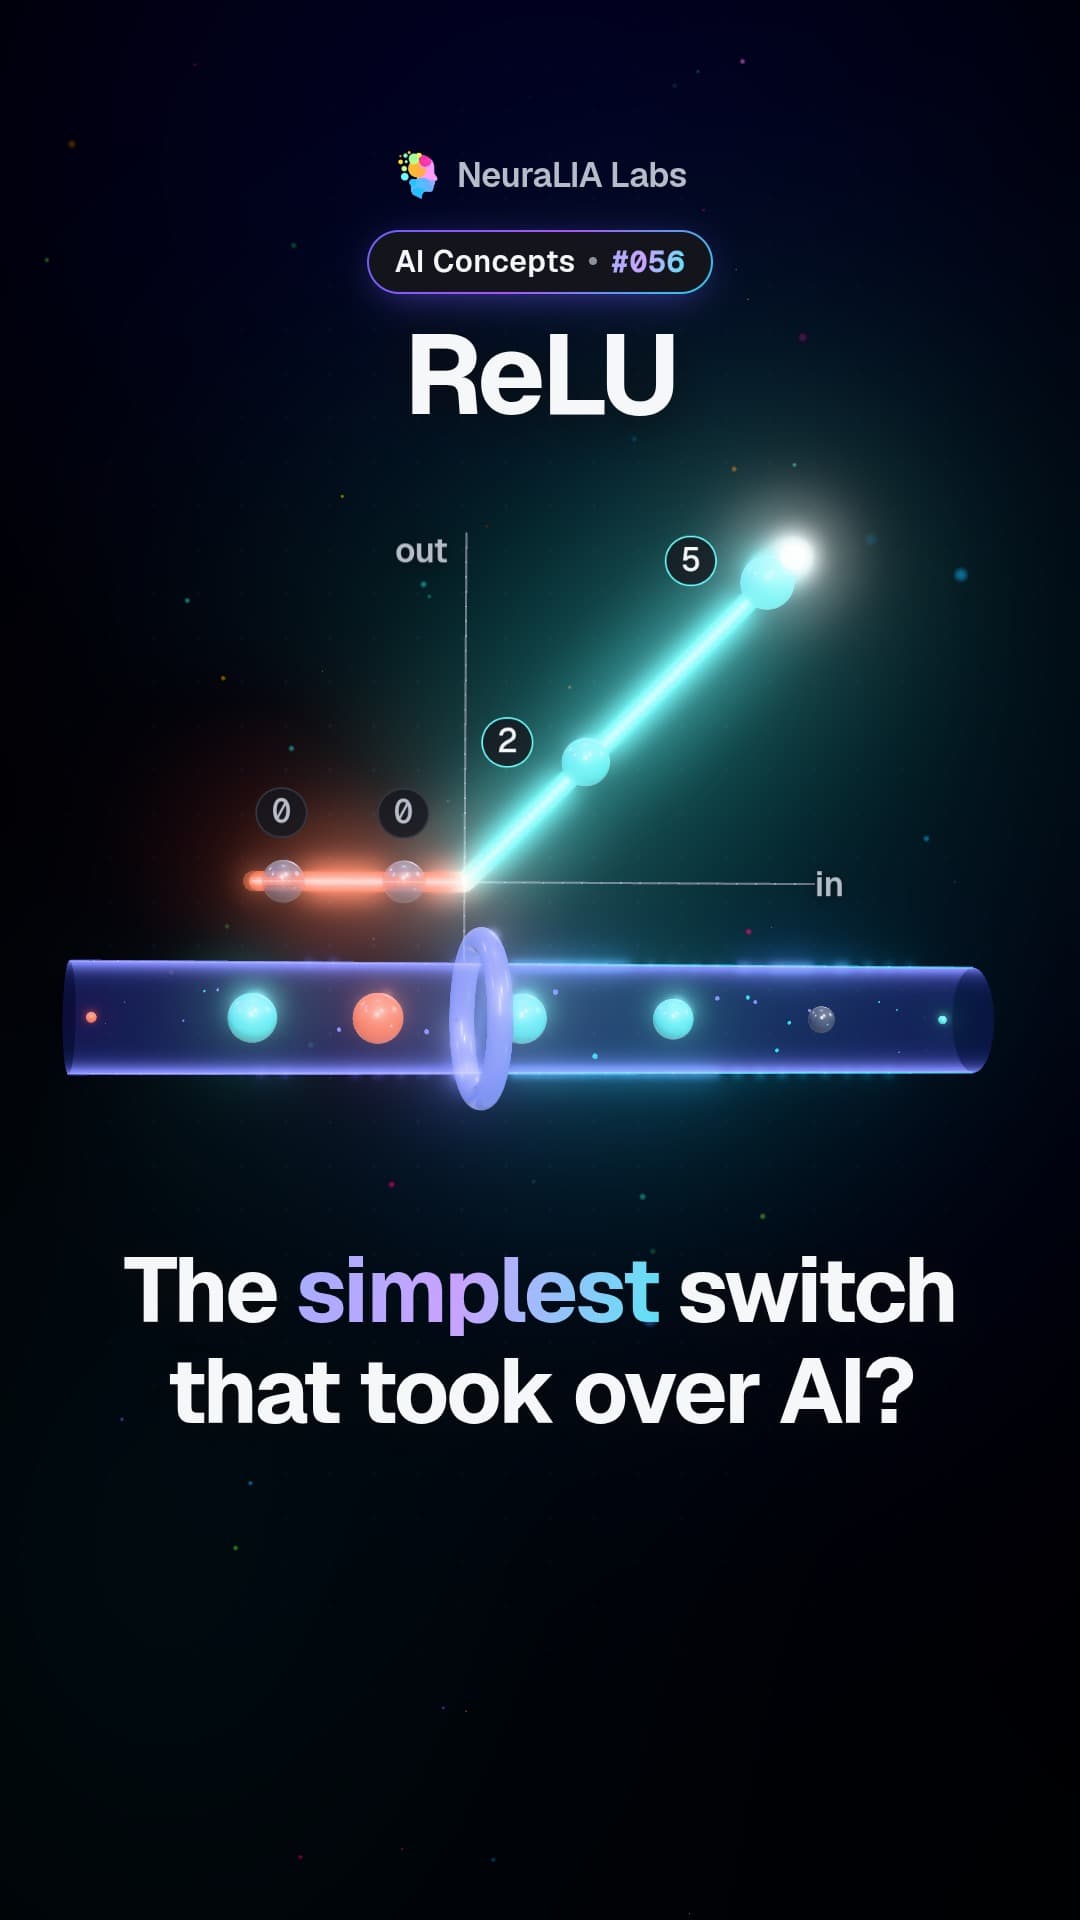 #056
ReLU: the simple on-off rule inside modern neural networks
 #057
Dying ReLU: when parts of a neural network quietly switch off
 #058
Computational graphs: how AI tracks where every number came from
 #059
Backpropagation: one backwards pass that trains a whole network
 #060
Autodiff: how a program works out its own slopes, exactly
 #061
Saturation: when a flat curve stops a neural network from learning
 #062
Multilayer perceptron: how a few neurons solve what one never can
 #063
Learned representation: how a hidden layer reshapes a problem
 #064
Universal approximation theorem: what it promises and what it does not