
从零实现感知机:一个神经元到底计算什么
用纯 Python 构建感知机,观察它在 XOR 上失败,并理解为什么收敛定理只保证成功,不保证你等得到。
本页内容
工厂里有一条传送带。零件顺着它下来,必须有人决定哪些可以出货,哪些要退回。每个零件只测两个数字:宽度,单位毫米;重量,单位克。信息就这么多。
自动化这件事,最显然的办法是把规则写下来。如果宽度低于 22 毫米,就放行。 这在供应商更换合金、重量分布发生变化之前都很好用。于是你加一个条件。接着公差重新谈判,你又加一个条件。六个月后,这个函数有四十行长,没人记得第 19 行为什么在那里,而写它的人已经离职。
另一种办法,就是这门课程的主题。你不写规则。你写规则的形状——一个带空位的模板——然后让样本决定空位里填什么。这个反转就是机器学习的全部,而在本章里,这个模板已经小到不能再小:两个数字和一个阈值。
到最后,你会用大约二十行 Python 写出一个感知机,看它成功,看它失败,并理解两者。你在这里写下的文件不是下一章就扔掉的玩具:它是一个仓库里的第一次 commit,而这个仓库在二十九章之后,会变成一个带 tool 循环和权限模型的 agent。
模型:加权求和与一条直线
链接到此部分:模型:加权求和与一条直线感知机拿到测量值,把每个值乘以一个由它控制的数字,把它们加起来,再加上另一个数字,然后看结果的符号。
把一个零件的测量值写成向量 ——宽度和重量。感知机持有一个权重向量 和一个偏置 。它的分数是
它的答案就是这个分数的符号:如果 就放行,否则退回。
这就是整个模型。感知机关于这座工厂能够知道的一切,都存在三个数字里。
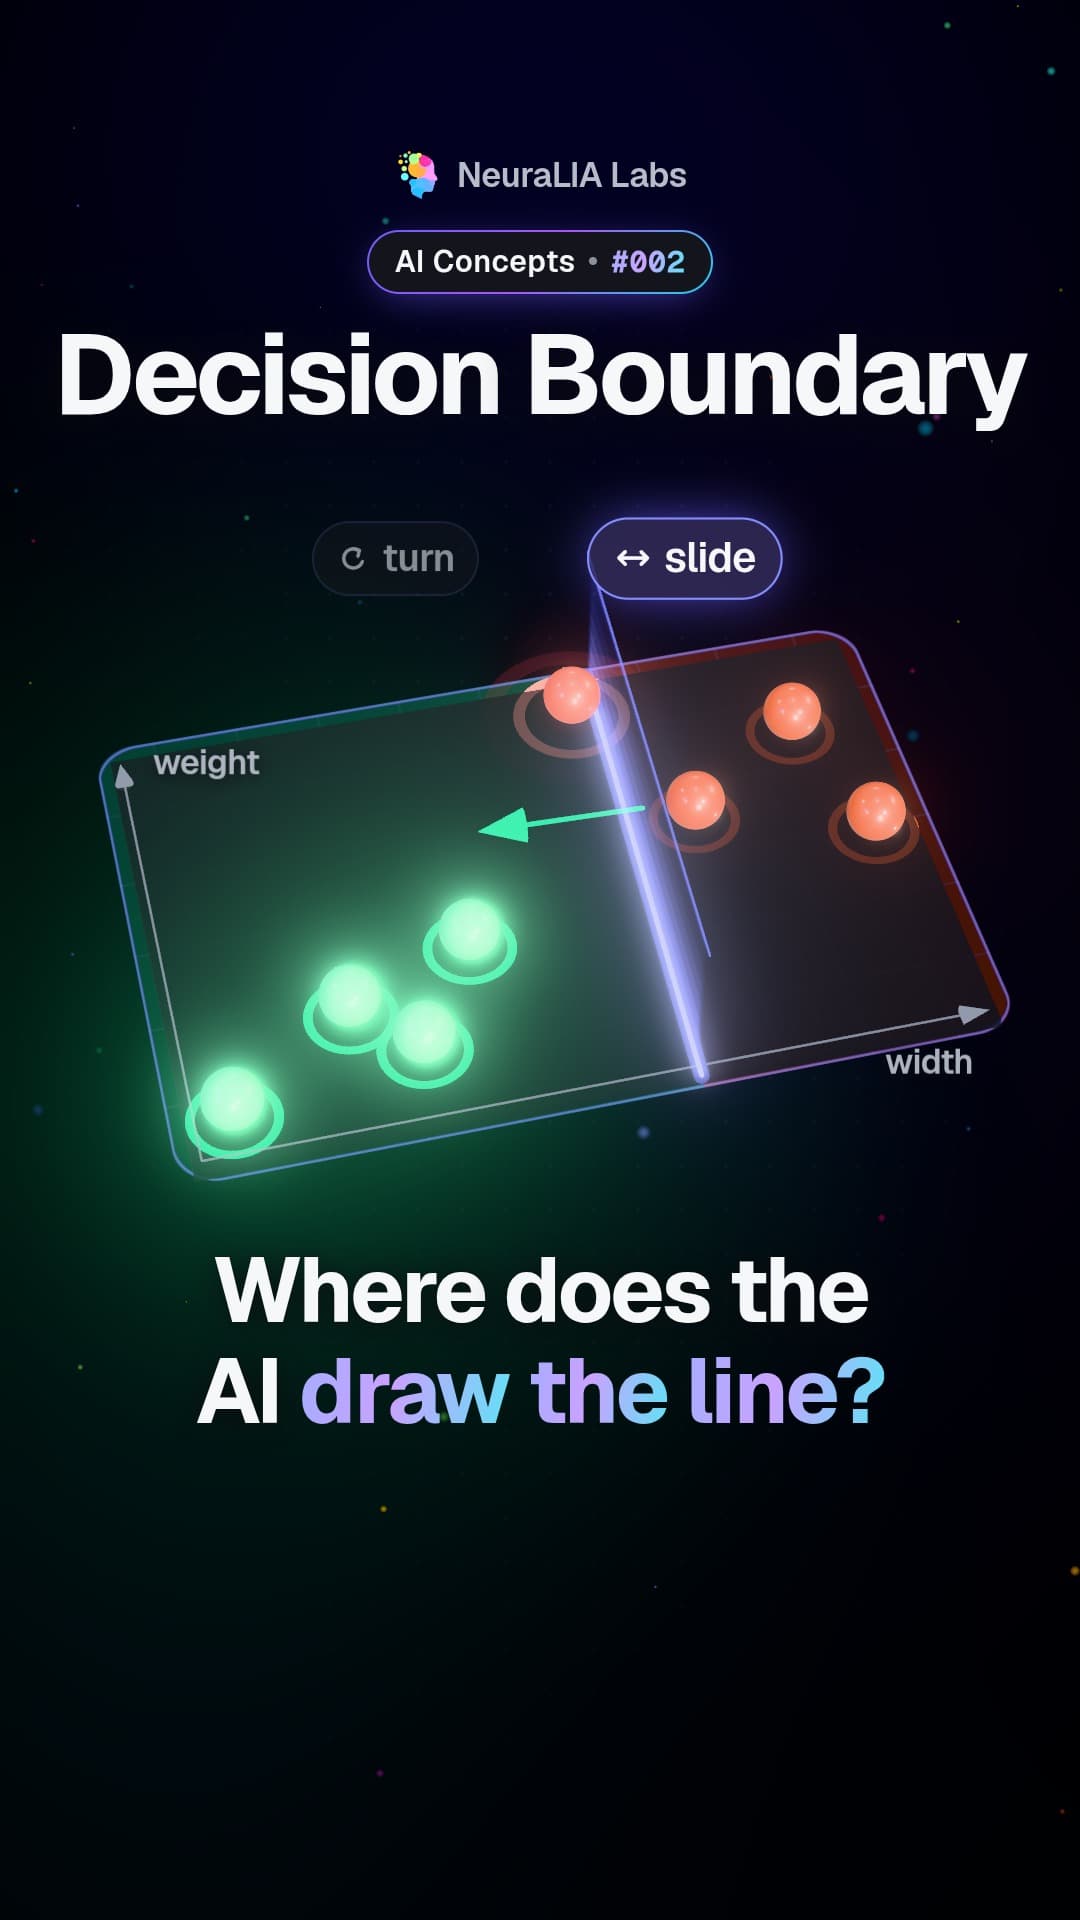
这里值得停下来看看几何图像,因为即使二十九章之后方程已经放不下一行,这幅图仍然管用。所有满足 的点——也就是感知机正好犹豫不决的点——在平面上形成一条直线。直线的一侧分数为正,全部放行;另一侧分数为负,全部退回。对感知机来说,学习就是移动这条线。
关于这条线,有两个事实可以直接从代数推出,而且之后都会很重要:
- 与它垂直。权重向量不是沿着边界躺着,而是穿过边界,指向被放行的一侧。
- 会平移它,而不会旋转它。没有偏置,这条线就被迫穿过原点;对一个用毫米和克测量的工厂来说,这是荒唐的约束——它意味着一个宽度为零、重量为零的零件正好坐在栅栏上。
学习规则,以及它为什么不需要微积分
链接到此部分:学习规则,以及它为什么不需要微积分感知机一开始一无所知: 和 。每个分数都是零,所以它会放行一切。
现在一次给它看一个样本。把应当放行的零件标为 ,应当退回的零件标为 。对每个样本,只问一个问题:符号对了吗? 紧凑的写法是检查 是否为正——如果标签和分数符号一致,它们的乘积为正;如果不一致,乘积为负。
如果答案是是,什么也不改。如果答案是否,就推一下:
这就是整个算法,而且值得理解的是,为什么 这一下是正确的推动,而不是死记。假设一个零件本应被放行(),但分数却是负的。把 加到 上,会让同一个零件的分数改变
这是一个正数。它刚刚判错的那个零件,分数会上升,这正是它需要移动的方向。这个规则不是某个人猜出来的启发式方法;它是能被证明会改善眼前这个案例的最小改变。当然,它可能会弄坏另一个案例,所以你才要再跑一轮。
注意这里缺了什么。完全没有导数。这不是疏忽,而是本课程第一个真正重要的想法。
你想求导的东西是错误——被误分类零件的数量。但这个数量是一段楼梯:你轻轻移动直线时,它会平平地停在 4;直到直线越过某个点的瞬间,它才降到 3。它的导数几乎处处为零,在台阶处又没有定义。微积分无处下手。感知机规则绕开了这一点:它根本不问斜率,只问「对还是错?」,然后朝着一个能用几何解释的方向移动。
这是一个真正的解法,但也是一条死路。在第 2 章,我们会想要一个有来处、而不是随手选出的损失;在第 4 章,我们会想要一个能报告自己有多确定的模型;在第 5 章,我们会想要不止一层的东西——而这些都无法从一个只知道「错了」的规则抵达。把可用的斜率找回来,正是接下来两章必须做的事。但感知机能做一件它所有后继者都做不到的事:完全不用微积分也能学习。
写出来
链接到此部分:写出来纯 Python,不用 NumPy。列表和一个循环。NumPy 下一章再登场,因为那时算术已经不适合放进你愿意阅读的循环里;现在引入它,恰好会在你最想看清算术的时刻,把算术藏到库后面。
def score(w, b, x):
    return w[0] * x[0] + w[1] * x[1] + b


def predict(w, b, x):
    return 1 if score(w, b, x) >= 0 else -1


def train(data, epochs=200):
    """Returns (w, b, epoch_it_converged) — or None for the epoch if it never did."""
    w, b = [0.0, 0.0], 0.0
    for epoch in range(epochs):
        mistakes = 0
        for x, y in data:
            if y * score(w, b, x) <= 0:
                w[0] += y * x[0]
                w[1] += y * x[1]
                b += y
                mistakes += 1
        if mistakes == 0:
            return w, b, epoch + 1
    return w, b, None
高亮的四行就是算法。其他全是记账。
下面是传送带上的八个零件测量值——四个出货,四个退回:
BELT = [
    ((18.0, 47.0), +1), ((19.5, 52.0), +1), ((20.2, 49.0), +1), ((21.0, 55.0), +1),
    ((24.0, 61.0), -1), ((25.5, 66.0), -1), ((23.0, 70.0), -1), ((26.0, 58.0), -1),
]

w, b, epoch = train(BELT, epochs=200)
print(epoch, w, b)这八个零件确实可以被一条直线分开——每个放行零件都小于 22 mm,每个退回零件都是 23 mm 或更大。在 22 毫米处竖一道栅栏就行。所以感知机应该能找到它。
运行它:
None [-142.1, -13.0] 54.0两百个 epoch,454 次修正,它还没有收敛。权重很大,而且符号不对。一定有什么地方错了——但其实什么都没错,而原因正是本章最有用的东西。
收敛定理,以及它真正给你的那个数字
链接到此部分:收敛定理,以及它真正给你的那个数字感知机有一个保证,由 Novikoff 在 1962 年证明。1 如果数据确实能被一条直线分开,那么算法在停止出错之前,最多会做
次修正——其中 是数据半径,也就是最长样本向量的长度; 是margin:在把偏置作为第三个坐标加入后的增广空间里,分隔超平面到最近点的距离。这就是为什么对数据做中心化会改变它,而以毫米为单位的距离不会。
这个保证是无条件的,它不提 epoch、学习率或运气。它也不提时间,而这正是关键。
把我们的数字代进去。直接从八个零件测得,并把偏置折叠成一个常量特征:
| 半径 | margin | 上界 | 实际修正次数 | |
|---|---|---|---|---|
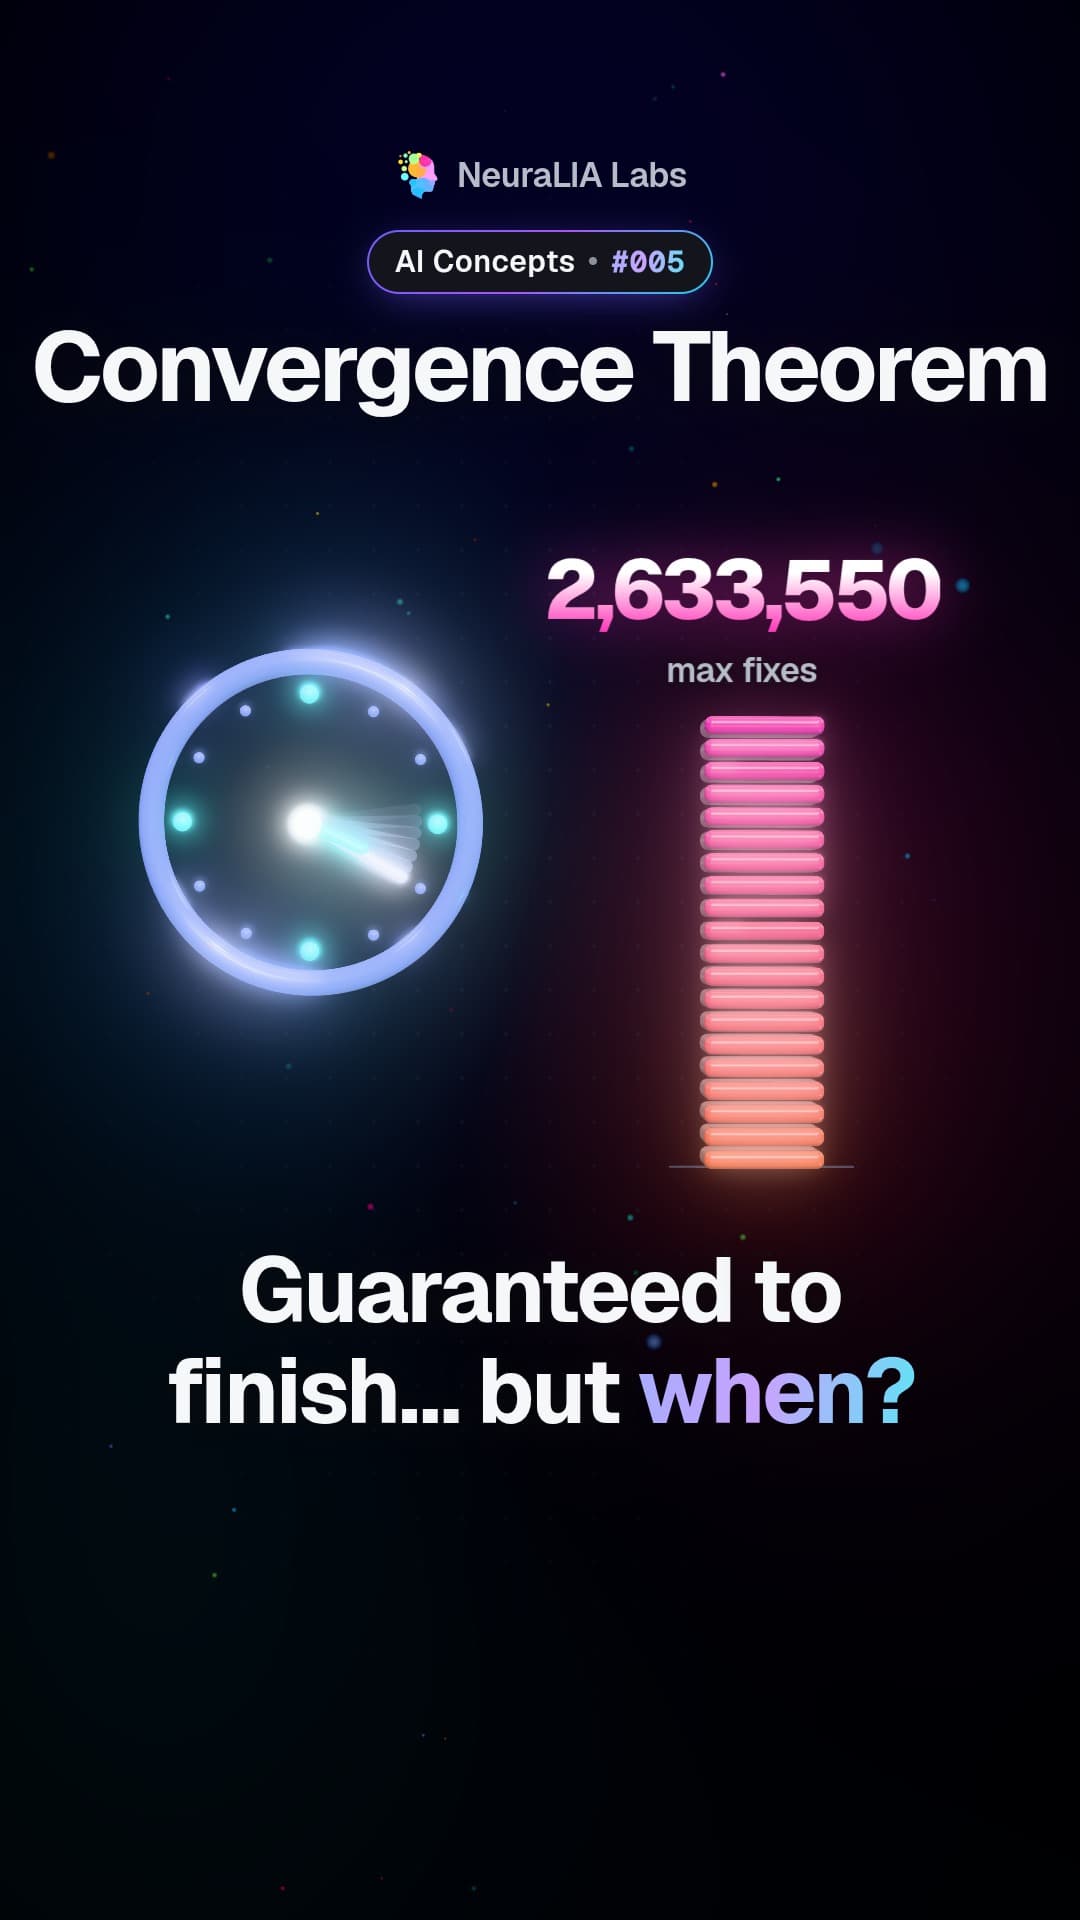
| 原始毫米和克 | 73.69 | 0.045 | 2,633,550 | 29,870 |
| 减去均值之后 | 12.82 | 0.989 | 168 | 1 |
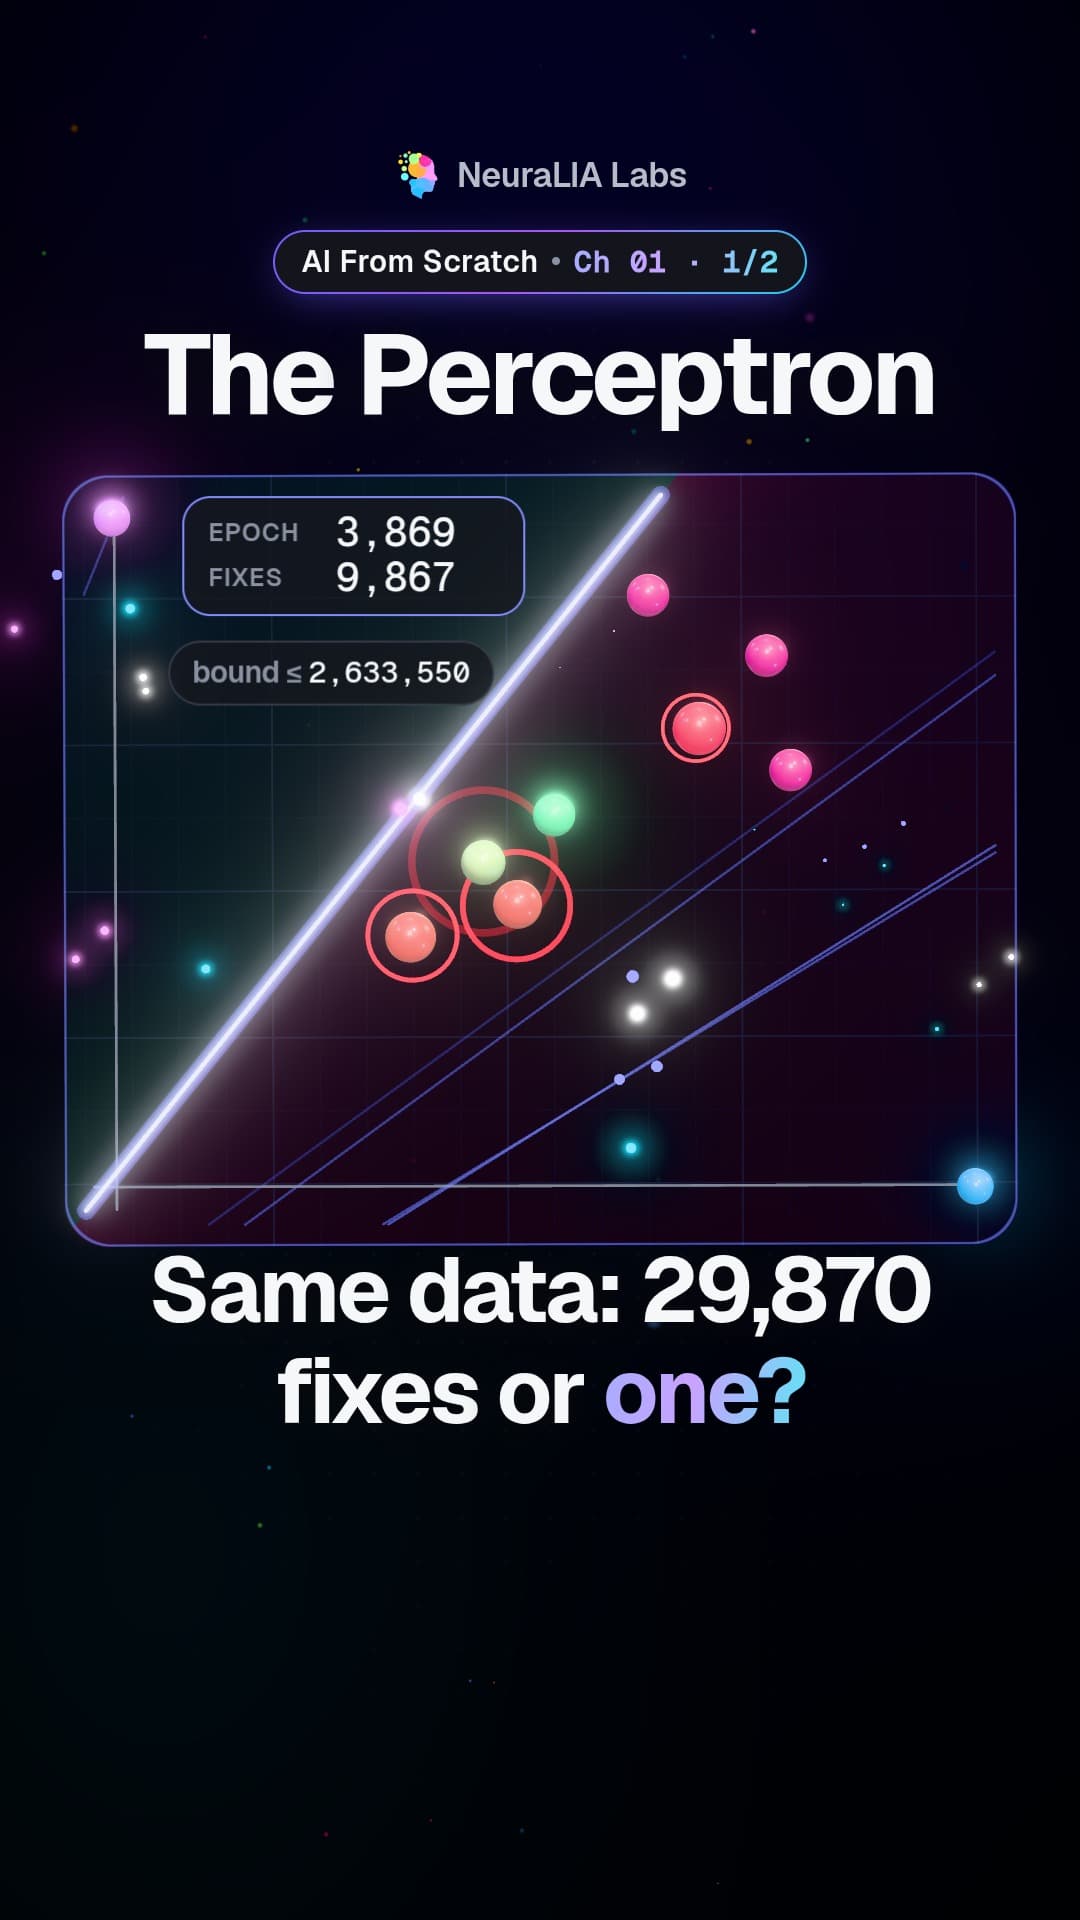
定理从未被违反。把原始版本跑得足够久,它确实会收敛——在 第 11,976 个 epoch,经过 29,870 次修正之后——远远落在 2,633,550 的上界之内。而这个差距本身就是重点:定理约束的是最坏情况,不是典型情况。它只是需要比任何人愿意等待的时间多六十倍的 epoch。
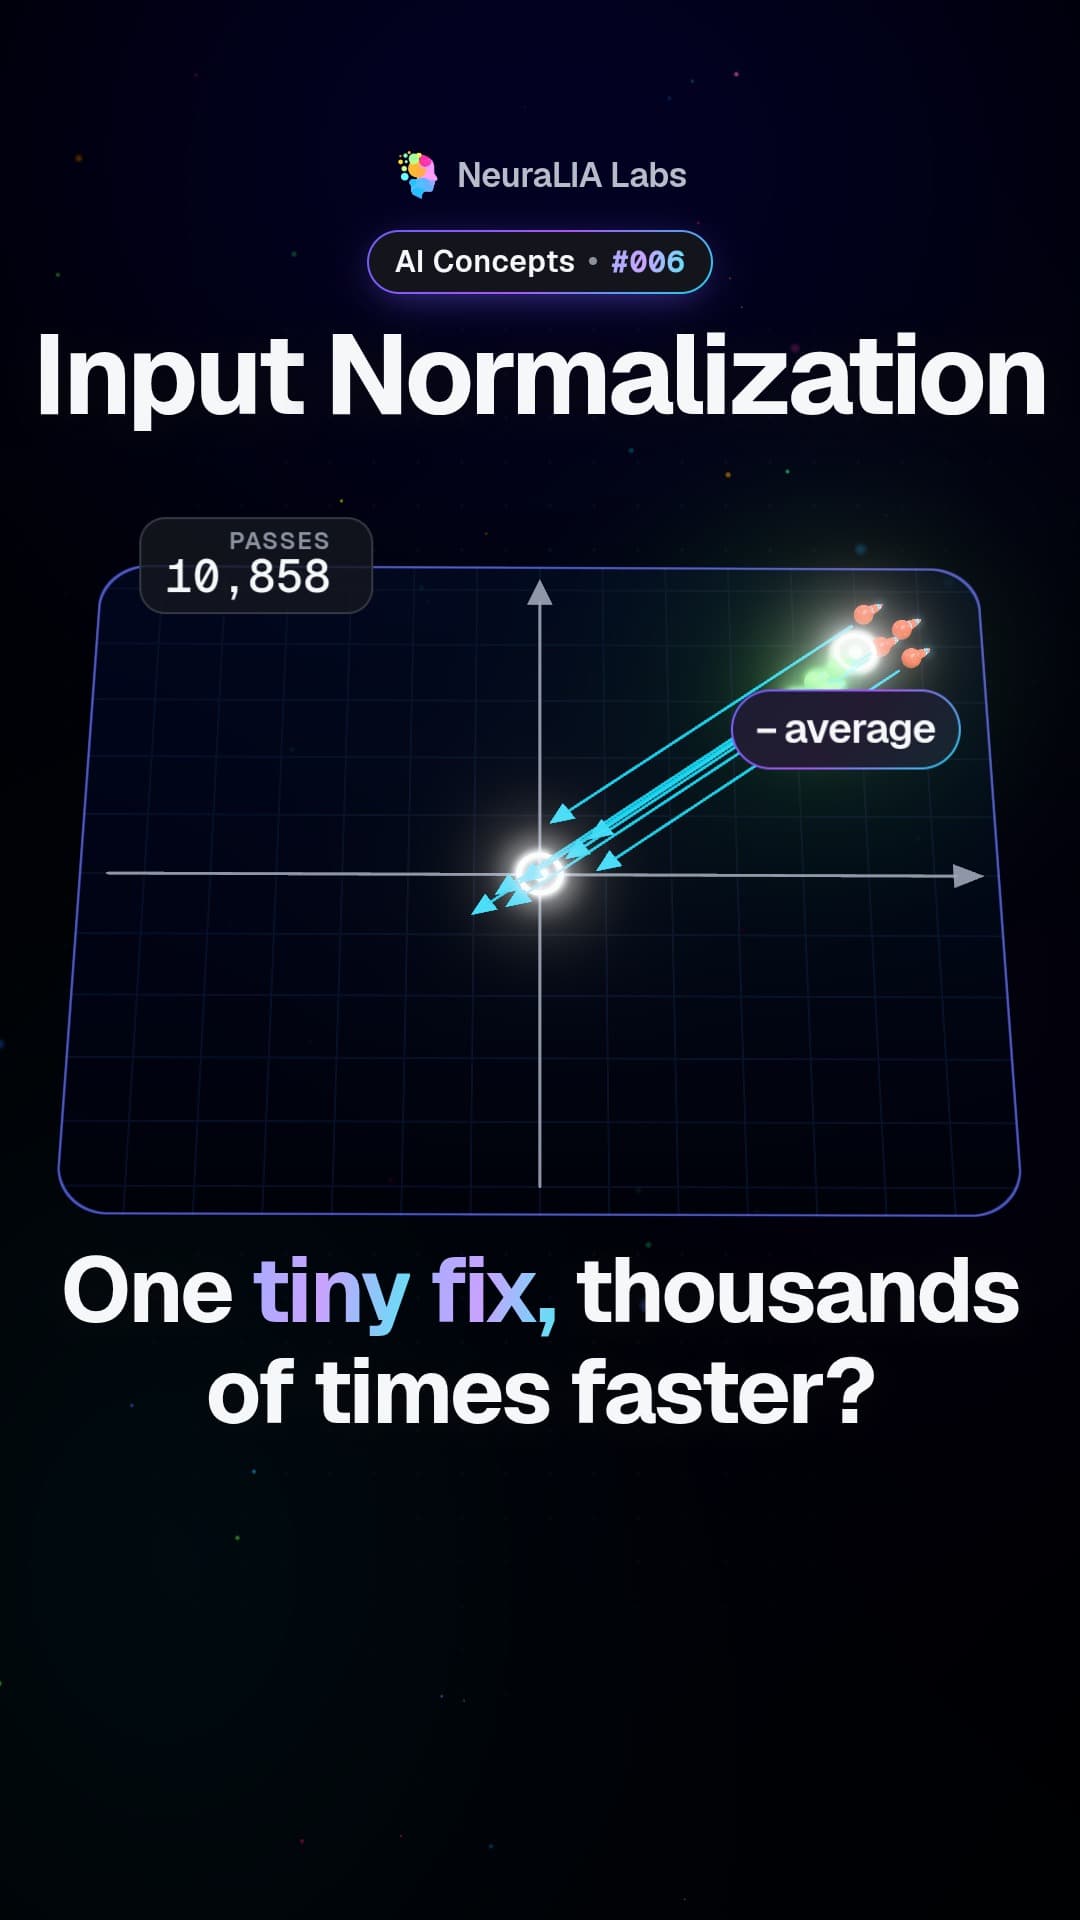
第二行是同样的八个零件,同样的二十行代码,只额外加了三行:从每个测量值里减去平均宽度和平均重量。就这些。这就是全部改变。它把点云移动到跨过原点的位置,而不是漂在 (22, 57) 附近;对上界的影响是 一万五千倍,因为两个项同时变好了: 从 74 降到 13,因为这些点不再从一个遥远的原点开始测量; 从 0.045 升到 0.989,因为 margin 是相对于一个不再需要携带巨大偏置才能够到数据的权重向量来测量的。
mean_w = sum(x[0] for x, _ in BELT) / len(BELT)   # 22.15
mean_g = sum(x[1] for x, _ in BELT) / len(BELT)   # 57.25
CENTRED = [(((x[0] - mean_w), (x[1] - mean_g)), y) for x, y in BELT]

w, b, epoch = train(CENTRED, epochs=200)
print(epoch, w, b)2 [-4.15, -10.25] 1.0两个 epoch 收敛,而且它只修正了自己一次。
这里真正的教训不是「记得归一化输入」,尽管你确实应该这么做。它是:一个关于算法是否会结束的保证,并不会告诉你它结束时你是否还在场;而这两者之间的差距,通常来自几何。这是一个模式的第一次出现:你会在第 6 章的初始化里、第 10 章的学习率调度里、第 13 章的量化里再次遇到它。数学说这件事可能,工程决定它是否实际可行。一门只教定理的课程,会把一个训练三天的模型交给你,然后怪你。
四个点,一条线,无解
链接到此部分:四个点,一条线,无解现在来看那个终结了神经网络第一个时代的失败,而且它只需要四行。
忘掉工厂。取两个输入,每个都只能是 0 或 1,并要求当且仅当其中一个为 1 时,答案为 :
| 0 | 0 | |
| 0 | 1 | |
| 1 | 0 | |
| 1 | 1 |
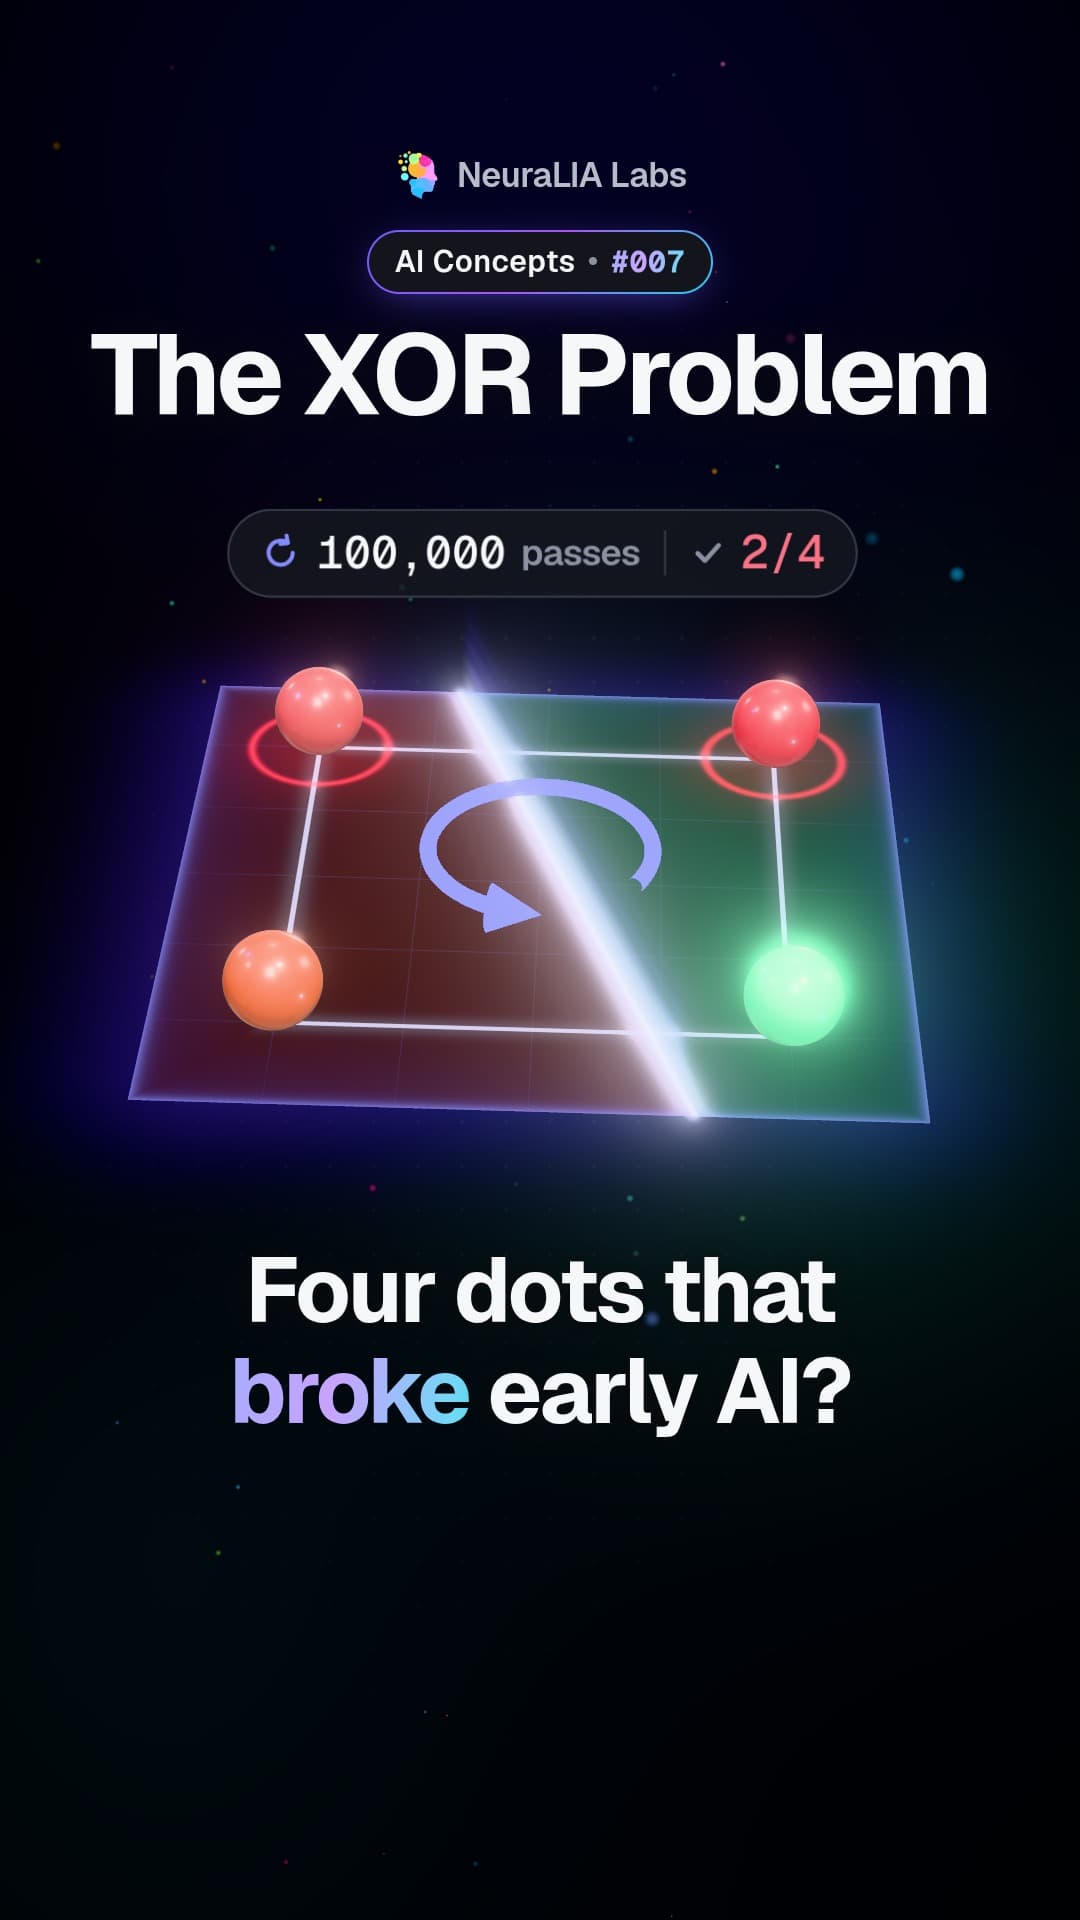
这就是 XOR——异或。继续读之前,先在纸上画出这四个点:单位正方形的三个角,以及第四个角。把两个对角点 和 标为放行,把 和 标为退回。现在画一条直线,让两个放行点在一侧,两个退回点在另一侧。
你画不出来。不是因为它难,也不是因为你需要更聪明的算法;而是这条线根本不存在。三行代数就能说明原因。如果一个感知机把四行都判对,那么按顺序读这四行会得到
把中间两个不等式相加:,所以 。最后一个不等式说 。合起来就是:,这要求 ,也就是要求 。而第一个不等式又说 。不存在这样的 ,所以也不存在这样的权重。任何感知机,无论数字怎么取,都无法分类 XOR。
还是运行它,因为亲眼看一个算法失败,比被告知它会失败更有价值:
     100 epochs -> converged=None  w=[0.0, 0.0] b=0.0  correct=2/4
   1,000 epochs -> converged=None  w=[0.0, 0.0] b=0.0  correct=2/4
100,000 epochs -> converged=None w=[0.0, 0.0] b=0.0 correct=2/4它不会发散,也不会在一个还算不错的答案附近乱撞。它会循环:它在权重空间里走一个短回路,然后精确回到起点,永远如此,四个里只判对两个——这和瞎猜没区别。十万个 epoch 和一百个 epoch 看不出差别,因为这个算法并没有在做一种更长运行就能完成的进展。拿它和传送带问题对比:后者在 200 个 epoch 时看起来也卡住了,但其实正在缓慢磨向一个真实答案。从外面看,前几秒两者很相似。没有定理,就不可能区分它们——这也是了解定理的另一个理由。
Minsky 和 Papert 到底说了什么
链接到此部分:Minsky 和 Papert 到底说了什么1969 年,Marvin Minsky 和 Seymour Papert 出版了 Perceptrons,这是一整本用数学研究这个模型究竟能表示什么、不能表示什么的书。2 XOR 是其中被引用最多的结果,而这段引用通常被当成指控来使用:说这本书出于竞争或恶意,让神经网络研究停摆了十五年。
书里的数学是正确的,而且比 XOR 例子更有意思。Minsky 和 Papert 主要关心的并不是单个感知机能不能做 XOR;他们关心的是当感知机被赋予有限感受野时会发生什么——每个单元只能看到输入的一部分——并证明了图像的某些全局属性,比如一个图形是否连通,无论你使用多少单元,都无法用这种方式计算出来。这是一个关于局部性的真正深刻的结果,和流行故事没有关系。
流行故事在历史上也错了。Minsky 和 Papert 明确讨论了多层感知机,并说它们能力的问题仍然开放——他们怀疑扩展这套理论会是「贫瘠的」,这是预测,不是证明,而且它错了。1969 年缺少的不是堆叠层的想法;缺少的是训练一个堆栈的方法。感知机规则做不到:它需要知道每个单元错得多厉害,而对一个埋在中间的单元来说,没有标签可供比较。这个缺口一直开放到 1986 年 backpropagation 被推广开来,3 而弥合它正是第 5 章要做的事。
所以诚实的总结是这样。这本书证明了一个真实模型的真实限制。七十年代这个领域的经费坍塌有很多原因,其中之一是六十年代初人们对感知机许下的承诺过于夸张。而那个技术障碍是可以解决的,只是当时还没人拥有工具。
留下来的是什么
链接到此部分:留下来的是什么感知机已经六十八岁了,而你刚刚写了一个。值得精确说明的是,它的哪些部分仍然存在于你完成这门课时会得到的机器里,因为答案是:比你以为的更多。
仍然在这里。 这个形状——乘以权重、求和、加上偏置、对结果应用一个非线性函数——正是本课程里每个神经网络中一个单元的形状,包括第 9 章 transformer block 里面的那些单元。犯错就更新的规则,是伪装起来的随机 gradient descent:它正是把第 3 章的方法应用到某个特定损失函数时得到的东西。增量式训练——一次用少量样本,而不是一次用完整数据集——直到今天仍然是各种规模模型的训练方式。第 3 章会衡量这个取舍真正落在哪里。
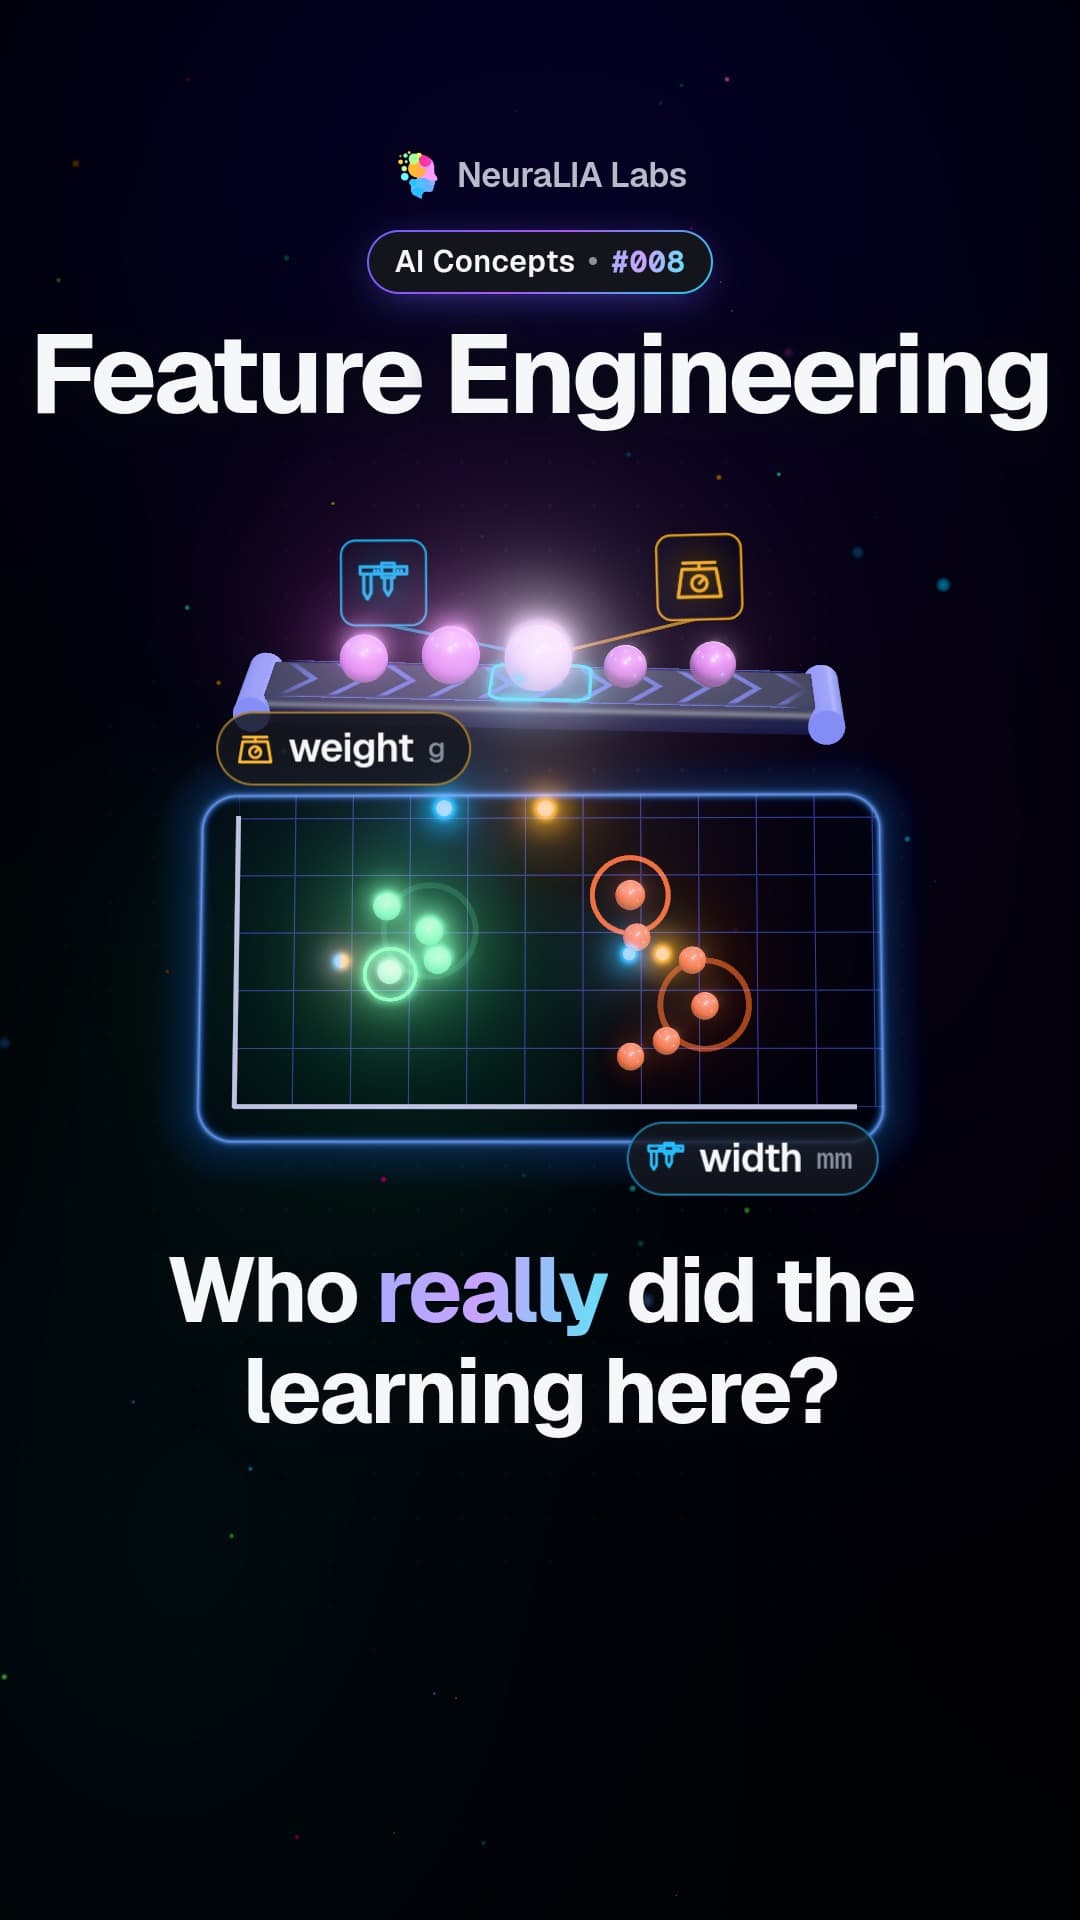
已经消失。 阈值本身:在第 4 章被一个输出概率而不是判决的函数取代,因为「退回」和「退回,但其实很接近」是两种不同信息,而符号会把差异丢掉。单层结构,在第 5 章被取代。以及手工挑选的特征:有人为这条传送带选择了宽度和重量,而这个选择比算法本身做了更多工作。第 8 章会让模型开始选择自己的特征。
接下来走向哪里
链接到此部分:接下来走向哪里感知机同时卡在两件事上,而它们最终被证明是同一件事。
它无法表示 XOR,因为一条线不够。修复这一点意味着堆叠层——第一层弯曲空间,第二层在弯曲后的空间里画线。这是第 5 章。
但你不能用感知机规则训练一个堆栈,因为它只知道「错了」,而网络中间的一个单元没有属于自己的标签可供出错。要训练一个堆栈,你需要知道每个权重错得多厉害、该往哪个方向改——你需要斜率。而感知机的错误函数,那段楼梯,没有斜率。
所以在堆栈之前,必须先有一个带可用导数的损失函数。也不能只是因为方便求导就选一个:它得有来处,得说出关于数据的真实东西,而且它的 gradient 要从这个含义里自然落下,而不是为了看起来整洁而反向设计出来。
这就是第 2 章,它从一个感知机从未需要回答的问题开始:不是「这个零件好吗?」,而是「如果这就是真相,那么这些读数有多可能?」
来源与方法
链接到此部分:来源与方法还值得和本章一起阅读的有:Rosenblatt 的原始论文 The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain (Psychological Review 65(6), 1958),它比名声暗示的更易读;McCulloch 和 Pitts 的 A Logical Calculus of the Ideas Immanent in Nervous Activity (Bulletin of Mathematical Biophysics 5, 1943),这篇论文首次把神经元建模为加权求和之上的阈值;Hal Daumé III 的 A Course in Machine Learning 中的感知机章节,它以不同重点推导了同一个更新;以及 Deisenroth、Faisal 和 Ong 的 Mathematics for Machine Learning 第 2、3 章,若上面的框让你还想要更多线性代数,可以读它们。
参考资料
链接到此部分:参考资料-
Novikoff, A. B. J. On convergence proofs for perceptrons. Proceedings of the Symposium on the Mathematical Theory of Automata, vol. 12, pp. 615–622 (Polytechnic Institute of Brooklyn, 1962). 上文所用错误次数上界的原始陈述和证明。 ↩
-
Minsky, M. and Papert, S. Perceptrons: An Introduction to Computational Geometry (MIT Press, 1969; expanded edition 1988). XOR 结果是初等的;更实质的结果涉及阶数受限谓词和连通性。 ↩
-
Rumelhart, D. E., Hinton, G. E. and Williams, R. J. Learning representations by back-propagating errors. Nature 323, pp. 533–536 (1986). ↩
本章视频
用通俗语言讲解本章概念的短视频。
 #01
What is AI? Software that learns its own rules from examples
 #001
Perceptron: the yes-or-no model every neural network grew from
 #02
Machine learning: how a computer draws its own dividing line
 #002
Decision boundary: the line a simple model draws between yes and no
 #003
Dot product: the multiply-and-add step at the heart of AI's math
 #004
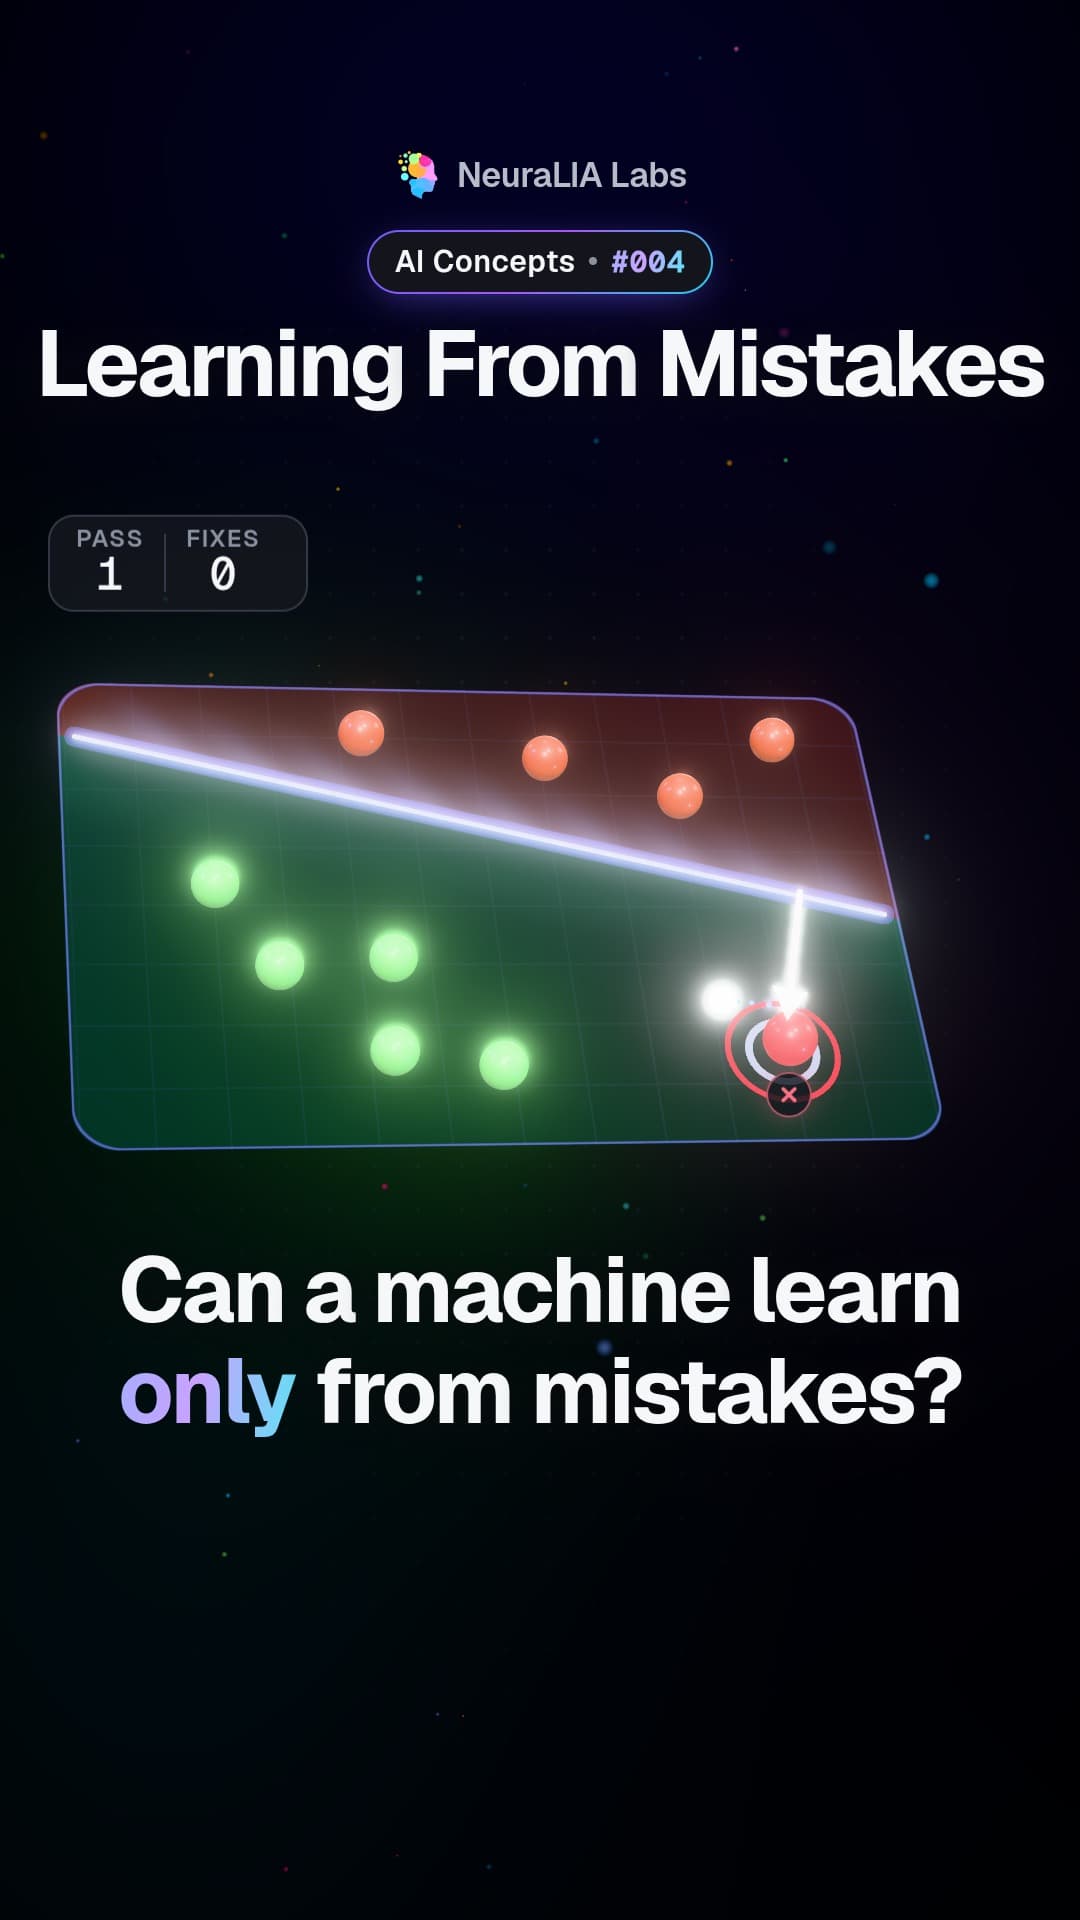
Learning from mistakes: the perceptron rule that only moves when wrong
 #005
Convergence theorem: guaranteed to finish, silent about when
 #006
Input normalization: three lines of code, 6,000 times faster training
 #007
The XOR problem: four dots no straight line can separate
 #008
Feature engineering: the human choice that can beat the algorithm