
Chain of Thought, RLVR och Test-Time Compute, uppmätt
Samma 24 problem: 0 % rätt på 1,9 tokens, 100 % rätt på 145. Sedan self-consistency som köper tillbaka greedy decoding.
På den här sidan
Tjugofyra textproblem i två steg. En liten modell — en halv miljard parametrar, samma som i kapitel 11 — får varje fråga två gånger.
Först ombeds den ge svaret:
"...How many bolts are left?  Reply with only the final number, nothing else."

  0 / 24 correct        1.9 tokens per answer
Sedan ombeds den ge svaret, med tillåtelse att arbeta först:
"...How many bolts are left?  Think step by step, then give the final
 number on its own line."

  24 / 24 correct       145.2 tokens per answer
Noll till hundra procent. Samma modell, samma vikter, samma problem, samma greedy decoding. Den enda skillnaden är att den andra versionen fick avge 143 fler tokens innan den band sig vid ett tal.
Det här kapitlet handlar om det gapet: vad det faktiskt är, hur långt det räcker, vad det kostar och vad som hände när fältet slutade be om det i prompt och började träna in det.
Modellen tänker inte. Den beräknar längre.
Länk till avsnittet: Modellen tänker inte. Den beräknar längre.Det är frestande att säga att den andra versionen "tänkte på saken". Motstå det, eftersom mekanismen är både enklare och mer användbar att känna till.
En transformer gör en fast mängd beräkning per genererad token. En forward pass: samma lager, samma matriser, samma antal operationer oavsett om frågan är vad är 2+2 eller bevisa denna sats. Det finns ingen ratt inne i modellen för "försök hårdare med just den här".
Så när en modell ombeds svara omedelbart är hela den tillgängliga beräkningen en enda forward pass. Varje mellanliggande storhet måste få plats i aktiveringarna i den enda passeringen, och allt den inte kan beräkna där kan den inte beräkna.
Att avge tokens ändrar det, och det ändrar det på två skilda sätt som är värda att hålla isär:
- Mer beräkning. Varje genererad token är ännu en full forward pass. Hundrafyrtiofem tokens av arbetsgång är hundrafyrtiofem gånger så mycket aritmetik som att svara direkt.
- Externaliserat minne. Tokens skrivs in i kontexten, så nästa passering kan läsa dem.
5 × 13 = 65blir ett faktum i indata, inte ett värde som modellen måste hålla i en aktivering och bära vidare. Modellen använder sin egen output som kladdpapper.
Den andra punkten är den folk missar, och den förklarar varför arbetsgången måste skrivas ned för att hjälpa. En modell som ombeds "tänka på det tyst och sedan svara" har ingenstans att lägga tanken.
Inget av detta kräver något mystiskt, och det ger en tydlig förutsägelse: chain of thought bör hjälpa mest på problem med seriell struktur — där steg två behöver resultatet från steg ett — och minst på problem som är en enkel uppslagning. Det är exakt vad litteraturen hittar, och det är därför "think step by step" inte gör något för vad är Frankrikes huvudstad.
Chain of thought som prompting-teknik
Länk till avsnittet: Chain of thought som prompting-teknikTekniken kom 2022 i två delar. Wei et al. visade att inkluderade genomarbetade exempel i prompt — demonstrationer där svaret föregås av resonemang — gav stora förbättringar på aritmetiska benchmarks och commonsense-benchmarks.1 Kojima et al. visade sedan något märkligare: du behöver inte exemplen. Att lägga till "Let's think step by step" i en zero-shot prompt fångar mycket av samma förbättring.2
Det andra resultatet är det som säger vad som pågår. Om en magisk fras låser upp beteendet fanns beteendet redan i modellen — pretraining är full av genomarbetade lösningar, och frasen är en pekare till den delen av distributionen. Chain of thought lärde inte modellen något. Det valde något modellen redan hade.
Den inramningen förutsäger också teknikens slutliga föråldring, som vi återkommer till i slutet av kapitlet.
Self-consistency och ett resultat som överraskade mig
Länk till avsnittet: Self-consistency och ett resultat som överraskade migNästa uppenbara steg: om en resonemangskedja kan vara fel, sampla flera och ta majoritetssvaret. Det är self-consistency.3 Det är en strikt större kostnad — fulla genereringar i stället för en — och intuitionen är att fel svar sprids medan rätt svar samlas.
Mätt på 16 av samma problem, sampling vid temperature 0.8, majoritetsomröstning över kedjor:
| träffsäkerhet | kumulativa tokens | tokens per problem | |
|---|---|---|---|
| 1 | 81 % | 2,952 | 185 |
| 2 | 81 % | 5,618 | 351 |
| 3 | 100 % | 8,417 | 526 |
| 4 | 100 % | 11,103 | 694 |
| 5 | 100 % | 13,933 | 871 |
Sexton problem är en liten nämnare, och regeln från kapitel 4 gäller den här tabellen lika mycket som alla andra. 13 av 16 är 81 % med ett 95-procentigt Wilson-intervall på [57, 93]; 16 av 16 är 100 % med [81, 100]. De överlappar. Läs kurvans form, vilket är fyndet; läs inte den exakta pinnen där den planar ut, vilket sexton problem inte kan lokalisera.
Två saker i den tabellen, och den andra var inte vad jag väntade mig.
Kurvan planar ut vid . Vid tredje sampeln ligger träffsäkerheten vid sitt tak och de återstående två samplen köper ingenting men kostar 172 tokens var, 345 tillsammans. Det är formen på varje self-consistency-kurva som rapporteras i litteraturen, och det sker mycket tidigare än inramningen "fler samples är mer bättre" antyder.
Och greedy decoding låg redan på 100 %. Titta tillbaka på kapitlets början: en kedja, ingen sampling, 145 tokens, 24/24. Sampling vid temperature 0.8 sänkte träffsäkerheten till 81 %, och self-consistency behövde tre genereringar för att klättra tillbaka dit en enda greedy passering redan var — till 3,6 gånger så många tokens, eller sex gånger om du kör svepet till fem utan att veta var det planar ut.
Det är inte ett argument mot self-consistency. Det är ett exakt påstående om vad tekniken gör: temperature köper mångfald genom att injicera fel, och röstning tar bort felen den just injicerade. På problem där greedy decoding misslyckas — där den enskilt mest sannolika kedjan leder fel och en mindre sannolik är rätt — lönar sig den avvägningen, och det är därför tekniken finns. På problem där greedy redan lyckas är det ett sätt att spendera sex gånger budgeten för att gå jämnt upp.
Ingen publicerar det andra fallet, och därför är det värt att mäta på din egen uppgift innan du inför tekniken. Det här är enkla tvåstegsproblem för en liten modell; det är den regimen där svaret blir så här.
Från att be till att träna
Länk till avsnittet: Från att be till att tränaAllt hittills sker vid prompt-tid på en modell som aldrig specifikt tränats för det. Skiftet som gav dagens generation av resonemangsmodeller var att flytta in det i träningen — och nyckeln som gjorde det möjligt är smalare än den låter.
Post-training i kapitel 11 behövde mänskliga preferenser, eftersom "var detta ett bra svar?" inte har något programmatiskt svar. Men för vissa frågor har det det. Ett matematiskt svar är antingen lika med rätt värde eller inte. Kod klarar antingen testerna eller inte. Ett bevis kontrolleras antingen eller inte.
För de domänerna kan du ersätta belöningsmodellen med en verifierare, och allt nedströms blir bättre på en gång: inga annoterare, ingen Bradley–Terry-anpassning, ingen reward hacking av den typ som mättes i kapitel 11 — eftersom du inte kan smickra ett enhetstest. Det här är reinforcement learning from verifiable rewards, och det är miljön GRPO byggdes för: sampla en grupp lösningsförsök på samma problem, kontrollera vart och ett och använd gruppens medelpoäng som baseline. Ingen critic, ingen annoterare, ingen belöningsmodell. Bara ett program som säger rätt eller fel.
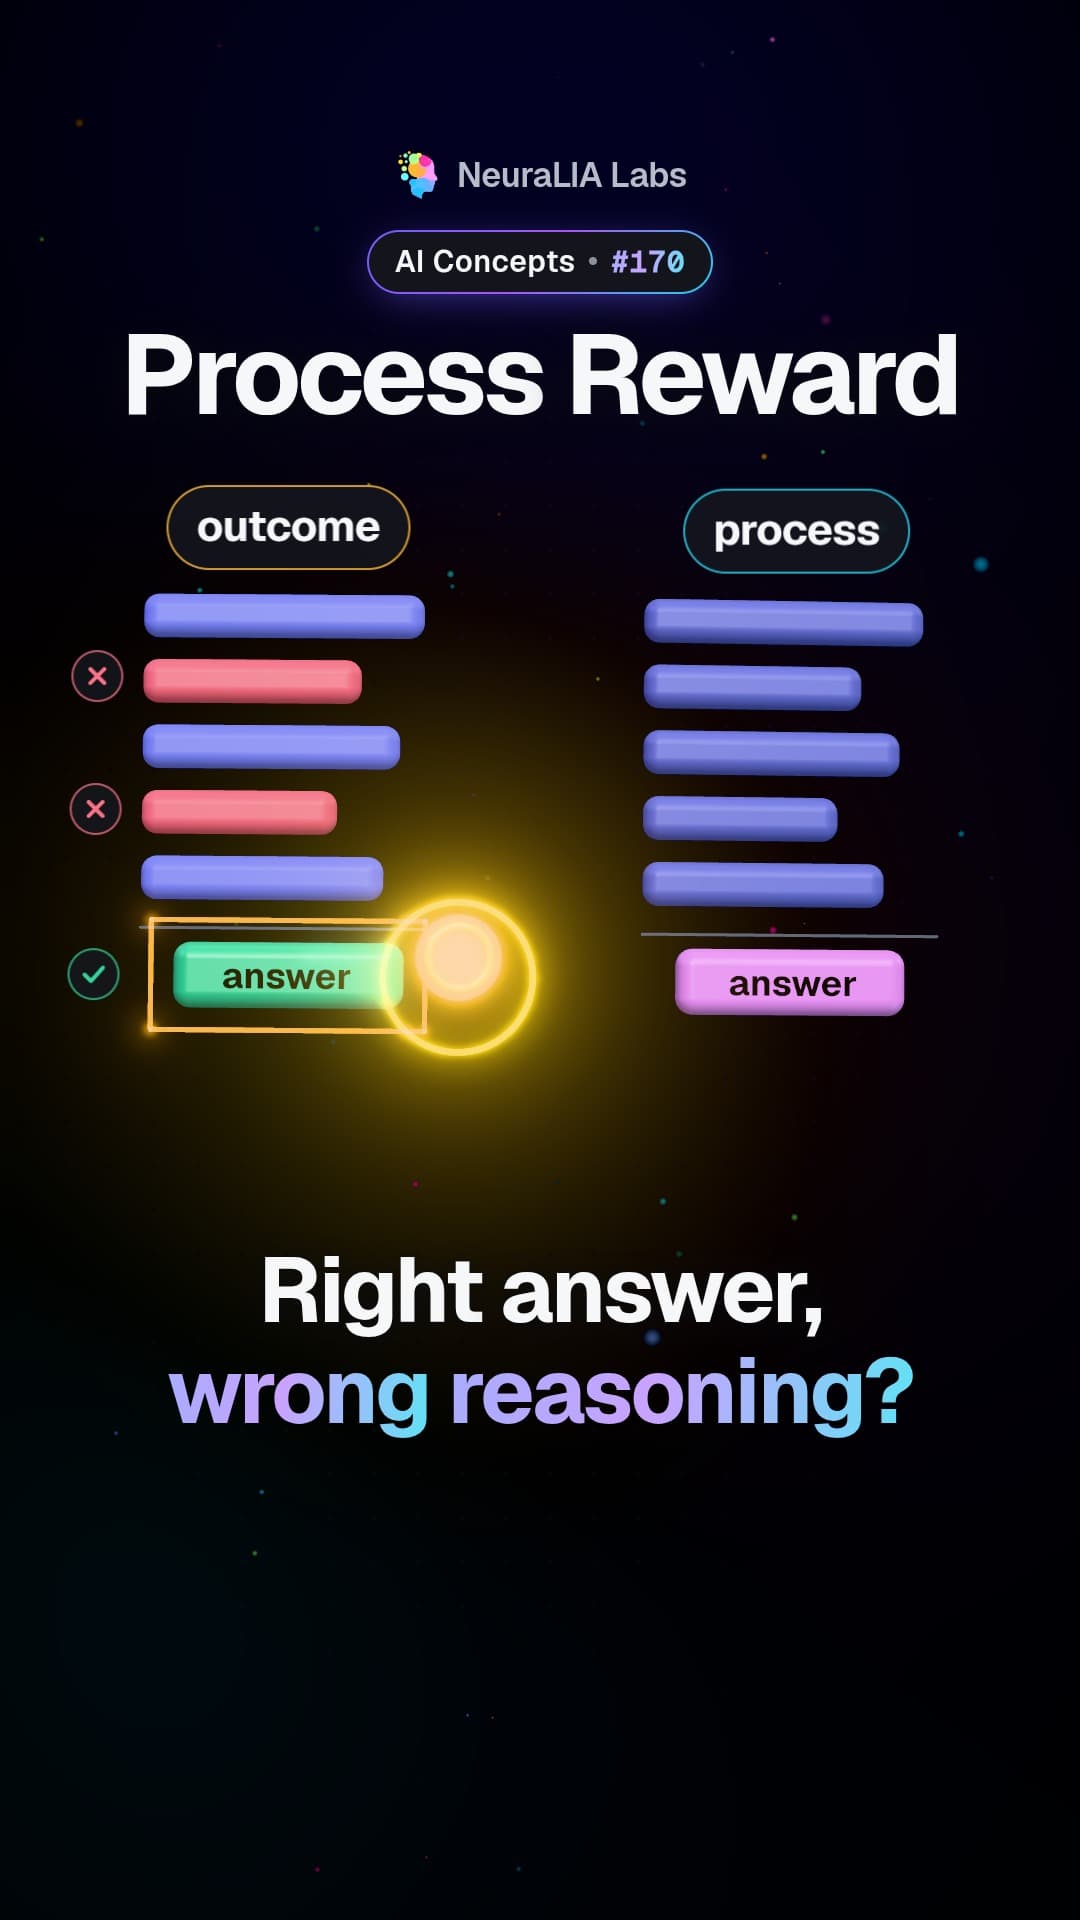
Outcome reward. Poängsätt bara det slutliga svaret. Billigt — en strängjämförelse — och det har ett uppenbart hål: en lösning som når rätt tal genom fel resonemang belönas exakt som en korrekt, så policyn är fri att lära sig plausibelt nonsens som råkar landa rätt.
Process reward. Poängsätt varje steg. Lightman et al.5 byggde ett dataset med 800 000 mänskligt märkta resonemangssteg för att träna en modell som gör detta, och visade att det tydligt överträffar outcome supervision på svår matematik. Kostnaden ligger i namnet: någon märkte 800 000 steg.
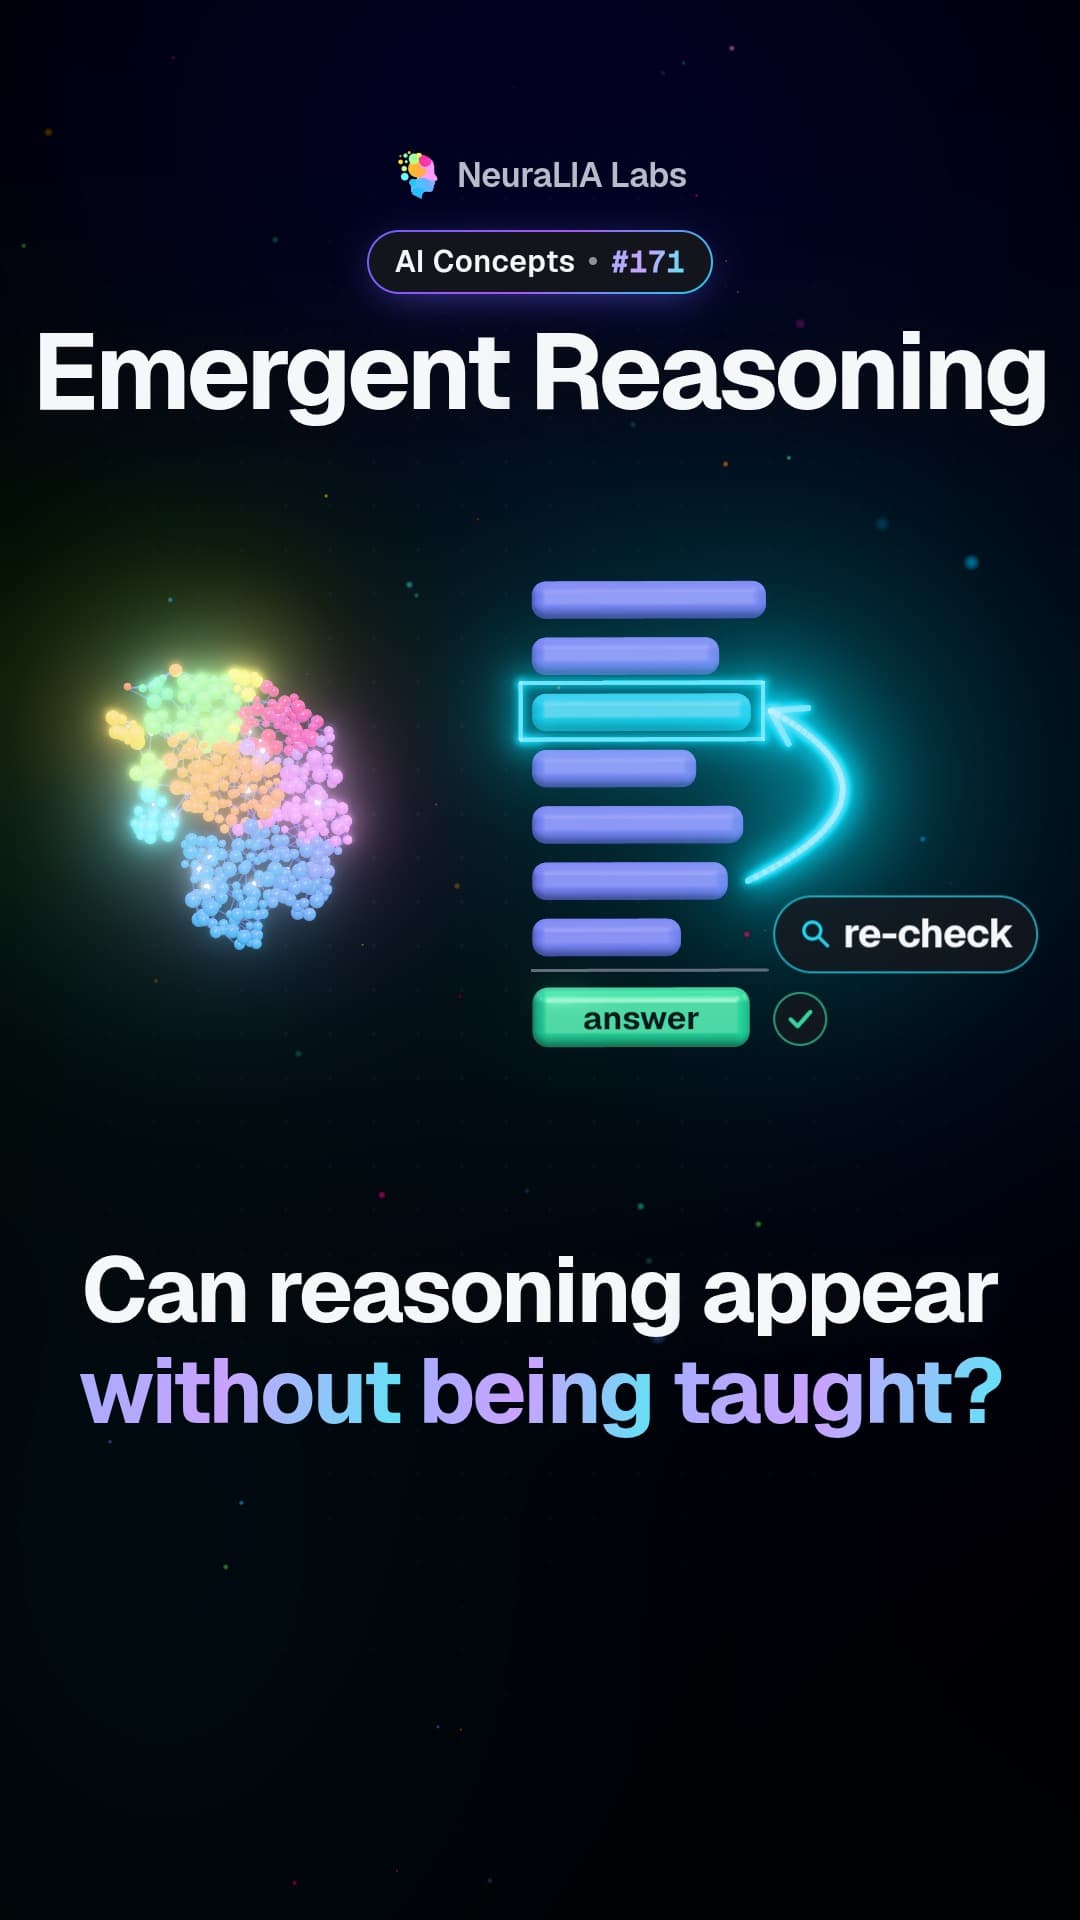
Resultatet som omformade fältet kom från DeepSeek i början av 2025.6 De tog en basmodell och tillämpade reinforcement learning with verifiable rewards direkt, utan något supervised fine-tuning-steg först — steget som kapitel 11 presenterar som grunden för allt. Långa resonemangskedjor uppstod ändå. Det gjorde även beteenden som ingen tränat för: modellen började kontrollera sina egna steg på nytt och, i artikelns mest citerade passage, spontant ompröva ett angreppssätt mitt i lösningen.
Den ärliga läsningen är inte att resonemang är magi. Den är att när det enda som belönas är att ha rätt, och att ha rätt på ett svårt problem kräver att man arbetar sig igenom det, då är det att arbeta sig igenom det som optimeraren hittar — inklusive de delar av arbetet som människor också gör, eftersom de är vad problemet kräver snarare än vad någon har lärt ut.
Resonemangs-tokens är en rad på fakturan
Länk till avsnittet: Resonemangs-tokens är en rad på fakturanDen praktiska konsekvensen av allt detta är att en resonemangsmodell producerar tokens du bad om och tokens du inte bad om, och du betalar för båda.
Leverantörer hanterar detta olika, och skillnaden spelar roll:
- De flesta API:er räknar resonemangs-tokens inuti antalet output tokens. Din faktura och din
max_tokens-gräns inkluderar båda tänkandet du aldrig ser. - Googles Gemini rapporterar thinking tokens som ett separat fält, utanför standardantalet output tokens.
Det är en verklig inkompatibilitet mellan två sätt att räkna samma sak, och all kod som beräknar kostnad eller upprätthåller en budget över leverantörer måste normalisera det. Kapitel 16 är där det blir pengar, och kapitel 23 där det blir en budget du kan upprätthålla.
Den andra konsekvensen är en latency-konsekvens som överraskar folk första gången. En resonemangsmodells tid till första synliga token inkluderar allt dess tänkande, så en begäran som inte streamar något på åtta sekunder och sedan svarar på en är inte en hängd anslutning — det är modellen som arbetar. Ett gränssnitt som visar en spinner utan förklaring i åtta sekunder har ett designproblem, inte ett nätverksproblem.
När "think step by step" slutar hjälpa
Länk till avsnittet: När "think step by step" slutar hjälpaEn avslutande varning, eftersom detta är det vanligaste sättet som materialet i kapitlet används fel.
Allt i första halvan är en teknik för att få en modell som inte tränats att resonera att ändå producera resonemang. Modeller tränade med RLVR gör det redan: de avger sin egen arbetsgång, i sin egen längd, innan de svarar. Att säga åt en sådan modell att tänka steg för steg är i bästa fall överflödigt och i värsta fall skadligt — det kan producera en kort, prompt-formad kedja i stället för den längre som modellen skulle ha genererat på egen hand, och vissa leverantörer dokumenterar exakt detta.
Detsamma gäller avancerade resonemangsställningar byggda i applikationskod. En prompt som leder en modell genom ett beslutsträd den redan navigerar internt spenderar dina tokens på att begränsa ett beteende som tränats in. Detta är den första förekomsten av ett tema som löper genom resten av kursen: tekniker som var nödvändiga 2022 hade blivit vidskepelse 2025, och det enda sättet att veta vilket som är vilket för din modell, i dag, är att mäta båda.
Kapitel 15 är där den mätningen blir en disciplin snarare än en åsikt.
Vart det leder härnäst
Länk till avsnittet: Vart det leder härnästResonemang har en obekväm egenskap: det är den enda förmågan vars kostnad skalar med hur svår frågan är. En modell som tänker i niohundra tokens gör niohundra forward passes, håller en växande cache i minnet för dem alla och håller en GPU under hela tiden.
Det gör ekonomin i att köra en resonemangsmodell markant sämre än att köra en chatmodell, och det förvandlar en uppsättning implementationsdetaljer till skillnaden mellan en livskraftig produkt och en olönsam: hur cachen av tidigare nycklar och värden lagras och återanvänds, hur många begäranden som kan dela en forward pass och hur mycket precision vikterna faktiskt behöver.
Kapitel 13 är det sista där modellen är ett objekt i ditt minne snarare än en tjänst bakom en port, och det handlar om att göra det objektet billigt nog att köra. Det löser också in ett löfte från detta kapitel: speculative decoding, som producerar flera tokens till ungefär priset av en genom att låta en liten modell gissa och en stor kontrollera — ett knep som bara är begripligt när du har sett hur mycket av en forward pass som går åt till att vänta på minne snarare än att göra aritmetik.
Källor och metod
Länk till avsnittet: Källor och metodAlla mätningar i detta kapitel kommer från Qwen/Qwen2.5-0.5B-Instruct på 24 genererade tvåstegsproblem, greedy decoding utom där sampling anges, med noll trunkerade genereringar vid de token-gränser som användes. De är reproducerbara, och de är en liten modell på enkla problem: läs self-consistency-resultatet som en demonstration av mekanismen, inte som en benchmark. Kapitel 18 i CS229-föreläsningsanteckningarna och kapitel 12 i Hugging Face LLM Course täcker båda detta material med större modeller och riktiga benchmarks.
Referenser
Länk till avsnittet: Referenser-
Wei, J. et al. Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. arXiv:2201.11903 (2022). ↩
-
Kojima, T., Gu, S. S., Reid, M., Matsuo, Y. and Iwasawa, Y. Large Language Models are Zero-Shot Reasoners. arXiv:2205.11916 (2022). Resultatet med "let's think step by step". ↩
-
Wang, X. et al. Self-Consistency Improves Chain of Thought Reasoning in Language Models. arXiv:2203.11171 (2022). ↩
-
Yao, S. et al. Tree of Thoughts: Deliberate Problem Solving with Large Language Models. arXiv:2305.10601 (2023). ↩
-
Lightman, H. et al. Let's Verify Step by Step. arXiv:2305.20050 (2023). Introducerar PRM800K, datasetet för processövervakning med 800 000 steg. ↩
-
DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948 (2025). R1-Zero-resultatet — reinforcement learning tillämpad direkt på en basmodell, utan något supervised fine-tuning-steg — finns i avsnitt 2.2. ↩
-
Snell, C., Lee, J., Xu, K. and Kumar, A. Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters. arXiv:2408.03314 (2024). ↩
Det här kapitlet på video
Korta videor som förklarar idéer från det här kapitlet på enkelt språk.
 #165
Chain of thought: why letting an AI show its work changes the answer
 #166
Think step by step: why a famous prompt works, and when it backfires
 #167
Self-consistency: ask an AI several times, then trust the majority
 #168
Tree of thoughts: how an AI searches through ideas, and what it costs
 #169
Verifiable rewards: training AI on answers a program can check
 #170
Process reward: grading an AI's working, not just its final answer
 #171
Emergent reasoning: the AI that started double-checking on its own
 #172
Reasoning tokens: the AI thinking you never see but still pay for
 #173
Test-time compute: making an AI better by letting it think longer